blog SwaggerベースのAPI仕様自動化PoC 作成背景 本プロジェクトの開発環境では、Swaggerライブラリを顧客企業のサービスに直接適用することが難しい制約がありました。一般的なSpringベースのサービスであれば、Springfoxまたはspringdoc-openapiを使用してControllerとDTOに基づくAPI仕様を自動生成できますが、顧客企業の環境では、サービスごとの依存関係の追加やランタイム連携を自由に行うことができませんでした。 それでも顧客は、API仕様の管理にSwaggerを使用したいと考えていました。特に、現在デプロイされているAPI一覧と詳細なrequest、response構造をSwagger UIで確認したいというニーズがありました。さらに、複数の開発チームがそれぞれ開発したサービスについて、APIドキュメントを手作業で作成・更新することの遅延に起因するVOCも発生していました。 PoCの出発点は、この制約を維持しながらSwaggerベースのドキュメント化体験を提供できるか検証することでした。つまり、各サービスにSwaggerライブラリを直接組み込まず、中央Swagg
blog MUIベースのデザインシステムVUI はじめに ここ数か月、社内デザインシステムであるVUI(Vizend UI)の実装に取り組んできました。VUIは、デザイナーと開発者が同じ方法で製品をつくるための共通言語であり、約束です。デザイントークン・コンポーネント・パターン・原則と、それらをコードまでつなぐ自動化を一つにまとめたデザインシステムです。その基盤エンジンとしてMUI(Material UI)を使用しています。ここでは、デザインシステムをどのようにつくっているのかを簡単に紹介します。 構成は次のとおりです。①なぜデザインシステムが必要だったのか、②MUIをベースとして使用した理由、③デザインシステムで使用するデザイントークン、④MUIテーマの動作原理、デザイントークンをMUIテーマがどのように利用し、実際のコンポーネントにトークンを適用した方法、⑤モバイル/デスクトップやライト/ダークなど、モードごとにテーマを分離して構成した方法、最後に⑥まだ解決できていない問題です。 1. なぜデザインシステムが必要だったのか デザインシステムは一般に「再利用可能なUIコンポーネントの集合」と考えら
blog Vello: クラスパスにない外部イベント処理 問題の定義 Lakeyプロジェクトでは、社内メッセージングフレームワークであるPrologueのVelloモジュールを使用して外部イベントを保存し、LLMコンテキストで利用できるよう、外部イベントを管理しています。 Prologueがデフォルトで提供するイベントコンバーターである'TypeAwareEventConverter'は、メッセージを受信するとヘッダーの'payloadClass'値を読み取り、クラス名が稼働中のサービスのクラスパスに存在するかを確認した後、デシリアライズを実行します。 この方式は、同一サービス内、または外部サービスのEventモジュールに依存した状態でイベントを送受信する場合には問題ありません。すでにEventクラスがサービスのクラスパスに存在するためです。しかし、未定義のまま発行されたイベントの場合は事情が異なります。未定義イベントのクラスはLakeyのクラスパスに存在しないため例外が発生し、最終的にそのイベントは正常に処理されないまま失われます。 外部サービスのイベントスキーマが変更されるたびにLakey内部のロジックも変
blog エーアイの世界へようこそ! ― 怠惰なバックエンド開発者の反省 ― 動的CMS設計 2026年1月、本社に復帰して参加したプロジェクトは「観光コンテンツ管理システム(Pinlime)」でした。過去にある企業へ導入したプロジェクトを基盤に、最新アーキテクチャ上で再構築を進めていました。数多くの観光地リソースを一目で分かりやすく管理するため、JSON構造を柔軟に保存し、UIまで自由に変形できる形で設計が進められていました。 動的CMS設計 「雪岳山」のような自然景観には登山道入口や立入規制期間などのフィールドを、「博物館」のような施設には休館日や営業時間を、「レストラン」にはブレークタイムやビーガンメニューなどを入力できるよう、入力フォームをリアルタイムでレンダリングし、後からデータ構造が変わっても簡単に構造を変更できる教科書的なシステムでした。AIを使って分析してみても、大きな無駄がなく高い評価を得られる設計でした。 使いにくいシステム 開発者として、この構造は明らかに柔軟で魅力的でした。しかし、観光地データを入力するために入力フィールドを定義し、入力フィールド
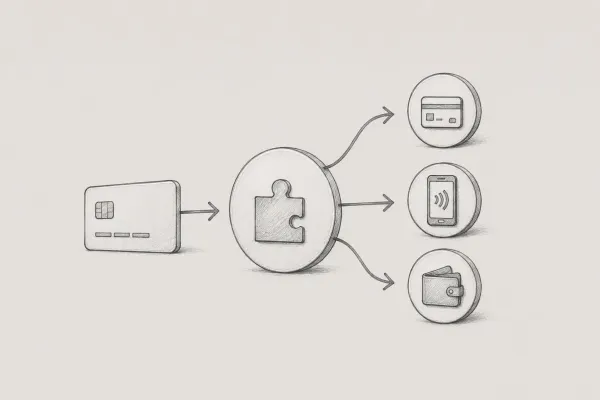
blog ストラテジーパターンを活用した柔軟な決済モジュールの実装記 決済モジュールの実装を始めるにあたって、最初に直面した課題は、単に「決済承認 APIをどのように呼び出すか」ではありませんでした。核心となるのは、「今後どのような決済代行会社(PG)が追加されても、サービスの決済フローを揺るがすことなく、一貫した決済体験を提供できるか」でした。 初期MVPの目標はト* ペイメンツ(T***Payments)との連携でしたが、今後、決済手段、精算条件、海外決済対応(Stripeなど)、顧客企業の要件に応じて、複数のPGを同時にサポートしなければならない状況が発生する可能性があります。そこで、単純なAPI連携を超えて、次のような目標を設定しました。 * さまざまなPG連携コードを一つに集約し、断片化を防ぎます。 * 新しいPGを容易に追加できる構造的な拡張性を確保します。 * 決済データを内部DBに保存し、追跡およびデバッグを容易にします。 1. if-else分岐処理の限界とStrategy Patternの導入 さまざまなPGとの連携を決済
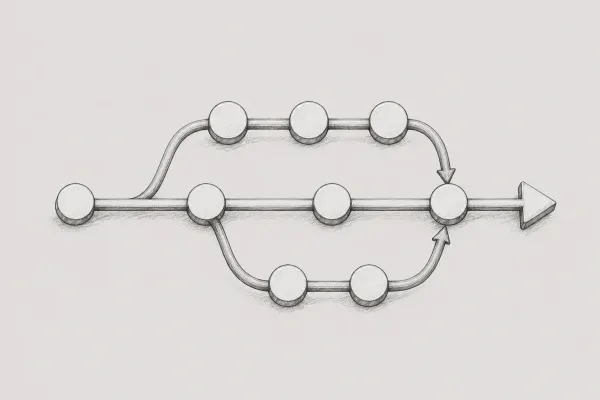
blog Gitブランチ戦略 1. はじめに Gitブランチは「機能ごとに分けるためのツール」程度に考えがちですが、実際の業務におけるブランチ戦略は、協業方法、開発環境へのデプロイとテスト、QA検証、運用環境へのデプロイ、hotfix対応まで直接つながっています。複数人が同時に開発し、決められたスケジュールに合わせてデプロイしなければならない環境では、特にブランチ戦略が単なるGitの使い方を超えて、チームの仕事の進め方そのものになります。 最初は、Git FlowやGitHub Flowのような名前の付いた戦略を基準に、実務でのブランチ構成を理解しようとしました。しかし、実際のプロジェクトで目にしたブランチ戦略は、教科書と完全に一致するものではありませんでした。feature、develop、stage、prod、releaseなどのブランチがあっても、実際の運用方法は、デプロイ周期、QA方式、人数規模、CI/CD環境、承認手順に応じて変形していました。 この記事では、代表的なブランチ戦略を簡単に整理したうえで、実際に経験した環境ブランチとデプロイ候補ブランチの構成を中心に説明します。こ
blog LLM自動翻訳:ネストされたオブジェクトとリスト構造の拡張 1. はじめに 前回の作業では、LLM自動翻訳機能を非同期イベントフローとして分離する構成を扱いました。保存リクエスト内でLLMを直接呼び出すのではなく、翻訳が必要な状況をイベントとして発行した後、別のフローで翻訳を実行するように構成しました。今回の作業は、その後続拡張に近い内容です。 従来の構成は、エンティティが直接持つ多言語フィールドを翻訳することに重点を置いていました。しかし実際のドメインモデルでは、多言語文字列が常にエンティティの直接フィールドにのみ存在するとは限りません。エンティティ内部の値オブジェクト(Value Object)に多言語フィールドが含まれていたり、値オブジェクトがリスト形式で存在したりする場合も多くあります。 この記事では、LLM自動翻訳の対象をネストされたオブジェクトとリスト構造まで拡張する中で生じた技術的な検討事項を整理します。重要だったのは、単に翻訳可能な位置を増やすことではなく、識別子を持たないリスト構造をどのように安全に扱うか、そして共通機能のユーザーAPIをどのようにシンプルに維持するかという点でした。 2. 従
blog React環境における重複APIリクエストの改善 プロジェクトの規模が大きくなるほど、単に機能を実装することよりも、状態管理と非同期リクエストを効率的に処理することが重要になります。特に React ベースのアプリケーションでは、複数のコンポーネントが同じデータを共有し、さまざまな状態変化に応じて API を呼び出しますが、この構造が複雑になるほど、予期しない重複リクエストの問題が発生する可能性があります。 今回のプロジェクトでは、ログイン後のユーザー情報、権限情報、アクセス可能な業務データなどをグローバル Context に保存し、複数の画面で共通して使用する構造を適用していました。初期段階では正常に動作しているように見えましたが、機能が継続的に追加されるにつれて、同じ API が複数回呼び出されたり、以前のリクエストのレスポンスが最新のデータを上書きしたりする現象が発生しました。 最初はサーバーのレスポンス速度の問題だと考えていました。しかし、実際の原因を分析してみると、フロントエンド内部の状態管理構造と非同期処理方式に問題がありました。 この記事では、重複 API リクエストが発生した背景と原因の分析過
blog データバックフィルのためのリソース分離戦略 1. 序論:大容量データ再送(Backfill)アーキテクチャが直面する課題 現代の分散システムアーキテクチャにおいて、データパイプラインの安定性はサービスの存続に直結します。特にIoT、金融、あるいはリアルタイムモニタリングシステムで発生する時系列(TimeSeries)データは、1秒あたり数万件以上という高いスループット(Throughput)を要求されることが少なくありません。このような環境で、システム障害、ネットワーク切断、あるいはダウンストリーム(Downstream)データベースの一時的な停止によって失敗したデータを漏れなく再投入する再送(Backfill)プロセスは、バックエンドエンジニアにとって非常に難しい課題です。 多くの開発者が犯す過ちの一つは、失敗したデータを単純にループで再送したり、リアルタイムトラフィックが流れている共有メッセージキューにそのまま投入したりすることです。しかし、大規模な運用環境では、このようなアプローチがリアルタイムの正常なサービスまで停止させる連鎖障害(Cascading Failure)を引き起こします。 本技術
blog レビューサービスの品質改善 1. はじめに サービスを開発していると、画面を実装することよりも、その後のことを考える時間のほうが長くなる場合があります。 最近、観光地コンテンツサービスのレビュー機能を開発した際に、まさにそのような経験をしました。 レビュー機能とは、ユーザーが自分で感想を作成し、写真を登録できる機能です。 機能自体は比較的単純に見えます。ユーザーがレビュー内容を入力して画像をアップロードすると、サーバーに保存し、保存されたデータを再び画面に表示すればよいのです。 最初は、レビューが正常に登録され、閲覧できることに集中していました。しかし、機能の実装を終えた後、運用環境を基準に改めて見直してみると、思った以上に多くの疑問が生じました。 * ユーザーが想定外の文字列を入力したらどうなるのか。 * HTMLタグやスクリプト形式の入力が保存されたらどうなるのか。 * 画像ではないファイルを画像のようにアップロードしたらどうなるのか。 * レビューの編集過程で
blog AIで加速する個人、消化しきれないチーム - AIの活用によってコードやドキュメントの作成は速くなりましたが、それがそのままチームの進捗につながるわけではありません。個人の作業速度をチームの生産性につなげるために備えるべき吸収能力を、判断可能性、追跡可能性、復旧可能性という観点から確認します。 最初は、自分が使っていたAIワークフローを整えてチームに共有すれば十分だと思っていました。ルールとコマンドを整理して共有すれば、自分が実感した速度向上をチームにも広げられると期待していました。 しかし、実際のボトルネックは別のところにありました。AIのおかげでコードやドキュメントはすぐに作成できましたが、その速度がチームの速度として十分に発揮されることはありませんでした。 この違いがなぜ生じるのかを調べているうちに、吸収能力(Absorptive Capacity)という概念を知りました。組織論でいう、外部の知識や情報の価値を認識し、それをチーム内部の能力に変えて活用する能力です。 AIが作成したコードやドキュメントも、最初は外部の知識に近いものです。見た目にはチーム内に存在していても、すぐにチームの能力に
blog MongoDB Online Archiveの検索戦略を再設計 1. 問題の始まり:ストレージコストの増加 サービスの運用期間が長くなるにつれて、MongoDBのストレージ容量も継続的に増加しました。 ビジネス要件上、すでに生成されたデータを削除することはできませんでしたが、すべてのデータを通常のストレージに継続して保持することは、コスト面で大きな負担になりつつありました。 特にOnline Archiveの適用対象となった特定のコレクションにはサービスの中核データが含まれており、データが継続的に蓄積されることで、約1.2TBの規模まで増加した状態でした。 これにより、単なるストレージコストの問題ではなく、長期的なデータ運用戦略そのものを見直す必要がある状況になりました。 そこで、一定期間が経過したデータを別のストレージへ移行する方法を検討し、MongoDB Online Archiveを導入することに決定しました。 - 作成後365日が経過したデータはOnline Archiveへ移行する。 - この基準は、クエリパターンの分析に基づいて精緻に設計された値というよりも、ストレージコストの最適化を目的とし
blog JVMヒープ設定とOOMKilled 1. 概要 本プロジェクトでは、船舶のセンサーデータの異常値を検知してアラームを発生させる機能の導入が必要でした。これを実装するため、船舶ごとのセンサーデータを取得し、アラーム発生条件を検知したうえでアラームを発生させる日次バッチロジックを新たに開発しました。 これは開発環境の Kubernetes クラスターに Pod 形式でデプロイされたサービス上で実行され、1日に1回実行することで船舶ごとのアラーム発生統計データを蓄積できると考えていました。しかし予想に反して、ロジックの実行中に Pod が再起動する問題が繰り返し発生しました。 2. 問題の状況 ロジックが実行されるたびに Pod が再起動する原因を確認したところ、OOMKilled(Out Of Memory Killed)、つまりコンテナがメモリ制限を超過し、OOM Killer によって強制終了されていることが分かりました。船舶の大容量データを処理するには Memory Limit の設定が小さすぎるのかと思い、Pod の Memory Limit を増やしてみましたが、それでも問題は解決
blog Loopinメッセンジャー開発記 1. はじめに(Introduction) 1.1 プロジェクトの背景 従来の古いメッセージングサービスの構造は、変化するウェブ環境に対応することが難しく、保守の面でも多くの課題がありました。本プロジェクト「Loopin」は、このようなSmalltalkシステムを廃止し、最新のVizendプラットフォームへ再構築(Refactoring)することを目標として始動しました。 メッセンジャーサービスの核心的な価値は、「ユーザー間の断絶のないリアルタイムコミュニケーション体験」にあります。これを実現するために直面した技術的課題は、大きく2つありました。1つ目は、従来のHTTPプロトコルによる一方向のリクエスト・レスポンスモデルから脱却し、クライアントとサーバーが永続的なコネクションを確立して、遅延なくメッセージを送受信できるメッセージングチャネルを構築することです。2つ目は、コラボレーションとコミュニケーションの効率を最大化するため、ユーザーが現在接続中かどうかをリアルタイムに判定して画面に表示する接続状態管理(Presence)エンジンを実装することでした。
blog DBスキーママイグレーションツール、どう選ぶ? MSA・DDD環境におけるFlyway・Liquibase・Bytebase・Atlasを比較し、状況に応じてどれを選ぶべきか整理しました。 1. スキーマは止まらずに変わる DDDとMSA、クラウドネイティブ環境では、DBスキーマは固定資産ではありません。サービスを運用している間、絶えず変化し続けます。 理由はドメインにあります。エンティティとアグリゲートは、ドメインへの理解が深まるほど、ともに変化します。属性が追加され、ひとまとまりだった概念が二つに分かれ、カラムだった値が独立したテーブルへ昇格します。モデルが進化すれば、スキーマも進化します。 これをツールなしで手作業で ALTERだけ実行すると、環境ごとにスキーマが食い違います。マイグレーションツールは変更をバージョンで管理し、どの環境でも同じ順序で同じ状態に到達できるよう保証します。 MSAでは、ここに分散が加わります。サービスごとに独自のDBを持つ Database per Serviceでは、マイグレーションもサービス単位で行われます。中央からDDLを一度に適用するのではなく、複数
blog 企画からテストまで、開発サイクル体験記 1. はじめに 一つの画面がユーザーに届けられるまでには、思っている以上に多くの工程があります。企画からパブリッシングの依頼、開発、テストまで、一つの流れとしてつながっています。今回は、パブリッシングを除くほとんどの工程を自分で担当して進めました。 この記事は、成果物の紹介というより、その過程を振り返る記録です。一つのサイクルを実際に経験しながら、どのようなことを悩み、どこで難しさを感じ、次に何を改善できるのかを整理してみたいと思います。 2. 企画 — 開発者ではなくユーザーの視点から 企画段階で最も悩んだのは、ユーザーの利用フローでした。開発をしていると、実装が単純な方向へ自然と考えが傾くことがあります。しかし、ユーザーが実際にどのような操作を繰り返すのかを、まず思い浮かべるようにしました。 代表的な例が、一覧で項目の状態を変更する機能でした。開発者の視点では、行をクリックして詳細画面へ移動し、値を変更して保存する方法が最も単純です。画面構成も明確で、実装の難易度も低くなります。 しかし、実際の利用シナリオを考えてみると、ユーザーは複数の項
blog キャッシュ戦略で解決した応答遅延問題 1. 概要 マイデータサービスの運用を担当する中で、最初に直面した課題は、ユーザー数が急速に増加する中で発生したメイン画面の応答遅延でした。サービス初期には大きな問題にならなかった構造が、ユーザー規模の拡大に伴い、体感的な遅延という形で表面化しました。本稿では、当時どのように問題を診断して解決したのか、そしてその解決策が今振り返ると、どのような技術的な流れにつながっていたのかを整理します。 当時のサービスは Vue 2 ベースの WebApp で、キャッシュはクライアントではなくサーバー側に実装されていました。この点で、現在のデータフェッチングライブラリが標準で提供するクライアントメモリキャッシュとは、キャッシュが置かれるレイヤー自体が異なります。ただし、「古いデータを先に表示し、バックグラウンドで更新する」という戦略そのものは、現在 Vue の分野で使われている TanStack Query(旧称 Vue Query)や、React の分野で使われている SWR が標準で提供する Stale-While-Revalidate(以下、SWR)キャッシュ戦略と本質
blog OpenHTMLtoPDFの適用経験 1. はじめに プロジェクトを進める中で、ユーザーが見積書や文書データをPDF形式でダウンロードできる機能が必要になりました。 当初は単純にPDFファイルを生成すればよいと考えていましたが、実際に検討を進めると、さまざまな考慮事項がありました。 * ハングル出力対応 * レイアウト修正のしやすさ * ライセンスの問題 * 開発生産性 * 保守性 特に、文書様式の変更依頼が頻繁に発生する業務の特性上、PDF生成そのものよりも、レイアウトをどれだけ容易に修正できるかが重要な要件でした。 そこで、複数のPDFライブラリを検討し、プロジェクトに適した技術を選定するプロセスを進めました。 2. ライブラリの検討 iText iTextは、Java分野で最も広く知られているPDFライブラリです。 機能が豊富で参考資料も多いため、実装の難易度は比較的低いものでした。 しかし、商用利用時にはライセンス上の制約
blog MSAの品質管理をCIゲートで解決する 1. 品質管理体制をCIに置くことにした理由 私はDevOpsエンジニアとして、現在あるMSAコンサルティングに参加しています。コンサルティングというと、通常はサービス境界やドメイン分離などの設計を思い浮かべると思いますが、私が担当した領域はそこではなく、品質管理体制でした。この記事は、その作業に関する記録です。 品質管理というと、コードスタイル、静的解析、テストカバレッジ、イメージの脆弱性スキャンといった項目が思い浮かびます。項目自体に目新しさはありません。本当に難しかったのは、「これをどこで、どの程度の強制力で実行するのか」でした。MSAでは、この問いが思った以上に重くなります。 サービスを細かく分割すると、デプロイ単位もそれだけ増えます。それまで一つだったデプロイが十個、二十個に分かれ、各サービスがそれぞれ異なる周期で本番環境に投入されます。このような状況で品質項目を「できるだけ守ろう」というレベルの推奨事項にしておくと、サービスが増える速度に品質上の抜け漏れが追いついてしまいます。実際、私が最初に参加したときがまさにその状態でした。 そこで、まず
blog 産業用IoTの標準、MQTT 1. 産業用 IoT とデータ収集 近年、製造現場では設備状態のモニタリング、生産データの分析、遠隔管理など、さまざまな目的で IoT 技術が活用されています。PLC、センサー、ロボットなどの機器は継続的にデータを生成しており、これらのデータを効果的に収集・活用することは、スマートファクトリー構築における重要な要素の一つです。 しかし、産業現場にはさまざまなメーカーの機器や複数の通信プロトコルが混在しており、収集したデータをモニタリングシステム、データストレージ、分析システムなど複数の場所で同時に活用しなければならない場合も多くあります。そのため、機器とシステム間でデータを効率的に伝送できる通信方式が必要です。 MQTT(Message Queuing Telemetry Transport)は、こうした要件を満たすために広く使用されているメッセージングプロトコルです。軽量な構造と高い拡張性を基盤として、産業用 IoT 環境におけるデータ収集および伝送の中核的な役割を果たしています。 2. 産業用 IoT 環境の特徴 産業現場におけるデータ収集環境
blog ESLintとPrettierでコードスタイルを統一する 1. 背景 前回の記事では、モノレポ(Monorepo)ベースの物理構造設計について取り上げました。今回はその上でコードを記述する開発者間のコーディングルールを統一する方法について説明します。 プロジェクトの規模が大きくなるほど、同じファイルを複数の開発者が修正する機会が増え、インデントや引用符のスタイルの違いによる不要なGit diffが継続的に発生していました。このようなスタイルの違いは単なるコード形式の問題にとどまらず、コードレビューの過程で繰り返し議論を引き起こし、結果的にレビュー疲れを高める要因となっていました。 社内Wikiにガイドラインを整理するだけではこの問題の解決に限界があり、コードがリモートリポジトリに反映される前に、開発者のミスに関係なくルールを強制できる自動化された仕組みが必要でした。 この記事では、Vue 3とTypeScriptの環境を前提に、ESLintとPrettierを活用してコード規約を定着させた過程と、VS Code・IntelliJの環境で同じルールを適用する方法を共有します。 2. ESLintとPret
blog フィクスチャベースのテストデータ構成 1. はじめに プロジェクトを進めていると、「テストコードを書かなければならない」と分かっていても、スケジュールに追われて後回しにしてしまうことがよくあります。私も同じでした。バックエンドサービスを開発する中で、初期段階ではテストコードを書かず、Insomniaや画面を通じて手動で機能を確認していました。しかし、サービスの規模が大きくなり、ドメイン間の関係が複雑になるにつれて、1つの機能を修正した際に別の機能へ影響を与えるケースが次第に増えていきました。手動テストだけでこれらすべての経路を毎回確認するのは難しく、コードを修正した後に予期しない機能でエラーが発生することもしばしばありました。こうした経験をきっかけに統合テストを本格的に追加するようになり、この記事では、その中でもテストデータを準備するFixtureの設計に焦点を当て、経験を共有したいと思います。 2. テスト環境の概要 統合テスト環境は次のように構成しました。@SpringBootTestとH2インメモリDBを利用してアプリケーション全体のコンテキストをロードしつつ、外部DBなしでテストを実行
blog あれほどあったトークンを食べ尽くしたのは誰? LLMを業務で活用していると、最初はプロンプトをどれだけ短く明確に書くかが最も重要に思えます。私も当初は、トークンを節約するには自分が入力する文章を短くすればよいと考えていました。 しかし、Codexのようなエージェント型開発ツールを使うようになって、考えが変わりました。実際のトークンの浪費は、ユーザーが直接書いた文章よりも、ツールが返したデータによって大きく発生する可能性があります。MCP、ファイル検索、コードの読み取り、ターミナルの実行結果などの外部ツールが接続されると、モデルのコンテキストはユーザーのプロンプトではなく、ツールの出力によって急速に埋め尽くされます。 この問題を直接実感したのは、FigmaとStorybookを同期する作業をしていたときでした。FigmaのデザインをStorybookのコンポーネントに合わせるためにFigma MCPを呼び出したのですが、私が必要としていた情報は、レイアウト、色、Typography、間隔、variant程度でした。しかし実際のレスポンスには、Figmaコンポーネントの変数、重複したメタデータ、関係のない内部プロ
blog 要件、IA、フローチャートの作成 1. はじめに:企画者は「画面」ではなく「プロセス」を設計する IT業界では、サービス企画者の役割を「スケッチを描いて画面を作る人」と誤解しがちです。デザインツールを活用してボタンを配置し、ワイヤーフレームを作成する作業が最も目立つためです。 しかし、視覚的な画面は、企画者が定義した数多くの論理やポリシーが最終的に表現された「成果物」にすぎません。本当の企画者の役割は、ビジネス上の曖昧な要件を、開発とデザインが可能な「構造化言語」に翻訳し、サービスの開始からローンチ直前のQAまで、製品のライフサイクル(Product Life Cycle)全体を綿密に管理することです。 船舶の基準情報を管理する新規サービスを自ら構築しながら、企画の3大要素である要件、IA、フローチャートを通じて問題を解決し、成長してきた実務の経験を共有したいと思います。 2. 要件分析および定義:画面を埋めることに追われていた日々から発見したSRSの核心 プロジェクトを進めていると、現場担当者や顧客から「この画面にこの情報も表示してほしい」「あの機能も追加してほしい」といった数多
blog アンケート管理サービスの実装事例 1. プロジェクトの背景および技術選定 アンケートサービスは、患者が直接報告する結果(PRO、Patient-Reported Outcome)を扱う医療アンケートプラットフォームの中核サービスであり、アンケートフォームの定義から配信、回答収集、締め切りに至るまで、アンケートの全ライフサイクルを担います。採点・統計・レポート加工は別のメトリクスサービスが、通知・チャット・SMS/メールの実際の送信は別のコミュニケーションサービスが担当するよう責任を明確に分離し、本サービスは「アンケートデータの定義と収集」という単一責任に集中するよう設計しました。 多数の内部マイクロサービスおよび外部のレガシー医療情報システム(EMR)と連携する環境で、データ整合性と拡張性を確保するため、以下の技術スタックを戦略的に選定しました。 • Java 21 & Spring Boot 3.5.13 : 最新のLTSランタイムと安定したSpringエコシステムを基盤として、サービスの信頼性を確保しました。 • Spring Cloud 2025.0.0 (OpenFeign) :