
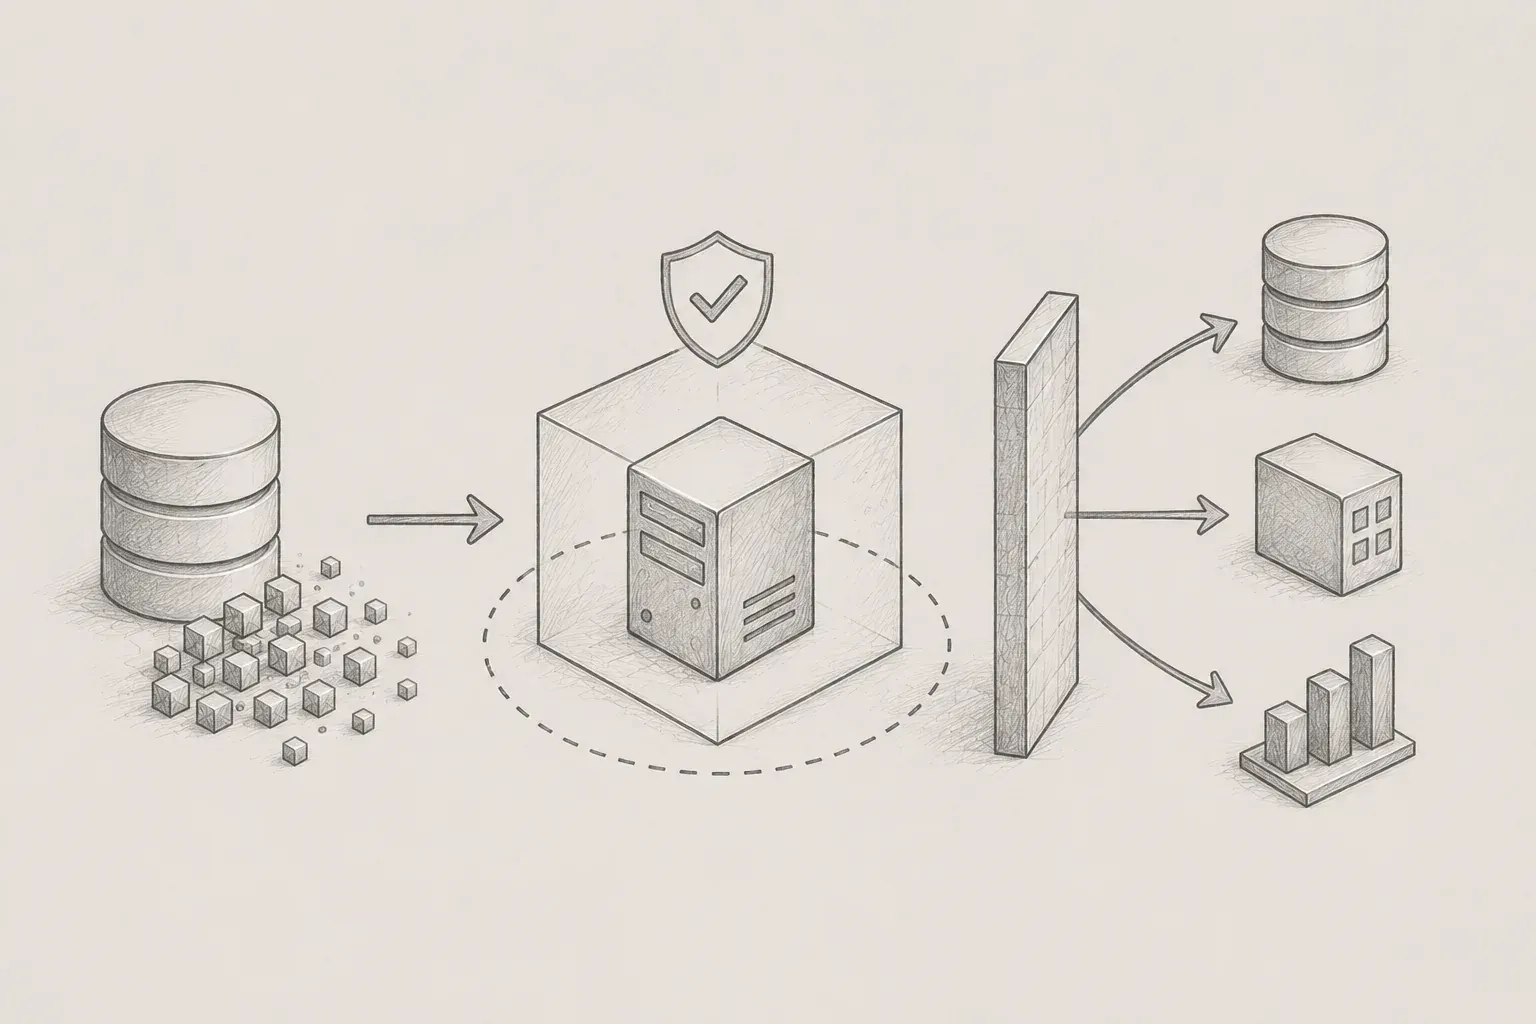
1. 序論:大容量データ再送(Backfill)アーキテクチャが直面する課題
現代の分散システムアーキテクチャにおいて、データパイプラインの安定性はサービスの存続に直結します。特にIoT、金融、あるいはリアルタイムモニタリングシステムで発生する時系列(TimeSeries)データは、1秒あたり数万件以上という高いスループット(Throughput)を要求されることが少なくありません。このような環境で、システム障害、ネットワーク切断、あるいはダウンストリーム(Downstream)データベースの一時的な停止によって失敗したデータを漏れなく再投入する再送(Backfill)プロセスは、バックエンドエンジニアにとって非常に難しい課題です。
多くの開発者が犯す過ちの一つは、失敗したデータを単純にループで再送したり、リアルタイムトラフィックが流れている共有メッセージキューにそのまま投入したりすることです。しかし、大規模な運用環境では、このようなアプローチがリアルタイムの正常なサービスまで停止させる連鎖障害(Cascading Failure)を引き起こします。
本技術文書では、高速メッセージングインフラであるNATS、Javaの高性能ノンブロッキングデータ構造であるConcurrentLinkedQueue、そしてSpringのカスタム非同期スレッドプール(@Async)を有機的に組み合わせ、リアルタイムトラフィックを完全に保護しながら、数百万件に及ぶ蓄積された時系列データを安定かつ効率的に再送したシステム高度化の経験と、その最適化戦略について詳しく説明します。
2. 既存アーキテクチャの限界と技術的なペインポイント(Pain Point)
高度化以前の初期システムは、一つのメッセージングパイプライン内でリアルタイムトラフィックと再送トラフィックを同時に処理する単純な構成でした。この構成は小規模なテスト環境では問題を露呈しませんでしたが、運用環境で大規模なバックフィル処理がトリガーされた瞬間、次のような三つの致命的なボトルネックを引き起こしました。
2.1. リソース枯渇(Resource Exhaustion)によるリアルタイムサービスの停止
リアルタイムのユーザーリクエストとバックフィルリクエストが、共有HTTPスレッドプールと単一のメッセージキューリソースを共有していました。そのため、数百万件のバックフィルデータが流入すると、再送ワーカースレッドがCPU、メモリ、スレッドリソース全体を独占することになりました。その結果、リアルタイムで受け付けるべき重要なリクエストがスレッドを割り当てられず、無期限に待機した末にConnection Timeoutで失敗するという大惨事が発生しました。
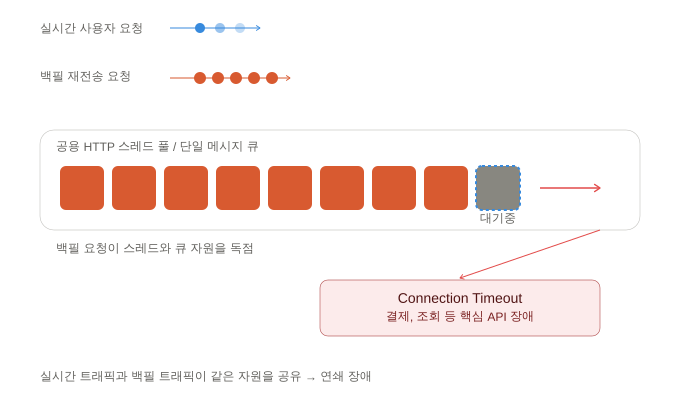
図1. リアルタイムリクエストとバックフィルリクエストが同一リソースを共有した場合に発生するリソース枯渇の問題
2.2. 時間ベース(Time-based)スケジューリングによる負荷スパイク
キューに蓄積されたバックフィルデータをダウンストリームデータベース(PostgreSQL)に格納する際、初期段階では「10秒ごとにスケジューラーを実行してキューを完全に空にする」といった時間中心のロジックを使用していました。これはデータ流入量が不規則な場合に予測不能性を高めます。特定の10秒間にデータが爆発的に蓄積されると、次のスケジューリング時刻に数万件のクエリが一斉にデータベースへ投入され、コネクションプールが停止し、DBのCPU使用率が100%に達する「トラフィックスパイク(Spike)」現象が頻繁に発生しました。
2.3. スレッドブロッキング(Thread Blocking)によるリソースの浪費
バックフィルデータの再送がすべて完了した時点を確認し、最終統計集計(Aggregation)プロセスをトリガーする過程で、「すべてのデータが処理されるまでしばらく待機する」という名目でThread.sleep()やCountDownLatchのような同期的ブロッキング機構を使用していました。これにより、待機状態のスレッドがメモリを保持し続け、頻繁なコンテキストスイッチ(Context Switching)を引き起こすため、システム全体のリソース効率が著しく低下していました。
3. 分離と最適化のための4つのアーキテクチャ高度化戦略
上記三つの限界を克服するため、インフラレイヤーからアプリケーションのデータ構造、さらにスレッドモデルに至るまで、全体の構造を完全に分離するBulkheadパターン(隔壁分離アーキテクチャ)を導入しました。
3.1. インフラおよびデータ構造レイヤーの分離:NATSとConcurrentLinkedQueue
最初に行ったのは、トラフィックを徹底的にルーティング分離することでした。リアルタイムデータ用トピックとバックフィル専用トピックをインフラ(NATS)レベルで分離し、Javaアプリケーション内部には、バックフィルデータのみを安全に受け入れるための独立したメモリバッファキューを@Beanとして登録しました。
@Configuration
public class QueueConfig {

    @Bean
    public Queue<TimeSeriesVo> backfillTimeSeriesVoQueue() {
        // 다중 스레드 환경에서 Lock-Free 고성능을 보장하는 논블로킹 큐 선택
        return new ConcurrentLinkedQueue<>();
    }
}
ここで重要なのがConcurrentLinkedQueueの選択です。一般的なLinkedBlockingQueueやArrayBlockingQueueでは、ProducerとConsumerのスレッドがキューにアクセスする際にロック(Lock)を取得する必要があるため、同時実行競合が激しい場合に待機によるボトルネックが発生します。一方、ConcurrentLinkedQueueはロックを使用せず、CPUレベルのアトミック操作であるCAS(Compare-And-Swap)アルゴリズムに基づいて動作します。ネットワーク応答速度が非常に高速なNATSコンシューマーが1秒あたり数万件のデータを投入しても、ワーカースレッドと衝突することなく、ノンブロッキング(Non-blocking)で安全にデータをメモリへ受け入れられる緩衝地帯として機能します。
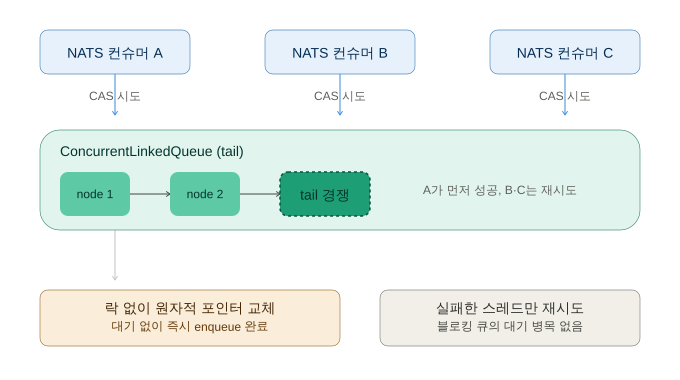
図2. 複数のNATSコンシューマースレッドがCASアルゴリズムによってロックなしでキューにデータを格納する方式
3.2. スレッドレイヤーの分離:@Async("backfillTimeSeriesPool")
NATSとメモリキューを通じてデータを安全に受け取ったとしても、それを取り出して実際のビジネスロジックを実行し、DBに格納するワーカーがWebサーバーのメインスレッドプールを共有しているなら、前述のリソース枯渇問題は解決されません。
そこでSpringの@Asyncメカニズムを活用し、バックフィル処理だけを担当する独立したカスタムThread Poolを構築しました。
@Configuration
@EnableAsync
public class AsyncConfig {

    @Bean(name = "backfillTimeSeriesPool")
    public Executor backfillTimeSeriesPool() {
        ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
        executor.setCorePoolSize(5);          // 기본 유지할 스레드 개수
        executor.setMaxPoolSize(10);          // 트래픽 폭발 시 최대 확장 스레드 개수
        executor.setQueueCapacity(500);       // Task 대기 큐 용량
        executor.setThreadNamePrefix("backfill-task-");
        executor.setRejectedExecutionHandler(
            new ThreadPoolExecutor.CallerRunsPolicy());
        executor.initialize();
        return executor;
    }
}
このように分離されたスレッドプールを宣言し、バックフィルを処理する非同期ワーカーコンポーネントに注入します。
@Component
public class BackfillWorker {

    private final Queue<TimeSeriesVo> backfillTimeSeriesVoQueue;
    private final TimeSeriesRepository timeSeriesRepository;

    public BackfillWorker(
            Queue<TimeSeriesVo> backfillTimeSeriesVoQueue,
            TimeSeriesRepository timeSeriesRepository) {
        this.backfillTimeSeriesVoQueue = backfillTimeSeriesVoQueue;
        this.timeSeriesRepository = timeSeriesRepository;
    }

    @Async("backfillTimeSeriesPool")
    public void processBackfill() {
        // 공용 HTTP 스레드를 전혀 오염시키지 않고, 백필 전용 스레드(backfill-task-) 내에서만 안전하게 루프 구동
        List<TimeSeriesVo> chunkList = new ArrayList<>();
        while (!backfillTimeSeriesVoQueue.isEmpty()) {
            TimeSeriesVo vo = backfillTimeSeriesVoQueue.poll();
            if (vo != null) {
                chunkList.add(vo);
                // 3.3 섹션에서 서술할 크기 기반 청크 처리 로직이 여기에 위치함
                if (chunkList.size() >= 1000) {
                    timeSeriesRepository.saveAll(chunkList);
                    chunkList.clear();
                }
            }
        }
        if (!chunkList.isEmpty()) {
            timeSeriesRepository.saveAll(chunkList);
        }
    }
}
この設計により、バックフィル処理が数時間にわたって重い処理としてバックグラウンドで実行されても、ユーザーのリアルタイムリクエストを処理するhttp-nio-スレッドは完全に分離され、0.1秒未満の高性能な応答速度を安定して維持できるようになりました。
3.3. バックエンドのフロー制御(Flow Control):サイズベース(Size-based)のチャンク抽出
時間ベースのスケジューラーによる無差別なDB投入の問題を解決するため、システムの限界容量内で最適な速度を維持できるよう、Size-based Extraction(サイズベースの抽出)方式へとパラダイムを転換しました。
スレッドがキューからデータを取り出す際、時間の経過には依存せず、データ数(Chunk Size)のみを基準とします。データベース(PostgreSQL)がインデックス更新およびコネクション負荷の面で最も安定して受け入れられる最適なバルク単位を算定し、キューにデータが蓄積されるたびに、指定されたサイズに分割して継続的にDBへ投入します(poll())。
このフロー制御により、バックフィルデータが数十万件以上急激に流入しても、データベースが一度に停止する最悪の事態を防ぎ、システムのしきい値内で負荷の上限を制御しながら、段階的にバルクインサート(Bulk Insert)を完了できる構造的な安定性を確保しました。
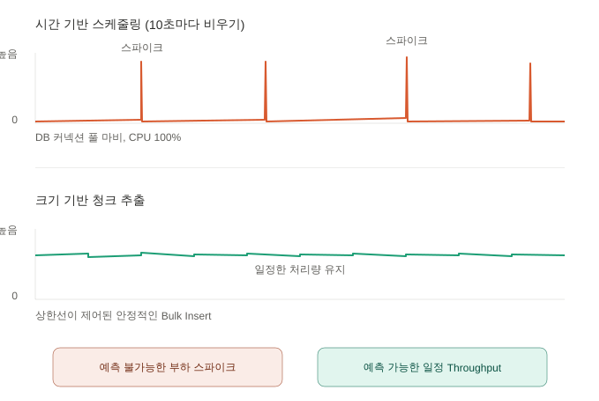
図3. 時間ベースのスケジューリングは負荷スパイクを引き起こすが、サイズベースのチャンク抽出は一定の処理量を維持する
3.4. 非同期リソースの最適化:制御フラグとisEmpty()によるノンブロッキング完了検証
バックフィルデータの再送が完全に完了した後、システムは最終的なデータ整合性を確保するために集計(Aggregation)処理を実行する必要があります。従来のスレッドブロッキング方式を廃止し、完全な非同期フローを実現するため、Control Flag(制御フラグ)とキュー状態の検証を組み合わせました。
NATSプロトコルを通じてデータ転送の終了を知らせるバックフィル完了シグナル(End-of-Stream Flag)がコンシューマーに到達すると、システムは状態フラグをCOMPLETINGへ切り替えます。その後、ワーカースレッドはスリープや待機をせず、ノンブロッキングでメインキューの状態を確認します。
public void checkAndTriggerAggregation() {
    // 스레드를 재우는 오버헤드 없이, 락 프리로 큐의 공백 상태를 체크
    if (isEndOfStreamSignalReceived && backfillTimeSeriesVoQueue.isEmpty()) {
        // 대기 시간 0초 만에 즉시 최종 집계 프로세스 비동기 트리거
        aggregationService.triggerFinalAggregation();
    }
}
backfillTimeSeriesVoQueue.isEmpty()がtrueを返した瞬間に、CPUの遅延やスレッドのアイドル状態を発生させることなく、最終集計ロジックがトリガーされます。
また、分散非同期環境の特性上、ネットワーク遅延によって「バックフィルデータリクエスト」と「成功レスポンスの受信」の順序が逆転する一部のレースコンディション(Race Condition)に対処するため、特定の正常レスポンスイベントを受信した際に、それをまずメモリ内のホワイトリスト(Whitelist)へ登録して相互検証するロジックを追加し、データ損失の可能性を低減しました。
4. 結論:インフラとソフトウェアの調和から得られる教訓
今回の高度化プロジェクトから得られた最も価値ある教訓は、「どれほど高速な高性能分散インフラ(NATS)を導入しても、それを受け止めるバックエンドアプリケーション内部のデータ構造、スレッドモデル、フロー制御戦略が脆弱であれば、ボトルネックは場所を移して最終的に再び発生する」という点です。
インフラレベルでのトピック分離、Spring設定による@Asyncカスタムスレッドプールの分離、ConcurrentLinkedQueueによるロックフリー(Lock-Free)バッファリング、そしてサイズベースのチャンク制御という連鎖が有機的にかみ合って初めて、真の意味での大容量データパイプラインが完成しました。
システムのリソース消費を劇的に削減しながらも、大規模な再送環境でデータ整合性を完全に保証した今回のアーキテクチャ改善の経験は、限られたコンピューティングリソースの中でトレードオフ(Trade-off)を調整し、どのような極限のトラフィック状況でも揺るがない堅牢なシステム安定性を確保するための足掛かりとなりました。
Pancake Maker