
1. 概要
マイデータサービスの運用を担当する中で、最初に直面した課題は、ユーザー数が急速に増加する中で発生したメイン画面の応答遅延でした。サービス初期には大きな問題にならなかった構造が、ユーザー規模の拡大に伴い、体感的な遅延という形で表面化しました。本稿では、当時どのように問題を診断して解決したのか、そしてその解決策が今振り返ると、どのような技術的な流れにつながっていたのかを整理します。
当時のサービスは Vue 2 ベースの WebApp で、キャッシュはクライアントではなくサーバー側に実装されていました。この点で、現在のデータフェッチングライブラリが標準で提供するクライアントメモリキャッシュとは、キャッシュが置かれるレイヤー自体が異なります。ただし、「古いデータを先に表示し、バックグラウンドで更新する」という戦略そのものは、現在 Vue の分野で使われている TanStack Query(旧称 Vue Query)や、React の分野で使われている SWR が標準で提供する Stale-While-Revalidate(以下、SWR)キャッシュ戦略と本質的に同じ方向性でした。本稿では、問題の診断から解決策の設計、適用結果、そして SWR の観点からの再解釈までを扱い、トレンドを意識しなくても同じ結論にたどり着けた理由についても考察します。
2. 問題の状況:メイン画面の応答遅延
2-1. 既存の構造
マイデータサービスの中心的な価値は、ユーザーがメイン画面に入るとすぐに、複数の金融機関に登録された資産・取引情報を1つの画面にまとめて表示することでした。そのため、画面に入るたびにアクティブユーザーの情報をリアルタイムで取得し、最新データを表示する方式を採用していました。サービス初期はユーザー数が少なかったため、この構造でも大きな問題はなく、むしろ「常に最新データを表示する」というシンプルで明確な設計原則が利点として働いていました。
2-2. 問題が顕在化した箇所
ユーザー数が増えるにつれて、問題が徐々に明らかになりました。画面に入るたびに複数の外部機関へ同時多発的に照会リクエストを送る構造だったため、同時接続ユーザーが増えるほど、外部からの応答待ち時間がそのままユーザーの体感遅延として蓄積されました。運用モニタリング指標から、メイン画面に入ってから画面が表示されるまでの時間が、ユーザー数の増加傾向に比例して長くなるパターンを確認できました。
特に、外部機関の一部で応答が遅くなった場合、その遅延が画面全体の読み込み時間を押し下げるという構造的な脆弱性も明らかになりました。「常に最新データを表示する」という原則を守るための構造が、ユーザー規模の拡大に伴い、かえってサービス全体の体感性能を左右するボトルネックになったのです。この時点で明確になったのは、すべての画面遷移で100%最新のデータを保証する構造と、ユーザーがすぐに画面を表示できる構造を同時に満たすことは難しいという点でした。2つの価値のうち一方を優先し、設計を見直す必要がありました。
3. 解決戦略:キャッシュ優先レンダリング+バックグラウンド更新
3-1. 設計原則
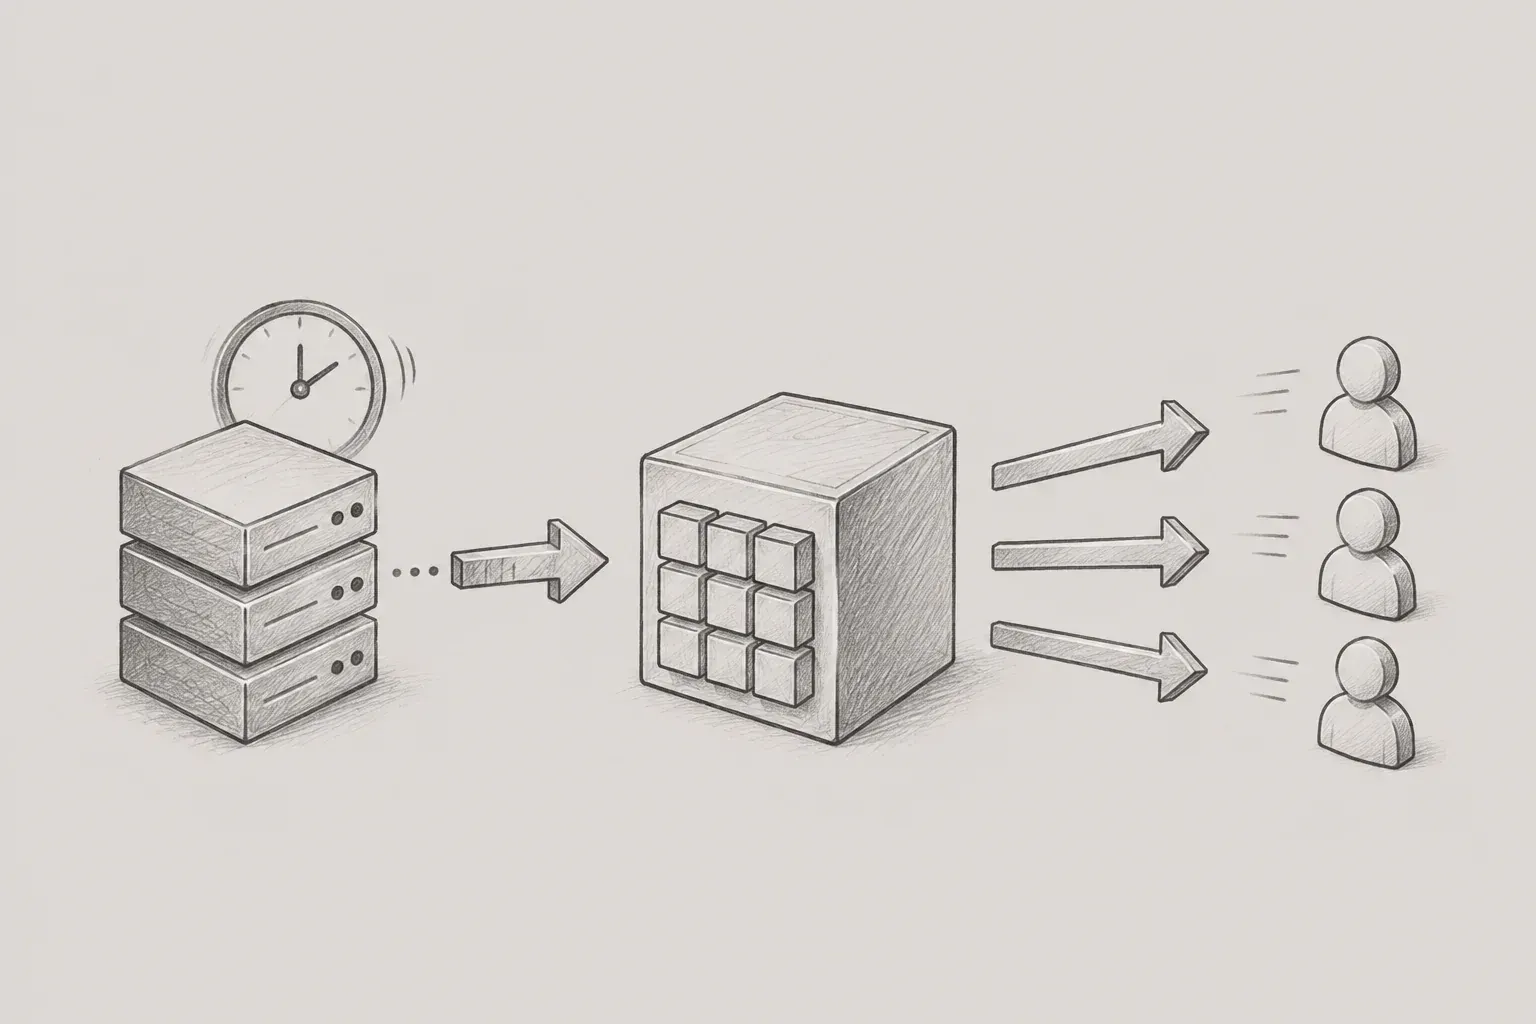
問題を再定義する中で採用した原則は、「即時応答」と「最新性の確保」を1つのリクエスト内で同時に処理せず、2段階に分離することでした。画面に入った時点では、直近に取得・保存されたデータをすぐに表示し、その直後にバックグラウンドで最新データを再取得して画面を更新する方式です。ユーザーは空白画面やローディング状態を長く見続ける代わりに、すぐに意味のある情報を受け取ることができ、少し時間を置いて最新情報へ自然に切り替わる体験を得られます。
この原則を適用するには、直近の取得結果を保存しておくキャッシュストレージと、画面表示用のデータ取得と更新用の取得を分離して処理できる非同期処理構造が必要でした。
3-2. 処理フロー
処理フローを擬似コードに整理すると、次のようになります。
function 메인화면진입(사용자ID):
  캐시데이터 = 캐시저장소.조회(사용자ID)

  if 캐시데이터 존재:
    화면.즉시렌더링(캐시데이터)
  else:
    화면.로딩상태표시()

  비동기작업큐.등록(갱신작업, 사용자ID)
  return

function 갱신작업(사용자ID):
  최신데이터 = 외부기관조회.전체조회(사용자ID)
  캐시저장소.갱신(사용자ID, 최신데이터)
  if 화면.현재활성상태(사용자ID):
    화면.부분갱신(최신데이터)
この構造の核心は、画面のレンダリング経路とデータ更新経路を分離した点にあります。画面はキャッシュストレージだけを参照してすぐに応答し、外部機関への照会という負荷の大きい処理は別経路で非同期に実行されるため、画面の応答時間に影響を与えません。
3-3. メッセージキューによる更新処理の分散
更新処理を単に非同期で実行するだけでは十分ではありませんでした。同時接続ユーザーが増えるタイミングでは、更新処理そのものが一度に集中し、外部機関への照会リクエストが急増する可能性があったためです。これを緩和するため、更新処理をメッセージキューに投入し、ワーカーが一定の処理量でキューを消費する構成にしました。
ユーザー側では、画面に入るとすぐにキャッシュデータを受け取れるため、キューの処理速度に左右されず、体感応答速度が維持されました。システム側では、外部機関へのリクエスト量がキューによって平準化され、負荷が特定の時点に集中する現象が減少しました。
3-4. 構造の比較
[表1] 構造改善前後の比較
|
区分 |
既存の構造(As-Is) |
改善後の構造(To-Be) |
|---|---|---|
|
データ処理のタイミング |
画面遷移時にリアルタイムで全件取得 |
キャッシュによる即時応答+バックグラウンド更新 |
|
応答の特性 |
外部機関の応答速度に依存 |
キャッシュ取得速度によって応答時間を一定化 |
|
負荷の発生パターン |
同時接続時に外部照会リクエストが急増 |
メッセージキューによるリクエストの平準化 |
|
ユーザー体験 |
全件取得が完了するまで待機 |
即座にデータを表示した後、自然に更新 |
4. 適用結果
構造改善後に最も目立った変化は、画面に入った際の体感待ち時間が大幅に短縮されたことです。ユーザーは外部機関の応答速度に関係なく、常に一定の速度で画面を表示できるようになり、特定の機関の応答が遅くなっても、その影響が画面全体の読み込みに波及しなくなりました。
運用面でも、外部機関への照会リクエストがメッセージキューを通じて平準化されたことで、同時接続ユーザーが増える時間帯でも更新処理が安定して行われました。何より、「最新性」を諦めたのではなく、「最新性を保証するタイミング」を画面に入った時点から、その直後へずらしただけであるため、データの信頼性とユーザー体験の両方を守ることができました。
5. 今振り返ると:SWR パターンとのつながり
5-1. SWR パターンとは
Stale-While-Revalidate は、キャッシュされた(古い、Stale)データを先に返しながら、同時にバックグラウンドで検証(Revalidate)を行い、検証が完了すると最新データに置き換えるキャッシュ戦略です。この戦略には、メカニズムの異なる3つの形態があります。1つ目は HTTP プロトコルレベルで、Cache-Control: stale-while-revalidate ヘッダー(RFC 5861)をブラウザや CDN、リバースプロキシが参照し、キャッシュされたレスポンスを先に返した後、バックグラウンドで再検証します。2つ目はアプリケーションレベルで、プロトコルやライブラリに依存せず、キャッシュ取得とバックグラウンド更新のロジックをバックエンドコードで直接実装する方式です。3つ目はクライアントライブラリレベルで、TanStack Query や SWR. js のように、同じ戦略をブラウザメモリ上で宣言的に提供する方式です。
今回の事例は、このうちアプリケーションレベルに該当します。プロトコルやライブラリを借用したのではなく、同じ戦略を独自にコードへ落とし込んだ結果であるという点に意味があります。
5-2. 直接実装した方式とクライアントライブラリの実装比較
メカニズムのレイヤーは異なりますが、「古いデータを先に表示し、バックグラウンドで更新する」という戦略を実装の観点から比較すると、次のようになります。
[表2] 実装方式の比較
|
項目 |
当時、直接実装した方式 |
TanStack Query / SWR. js など |
|---|---|---|
|
キャッシュの保存場所 |
別途キャッシュストレージ(サーバー側) |
クライアントメモリ・ストレージ |
|
更新トリガー |
画面への遷移時に非同期タスクを登録 |
画面への遷移、フォーカス復帰、再接続など、さまざまなトリガー |
|
更新タスクの分散 |
メッセージキューに基づく処理量制御 |
リクエストの重複排除(Dedupe)、リトライポリシー |
|
実装難易度 |
直接設計・実装が必要 |
宣言的な設定ですぐに適用可能 |
5-3. 同じ結論に至った理由
当時は、Stale-While-Revalidateという名前も、このような戦略を標準で提供するプロトコルやライブラリの存在も知りませんでした。ただ、「ユーザーにすぐ表示するデータ」と「正確性を保証しなければならないデータ」は、同じタイミングに同じ方法で処理する必要がないということを、運用データを通じて実感しました。そして、その気づきを構造に反映した結果、自然と同じパターンに行き着きました。これは、優れたアーキテクチャパターンが特定の技術トレンドから始まるのではなく、実際の問題を正確に見つめる過程で独立して再発見されることが多いことを示す事例だと思います。
6. 限界とトレードオフ
この構造にも明確なトレードオフがありました。画面への遷移時に表示するデータは、定義上わずかに古い(Stale)データであるため、データの鮮度が重要な画面や機能にはそのまま適用するのが難しいです。また、キャッシュの無効化タイミングを誤って設計すると、ユーザーが実際よりも古い情報を長く見続けるリスクもあります。
実際には、画面ごとのデータ特性に応じて、キャッシュの保持時間と更新の優先順位を変える必要がありました。たとえば、資産総額のように表示頻度が高く、変動が比較的少ないデータはキャッシュの保持時間を長く設定し、取引履歴のように最新性が重要なデータはキャッシュの保持時間を短くし、更新の優先順位を高くしました。この基準を定める作業そのものが別途チューニング作業となり、一律の正解ではなく、データの性質に応じた個別の判断が必要でした。
7. 運用ガイドとしての定着
一度の構造改善で終わらせず、データの種類ごとのキャッシュ保持時間と更新優先順位の基準を、チーム内のガイドとして整理しました。新しい画面を追加するたびにキャッシュポリシーを最初から検討し直すのではなく、データの性質を以下の基準に照らして迅速に判断できるようにしたのです。
[表3]データの種類ごとのキャッシュ運用基準(例)
|
データの種類 |
キャッシュ保持時間 |
更新優先順位 |
|---|---|---|
|
資産総額 |
長め(変動頻度が低い) |
低 |
|
保有商品一覧 |
中程度(加入・解約の反映が必要) |
中 |
|
取引履歴 |
短め(最新性が信頼に直結) |
高 |
この基準表の意味は、単なる設定値の一覧ではなく、「このデータはどのくらいの頻度で変化し、ユーザーはどの程度迅速な最新性を期待しているのか」という問いにまず答え、その答えをキャッシュポリシーに反映する思考プロセスをチームで共有できるようになった点にあります。その後、新しい画面を企画する段階でもこのプロセスを経ることで、キャッシュ戦略は一度きりの問題解決ではなく、繰り返し適用できる運用基準として定着しました。
8. まとめ
この経験を振り返ると、トレンドや定型化されたパターンを先に学習して適用したのではなく、運用中に直面した問題を正確に分解する過程で解決策にたどり着きました。現在はTanStack QueryやSWR. jsのようなライブラリを通じて、同じ戦略を数行の宣言的なコードで適用できます。しかし、その前に「なぜこの戦略が必要なのか」を自分自身で考えた経験があったことで、ライブラリを単に導入して使う以上の理解を得られました。
新しいツールを導入する際、そのツールが解決する問題の本質を先に理解していれば、適用の幅と深さが変わるということを、改めて確認できた経験でした。
cryss