
1. 品質管理体制をCIに置くことにした理由
私はDevOpsエンジニアとして、現在あるMSAコンサルティングに参加しています。コンサルティングというと、通常はサービス境界やドメイン分離などの設計を思い浮かべると思いますが、私が担当した領域はそこではなく、品質管理体制でした。この記事は、その作業に関する記録です。
品質管理というと、コードスタイル、静的解析、テストカバレッジ、イメージの脆弱性スキャンといった項目が思い浮かびます。項目自体に目新しさはありません。本当に難しかったのは、「これをどこで、どの程度の強制力で実行するのか」でした。MSAでは、この問いが思った以上に重くなります。
サービスを細かく分割すると、デプロイ単位もそれだけ増えます。それまで一つだったデプロイが十個、二十個に分かれ、各サービスがそれぞれ異なる周期で本番環境に投入されます。このような状況で品質項目を「できるだけ守ろう」というレベルの推奨事項にしておくと、サービスが増える速度に品質上の抜け漏れが追いついてしまいます。実際、私が最初に参加したときがまさにその状態でした。
そこで、まず品質を管理する場所から見直しました。結論はCIでした。
CIは、すべての変更が必ず一度は通る道です。この道に品質基準をゲートとして組み込めば、誰が作業しても、どのサービスであっても同じ基準を通ることになります。人の誠実さではなく、パイプラインが基準を保持することになるわけです。品質を「守るとよいもの」から「通過できなければ次へ進めないもの」へ変えられる、最も自然な場所がここでした。
以下では、この観点から品質項目をCIの中にどのように組み込んだのかについて説明します。
2. エージェントコーディングと品質
ゲート設計に入る前に、前提として置いたことが一つあります。それは、最近ではコードを書く方法自体が急速に変化しているという点です。開発のかなりの部分がAIエージェントとともに行われています。私はこの変化を、品質の観点では脅威ではなく機会だと考えました。
代表的なのがテストコードです。以前は、テストを十分に作成すること自体がコストでした。カバレッジを80%まで高めるには、境界値や例外ケースを人が一つひとつ作る必要があり、その時間を惜しんで主要経路だけを大まかにカバーして済ませることがよくありました。最も先送りされていた作業がテストでした。
エージェントを導入すると、この点が変わります。境界条件や例外フローまで含むテストを素早く生成でき、反復的で退屈なため先送りされていた作業ほど効果が大きくなります。同じ時間で、より高く、より網羅的なカバレッジを実現できるようになったのです。ツールが良くなった分だけ、品質の目標ラインも同時に引き上げられるということです。
ただし、前提が一つあります。エージェントが作成したコードであれテストであれ、それが本当に意味のある検証なのかを、誰かが一貫して判定しなければなりません。この判定を人の目だけに任せると、生産速度は上がっても検証速度が追いつきません。作り出す量は増えたのに、ふるいにかける手はそのままだからです。
そのため、「エージェントでより速く、より多く作る」ことと、「CIゲートで基準を一貫して強制する」ことは、セットで進める必要があります。作成速度が速くなるほど、その成果物を受け入れるかどうかを機械的に判定するゲートの価値は、むしろ高まります。この記事の残りでは、そのゲートをどのように設計したのかを説明します。
3. CI品質ゲート
設計原則そのものは単純です。欠陥は早い段階で見つけるほど安く、後になればなるほど高くつきます。この事実をパイプライン構造にそのまま組み込むことがすべてです。
そこで、品質ゲートを一つの大きな検査にせず、役割の異なる四つの段階に分けました。
早期遮断 → ベースライン確定 → 本番候補検証 → 昇格判定
段階ごとに、通過する意味は異なります。早期遮断を通過するとマージが可能になり、ベースライン確定を通過すると公式の品質ベースラインとして登録され、本番候補検証まで通過して初めて昇格審査の対象になります。
ここで、一つだけ明確に定めました。ブランチ戦略が何であっても、品質管理の基準は同じにするということです。戦略は段階や状況に応じて変わり得ますが、ゲートが要求する品質レベルまで戦略によって揺らぐなら、それは基準とは呼べないからです。
このプロジェクトでは、構築(SI)段階ではリリース管理が重要であるためGitFlowを基本とし、運用(SM)段階で自動化が十分に成熟したらTrunk-basedへ移行する経路も併せて描きました。そのため、ゲートは共通モデルとして定義しておき、実行地点だけをブランチ戦略に合わせてマッピングしました。戦略を入れ替えても、検査内容はそのまま引き継がれるようにしたのです。
個人的には、MSAをモノレポで運用する環境であれば、最終的にはTrunk-basedのほうが適していると考えています。モノレポでは複数のサービスが一つのリポジトリを共有しますが、ここにGitFlowのようにrelease・develop・featureブランチが長期間分岐すると、サービス数に応じて統合地点が増えます。競合やマージのコストも同時に膨らみます。Trunk-basedでは短期間で作業して頻繁にトランクへマージするため、変更が長く離れたまま一度に衝突する状況そのものを減らせます。
ここに後で説明するselective CIが加わると、相性はかなり良くなります。リポジトリにサービスが多くても、変更の影響範囲だけを選んで検証するため、頻繁に統合しながらもCIコストを許容可能な範囲に維持できます。統合周期が短いことによるリスクは、品質ゲートが支えます。そのため、このプロジェクトでもSIではGitFlowで開始し、運用が安定したらTrunk-basedへ移行する方針を推奨案としてまとめました。
[図1. ブランチ戦略に関係なく動作する品質ゲートの段階]
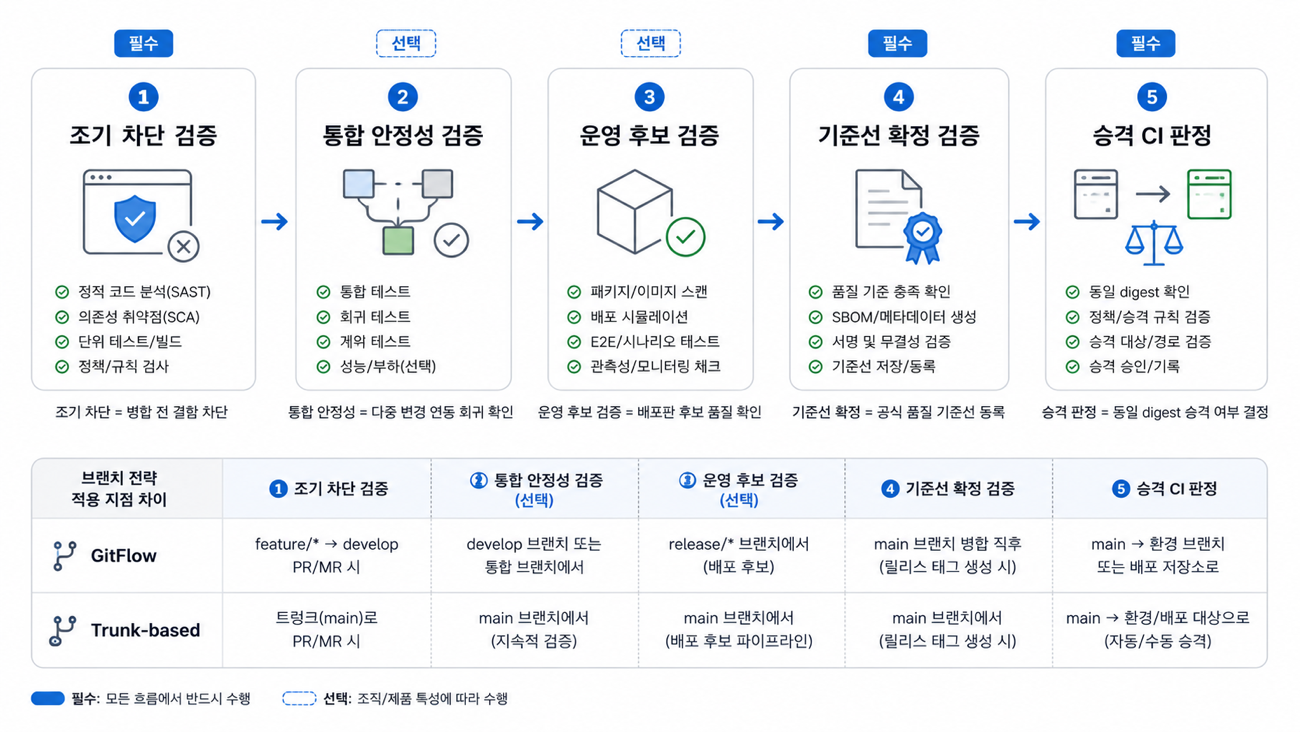
このように段階と責任を分けると、「この変更は今、どの段階で何を通過しなければならないのか」が明確になりました。レビュー担当者一人がすべてを頭の中で抱える構造から、パイプラインが第一の防衛線を担う構造へ移行したわけです。
ゲートを設ける中で、現実的にもう一つ問題に直面しました。サービスの多いモノレポでは、変更のたびに全体を検証すると、CI時間がすぐに制御不能になります。コミットを一行修正しただけで20分待たされるようでは、誰もゲートを好みません。
そこでselective CIを適用しました。変更されたモジュールだけをビルドし、依存関係グラフに沿って影響を受けるサービスだけをテスト対象にする方式です。ただし、むやみに範囲を狭めたわけではありません。共通ライブラリやイベント契約、インフラが変更された場合、またはリリース候補を作成する場合には、範囲を狭めず全体を実行するよう例外を明示しました。速度を優先するあまり回帰を見逃すことが最も怖いため、「範囲は狭めるが、危険な変更は必ず広げる」という線引きを明確にしました。
しかし、selective CIで時間を短縮しても足りない場面があります。検証をすべて行う余裕がなく、今すぐリリースしなければならない状況です。緊急のホットフィックスがそうですし、デモや実演の予定に追われる日もそうです。これは意志の問題ではなく、現場には常にあることです。
そこで、品質ゲートの検証項目をオプションとしてオン・オフできるようにしました。
静的解析、統合テスト、カバレッジ検査、脆弱性スキャンのような重い検証は、パイプラインパラメータとして公開し、状況に応じて一部をスキップできるようにしました。緊急時にゲートが丸ごと足かせになると、人は結局CIの外へ迂回する、より危険な道を探します。それならば、「今回は何を無効にして進むのか」をパイプライン内で明示し、選択できるようにするほうがよいと考えました。
もちろん、無効化には代償を設けました。どの検証を省略したのかをビルド記録に残し、ビルド失敗や単体テスト失敗などの主要な遮断条件は、そもそもオプション一覧から外して、どのような状況でも無効にできないようにしました。オプション化の目的は統制を緩めることではなく、「速く進まなければならない状況」さえもゲート設計の中に取り込み、可視化することでした。
4. 遮断強度(Hard Block / Soft Block / Warning)
ゲートを作りながら最も長く悩んだのは、意外にも「何を止めるか」ではなく、「何を止めないか」でした。
すべてを強く止めると、パイプラインはすぐに嫌われます。フォーマットが一つずれただけでデプロイが止まれば、皆ゲートを迂回する方法から考え始めます。そこで、遮断の強度を三段階に分けました。
|
階層 |
意味 |
代表項目 |
|---|---|---|
|
Hard Block |
例外承認なしではマージ・昇格不可 |
ビルド失敗、単体テスト失敗、Critical/Highの脆弱性、必須承認の未達 |
|
Soft Block |
改善計画を記録すれば条件付きで承認 |
カバレッジ未達、性能回帰、Mediumの脆弱性、不安定な統合テスト |
|
Warning |
停止はせず、傾向だけを管理 |
フォーマット、低い深刻度、ドキュメントの欠落、スタイル上の問題 |
このように分けると、ゲートは「何が何でも止める壁」ではなく、「リスクの大きさに応じて反応する仕組み」になりました。些細なものは通過させ、危険なものは確実に捕捉するという形です。
強度を下げた分、抜け道も生まれます。そこで、補完ルールも設けました。同じ項目が二回を超えて連続で失敗した場合は、SoftからHardへ引き上げることを検討し、決済や精算のような重要なビジネス経路に関わる失敗は、テスト層が何であっても無条件でHardとして処理しました。同じ失敗でも、どこで発生したかによって重みが異なるからです。
結局、「止めないもの」を決めることと、「決して譲らない経路」を決めることは一つのセットです。強度を三つに分けたのも、この二つのバランスを取るための仕組みでした。
5. 静的解析とテスト
ゲートの骨格を作った後は、各ゲートで実際に何を検査するのかを埋めていく必要がありました。
コードベースがKotlinなので、静的解析ツールをあえて2つに分けました。Kotlin言語に特化した解析はdetektが、フォーマッティングとリントはktlintが担当し、カバレッジ測定はKoverとして別に切り分けました。
ツールを増やすことが目的だったわけではありません。detektはKotlin特有の慣用表現や意味ベースの欠陥をうまく検出し、ktlintはスタイルを機械的かつ一貫して強制します。それぞれ得意なことが異なります。分けておくと、「この違反はどのツールで検出されたのか」が明確になるため、ゲートの判定基準もはるかにすっきりと定められました。
テストは、層ごとに実行するタイミングと責任を変えました。すべてのテストをすべての段階で実行すると、コストに耐えられないからです。速くて安価な検査を前に、遅くて高価な検査を後ろに置くのが基本的な骨格です。
|
テスト層 |
実行時点 |
目的 |
|---|---|---|
|
Unit Test |
PR / 基準線確定 |
モジュール内部ロジックの正確性 |
|
Integration (Testcontainers) |
PR中心 |
サービス境界・連携における回帰の早期検出 |
|
E2E smoke |
基準線確定 |
デプロイ前の浅い回帰検証 |
|
E2E拡張 |
stage以降 |
デプロイ版を基準にした主要フローの検証 |
カバレッジは絶対的なスコアとして扱いませんでした。テストが届いていないリスク領域を照らし出す指標程度に捉えました。基本線は全体70%、主要ドメインと新規コードは80%に設定しましたが、数字そのものよりも、主要パスが検証されていない状態をより大きなリスクとして扱いました。数字だけにこだわると、合格するためだけの空疎なテストが増えてしまいがちです。
そこで、運用基準を1つ定めました。カバレッジの数値をゲートの絶対的なカットオフにしないということです。新規コードのカバレッジは回帰を事前に防ぐ先行指標なので比較的厳格に見つつ、既存コードの低い数値については一度にブロックするのではなく、主要パスから段階的に引き上げる形で運用しました。先ほど述べたように、エージェントを活用すれば、この目標ラインを現実的にさらに高く設定してもよいと考えたからです。
6. イミュータブルアーティファクト
品質をどれだけ丁寧に検査しても、検査したものとは別のものが本番に上がれば、検証はすべて無意味になります。意外にも、ここで漏れが生じるケースは多くあります。
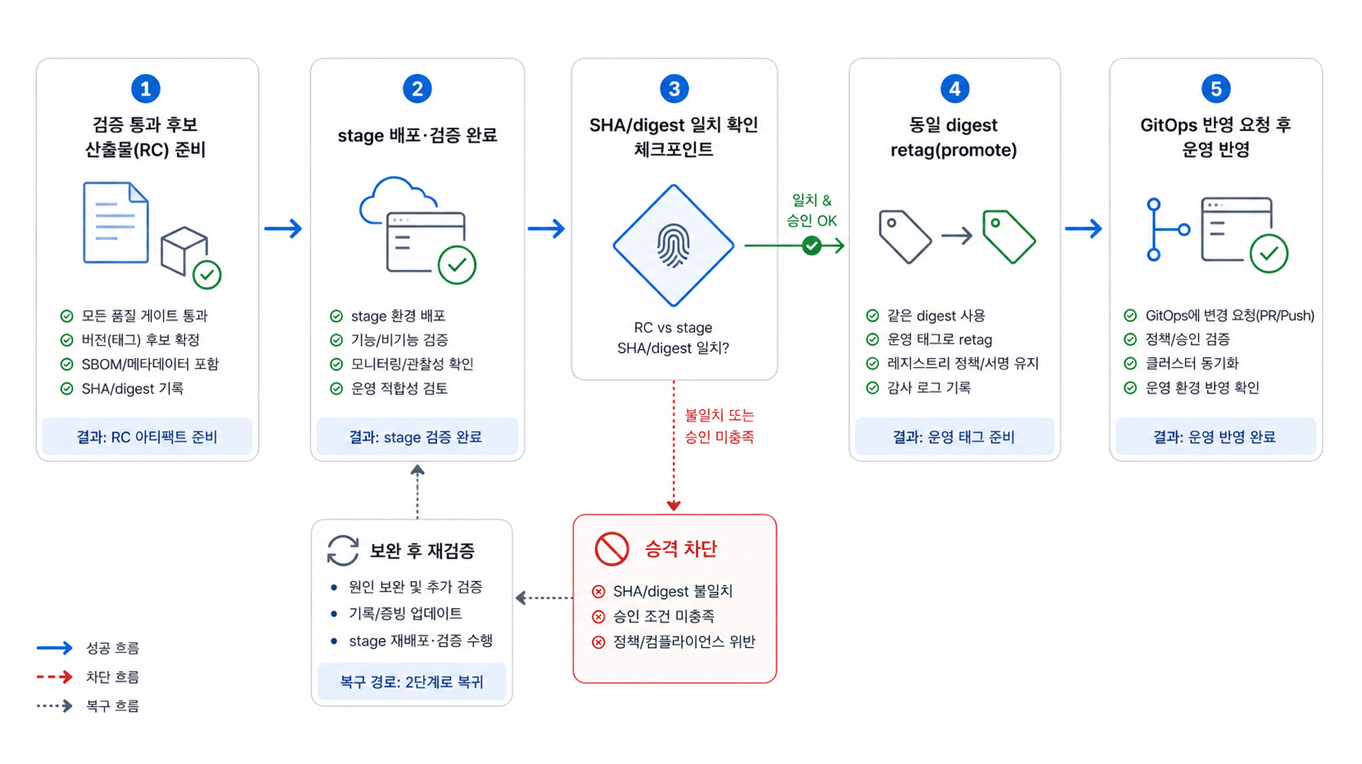
そこで、本番昇格では再ビルドしないことを原則として明確に定めました。stageで検証を通過したまさにその成果物を、同じdigestのままretagして本番へ上げます。検証したコミットのSHAと昇格対象のSHAが異なる場合は、昇格そのものをブロックします。「本番用に再ビルド」といった処理は、最初から経路から外しました。
些細に見えても、MSAではこの原則の重みが異なります。サービスごとの独立デプロイが頻繁になるほど、「検証したそのバイト列がそのまま本番に上がった」という保証が、障害分析とロールバックの信頼性を左右します。この保証がなければ、障害が発生したときに、まず「検証版と本番版は本当に同じなのか」を疑わなければならないからです。
[ 図2. 再ビルドせず、同じdigestで昇格するフロー ]
脆弱性管理も同じ場所に組み込みました。TrivyをCIランナー内で実行してイメージをスキャンし、CriticalとHighの脆弱性があるイメージは、すでにレジストリに登録されていても昇格対象から除外しました。結果はSARIFに集約し、中央で傾向を確認しました。セキュリティも「推奨」ではなく、合格条件の一部にしたのです。
7. AIコードレビュー
品質ゲートを整理していた頃、CIの段階でAIにコードレビューを支援させられることを知り、実際に組み込んでみました。
PRが上がると、AIが変更内容を確認し、欠陥候補、回帰リスク、テスト漏れ、ルール違反の可能性などを一次的に指摘する形です。パイプラインに接続して動かしてみたところ、正直なところ、動作は期待以上でした。
最も印象的だったのは、1つか2つの観点だけにとどまらない点でした。人がレビューする際に確認する順序をほぼそのまま踏襲し、多角的に指摘してくれました。1つのPRを上げると、おおむね次のように整理してくれます。
-
変更分析 — どのファイルが何の理由で変更されたのかを、まず1行で要約
-
潜在的なバグ・改善点 — ドキュメントが曖昧な部分や、欠落するとデプロイ時のエラーにつながる可能性がある設定依存関係などを指摘
-
セキュリティ問題 — APIキーや認証情報などの機密情報が混入する余地がないかを確認
-
構造・結合度 — 継承関係の変化や他のモジュールとの結合度の増加、それに伴う影響範囲を確認するよう提案
-
重複・最適化 — 類似ロジックの繰り返しや未使用コードをリファクタリング候補として表示
-
テストの提案 — 変更の影響に対してカバレッジが十分かを問い直し、必要なケースの追加を推奨
ドキュメントにMarkerを1行追加する程度の小さなPRを上げたときも、「この変更が他のコードにどのような影響を与えるのか」まで追ってくれました。レビュアーの立場からすると、レビューの出発点が1段階前に進むような感覚です。枝葉の部分を先に一度ふるいにかけてから始められるため、人は本当に重要な判断により集中できました。
しかし、この機能は最終的に実際の本番環境には導入しませんでした。
理由はセキュリティです。扱うデータの機密性が高い環境だったため、コードやそれに関連する情報が外部へ出ていく経路には敏感にならざるを得ず、変更内容を外部AIサービスへ送る方式をそのまま導入するのは困難でした。機能が正常に動作することと、この環境に実際に導入してよいことは別の問題でした。
そのため、「検証は行い、効果も確認したが、セキュリティ基準をまず満たしたうえで本番に上げる」というところで止めておきました。導入するなら、データを外部に出さないプライベートLLMベースである必要があり、その場合でもAIはあくまで補助であり、最終承認は人間のレビュアーが行うという原則は変えないつもりです。
技術的に可能であることと、この現場に導入できることとの距離を一度測ってみたわけですが、その距離を埋めるための基準を残せたこと自体が、1つの成果だったと考えています。
8. おわりに
振り返ってみると、今回の作業は大げさなツールを導入したわけではありませんでした。品質項目が毎回同じ基準を通るようにCIに定着させたこと、それが核心でした。
作業を進める中で、特に実感したことを整理すると次のとおりです。
-
品質項目の大半は、コードが入ってくる入口であるCIで扱うのが最も自然で、一貫性も保ちやすくなります。
-
エージェントを使ったコーディングの流れは、品質への脅威ではなくチャンスです。適切に活用すれば、カバレッジと検証密度をむしろ高められます。
-
ゲートは何を阻止するかだけでなく、何を阻止しないかも併せて設計してこそ、嫌われずに存続できます。
-
検証済みの成果物をそのまま投入するimmutableの原則が欠けると、前段で行ったすべての検証が一瞬で無力になります。
-
技術的に可能であることと、この環境に導入できることは異なります。AIレビューのように効果が確認できても、セキュリティ上の理由で保留にしたケースがその例です。
MSAコンサルティングでは、サービス設計やデプロイ体制のように目に見える成果物がまず注目されます。しかし、その成果物が時間が経っても一定の品質を維持できるよう、下支えしているのは毎日静かに稼働するCI品質ゲートだと考えています。
Tim