
1. はじめに
前回の作業では、LLM自動翻訳機能を非同期イベントフローとして分離する構成を扱いました。保存リクエスト内でLLMを直接呼び出すのではなく、翻訳が必要な状況をイベントとして発行した後、別のフローで翻訳を実行するように構成しました。今回の作業は、その後続拡張に近い内容です。
従来の構成は、エンティティが直接持つ多言語フィールドを翻訳することに重点を置いていました。しかし実際のドメインモデルでは、多言語文字列が常にエンティティの直接フィールドにのみ存在するとは限りません。エンティティ内部の値オブジェクト(Value Object)に多言語フィールドが含まれていたり、値オブジェクトがリスト形式で存在したりする場合も多くあります。
この記事では、LLM自動翻訳の対象をネストされたオブジェクトとリスト構造まで拡張する中で生じた技術的な検討事項を整理します。重要だったのは、単に翻訳可能な位置を増やすことではなく、識別子を持たないリスト構造をどのように安全に扱うか、そして共通機能のユーザーAPIをどのようにシンプルに維持するかという点でした。
2. 従来の構成の限界
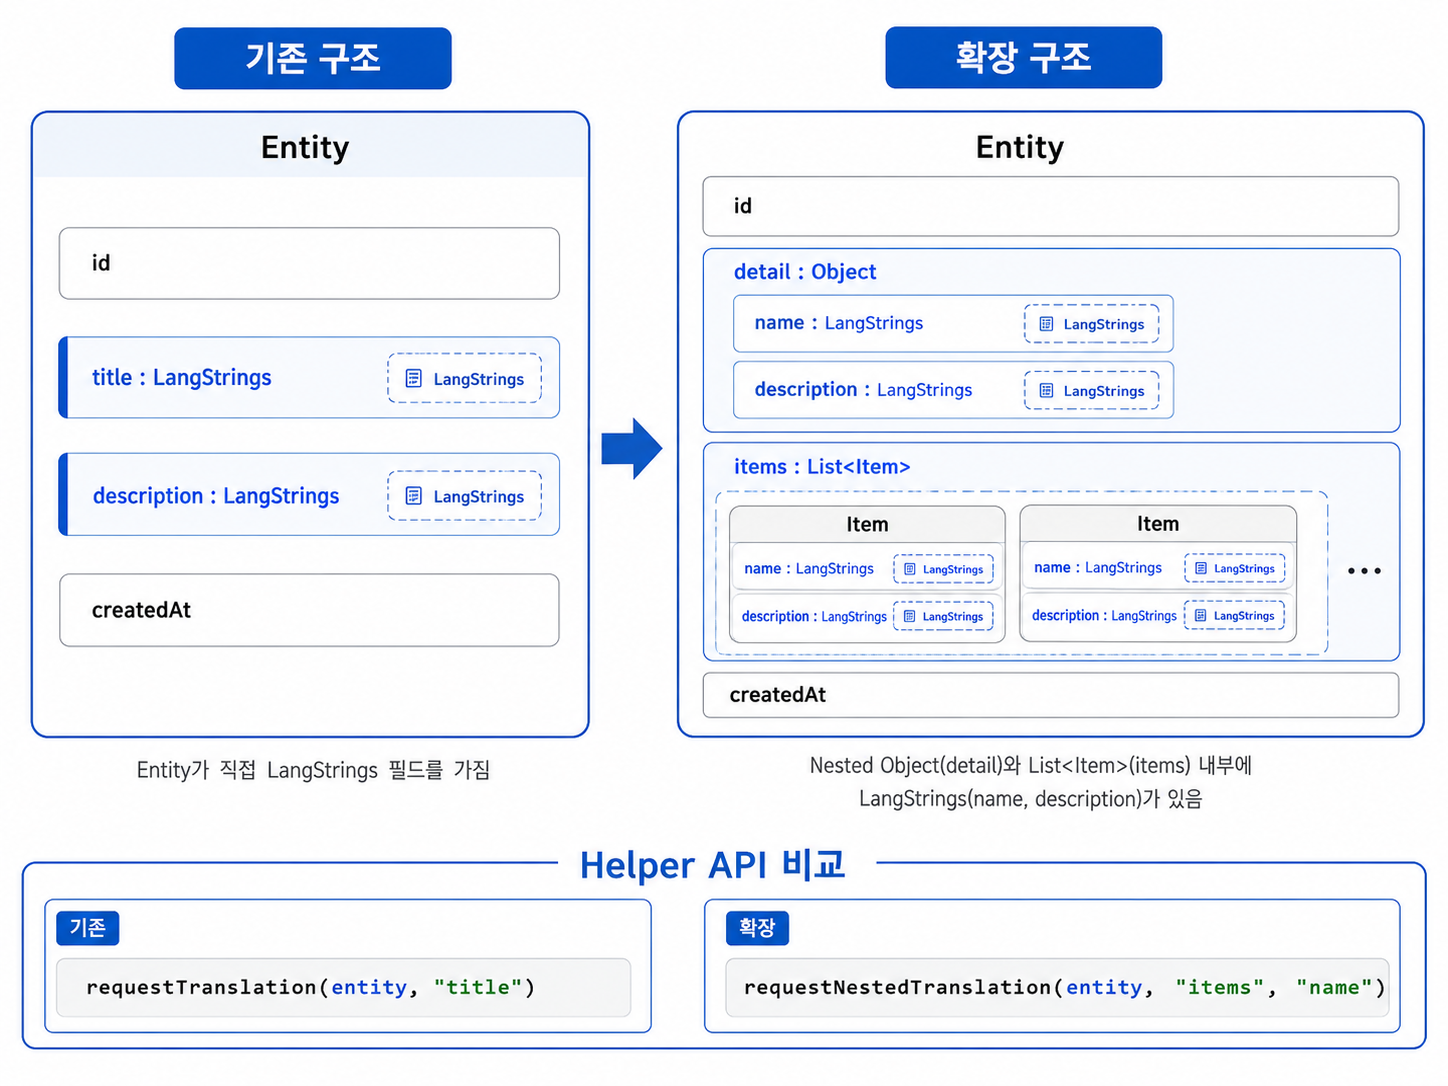
従来の自動翻訳リクエスト方式は比較的シンプルでした。サービスは翻訳対象のエンティティとフィールド名をHelperに渡し、Helperはそれを基に翻訳リクエストイベントを発行します。たとえば、requestTranslation(entity, "title")のような形式です。
この方式は、titleやdescriptionのようにエンティティが直接持つフィールドには適しています。完了イベントが到着すると、エンティティ名、エンティティID、フィールド名を基準に対象エンティティを取得し、そのフィールドに翻訳結果を反映できるためです。
問題は、翻訳対象がdetail.nameやitems[0].nameのように、より深い位置にある場合に発生します。単純に文字列パスをそのままユーザーに渡すようにすることもできますが、この方式では共通機能の使いやすさが低下します。ユーザーが内部のfield path規則を直接理解する必要があり、リスト構造ではindexまで指定しなければなりません。
特に、リストのindexは安定した識別子とは言いにくいものです。リクエスト時点のitems[0]が、完了イベントを反映する時点でも同じオブジェクトである保証がなければ、誤った対象に翻訳結果が反映される可能性があります。そのため、従来のfieldNameにドット記法やindex記法を単純に許可する方式は避けました。
[図1. 直接フィールドの翻訳とネストされたオブジェクト/リストの翻訳の比較]
3. ネストされたオブジェクトとリスト構造で生じた検討事項
ネストされたオブジェクトの翻訳を拡張するにあたり、最初に検討したのは値オブジェクトの識別の問題でした。エンティティは通常、一意のIDを持っているため、完了イベントが到着した際に再取得できます。一方、エンティティ内部の値オブジェクトは、独立した識別子を持たない場合が多くあります。
単一の値オブジェクトは比較的シンプルです。たとえば、article.detail.nameのように1つのパスで表現できます。しかし、値オブジェクトのリストにはより慎重な対応が必要です。article.items[0].nameやarticle.items[1].nameのように、indexが関わってくるためです。
リストの特定のindexだけを翻訳するAPIを提供することもできます。しかしこの場合、ユーザーはindexを直接渡す必要があり、リストの順序が変わると翻訳結果が別の要素に反映される可能性があります。値オブジェクトに個別のkeyがない場合、indexは技術的に便利な位置情報に過ぎず、安定した識別子とは言いにくいものです。
そこで今回の範囲では、特定のindexだけを翻訳するAPIは提供しない方針を選択しました。リストフィールドが渡された場合は、そのリスト全体を翻訳対象とし、内部で各要素を走査しながら翻訳対象を算出するようにしました。
もう1つの検討事項は、複数の多言語フィールドの処理でした。実際の値オブジェクトにはnameだけでなく、name、description、summaryのように複数の多言語フィールドが存在する場合があります。そのため、単一のネストされたオブジェクトとリスト構造のいずれにおいても、1つのフィールドだけでなく複数のフィールドをリクエストできるように範囲を整理しました。
-
単一のネストされたオブジェクト内部にある単一の多言語フィールド
-
単一のネストされたオブジェクト内部にある複数の多言語フィールド
-
リスト構造内部にある単一の多言語フィールド
-
リスト構造内部にある複数の多言語フィールド
4. ユーザーAPIをシンプルに維持する
今回の機能で重視したのは、ユーザーAPIのシンプルさでした。共通機能は複数のサービスで利用されるため、利用する開発者が内部イベントの構造やReflectionのパス規則を詳しく理解しなければならないのであれば、良いAPIとは言いにくいでしょう。
そこで、ネストされたオブジェクトの翻訳用に専用のリクエストメソッドを設けました。ユーザーはエンティティオブジェクト、ネストされたフィールド名、そしてその内部にある多言語フィールド名だけを渡します。たとえば、requestNestedTranslation(entity, "items", "name")のように呼び出します。
このAPIの重要な点は、ユーザーがitems[0].nameのような内部pathを直接作成しないことです。ユーザーは、エンティティが持つフィールド名であるitemsと、その内部オブジェクトが持つ多言語フィールド名であるnameだけを渡します。
単一のオブジェクトかリストかはHelperが判断します。Helperは渡されたオブジェクトを基準に対象フィールドを読み取り、そのフィールドが単一のオブジェクトであれば、内部の多言語フィールドを1つの翻訳対象として算出します。リストであれば、リスト全体を走査し、各要素の内部にある多言語フィールドを翻訳対象として算出します。
このようにすると内部処理は複雑になりますが、利用側のコードはシンプルに維持できます。共通機能の複雑さは内部で引き受け、ユーザーには必要最小限の入力だけを求める構成です。
5. イベント契約と結果反映方式の拡張
ユーザーAPIをシンプルに維持するには、内部のイベント契約も併せて拡張する必要がありました。従来の翻訳リクエストイベントは、エンティティの直接フィールドを基準に設計されていました。リクエストイベントは、どのサービスのどのエンティティにあるどのフィールドを翻訳するのかを表します。
しかし、ネストされたオブジェクトとリスト構造では、1つのリクエストが複数の翻訳対象に拡張される可能性があります。たとえば、itemsリストのnameとdescriptionを翻訳すると、内部的にはitems[0].name、items[0].description、items[1].name、items[1].descriptionのように複数の対象が作られます。
したがって、ネストされた翻訳リクエストを1つのフィールド名だけで表現するのは困難です。リクエスト内に複数の翻訳対象を含められる必要があり、各対象がどの位置にあるどの多言語フィールドなのかを把握できなければなりません。そのため、ネストされた翻訳リクエスト用のイベントと対象オブジェクトを別途設けました。
完了イベントの処理方式についても併せて検討しました。ネストされた翻訳結果をサービスが直接受信して反映するようにすることもできますが、従来の自動翻訳構成では、成功イベントをサービスが直接処理するのではなく、共通ライブラリが自動的に反映する方式でした。ネストされたオブジェクトの翻訳だけに別途イベントハンドラーを要求すると、利用方法に一貫性がなくなります。
そこで、ネストされたオブジェクトの翻訳も従来の成功処理と同様に自動反映されるよう整理しました。翻訳サービスは完了イベントを発行し、共通ライブラリはそのイベントを受信した後、reflectionによって元のエンティティにある対象位置へ翻訳結果を反映します。
一方、失敗処理はサービスが直接担当する方式を維持しました。失敗後のポリシーはサービスごとに異なる可能性があるためです。あるサービスは単にログを残すだけかもしれませんし、別のサービスは管理画面で失敗履歴を表示したり、再リクエスト機能を提供したりすることもあります。そのため、失敗イベントは共通で提供しつつ、その後の処理は各サービスのドメインポリシーに委ねるのが適切だと判断しました。
6. まとめ
今回の作業は、LLM自動翻訳の対象をエンティティの直接フィールドから、ネストされたオブジェクトとリスト構造まで拡張した経験でした。最初は、単に内部オブジェクトの多言語フィールドも翻訳できるようにする作業に見えましたが、実際にはユーザーAPI、リストindexの安定性、イベント契約、結果の反映方式、成功と失敗に関する責任の境界まで併せて検討する必要がありました。
特にリスト構造では、特定のindexをAPIとして公開するかどうかが重要な判断点でした。indexは実装上は便利ですが、値オブジェクトのリストにおいて安定した識別子とは言いにくいものです。そのため、特定のindexを翻訳する機能は除外し、リスト全体を対象に翻訳する方針を選択しました。
また、ユーザーAPIをシンプルに維持することも重要な目標でした。ユーザーが内部pathを直接作成せず、ネストされたフィールド名と内部の多言語フィールド名だけを渡すようにしました。単一のオブジェクトかリストか、内部的にどのような翻訳対象が作られるかはHelperが判断します。
今回の作業を通じて改めて感じたのは、LLM機能の核心はモデル呼び出しそのものだけではないということです。実際のサービスに適用するには、どのデータを翻訳対象とするのか、結果をどこにどのように反映するのか、失敗を誰が処理するのか、ユーザーがどれだけシンプルに機能を利用できるのかまで、併せて設計する必要があります。
共通機能は内部で多くのケースに対応する必要がありますが、利用者からはシンプルに見えなければなりません。今回の作業は、LLM自動翻訳機能を実際のサービスのドメインモデルにより近い形で拡張しながら、その原則を改めて確認する過程でした。
7. 今後検討すべき点
今回の拡張によって、翻訳リクエストと結果反映の範囲は広がりましたが、運用面ではまだ検討すべき点が残っています。代表的なものとして、翻訳状態をどこで管理するかという問題があります。単に値が空の状態から埋められる初回翻訳であれば、完了したかどうかを比較的容易に判断できます。しかし、すでに翻訳値が存在する状態で再翻訳が発生すると、フィールドの値だけでは処理中と完了を区別するのが難しくなる可能性があります。
このような状態情報は、多言語文字列そのものというより、翻訳リクエストの処理履歴やワークフローに近いものです。そのため、文字列オブジェクト内に状態を直接持たせるよりも、別の翻訳履歴または状態モデルとして管理する方が明確な場合があります。失敗時の再リクエスト機能も同様に、単純なLLMの再呼び出しではなく、現在のデータ状態とサービスのポリシーを併せて考慮する運用機能として捉える必要があります。
[参考文献]
Martin Fowler, Value Object
https://martinfowler.com/bliki/ValueObject.html
Microsoft Learn, 非同期リクエスト-レスポンスパターン
https://learn.microsoft.com/ko-kr/azure/architecture/patterns/asynchronous-request-reply
IBM, イベント駆動アーキテクチャとは?
https://www.ibm.com/kr-ko/think/topics/event-driven-architecture
jyyou