
LLMを業務で活用していると、最初はプロンプトをどれだけ短く明確に書くかが最も重要に思えます。私も当初は、トークンを節約するには自分が入力する文章を短くすればよいと考えていました。
しかし、Codexのようなエージェント型開発ツールを使うようになって、考えが変わりました。実際のトークンの浪費は、ユーザーが直接書いた文章よりも、ツールが返したデータによって大きく発生する可能性があります。MCP、ファイル検索、コードの読み取り、ターミナルの実行結果などの外部ツールが接続されると、モデルのコンテキストはユーザーのプロンプトではなく、ツールの出力によって急速に埋め尽くされます。
この問題を直接実感したのは、FigmaとStorybookを同期する作業をしていたときでした。FigmaのデザインをStorybookのコンポーネントに合わせるためにFigma MCPを呼び出したのですが、私が必要としていた情報は、レイアウト、色、Typography、間隔、variant程度でした。しかし実際のレスポンスには、Figmaコンポーネントの変数、重複したメタデータ、関係のない内部プロパティまで大量に含まれていました。
Codexの個人利用環境では、APIのようにinput token、output token、cached tokenを直接確認することが難しいため、正確なトークン数を確認することはできませんでした。ただし、Figma MCPを呼び出した際、個人用Plusアカウントの5時間の使用量表示が約91%から38%まで急激に低下し、実際の実装を始める前からコンテキストが不要な情報で埋まってしまいました。
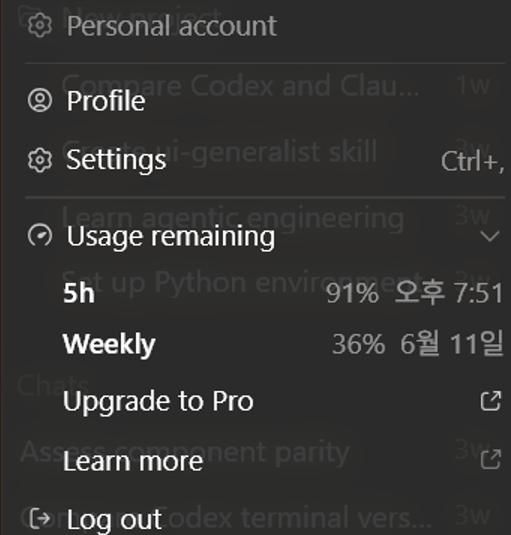
図1. Figma MCP呼び出し前の使用量表示
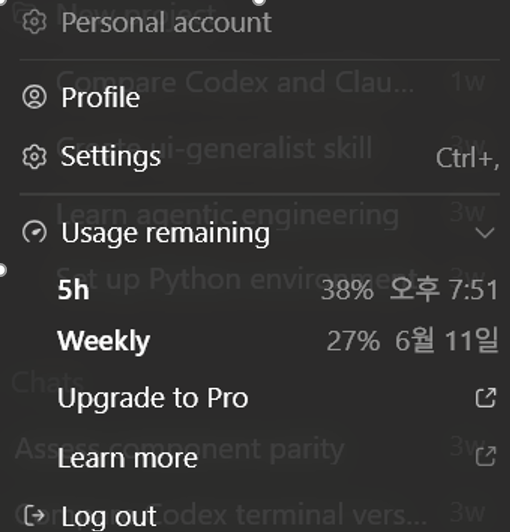
図2. Figma MCP呼び出し後の使用量表示
最初は、MCPの結果を受け取った後でエージェントに要約させればよいと考えていました。しかし、この方法は根本的な解決策ではありませんでした。大量のMCPレスポンスがすでにモデルのコンテキストに入った後であれば、最初のコストはすでに発生しています。その後の要約によって次の作業の負担を減らすことはできますが、不要なデータが最初からモデルに入ってくる問題を防ぐことはできません。
結局、解決策は要約ではなく事前フィルタリングでした。私はエージェントがuse-figmaツールを通じてJavaScriptコードを実行し、Figmaノードから実装の判断に必要なフィールドだけを抽出するようにしました。Figmaオブジェクト全体をそのまま渡すのではなく、必要な情報だけを整理してコンテキストに入れたのです。
|
区分 |
従来の方式 |
改善した方式 |
|---|---|---|
|
データ処理 |
MCPレスポンス全体をモデルに渡す |
JavaScriptで必要なフィールドだけを抽出 |
|
コンテキストの内容 |
変数、メタデータ、内部プロパティを含む |
layout、typography、color、stateを中心に構成 |
|
問題 |
実装前に使用量表示が急減する |
必要な情報を中心に作業を進められる |
|
限界 |
正確なトークン数を確認できない |
定量的なベンチマークではなく、観察に基づく比較 |
この経験以降、トークンの最適化を別の見方で捉えるようになりました。重要なのはプロンプトを短く書くことではなく、モデルに何を送るかを先に決めることです。
1. ツールの出力はモデルに入る前に減らすべきです
エージェント型開発ツールでは、ツールの出力が最大のコンテキスト汚染源になる可能性があります。ユーザーのプロンプトが短くても、MCPやファイル検索の結果が大きければ、コンテキストはすぐに不要な情報で埋まります。
Figma MCPで実際に必要だった情報は限られていました。
-
コンポーネントの階層構造
-
Auto Layoutの方向と整列
-
width、height、padding、gap
-
テキストスタイル
-
色とトークン名
-
variantとstate
-
Storybook実装との視覚的な差異
一方で、変数テーブル全体、重複したスタイルメタデータ、関係のないsibling node、過度に深い内部プロパティは、すぐには必要ありませんでした。問題は、こうした情報が一度モデルに入ると、その時点ですでにコストが発生するということです。
そのため、流れを変える必要があります。
나쁜 흐름:
외부 도구 → 응답 전체 → 모델 컨텍스트 → 요약

좋은 흐름:
외부 도구 → 필터링 → 필요한 정보만 → 모델 컨텍스트
受け取った後で減らすよりも、入ってくる前に選別するほうがよいのです。
Figmaの作業では、JavaScriptで必要な属性だけを抽出しました。たとえば、nodeオブジェクト全体を渡す代わりに、次のように実装の判断に必要な構造だけを残すことができます。
const extracted = {
  name: node.name,
  type: node.type,
  layout: {
    mode: node.layoutMode,
    padding: {
      top: node.paddingTop,
      right: node.paddingRight,
      bottom: node.paddingBottom,
      left: node.paddingLeft,
    },
    gap: node.itemSpacing,
  },
  size: {
    width: node.width,
    height: node.height,
  },
  styles: {
    fills: simplifyFills(node.fills),
    text: extractTextStyle(node),
  },
  children: node.children?.map(toShallowNode),
};
この方法の核心は、LLMにデータをすべて読ませてから判断させないことです。まずコードがデータ量を減らし、モデルは意味を判断する必要がある部分に集中します。
この原則はFigmaだけに適用されるものではありません。APIを呼び出すときは必要なフィールドだけをリクエストし、データベースではSELECT *の代わりに必要なカラムだけを取得し、ログ分析ではログ全体ではなくエラー行とその周辺のコンテキストだけを渡すのが望ましいです。コードレビューでも、リポジトリ全体より変更されたdiffと関連ファイルだけを渡すほうが適しています。
ただし、フィルタリングを過度に行うと、後で必要になる情報まで抜け落ちる可能性があります。そのため、無条件に少なく送るのではなく、作業の目的に合った抽出基準が必要です。
Design extraction 기준:
- layout: 방향, 정렬, padding, gap, size
- typography: font size, weight, line height
- color: fill, stroke, semantic token name
- component: variant, state, child hierarchy
- 제외: 관련 없는 변수, 미사용 메타데이터, 원본 node 전체 덤프
トークンを減らすには、モデルに与える情報を減らすのではなく、判断に必要な情報だけを与えなければなりません。
2. コンテキストは記録ではなく、現在の作業状態として管理すべきです
会話履歴は記憶のように感じられますが、エージェントにとっては毎回読み直す必要がある入力です。以前の会話、ツールの実行結果、失敗ログを残し続ければ役に立つように思えますが、実際には判断に必要のない情報が蓄積され続ける可能性があります。
コンテキストは保管庫ではなく、作業スペースに近いものです。今の判断に必要な情報だけが残っていなければなりません。古いログ、すでに解決したエラー、破棄された計画、関係のないファイル内容が残り続けると、コストは増え、判断は曖昧になります。
ソフトウェア開発でも、運用ログ全体をアプリケーションのメモリに読み込んでおくことはありません。必要な時点で検索し、必要な部分だけを読み、現在の状態は別途管理します。同じように、エージェントに対しても会話履歴全体より現在の作業状態を渡すほうが適しています。
たとえば、エージェントがFigmaの情報を読み、Storybookファイルを確認し、コンポーネントを修正し、typecheckで失敗した後に再び修正したとします。これらすべての原文を残し続ける必要はありません。次の段階に必要なのは、以下のような状態です。
Current goal:
Button variant를 Figma 기준으로 Storybook 구현과 맞춥니다.

Relevant files:
- Button.tsx
- Button.stories.tsx
- theme/tokens.ts

Decisions:
- raw color 사용 금지
- 기존 semantic token 우선 사용

Checks:
- typecheck 1차 실패: ButtonVariant union에 "soft" 없음
- 타입 수정 후 재검증 필요

Open issue:
- hover background token 일치 여부 확인 필요
このような状態の要約は、原文のログよりも短く、次の判断により直接的に役立ちます。
良い状態の要約には、現在の目標、確定した決定、変更したファイル、失敗したアプローチ、実行した検証、残っているリスク、次の行動を残すべきです。一方で、すでに解決した長いエラーログ、重複したファイル内容、意味のないターミナル警告、破棄した計画の詳細な説明は、長期間保存する必要性が低いものです。
コンテキストを減らすことは、記憶を捨てることではありません。現在の作業に必要な状態を、より正確に残すことです。
3. エージェントの探索範囲を狭める必要があります
エージェント型開発ツールでトークンが多く使われるもう一つの理由は、反復ループです。1回のプロンプトが長いことよりも、誤った探索と修正が何度も繰り返されることのほうが、大きなコストになる場合があります。
よくある失敗の流れは次のとおりです。
-
依頼の範囲が広すぎます。
-
エージェントが多数のファイルを読み込みます。
-
関係のない情報まで解釈します。
-
実装範囲を誤って設定します。
-
テストに失敗します。
-
失敗ログを長々と読み込みます。
-
再び修正します。
-
ユーザーが再度、方向性を説明します。
この過程では、トークンだけでなく人間によるレビューの時間も浪費されます。そのため、エージェントに仕事を任せるときは、まず作業範囲を狭める必要があります。
悪い依頼の例は次のとおりです。
Figma랑 Storybook 맞춰줘.この依頼は範囲が広すぎます。エージェントは、どのFigmaノードを見るのか、どのStorybookコンポーネントを修正するのか、どの基準で適合したと判断するのかを、自分で推測しなければなりません。
より良い依頼では、目標、許容範囲、禁止事項、検証方法を併せて提示します。
Goal:
Figma의 Button / Soft / Medium / Disabled 상태를 Storybook Button과 맞춥니다.

Allowed context:
- 선택된 Figma node만 확인합니다.
- Button.tsx, Button.stories.tsx, theme token 파일만 우선 확인합니다.

Do not:
- 전체 Figma variable table을 dump하지 않습니다.
- public API를 변경하지 않습니다.
- raw color를 추가하지 않습니다.

Verify:
- typecheck
- Storybook 실행 또는 build 가능 여부

Final answer:
- 변경 파일
- 적용한 token
- 실행한 검증
- 남은 visual mismatch
このような作業パケットは、最初の入力だけを見ると長く見えるかもしれません。しかし、作業全体のコストは削減されます。エージェントが誤ったファイルを読んだり、不要なMCP呼び出しを行ったり、関係のない実装を修正したりする可能性が低くなるためです。
この観点から見ると、AGENTS.md、skills、チェックコマンド、完了条件、禁止ルールもトークン最適化と関係しています。これらは単なる便利な文書ではなく、エージェントが不要な探索を行わないようにする作業上の境界です。
作業単位を設計するときは、まず次の質問を確認するとよいでしょう。
-
目標は何か?
-
確認すべきファイルは何か?
-
確認してはいけない情報は何か?
-
禁止されている変更は何か?
-
成功したかどうかをどのように検証するのか?
-
最終報告はどのような形式にすべきか?
良い作業単位は、エージェントの自由度を奪うものではありません。その代わりに、不要な探索空間を狭めます。
おわりに
今回の経験から最も大きく学んだことは、トークン最適化の出発点はプロンプトの長さではないということです。エージェント型開発ツールでは、ツールの出力、会話履歴、テストログ、ファイルの内容、繰り返される修正ループがすべてコンテキストを消費します。
Figma MCPで経験した問題も、私が長いプロンプトを書いたことが原因ではありませんでした。ツールが返した不要な情報が先にコンテキストを占有し、エージェントが実際の実装を開始する前に作業スペースが埋まってしまったのです。
そのため、今ではCodexを使うとき、「何を尋ねようか?」より先に「何をコンテキストに入れてはいけないか?」を確認します。
優れたトークン最適化とは、モデルに情報を不足させることではありません。モデルが判断すべき情報だけを正確に与えることです。
Joseph