
1. Qidiruvni Elasticsearch’ga ko‘chirish haqida umumiy ma’lumot
Men ishlagan loyiha bir nechta tillarda sayohat yo‘nalishlari va ushbu yo‘nalishlarga tegishli kontentni taqdim etadigan platforma edi. Xizmatning asosiy vazifasi foydalanuvchilar hudud yoki yo‘nalish nomini kiritganda tegishli yo‘nalishlar va kontentni topish bo‘lgani sababli, qidiruv sifati amalda xizmat sifatini belgilardi.
Ma’lumotlar tuzilmasi bitta muhim xususiyatga ega edi. Yo‘nalish haqidagi ma’lumotlar tilga bog‘liq bo‘lmagan va tilga bog‘liq qismlarga ajratilgan. Koordinatalar va ko‘rinish holati kabi tarjimani talab qilmaydigan qiymatlar destination jadvalida saqlangan, yo‘nalish nomlari, manzillar va qisqacha ma’lumotlar kabi tarjimani talab qiladigan qiymatlar esa ko‘p tilli jadvalda har bir til uchun alohida satrda saqlangan. Kontent ham xuddi shu tarzda til kodini o‘z ichiga olgan.
Normalizatsiya nuqtayi nazaridan bu tabiiy dizayn. Biroq qidiruv nuqtayi nazaridan bitta natijani hosil qilish uchun kamida ikkita jadvalni tekshirish kerak bo‘ladi. Kategoriya yoki teg shartlari qo‘shilganda tekshirilishi kerak bo‘lgan jadvallar soni yanada ortadi.
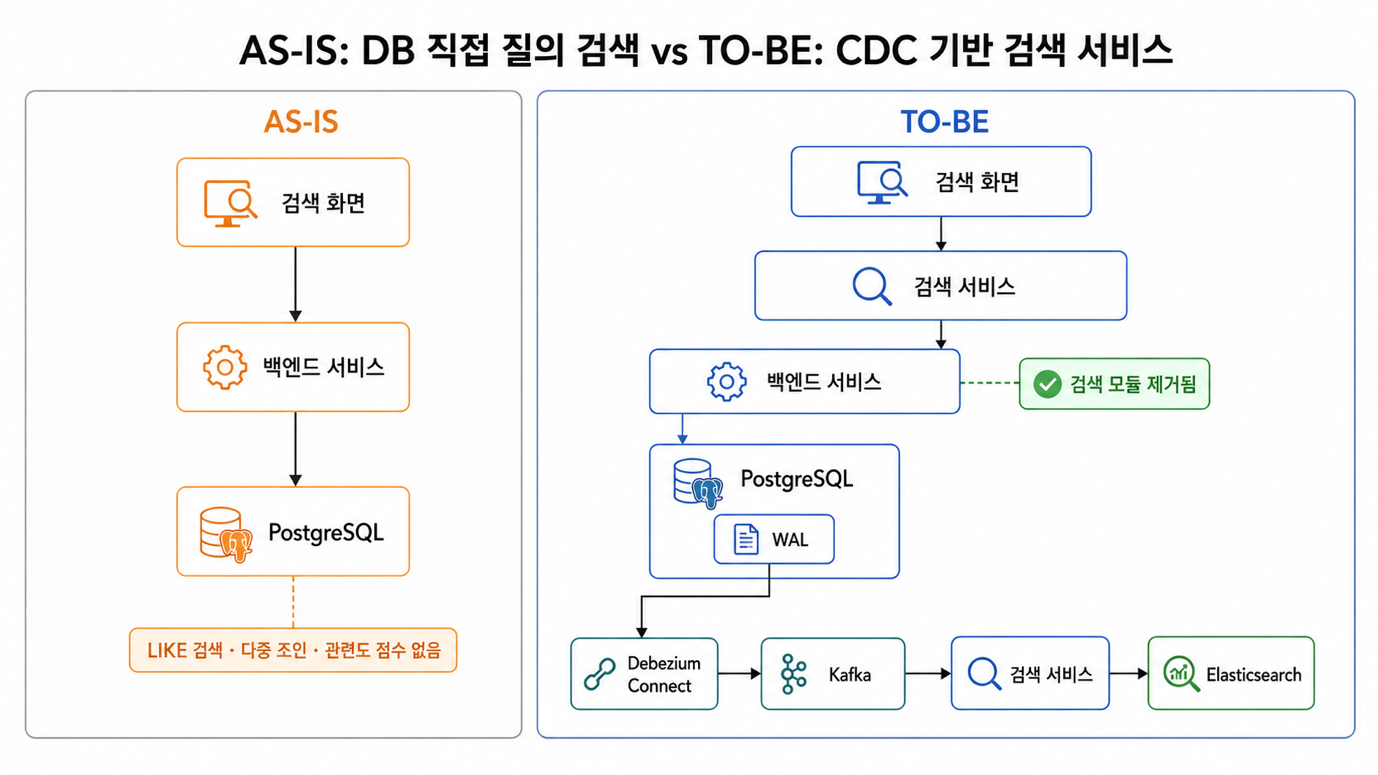
Loyihaga qo‘shilganimda qidiruv ekrani allaqachon yaratilgan edi. Qidiruv mantiqi backend xizmatidan to‘g‘ridan-to‘g‘ri PostgreSQL’ga so‘rov yuborar edi, mening vazifam esa buni Elasticsearch asosidagi yechim bilan almashtirish edi. Ish ko‘lami va jadvali unchalik katta emasdi.
Alohida qidiruv tizimini joriy etish qaroridan keyin muqarrar ravishda bitta savol tug‘iladi: PostgreSQL’dagi manba ma’lumotlar Elasticsearch’ga qanday yuklanadi va keyingi o‘zgarishlar qanday kuzatiladi? Ushbu maqolada avval Logstash’dan foydalanish, keyin esa Debezium asosidagi CDC (Change Data Capture) ga o‘tish jarayoni bayon qilinadi.
2. Mavjud qidiruv usuli va uning cheklovlari
Mavjud qidiruv ekrandan kelgan shartlarni SQL WHERE bandlariga aylantirib, JOIN yordamida bir nechta jadvalga so‘rov yuborar edi. Soddalashtirilgan ko‘rinishda tuzilma taxminan quyidagicha edi.
SELECT ...
  FROM place p
  JOIN place_lang pl ON p.id = pl.place_id
 WHERE pl.lang_code = :langCode
   AND pl.place_name LIKE '%' || :keyword || '%'
 ORDER BY pl.registered_on DESC
 LIMIT :limit OFFSET :offset
Amalning o‘zida hech qanday muammo yo‘q edi. Muammolar qidiruvni haqiqiy qidiruv kabi ishlatishga harakat qilganimizda yuzaga chiqdi.
2.1 Koreys tilidagi qidiruv sifatini yaxshilashning imkoni yo‘q edi
LIKE qidiruvi faqat aynan bir xil satr mavjud yoki mavjud emasligini tekshiradi. U so‘z shakllari yoki ma’nolarni hisobga olmagani sababli, "Jeju Island pension" bo‘yicha qidiruv "Jeju pension" natijasini qaytarmaydi. Qo‘shimcha qo‘shilgan yoki bo‘sh joylar farq qilgan bo‘lsa ham, natija topilmagan deb qaraladi.
Kiritilgan bir nechta so‘zning faqat ayrimlariga mos keladigan natijalarni qanday qayta ishlashni hal qilish ham qiyin edi. Ularni AND bilan birlashtirish deyarli hech qanday natija bermasdi, OR bilan birlashtirish esa aloqasiz natijalarni ham qaytarardi. Bu ikki yondashuv o‘rtasidagi muvozanatni amaliy tarzda nozik sozlashning imkoni yo‘q edi. Ikkala tomonida ham wildcard bo‘lgan LIKE andozalari indeksdan foydalana olmasligi ham doimiy tashvish tug‘dirardi.
Bu ko‘p tilli xizmat bo‘lgani muammoni yanada yaqqol ko‘rsatardi. Har bir til turlicha qayta ishlashni talab qiladi, LIKE esa tilidan qat’i nazar, faqat satr ichida berilgan qism mavjudligini tekshiradi.
2.2 Shartlar ko‘paygani sari so‘rovlar og‘irlashadi
Yo‘nalishni natija sifatida chiqarish uchun destination jadvalini ko‘p tilli jadval bilan birlashtirishimiz kerak edi, kategoriya shartlarini qo‘shish esa yana ikkita JOIN talab qilardi. Kontent qidiruvida ham xuddi shunday holat yuz berardi.
Sahifalash yuklamani yanada oshirardi. Ro‘yxat bilan birga umumiy sonni ham qaytarishimiz kerak edi, buning uchun hisoblash paytida o‘sha JOIN amallarini yana bir bor bajarish talab etilardi. OFFSET asosidagi sahifalashda keyingi sahifalarda o‘qilib, tashlab yuboriladigan satrlar soni ortadi. Ushbu tuzilmada bitta qidiruv shartini qo‘shishning o‘zi ma’lumotlar bazasiga tushadigan yuklamani bevosita oshirardi.
2.3 Relevanti asosida saralashning imkoni yo‘q edi
Bu eng ko‘p ranjitgan qism edi. WHERE bandi faqat biror narsa shartlarga mos keladimi-yo‘qmi, shuni aniqlaydi; u moslik darajasini ko‘rsatuvchi ball qaytarmaydi. Natijada saralash tartibi ro‘yxatdan o‘tkazilgan sanani kamayish tartibida ko‘rsatish bilan cheklangan va qidiruv so‘ziga eng mos yo‘nalishlarni yuqoriga chiqarish talabini ifodalashning imkoni yo‘q edi.
Yaqin atrofdagi yo‘nalishlarni topish funksiyasi ham xuddi shunday cheklovga ega edi. Kenglik va uzunlik diapazonlari bo‘yicha filtrlash amalda aylana emas, to‘g‘ri to‘rtburchak hududni qidirardi va masofa bo‘yicha saralashning imkoni yo‘q edi. Avtomatik to‘ldirish, xatolarni tuzatish va sinonimlar bilan ishlashni ham qo‘lda amalga oshirish kerak edi.
Shu paytda qidiruvga bag‘ishlangan alohida saqlash tizimini yuritish yaxshiroq bo‘ladi, degan xulosaga keldim. Biroq yana bir saqlash tizimini qo‘shishingiz bilanoq navbatdagi muammo darhol paydo bo‘ladi. Manba ma’lumotlar PostgreSQL’da joylashadi, qidiruvlar esa Elasticsearch’da bajariladi, shuning uchun ikkala saqlash tizimi uzluksiz ravishda sinxronlashtirib turilishi kerak.
Eng sodda usul backend xizmatining ma’lumotlarni saqlagandan so‘ng darhol indekslash API’siga murojaat qilishi bo‘lardi. Men bu usulni boshidanoq rad etdim. Bitta so‘rov ikki xil saqlash tizimiga yozadi, ammo ma’lumotlar bazasi tranzaksiyasi Elasticsearch’ni himoya qilmaydi. Ikki tizimdan biri ishlamay qolsa, yuzaga kelgan nomuvofiqlikni aniqlashning iloji bo‘lmaydi. Qidiruvni qo‘shish uchungina mavjud xizmat kodining turli joylariga indekslash chaqiruvlarini kiritish fikri ham menga yoqmadi. Shu sababli sinxronlashtirishni ilovadan tashqarida boshqarishga qaror qildik.
3. Birinchi tanlov Logstash edi
PostgreSQL ma’lumotlarini ilovadan tashqarida Elasticsearch’ga ko‘chirish usulini izlar ekanmiz, birinchi tanlovimiz Logstash bo‘ldi.
Sababi oddiy edi. Elastic ekotizimining tarkibiy qismi bo‘lgani uchun uni Elasticsearch’ga ulash oson edi, JDBC input plugin’da atigi bitta SQL so‘rovini sozlash orqali esa so‘rov natijalarini to‘g‘ridan-to‘g‘ri indeksga yuborish mumkin edi. JOIN so‘rovlaridan o‘z holicha foydalanishimiz mumkin bo‘lgani sababli, bir nechta jadvalni birlashtirgan hujjatlarni yaratish ham qulay edi. Eng muhimi, message broker kabi qo‘shimcha komponentni joylashtirish talab etilmagani uchun joriy etish uchun eng kam kuch sarflanardi.
Qidiruv uchun mo‘ljallangan ikki xil ma’lumot turi bir xil nomdagi indekslarga yuborilishi uchun ikkita input sozladik. O‘zgarishlarni aniqlash uchun oxirgi o‘zgartirilgan vaqt tamg‘asi ustunidan foydalandik. Logstash o‘zi o‘qigan oxirgi vaqt tamg‘asini eslab qolib, faqat shu vaqtdan keyin o‘zgartirilgan satrlarni so‘rardi. So‘rovlarni takrorlash oralig‘i bir daqiqaga o‘rnatildi.
jdbc {
  schedule  => "* * * * *"
  statement => "SELECT ... FROM content
                 WHERE modified_on > :sql_last_value ORDER BY modified_on ASC"
  use_column_value => true
  tracking_column  => "modified_on"
}
Indekslangan hujjatlarning ID’lari manba ma’lumotlarining primary key qiymatlariga teng qilib o‘rnatilgani sababli, bir xil satrning qayta olinishi yig‘ilib boradigan dublikatlar emas, mavjud hujjatlarning ustidan yozilishiga olib kelardi. Shu paytda bu usul barcha ma’lumotlarni dastlab yuklash va keyingi o‘zgarishlarni qidiruvda aks ettirish uchun yetarli ko‘rindi.
Faqat yangi yozuvlar va o‘zgarishlarni tekshirayotganimizda hech qanday muammo bo‘lmadi. Keyin esa muammo yuzaga chiqdi.
4. O‘chirishlar aks etmasligi muammosi va Debezium’ga o‘tish
4.1 O‘chirilgan ma’lumotlar qidiruvda ko‘rinishda davom etdi
Test ma’lumotlarini tozalayotganimda g‘alati narsani payqadim. PostgreSQL’dan o‘chirilgan yo‘nalishlar qidiruv natijalarida hali ham mavjud edi. Avvaliga konfiguratsiyada xato qilganman, deb o‘yladim. Indekslash shunchaki kechikayotgan bo‘lishi mumkin, deb ham taxmin qildim. So‘rovlarni takrorlash oralig‘i bir daqiqa bo‘lgani uchun biroz kutsam, ma’lumotlar yo‘qoladi, deb o‘yladim. Biroq ancha vaqt o‘tgach qayta tekshirganimda ham ular hali bor edi. Konfiguratsiyani yana bir necha marta ko‘rib chiqqanimdan keyingina bu konfiguratsiya xatosi emas, balki yondashuvning o‘ziga xos cheklovi ekanini tushundim.
4.2 So‘rovlarni takroriy bajarish faqat saqlanib qolgan satrlarni ko‘ra oladi
JDBC input plugin vaqti-vaqti bilan SELECT bajaradi va natijalarni Elasticsearch’ga yuboradi. Bu yerda muhim jihat shuki, ushbu usul faqat joriy so‘rov qaytargan satrlarni ko‘ra oladi.
O‘zgartirish vaqt tamg‘asi ma’lum qiymatdan katta bo‘lgan satrlarni so‘rash, boshidanoq jadvalda qolgan satrlar orasidan tanlashni anglatadi. Satr o‘chirilganda u shunchaki so‘rov natijalaridan yo‘qoladi va uning o‘chirilgani haqidagi fakt hech qayerda aks etmaydi. Logstash nuqtayi nazaridan hech qachon mavjud bo‘lmagan ma’lumotni hozirgina o‘chirilgan ma’lumotdan ajratish uchun hech qanday asos yo‘q.
Yangi yozuvlar va o‘zgarishlarning to‘g‘ri aks etganining sababi ham shu edi. Yangi yozuvlar va o‘zgarishlar satrlarni qoldiradi, shuning uchun ular so‘rov tomonidan qaytariladi, o‘chirish esa iz qoldirmaydigan yagona o‘zgarishdir. Shu sababli faqat yangi yozuvlar va o‘zgarishlarni tekshirsangiz, muammoni payqamay qolish oson. Men ham aynan shunday qildim.
Qolib ketgan hujjatlar qidiruv xizmati uchun shunchaki oddiy nomuvofiqlikni anglatmaydi. Ular ro‘yxatda ko‘rinadi, ammo foydalanuvchi ulardan birini bosganda endi mavjud bo‘lmagan obyektning tafsilotlar sahifasiga o‘tadi va bu foydalanuvchiga xato sifatida ko‘rinadi.
4.3 Avval vaqtinchalik yechimlarni ko‘rib chiqdik
Avval Logstash’dan foydalanishni davom ettirgan holda muammoni hal qilish yo‘lini izladik. Xayolimizga ikkita g‘oya keldi.
Birinchisi, yozuvni amalda o‘chirish o‘rniga uning o‘chirilganini bildiruvchi qiymatni yangilaydigan qilib implementatsiyani o‘zgartirish edi. O‘chirish yangilanish sifatida qayd etilgani uchun uni so‘rovlarni takroriy bajarish orqali aniqlash, qidiruv so‘rovida esa bunday yozuvlarni filtrlash mumkin bo‘lardi. Biroq buning uchun manba jadvaliga ustun qo‘shish va xizmatdagi barcha mavjud o‘chirish mantiqini o‘zgartirish kerak bo‘lardi.
Ikkinchi usul ikkala tomondagi ID ro‘yxatlarini vaqti-vaqti bilan taqqoslab, manbada endi mavjud bo‘lmagan hujjatlarni o‘chirish edi. Bunda tuzilmani o‘zgartirish shart emas, ammo ma’lumotlar ko‘paygani sari taqqoslash xarajati ortadi va noto‘g‘ri hujjatlar kamida taqqoslash oralig‘i davomida ko‘rinib turadi.
Ikkala usul ham qidiruv to‘g‘ri ishlashi uchun manba tizimini o‘zgartirish yoki uni keyinroq tozalashni talab qilardi.Agar ma’lumotlarni ilovadan tashqarida sinxronlashtirish uchun tanlagan usulimiz oxir-oqibat sxema va xizmat kodini o‘zgartirishni talab qilsa, uni dastlab tanlashimizga sabab qolmaydi. Bizga vaqtinchalik yechim emas, o‘chirishni o‘chirish sifatida xabar qiladigan yo‘l kerak edi.
4.4 Shunday qilib, Debezium’ga o‘tdik
Debezium ma’lumotlar bazasining tranzaksiya jurnallariga bevosita obuna bo‘ladi. PostgreSQL’da u mantiqiy replikatsiya orqali WAL (Write-Ahead Log) ni o‘qiydi.
Hal qiluvchi farq shunda. Jadvalni so‘rashda o‘chirilgan satrlar ko‘rinmaydi, ammo tranzaksiya jurnali nima va qachon o‘chirilganini qayd etadi. U so‘rov natijalarini emas, o‘zgarishlar yozuvlarini o‘qigani uchun DELETE hodisalari bilan bir qatorda INSERT va UPDATE hodisalarini ham yetkazadi.
O‘chirish hodisasi quyidagi ko‘rinishda keladi. op maydoni d qiymatiga ega, before esa o‘chirishdan bevosita oldingi qiymatlarni o‘z ichiga oladi, shuning uchun aynan nima yo‘qolgani aniq ko‘rinadi.
{
  "op": "d",
  "before": { "id": "...", "lang_code": "ko", ... },
  "after": null
}
O‘chirishlarni to‘g‘ri qayta ishlash eng katta foyda bo‘ldi, ammo o‘tishdan keyin boshqa afzalliklar ham paydo bo‘ldi. Endi o‘zgartirish vaqt tamg‘asi ustuni to‘g‘ri yangilangan-yangilanmaganiga bog‘liq emasmiz. Ma’lumotlar qanday o‘zgarmasin, o‘zgarish jurnalda qayd etiladi. Connector’ning snapshot funksiyasi dastlabki to‘liq ma’lumot yuklanishini ham boshqargani uchun alohida so‘rov yaratishga hojat qolmadi.
|
Kategoriya |
Logstash JDBC input |
Debezium CDC |
|---|---|---|
|
U nimani kuzatadi |
Hozirda so‘rov yuborilayotgan qatorlar |
Tranzaksiyalar jurnalidagi o‘zgarishlar yozuvlari |
|
O‘zgarishlarni aniqlash |
Har daqiqada SELECT so‘rovi yuborish |
WAL obunasi |
|
O‘chirishni aniqlash |
Mumkin emas. U faqat natijalardan yo‘qoladi |
O‘chirish hodisasi sifatida yetkaziladi |
|
Kuzatuv mezoni |
Oxirgi o‘zgartirilgan vaqt tamg‘asi ustuni |
LSN (Log Sequence Number) |
|
Manba sxemasidagi o‘zgarishlar |
O‘chirish bayrog‘i joriy etilganda talab qilinadi |
Kerak emas |
|
Dastlabki yuklash |
Alohida so‘rov |
O‘rnatilgan snapshot funksiyasi |
|
Qo‘shimcha komponentlar |
Hech biri |
Kafka, Kafka Connect |
|
Operatsion yuklama |
Past |
Replikatsiya slotlari va connector boshqaruvi talab qilinadi |
Albatta, buning ham o‘z qiymati bor. Kafka va Kafka Connect bilan operatsion komponentlar soni ortadi, shuningdek, replikatsiya sloti deb ataladigan ma’lumotlar bazasi resursini boshqarish kerak bo‘ladi. Shunga qaramay, biz bu o‘zgarishni amalga oshirishga qaror qildik, chunki o‘tkazib yuborilgan o‘chirishlarni vaqtinchalik yechim bilan bartaraf etib bo‘lmas edi. Konfiguratsiya qanchalik sodda bo‘lmasin, noto‘g‘ri natijalar qaytaradigan qidiruv tizimidan foydalanib bo‘lmaydi.
5. CDC konveyerini sozlash
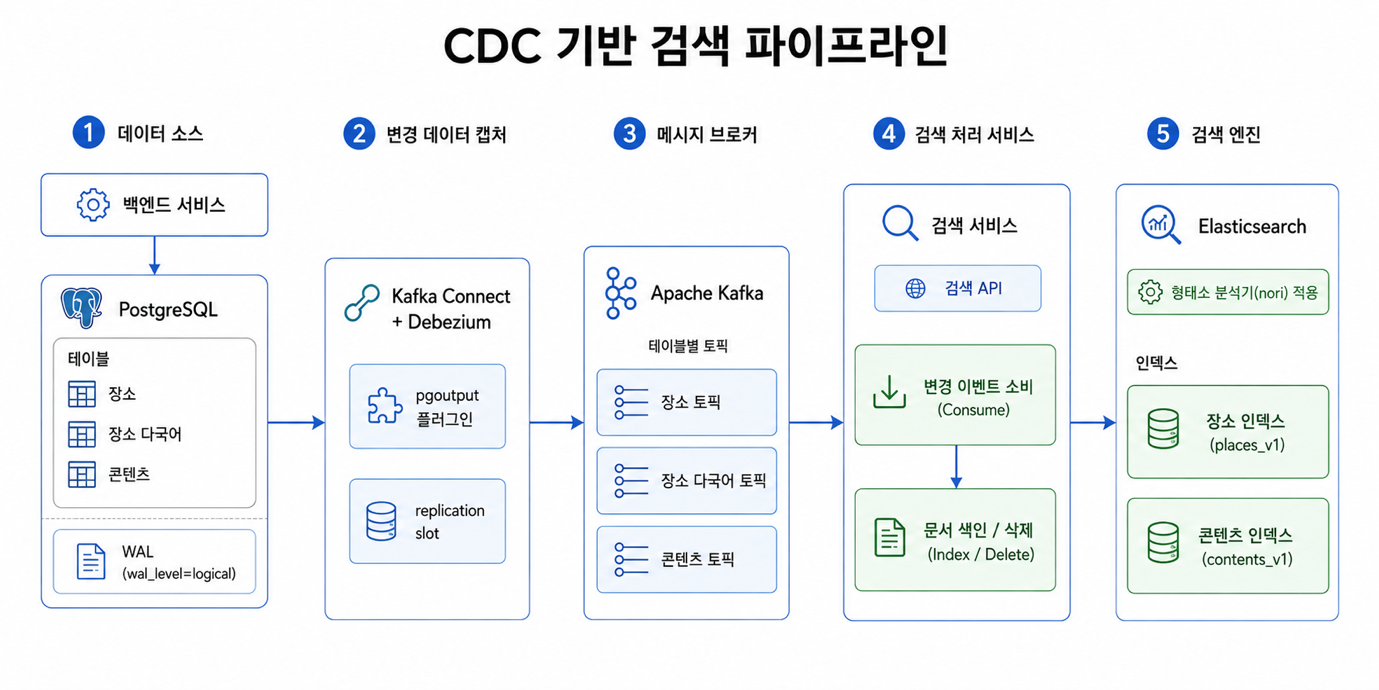
O‘tishdan so‘ng Debezium o‘zgarishlarni PostgreSQL’dan Kafka topic’iga uzatadi, alohida joylashtirilgan qidiruv xizmati esa ularni qabul qilib, Elasticsearch’da indekslaydi.
5.1 PostgreSQL mantiqiy replikatsiyasini tayyorlash
Debezium WAL’ni o‘qishi uchun ma’lumotlar bazasi mantiqiy replikatsiyaga ruxsat berishi kerak. Biz wal_level qiymatini logical ga o‘zgartirdik hamda yetarli miqdorda replikatsiya slotlari va WAL sender jarayonlarini ta’minladik. Bu sozlamalar qayta ishga tushirishni talab qilgani sababli, ularni qachon qo‘llash masalasini alohida muvofiqlashtirdik.
# postgresql.conf
wal_level = logical
max_replication_slots = 10
max_wal_senders = 10
Biz hal qilishimiz kerak bo‘lgan yana bir masala REPLICA IDENTITY bo‘ldi. Standart sozlamada UPDATE va DELETE hodisalari faqat primary key’ni o‘z ichiga oladi, shuning uchun o‘chirishdan bevosita oldingi qiymatni ham olish kerak bo‘lsa, uni FULL ga o‘rnatish lozim. Biroq FULL yozib olinadigan WAL hajmini oshiradi, shu sababli uni faqat avvalgi qiymatlar haqiqatan kerak bo‘lgan jadvallarga qo‘lladik.
5.2 Debezium connector’ini sozlash
Kafka Connect’ni Debezium image’idan o‘zgartirishsiz foydalanib joylashtirdik. Connector konfiguratsiyasi, offset’lar va holat Kafka topic’larida saqlangani uchun, container qayta ishga tushirilganda ham tizim qancha qismni qayta ishlaganini yo‘qotib qo‘ymaydi. Connector’ni REST API orqali ro‘yxatdan o‘tkazdik va PostgreSQL’ga o‘rnatilgan mantiqiy dekodlash plagini — pgoutput’dan foydalandik. Bu muhitni soddalashtiradi, chunki alohida plaginni o‘rnatish shart emas.
{
  "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
  "plugin.name": "pgoutput",
  "topic.prefix": "...",
  "slot.name": "...",
  "table.include.list": "public.place,public.place_lang,public.content",
  "snapshot.mode": "initial",
  "tombstones.on.delete": "false"
}
Faqat qidiruv uchun zarur bo‘lgan jadvallarni ko‘rsatish ataylab tanlangan qaror edi. Barcha jadvallarga obuna bo‘linsa, qidiruvga aloqasi bo‘lmagan o‘zgarishlar ham konveyerdan o‘tib, yuklamani keraksiz ravishda oshiradi. Connector mavjud ma’lumotlarni dastlabki yuklashni ham amalga oshirishi uchun snapshot rejimini initial ga o‘rnatdik. Natijada, avval Logstash’da alohida so‘rov orqali bajarilgan ish bitta konfiguratsiya qatoriga birlashtirildi.
5.3 Qidiruv xizmatini ajratish va morfologik analizatorni qo‘llash
Qidiruvni mavjud backend xizmatidan olib tashlab, uni alohida mikroxizmatga aylantirdik. Mavjud xizmat faqat ma’lumotlarni PostgreSQL’da saqlaydi, qidiruv xizmati esa Kafka orqali keladigan o‘zgarishlar hodisalarini qabul qiladi, hujjatlarni indekslaydi va qidiruv API’sini taqdim etadi.
Ularni ajratishdan maqsad indeksni qayta qurish yoki mapping’larni o‘zgartirish kabi vazifalarning mavjud xizmat deploy’lari bilan chalkashib ketishining oldini olish edi. Shuningdek, ommaviy indekslash hosil qiladigan yuklama mavjud API javoblariga ta’sir qilmasligini ta’minlashimiz kerak edi. Natijada, qidiruvga oid barcha modullar mavjud xizmatdan olib tashlandi va hatto Elasticsearch’ga yo‘naltiruvchi sozlama ham qolmadi.
Koreys tilidagi qidiruv uchun Elasticsearch’ga morfologik analiz plagini bo‘lgan nori’ni o‘rnatdik. Standart analizator tokenlarni bo‘shliqlar asosida ajratgani sababli, u koreys tilidagi yuklamalar yoki qo‘shma otlar bilan to‘g‘ri ishlay olmaydi. nori qo‘llanganda, “Jejudo” “Jeju” va “do” qismlariga ajratilgandan so‘ng indekslanadi, shuning uchun ilgari mos kelmagan qidiruv so‘zlari natijalarni qaytara boshlaydi. Biroq bu safar biz faqat plaginni qo‘shish va standart xatti-harakatni tekshirishgacha bordik; so‘z turkumi filtrlarini yoki sinonimlar lug‘atini takomillashtirishga ulgurmadik.
5.4 Operatsion jihatlar
CDC ma’lumotlar bazasi ichidagi mexanizmlardan foydalangani sababli, u operatsion jihatlarni ham hisobga olishni talab qiladi. Kuzatilishi kerak bo‘lgan eng muhim narsa — replikatsiya sloti.
Replikatsiya sloti WAL’ni faqat iste’molchi uni o‘qiganini tasdiqlagan nuqtaga qadar tozalaydi. Boshqacha aytganda, connector to‘xtatilgan paytda shu nuqtadan keyin yaratilgan WAL to‘planishda davom etadi. Agar pod o‘chirilgan holda qolib, bu holat unutilsa, u ma’lumotlar bazasi disk maydonini egallab tugatishi mumkin. Shu sababli connector’ni to‘xtatish tartibiga slot holatini tekshirishni qo‘shdik va ishlatilmayotgan slotlarni o‘chirishni sozladik.
SELECT slot_name, active,
       pg_size_pretty(
         pg_wal_lsn_diff(pg_current_wal_lsn(), confirmed_flush_lsn)
       ) AS retained_wal
  FROM pg_replication_slots;
6. Xulosa
Quyida qidiruv yo‘lini o‘zgartirganimizda nimalar o‘zgargani umumlashtirilgan.
|
Kategoriya |
Mavjud tuzilma |
Joriy etilgandan so‘ng |
|---|---|---|
|
Qidiruvni bajarish |
PostgreSQL join so‘rovi |
Elasticsearch indeksidan qidirish |
|
Koreys tilini qayta ishlash |
LIKE orqali qism satrni moslashtirish |
nori morfologik analizatori |
|
Dolzarblik bo‘yicha saralash |
Ro‘yxatdan o‘tkazilgan sana bo‘yicha kamayish tartibida qat’iy belgilangan |
Ball asosida saralash mavjud |
|
Sinxronizatsiya usuli |
Logstash har 1 daqiqada so‘rov yuboradi |
Debezium CDC (WAL obunasi) |
|
O‘chirish aks ettiriladi |
Aniqlab bo‘lmaydi. Hujjat saqlanib qoladi |
O‘chirish hodisasi orqali aks ettiriladi |
|
Dastlabki yuklash |
Alohida so‘rov |
Konnektor surati |
|
Xizmat arxitekturasi |
Backend xizmati qidiruvni ham amalga oshiradi |
Alohida qidiruv xizmatiga ajratilgan |
7. Xulosa
Bu ishda menda qolgan narsa Debezium’ning o‘zi emas, balki dastlab tanlagan yondashuvim nima sababdan ishlamaganini tasdiqlash jarayoni bo‘ldi. Logstash’ni sozlash oddiy bo‘lgani va dastlabki yuklashni yaxshi bajargani uchun, yuzaki qaraganda unda hech qanday muammo yo‘qdek ko‘rindi. Agar o‘chirish bilan bog‘liq yagona holatni tekshirmaganimda, buni sezmay, ishni davom ettirgan bo‘lardim.
Ortga nazar tashlasam, muammo tekshiruvimni ro‘yxatdan o‘tkazish va yangilashga qaratganimda bo‘lgan. Har ikkala holatda ham ma’lumot oxir-oqibat saqlanib qoladi, shu sababli sinxronizatsiya usullarining aksariyati nisbatan yaxshi ishlaydi. Yondashuvlar o‘rtasidagi farq ma’lumot yo‘qolganda yaqqol ko‘rinadi, men esa bu holatni juda kech ko‘rib chiqdim. Keyingi safar shunga o‘xshash ish qilsam, avval o‘chirishni tekshirishni rejalashtiryapman. Texnologiya tanlash haqida ham bir narsani o‘rgandim. Agar polling usuli tabiatan nimani kuzata olmasligini boshidanoq bilganimda, Logstash’ni ulashga urinib ko‘rishdan oldinroq qaror qabul qilgan bo‘lardim.
Tim