
1. Предпосылки перехода поиска на Elasticsearch
Проект, над которым я работал, представлял собой платформу с туристическими направлениями и связанным с ними контентом на нескольких языках. Поскольку основной функцией сервиса был поиск подходящих направлений и материалов, когда пользователи вводили название региона или направления, качество поиска фактически определяло качество всего сервиса.
У структуры данных была одна примечательная особенность. Информация о направлениях была разделена на языконезависимую и языковозависимую части. Значения, не требующие перевода, такие как координаты и статус видимости, хранились в таблице направлений, а значения, требующие перевода, такие как названия направлений, адреса и краткие описания, хранились в мультиязычной таблице — по одной строке на каждый язык. Контент также содержал код языка по тому же принципу.
С точки зрения нормализации это естественная конструкция. Однако с точки зрения поиска она означает, что для формирования одного результата необходимо проверить как минимум две таблицы. После добавления условий по категориям или тегам количество таблиц, которые нужно проверить, увеличивается ещё больше.
Когда я присоединился к проекту, экран поиска уже был создан. Логика поиска напрямую выполняла запросы к PostgreSQL из серверной части, а моей задачей было заменить её реализацией на базе Elasticsearch. Масштаб и сроки проекта не были особенно большими.
После принятия решения внедрить отдельный поисковый движок неизбежно возникает один вопрос: как загрузить исходные данные из PostgreSQL в Elasticsearch и как отслеживать последующие изменения? В этой статье описан процесс, начавшийся с Logstash и завершившийся переходом на CDC (Change Data Capture) на базе Debezium.
2. Существующий способ поиска и его ограничения
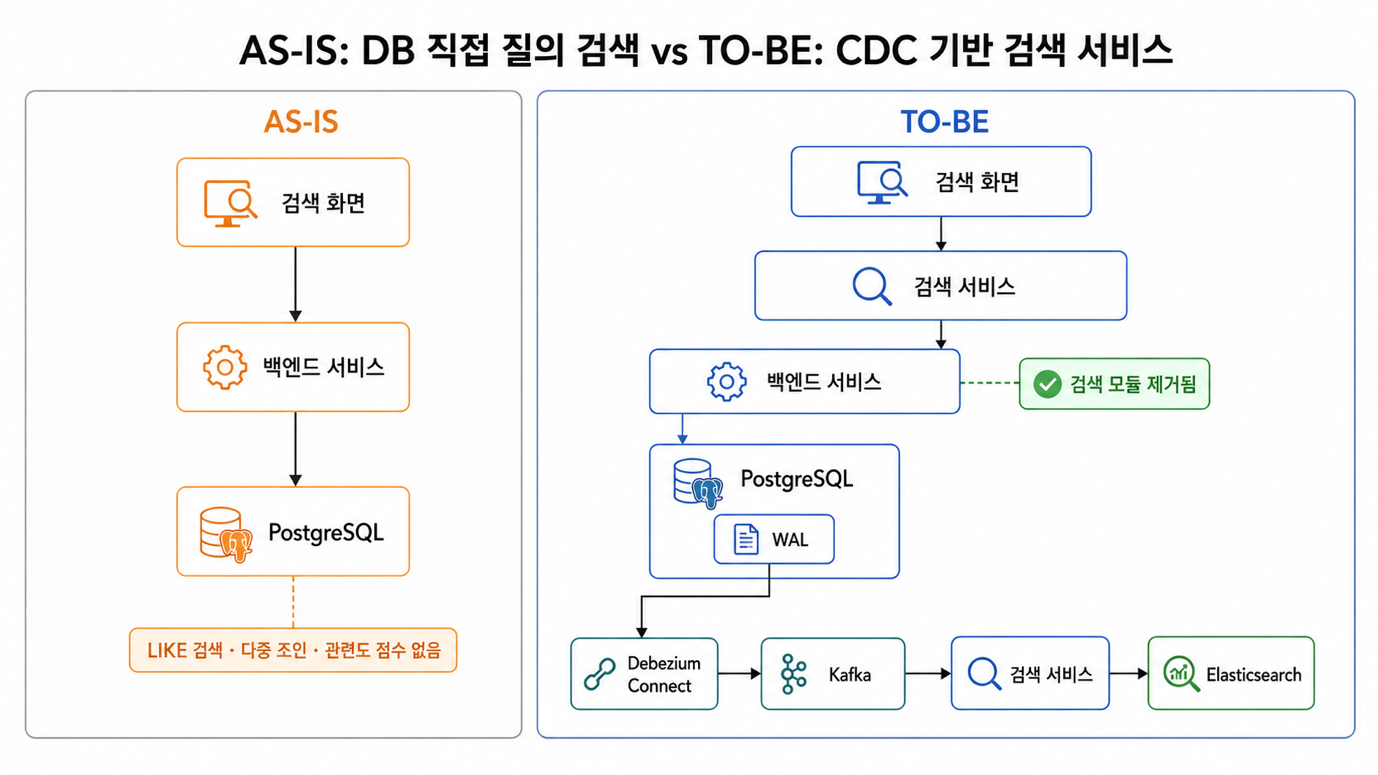
Существующий поиск преобразовывал условия, полученные с экрана, в SQL-условия WHERE и выполнял запросы к нескольким таблицам с использованием объединений. В упрощённом виде структура выглядела примерно так.
SELECT ...
  FROM place p
  JOIN place_lang pl ON p.id = pl.place_id
 WHERE pl.lang_code = :langCode
   AND pl.place_name LIKE '%' || :keyword || '%'
 ORDER BY pl.registered_on DESC
 LIMIT :limit OFFSET :offset
Сама работа системы не вызывала проблем. Проблемы появились, когда мы попытались сделать поиск похожим на настоящий поиск.
2.1 Невозможно было повысить качество поиска на корейском языке
Поиск с помощью LIKE проверяет только наличие точной строки. Поскольку он не учитывает формы слов и их значения, поиск по запросу «пансионат на острове Чеджу» не вернёт «пансионат в Чеджу». Если к слову присоединена частица или отличается расстановка пробелов, результат также будет считаться ненайденным.
Также было сложно решить, как обрабатывать результаты, совпадающие только с некоторыми из нескольких введённых слов. Объединение условий через AND почти не давало результатов, а объединение через OR возвращало в том числе нерелевантные результаты. Практического способа тонко настроить баланс между этими вариантами не было. Кроме того, постоянно вызывало беспокойство то, что шаблоны LIKE с подстановочными символами с обеих сторон не могли использовать индекс.
То, что сервис был мультиязычным, делало проблему ещё более заметной. Для каждого языка требуется своя обработка, тогда как LIKE лишь проверяет, содержится ли строка, независимо от языка.
2.2 Запросы становятся тяжелее по мере увеличения числа условий
Чтобы вернуть направление в качестве результата, нам приходилось объединять таблицу направлений с мультиязычной таблицей, а добавление условий по категориям требовало ещё двух объединений. При поиске контента ситуация была аналогичной.
Пагинация увеличивала нагрузку ещё сильнее. Вместе со списком нам нужно было возвращать общее количество результатов, что требовало повторного выполнения тех же объединений для подсчёта. При пагинации на основе OFFSET на последующих страницах увеличивается количество считываемых и отбрасываемых строк. В такой структуре добавление одного условия поиска напрямую увеличивало нагрузку на базу данных.
2.3 Сортировка по релевантности была невозможна
Это было самым неприятным ограничением. Условие WHERE лишь определяет, соответствует ли что-либо заданным условиям; оно не возвращает оценку, показывающую степень соответствия. В результате порядок сортировки был фиксированным — по убыванию даты регистрации, — и не существовало способа выразить требование выводить наверх направления, наиболее релевантные поисковому запросу.
У функции поиска ближайших направлений было то же ограничение. Фильтрация по диапазонам широты и долготы фактически выполняла поиск в прямоугольной области, а сортировать результаты по расстоянию было невозможно. Автодополнение, исправление опечаток и обработку синонимов также приходилось реализовывать вручную.
На этом этапе я пришёл к выводу, что лучше поддерживать отдельное хранилище, предназначенное для поиска. Однако сразу после добавления ещё одной системы хранения возникает следующая проблема. Исходные данные находятся в PostgreSQL, а поиск выполняется в Elasticsearch, поэтому эти две системы хранения необходимо постоянно синхронизировать.
Самым простым способом было бы вызвать API индексации из серверной части сразу после сохранения данных. Я отказался от этого варианта с самого начала. Один запрос записывал бы данные в две разные системы хранения, но транзакция базы данных не защищала бы Elasticsearch. При сбое одной из систем обнаружить возникшее несоответствие было бы невозможно. Мне также не нравилась идея добавлять вызовы индексации по всему существующему коду сервиса только ради внедрения поиска. Поэтому мы решили обрабатывать синхронизацию за пределами приложения.
3. Первым выбором стал Logstash
Ища способ перемещать данные из PostgreSQL в Elasticsearch за пределами приложения, вначале мы выбрали Logstash.
Причина была простой. Как компонент экосистемы Elastic, он легко подключался к Elasticsearch, а благодаря настройке всего одного SQL-запроса в плагине JDBC input результаты запроса можно было напрямую отправлять в индекс. Поскольку мы могли использовать запросы с объединениями без изменений, Logstash также был удобен для создания документов, объединяющих несколько таблиц. И самое главное — для его внедрения требовалось меньше всего усилий, поскольку не нужно было разворачивать дополнительный компонент, например брокер сообщений.
Мы настроили два входных потока, чтобы два типа данных, предназначенных для поиска, отправлялись каждый в индекс с одинаковым именем. Для обнаружения изменений использовался столбец с отметкой времени последнего изменения. Logstash запоминал последнюю прочитанную отметку времени и запрашивал только строки, изменённые после этого момента. Интервал опроса установили равным одной минуте.
jdbc {
  schedule  => "* * * * *"
  statement => "SELECT ... FROM content
                 WHERE modified_on > :sql_last_value ORDER BY modified_on ASC"
  use_column_value => true
  tracking_column  => "modified_on"
}
Поскольку идентификаторы индексируемых документов задавались равными первичным ключам исходных данных, повторное получение той же строки приводило к перезаписи, а не к накоплению дубликатов. На этом этапе казалось, что этого достаточно и для первоначальной загрузки всех данных, и для отражения последующих изменений в поиске.
Пока мы проверяли только добавление и изменение записей, проблем не возникало. Следующей обнаружилась другая проблема.
4. Проблема с неотражёнными удалениями и переход на Debezium
4.1 Удалённые данные продолжали отображаться в поиске
Во время очистки тестовых данных я заметил нечто странное. Направления, удалённые из PostgreSQL, по-прежнему присутствовали в результатах поиска. Сначала я подумал, что допустил ошибку в конфигурации. Я также предположил, что индексация могла просто задерживаться. Поскольку интервал опроса составлял одну минуту, я решил, что данные исчезнут, если немного подождать. Однако при повторной проверке значительно позже они всё ещё были на месте. Только после нескольких дополнительных проверок конфигурации я понял, что это не ошибка настройки, а inherentное ограничение самого подхода.
4.2 При опросе можно увидеть только сохранившиеся строки
Плагин JDBC input периодически выполняет SELECT и отправляет результаты в Elasticsearch. Здесь важно то, что этот метод может видеть только строки, возвращённые текущим запросом.
Запрос строк, у которых отметка времени изменения больше определённого значения, с самого начала означает выбор только среди строк, остающихся в таблице. Когда строка удаляется, она просто исчезает из результатов запроса, а сам факт её удаления нигде не представляется. С точки зрения Logstash нет оснований отличить данные, которых никогда не существовало, от данных, которые только что были удалены.
По той же причине добавление и изменение записей отражались корректно. После добавления или изменения строки остаются в таблице и возвращаются запросом, тогда как удаление — единственное изменение, не оставляющее следа. Поэтому проблему легко не заметить, если проверять только добавление и изменение записей. Именно так поступил и я.
Оставшиеся документы создают не просто несоответствие для поискового сервиса. Они отображаются в списке, но при нажатии на один из них открывается страница сведений о сущности, которой больше не существует, что для пользователя выглядит как ошибка.
4.3 Сначала мы рассмотрели обходные решения
Сначала мы попытались найти способ решить проблему, сохранив Logstash. В голову пришли две идеи.
Первой было изменить реализацию так, чтобы вместо фактического удаления обновлялось значение, указывающее, что запись удалена. Поскольку удаление в этом случае считалось бы обновлением, опрос мог бы обнаружить его, а поисковый запрос — отфильтровать такую запись. Однако для этого потребовалось бы добавить столбец в исходную таблицу и изменить всю существующую логику удаления в сервисе.
Второй идеей было периодически сравнивать списки идентификаторов с обеих сторон и удалять документы, которых больше нет в источнике. Это не требовало бы изменения структуры, но стоимость сравнения росла бы вместе с объёмом данных, а ошибочные документы оставались бы видимыми как минимум в течение интервала между сравнениями.
Оба метода требовали изменить исходную систему или выполнять последующую очистку просто для того, чтобы поиск работал корректно.Если выбранный нами способ синхронизации данных за пределами приложения в конечном итоге требовал изменения схемы и кода сервиса, то причина его первоначального выбора исчезала. Нам требовалось не обходное решение, а способ, при котором удаление передавалось бы именно как удаление.
4.4 Поэтому мы перешли на Debezium
Debezium напрямую подписывается на журналы транзакций базы данных. В PostgreSQL он считывает WAL (Write-Ahead Log) посредством логической репликации.
В этом и заключается решающее отличие. Удалённые строки не видны при запросе к таблице, но журнал транзакций фиксирует, что именно и когда было удалено. Поскольку Debezium считывает записи об изменениях, а не результаты запросов, он передаёт события INSERT и UPDATE, а также события DELETE.
Событие удаления приходит в следующем виде. Поле op содержит значение d, а before — значения непосредственно перед удалением, поэтому становится ясно, что именно исчезло.
{
  "op": "d",
  "before": { "id": "...", "lang_code": "ko", ... },
  "after": null
}
Главным преимуществом было то, что удаления начали обрабатываться корректно, но после перехода появились и другие плюсы. Нам больше не приходилось зависеть от того, было ли правильно обновлено поле с отметкой времени изменения. Независимо от того, как изменялись данные, изменение записывалось в журнал. Функция snapshot коннектора также выполняла первоначальную полную загрузку данных, поэтому создавать отдельный запрос не требовалось.
|
Категория |
Входной поток Logstash JDBC |
CDC Debezium |
|---|---|---|
|
Что он отслеживает |
Запрашиваемые в данный момент строки |
Записи об изменениях в журнале транзакций |
|
Обнаружение изменений |
Опрос с помощью SELECT каждую минуту |
Подписка на WAL |
|
Обнаружение удалений |
Невозможно. Они просто исчезают из результатов |
Передаются как событие удаления |
|
Критерий отслеживания |
Столбец с отметкой времени последнего изменения |
LSN (порядковый номер записи в журнале) |
|
Изменения схемы источника |
Требуется при введении флага удаления |
Не требуется |
|
Первоначальная загрузка |
Отдельный запрос |
Встроенная функция создания снимка |
|
Дополнительные компоненты |
Нет |
Kafka, Kafka Connect |
|
Операционные накладные расходы |
Низкие |
Требуется управление слотами репликации и коннектором |
Конечно, это также имеет свою цену. При использовании Kafka и Kafka Connect увеличивается количество операционных компонентов, а ресурс базы данных, называемый слотом репликации, необходимо администрировать. Несмотря на это, мы решили перейти на новую схему, поскольку пропущенные удаления нельзя было устранить с помощью обходного решения. Каким бы простым ни была конфигурация, поисковую систему, возвращающую некорректные результаты, использовать нельзя.
5. Настройка конвейера CDC
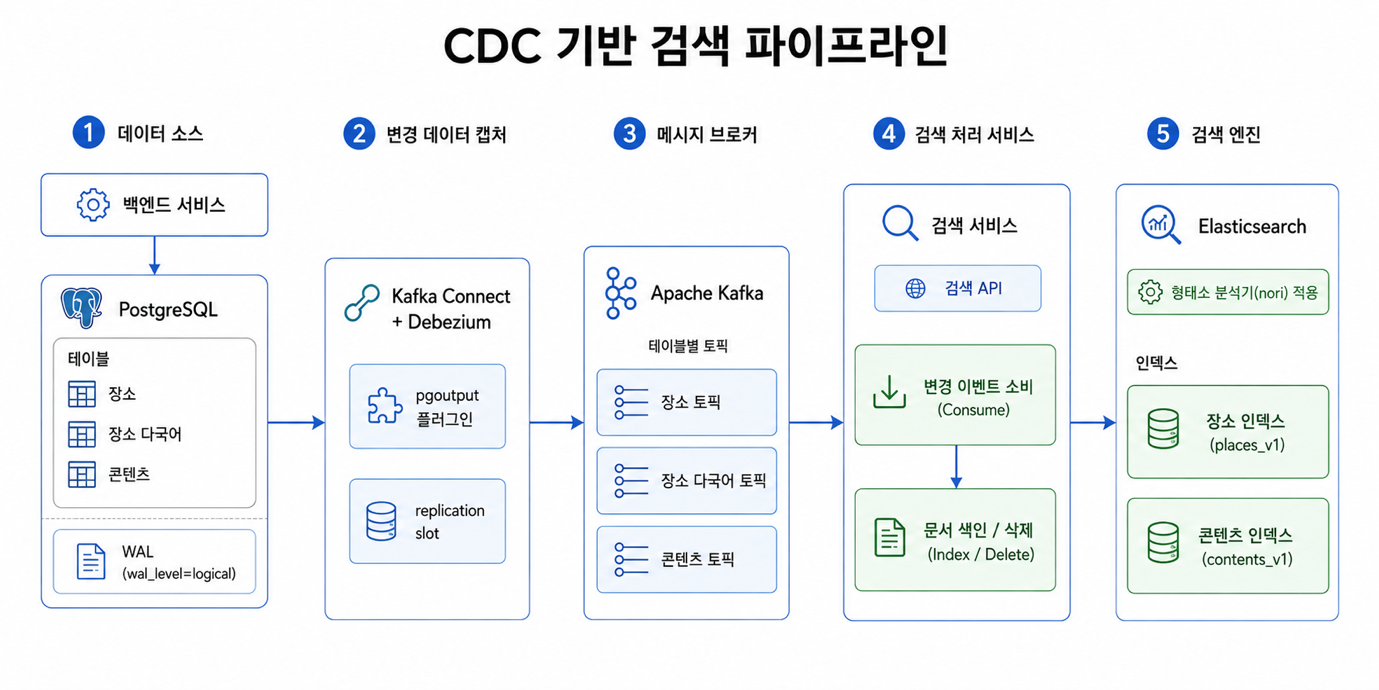
После перехода Debezium передаёт изменения из PostgreSQL в раздел Kafka, а отдельно развёрнутый поисковый сервис получает их, индексирует и сохраняет в Elasticsearch.
5.1 Подготовка логической репликации PostgreSQL
Чтобы Debezium мог читать WAL, база данных должна разрешать логическую репликацию. Мы установили для wal_level значение logical и обеспечили достаточное количество слотов репликации и процессов WAL sender. Поскольку эти настройки требуют перезапуска, мы отдельно согласовали время их применения.
# postgresql.conf
wal_level = logical
max_replication_slots = 10
max_wal_senders = 10
Ещё один вопрос, который требовалось решить, — REPLICA IDENTITY. При настройке по умолчанию события UPDATE и DELETE содержат только первичный ключ, поэтому, если необходимо также получать значение непосредственно перед удалением, следует установить значение FULL. Однако FULL увеличивает объём записываемых данных WAL, поэтому мы применили его только к таблицам, которым действительно требовались предыдущие значения.
5.2 Настройка коннектора Debezium
Мы развернули Kafka Connect без изменений, используя образ Debezium. Поскольку конфигурация коннектора, смещения и его состояние хранятся в разделах Kafka, система не теряет информацию о том, насколько далеко она продвинулась в обработке, даже при перезапуске контейнера. Мы зарегистрировали коннектор через REST API и использовали pgoutput — встроенный в PostgreSQL плагин логического декодирования. Это упрощает среду, поскольку отдельный плагин устанавливать не нужно.
{
  "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
  "plugin.name": "pgoutput",
  "topic.prefix": "...",
  "slot.name": "...",
  "table.include.list": "public.place,public.place_lang,public.content",
  "snapshot.mode": "initial",
  "tombstones.on.delete": "false"
}
Указание только таблиц, необходимых для поиска, было осознанным выбором. Если подписаться на все таблицы, через конвейер будут проходить даже изменения, не связанные с поиском, что приведёт к ненужному увеличению нагрузки. Мы установили для режима снимка значение initial, чтобы коннектор также выполнял первоначальную загрузку существующих данных. Фактически работа, ранее выполнявшаяся отдельным запросом в Logstash, была сведена к одной строке конфигурации.
5.3 Выделение поискового сервиса и применение морфологического анализатора
Мы удалили поиск из существующего серверного сервиса и сделали его отдельным микросервисом. Существующий сервис только сохраняет данные в PostgreSQL, а поисковый сервис получает через Kafka события изменений, индексирует документы и предоставляет API поиска.
Причина разделения заключалась в том, чтобы такие задачи, как перестроение индекса или изменение маппингов, не оказывались связанными с развёртыванием существующего сервиса. Нам также требовалось гарантировать, что нагрузка, создаваемая массовой индексацией, не повлияет на ответы существующего API. В результате из существующего сервиса были удалены все модули, связанные с поиском, и в нём не осталось даже настройки с указанием Elasticsearch.
Для поиска на корейском языке мы установили в Elasticsearch nori — плагин морфологического анализа. Поскольку анализатор по умолчанию разделяет токены по пробельным символам, он не может корректно обрабатывать корейские частицы и сложные существительные. При применении nori слово “Jejudo” индексируется после разделения на “Jeju” и “do”, поэтому поисковые запросы, которые ранее не давали совпадений, начинают возвращать результаты. Однако на этот раз мы ограничились добавлением плагина и проверкой поведения по умолчанию; до настройки фильтров по частям речи и словаря синонимов дело не дошло.
5.4 Операционные аспекты
Поскольку CDC использует механизмы внутри базы данных, он также требует учёта операционных аспектов. Важнее всего контролировать слот репликации.
Слот репликации очищает WAL только до той точки, до которой потребитель подтвердил чтение. Иными словами, пока коннектор остановлен, WAL, созданный после этой точки, продолжает накапливаться. Если оставить pod выключенным и забыть о нём, он может занять всё дисковое пространство базы данных. Поэтому мы добавили проверку состояния слота в процедуру остановки коннектора и настроили удаление неиспользуемых слотов.
SELECT slot_name, active,
       pg_size_pretty(
         pg_wal_lsn_diff(pg_current_wal_lsn(), confirmed_flush_lsn)
       ) AS retained_wal
  FROM pg_replication_slots;
6. Итоги
Ниже приведено резюме изменений, произошедших после изменения пути поиска.
|
Категория |
Существующая структура |
После внедрения |
|---|---|---|
|
Выполнение поиска |
Запрос с объединением в PostgreSQL |
Поиск в индексе Elasticsearch |
|
Обработка корейского языка |
Поиск подстроки с помощью LIKE |
Морфологический анализ nori |
|
Сортировка по релевантности |
Жёстко задана сортировка по убыванию даты регистрации |
Доступна сортировка по оценке |
|
Метод синхронизации |
Опрос Logstash раз в 1 минуту |
CDC Debezium (подписка на WAL) |
|
Удаление отражается |
Невозможно обнаружить. Документ сохраняется |
Отражается через событие удаления |
|
Первоначальная загрузка |
Отдельный запрос |
Снимок Connector |
|
Архитектура сервиса |
Бэкенд-сервис также обрабатывает поиск |
Выделено в отдельный поисковый сервис |
7. Заключение
В результате этой работы мне запомнился не сам Debezium, а процесс выяснения того, почему первоначально выбранный мной подход не сработал. Поскольку Logstash было просто настроить и он хорошо справлялся с первоначальной загрузкой, на первый взгляд проблем не возникало. Если бы я не проверил единственный случай с удалением, то продолжил бы работу, ничего не заметив.
Оглядываясь назад, я понимаю, что сосредоточил проверку на регистрации и обновлениях. В обоих случаях данные в итоге сохраняются, поэтому большинство методов синхронизации работает вполне приемлемо. Разница между подходами становится очевидной, когда данные исчезают, а до этого случая я добрался слишком поздно. Если в следующий раз мне предстоит сделать что-то подобное, я планирую сначала проверить удаление. Я также кое-что узнал о выборе технологий. Если бы я с самого начала знал, что именно принципиально невозможно наблюдать с помощью опроса, я мог бы принять решение ещё до попытки подключить Logstash.
Tim