
1. 検索をElasticsearchへ移行することになった背景
私が参加したプロジェクトは、旅行先とその場所に紐づくコンテンツを複数の言語で提供するプラットフォームでした。ユーザーが地域名や場所名を入力すると、関連する場所とコンテンツを検索することがサービスの中心機能だったため、検索品質がそのままサービス品質につながる構造でした。
データ構造には一つの特徴がありました。場所情報が、言語に依存しない部分と、言語によって異なる部分に分かれていたことです。座標や表示の有無のように翻訳が不要な値は場所テーブルに保存され、場所名や住所、概要のように翻訳が必要な値は、多言語テーブルに言語ごとに1行ずつ保存されていました。コンテンツも同じ方式で、言語コードを併せて保持していました。
正規化の観点では自然な設計です。しかし検索の観点から見ると、結果を1件作るために少なくとも2つ以上のテーブルを参照する必要があるということでもあります。さらにカテゴリーやタグの条件まで加わると、参照するテーブルはますます増えます。
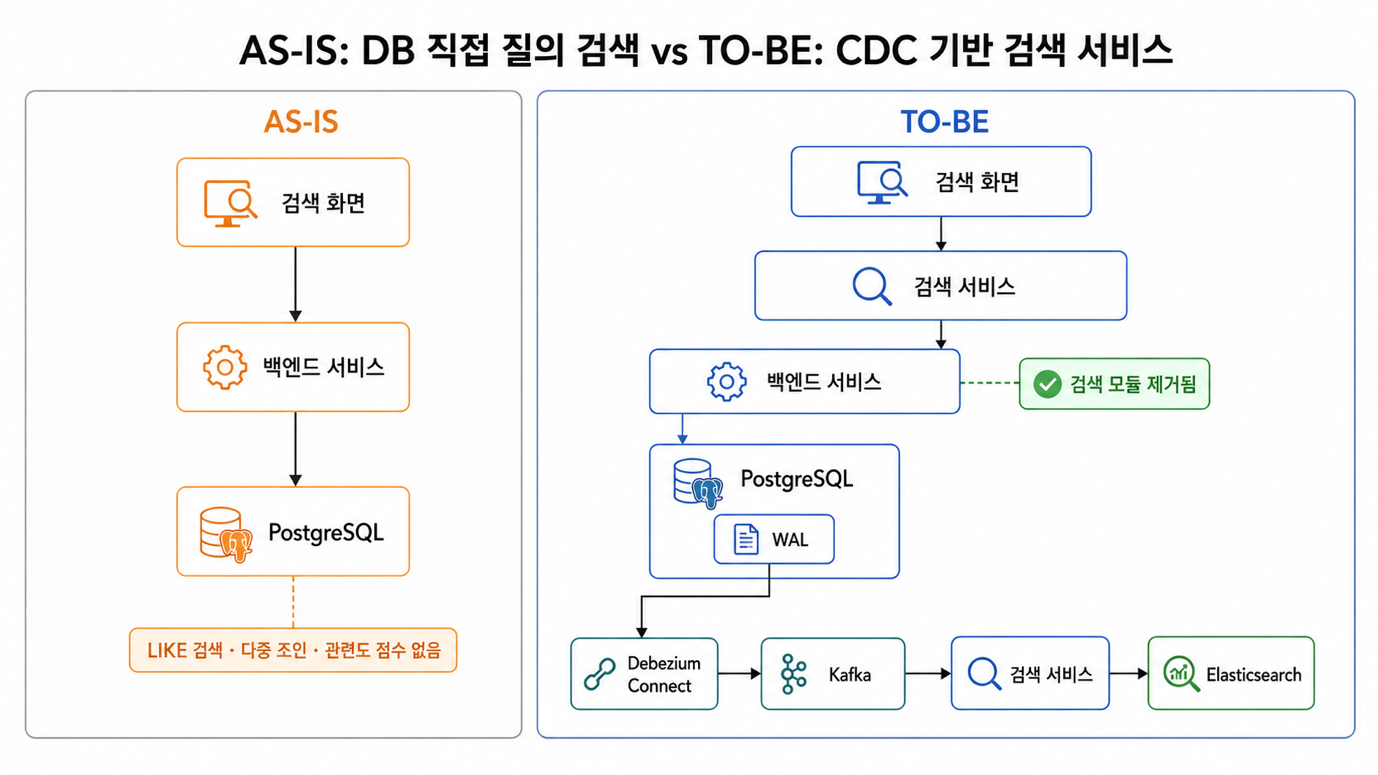
私が参加した時点で、検索画面はすでに作られていました。検索ロジックはバックエンドサービスがPostgreSQLに直接クエリを発行する方式で、私に与えられた課題はこの部分をElasticsearchベースに変更することでした。担当範囲と期間はそれほど大きくありませんでした。
検索エンジンを別に置くという決定には、必ず一つの問いが伴います。PostgreSQLにある原本をどの経路でElasticsearchに投入し、その後の変更をどのように追跡するのかという問いです。この記事では、その経路をLogstashで始め、DebeziumベースのCDC(Change Data Capture、変更データキャプチャ)へ切り替えるまでの記録を紹介します。
2. 既存の検索方式とその限界
従来の検索は、画面から渡された条件をSQLのWHERE句に変換し、複数のテーブルを結合して検索する形式でした。構造を簡単に置き換えると、次のようなものでした。
SELECT ...
  FROM place p
  JOIN place_lang pl ON p.id = pl.place_id
 WHERE pl.lang_code = :langCode
   AND pl.place_name LIKE '%' || :keyword || '%'
 ORDER BY pl.registered_on DESC
 LIMIT :limit OFFSET :offset
動作そのものには問題ありませんでした。問題は、検索を本格的な検索らしいものにしようとしたときに生じました。
2.1 韓国語検索の品質を高める手段がありません
LIKE検索は、文字列がそのまま含まれているかどうかだけを確認します。単語の形や意味は考慮しないため、「済州島 ペンション」で検索しても「済州 ペンション」はヒットしません。助詞が付いたり、スペースの入り方が異なったりすると、そのまま検索結果に表示されなくなります。
複数の単語を入力したときに、一部だけ一致する結果をどう扱うかを決めるのも困難でした。ANDで結ぶと結果がほとんどなくなり、ORで結ぶと関連のないものまで大量に表示されます。その中間を調整する適切な方法がありませんでした。前後にワイルドカードを付けたLIKEパターンはインデックスを利用できないことも、常に気になっていました。
多言語サービスであることが、この問題をさらに大きくしました。言語ごとに必要な処理は異なりますが、LIKEはどの言語でも同じように文字列が含まれているかどうかだけを確認します。
2.2 条件が増えるほどクエリが重くなります
場所を一つの結果として返すには、場所テーブルと多言語テーブルを結合する必要があり、カテゴリー条件が付くと結合がさらに2つ増えました。コンテンツ検索も似たような状況でした。
ここにページングが重なると負荷はさらに大きくなります。リストと一緒に総件数も返す必要がありましたが、そのためには同じ結合をカウント用にもう一度実行しなければなりません。OFFSET方式では後ろのページになるほど、読み込んで破棄する行が増えます。検索条件を一つ追加することが、そのままデータベースの負荷を増やすことになる構造でした。
2.3 関連度によるソートができません
最ももどかしかった部分です。WHERE句は条件に一致するかどうかを判断するだけで、どの程度よく一致するかをスコアとして返してはくれません。そのためソート基準は登録日の降順に固定されており、検索語に最も関連する場所を上位に表示するという要件を表現する方法がありませんでした。
周辺の場所を検索する機能も同じ限界を抱えていました。緯度と経度の範囲で絞り込む方式だったため、実際には円ではなく四角形の領域を検索しており、近い順に並べることもできませんでした。オートコンプリートや誤字補正、同義語処理も同様に、すべて自前で作る必要がありました。
このあたりで、検索専用のストレージを別に用意したほうがよいという判断に至りました。しかしストレージをもう一つ増やした瞬間、次の問題が生じます。原本はPostgreSQLにあり、検索はElasticsearchで行うため、両方のストレージを継続的に同期しなければなりません。
最も単純な方法は、バックエンドサービスがデータを保存した直後に、インデックスAPIも同時に呼び出すことです。この方法は最初から候補から外しました。一つのリクエストが異なる2つのストレージに書き込むことになりますが、データベースのトランザクションはElasticsearchまで保護してくれません。また、どちらか一方だけが失敗した場合に、状態がずれたことを検知する方法もないためです。検索を追加するために、既存サービスのコードのあちこちへインデックス呼び出しを埋め込まなければならない点も好ましくありませんでした。そこで同期はアプリケーションの外側で処理する方針にしました。
3. 最初の選択はLogstashでした
アプリケーションの外側でPostgreSQLのデータをElasticsearchへ移す方法を探し、最初に選んだのはLogstashでした。
理由は単純でした。Elastic陣営のコンポーネントなのでElasticsearchと接続しやすく、JDBC inputプラグインにSQLを一式記述しておけば、検索結果をそのままインデックスに投入できます。結合クエリをそのまま使えるため、複数のテーブルを結合したドキュメントを作るのにも便利でした。何より、メッセージブローカーのようなコンポーネントを新たに導入する必要がなく、導入負担が最も小さかったのです。
検索対象となる2種類のデータを、それぞれ同じ名前のインデックスへ送るようにinputを2つ構成しました。変更をどのように検知するかについての答えは、更新日時のカラムでした。最後に読み取った時刻をLogstashに記憶させ、それより後に更新された行だけを再度検索する方式です。ポーリング間隔は1分に設定しました。
jdbc {
  schedule  => "* * * * *"
  statement => "SELECT ... FROM content
                 WHERE modified_on > :sql_last_value ORDER BY modified_on ASC"
  use_column_value => true
  tracking_column  => "modified_on"
}
インデックスドキュメントのIDを原本の主キーに合わせていたため、同じ行が複数回検索されても上書きされ、重複が蓄積することはありませんでした。最初に全データを投入することも、その後の変更内容を検索へ反映することも、ここまでで十分に見えました。
実際、登録と更新だけを確認している間は何も問題ありませんでした。問題はその次にありました。
4. 削除が反映されない問題とDebeziumへの移行
4.1 削除したデータが検索に残り続ける
テストデータを整理している途中で、奇妙なことに気づきました。PostgreSQLで削除した場所が、検索結果にはそのまま残っていたのです。最初は自分の設定ミスだと思いました。インデックス作成が遅れているのだとも考えました。ポーリング間隔が1分なので、少し待てば消えるだろうと思ったのです。しかし、かなり時間が経ってから再度確認しても、やはり残ったままでした。設定を何度か見直してようやく、これは設定ミスではなく、方式そのものの限界だと分かりました。
4.2 ポーリングでは残っている行しか確認できません
JDBC inputプラグインは、定期的にSELECTを実行し、その結果をElasticsearchへ送ります。ここで重要なのは、この方式で確認できるのは現在検索できる行だけだという点です。
更新日時が特定の値より大きい行を求めるという質問は、そもそもテーブルに残っている行の中から選ぶ質問です。行が削除されると検索結果から静かに消えるだけで、削除されたという事実そのものはどこにも現れません。Logstashから見ると、最初から存在しなかったデータと、たった今削除されたデータを区別する根拠がないのです。
登録と更新がうまく反映されていたのも、同じ理由でした。登録と更新は、結果的に行が残る変更なので検索に引っかかりますが、削除だけは唯一、痕跡を残しません。そのため検証時に登録と更新だけを確認すると、問題を見落としやすくなります。私がそうでした。
残されたドキュメントは、検索サービス上の単純な不一致では終わりません。リストには表示されるのに、クリックすると存在しない詳細画面へ移動するため、ユーザーから見るとエラーに見えます。
4.3 回避策を先に検討しました
まずはLogstashを維持したまま解決する方法がないかを調べました。2つ思いつきました。
1つ目は、実際に削除する代わりに、削除済みであることを示す値を更新する方法です。削除が更新として扱われるためポーリングでも検知でき、検索クエリで除外できます。ただし、この方法を取るには原本テーブルにカラムを追加し、既存サービスの削除ロジックをすべて修正する必要があります。
2つ目は、定期的に両方のID一覧を照合し、原本に存在しないドキュメントを削除する方法です。構造に手を入れなくても済みますが、データが増えるほど照合コストが大きくなり、照合間隔の分だけ誤ったドキュメントが残り続けます。
どちらの方法も、検索を便利にするために原本側を変更するか、後からクリーンアップするという方向でした。 アプリケーションの外側で同期するために選んだ方式なのに、結局スキーマやサービスコードに手を入れることになるのであれば、最初にこの方式を選んだ理由が崩れてしまいます。必要だったのは回避策ではなく、削除を削除として知らせる経路でした。
4.4 そこでDebeziumに切り替えました
Debeziumはデータベースのトランザクションログを直接購読します。PostgreSQLでは、論理レプリケーション(logical replication)を通じてWAL(Write-Ahead Log)を読み取ります。
ここが決定的な違いです。テーブルを検索すると削除された行は見えませんが、トランザクションログには何がいつ削除されたのかが記録として残ります。検索結果ではなく変更履歴を読み取るため、INSERTとUPDATEはもちろん、DELETEも一つのイベントとして伝達されます。
削除イベントは次のような形式で到着します。opフィールドがdで、beforeには削除直前の値が格納されているため、何が消えたのかを明確に把握できます。
{
  "op": "d",
  "before": { "id": "...", "lang_code": "ko", ... },
  "after": null
}
削除を解決できることが最も大きな点でしたが、移行後に得られたメリットもありました。更新日時カラムが正しく更新されているかどうかに、もはや依存する必要がなくなりました。どの経路でデータが変更されても、ログには残るためです。最初に全データを投入する作業もコネクターのスナップショット機能が代わりに行ってくれるため、別途クエリを作成する必要がありませんでした。
|
区分 |
Logstash JDBC input |
Debezium CDC |
|---|---|---|
|
参照対象 |
現在照会される行 |
トランザクションログの変更記録 |
|
変更検知 |
1分間隔のSELECTポーリング |
WALサブスクリプション |
|
削除検知 |
不可。結果から消えるだけ |
削除イベントとして伝達 |
|
追跡基準 |
更新時刻カラム |
LSN(ログシーケンス番号) |
|
元のスキーマ変更 |
削除フラグ導入時に必要 |
不要 |
|
初期ロード |
別途照会クエリ |
スナップショット機能内蔵 |
|
追加コンポーネント |
なし |
Kafka、Kafka Connect |
|
運用負担 |
低い |
レプリケーションスロットとコネクターの管理が必要 |
もちろん代償もあります。KafkaとKafka Connectという運用対象が増え、レプリケーションスロットというデータベースリソースを管理する必要があります。それでも移行を決めたのは、削除漏れが迂回策で解決できる問題ではなかったからです。構成が単純でも、誤った結果を返す検索は使えません。
5. CDCパイプラインの構成
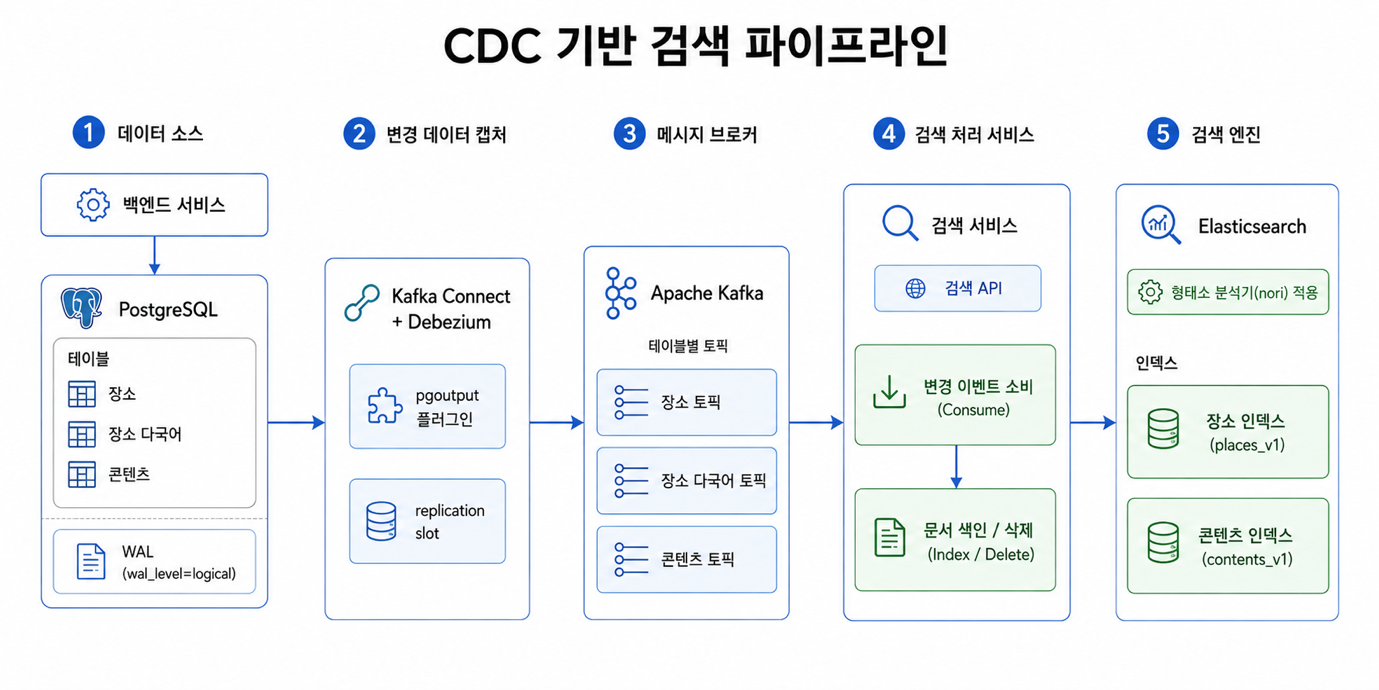
移行後の構成は、DebeziumがPostgreSQLの変更をKafkaトピックへ流し、別途分離した検索サービスがそれを消費してElasticsearchにインデックスする形です。
5.1 PostgreSQLの論理レプリケーションの準備
DebeziumがWALを読み取るには、データベースで論理レプリケーションを許可する必要があります。wal_levelをlogicalに引き上げ、レプリケーションスロットとWAL送信プロセス数を確保しました。再起動が必要な項目だったため、反映時期については別途協議しました。
# postgresql.conf
wal_level = logical
max_replication_slots = 10
max_wal_senders = 10
もう一つ確認しておく必要があったのがREPLICA IDENTITYです。デフォルト値ではUPDATEとDELETEイベントに主キーだけが含まれるため、削除直前の値も受け取るにはFULLに引き上げる必要があります。ただしFULLにするとWALの記録量が増えるため、以前の値が実際に必要なテーブルにのみ適用しました。
5.2 Debeziumコネクターの構成
Kafka ConnectはDebeziumイメージをそのまま使用して構築しました。コネクター設定とオフセット、状態がKafkaトピックに保存されるため、コンテナが再起動してもどこまで処理したかを失いません。コネクターはREST APIで登録し、論理デコーディングプラグインにはPostgreSQLに内蔵されたpgoutputを使用しました。別途プラグインをインストールする必要がないため、環境構成がシンプルになります。
{
  "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
  "plugin.name": "pgoutput",
  "topic.prefix": "...",
  "slot.name": "...",
  "table.include.list": "public.place,public.place_lang,public.content",
  "snapshot.mode": "initial",
  "tombstones.on.delete": "false"
}
検索に必要なテーブルだけをサブスクライブするよう一覧を指定したのは、意図的な選択でした。すべてのテーブルをサブスクライブすると、検索と無関係な変更までパイプラインを通過し、負荷だけが増加します。スナップショットモードをinitialに設定し、既存データの初期ロードまでコネクターが処理するようにしました。Logstashで別途クエリを実行していた作業が、設定一行で整理された形です。
5.3 検索サービスの分離と形態素解析器の適用
検索機能は既存のバックエンドサービスから切り離し、別のマイクロサービスとして構築しました。既存サービスはPostgreSQLへのデータ保存だけを行い、検索サービスがKafkaから入ってくる変更イベントを消費してドキュメントをインデックスし、検索APIを提供します。
分離した理由は、インデックスの再作成やマッピングの変更作業が既存サービスのデプロイと絡まないようにするためでした。大量のインデックス作成による負荷が既存APIの応答に影響してはならないという点もありました。その結果、既存サービスから検索関連モジュールが丸ごと取り除かれ、Elasticsearchを指す設定さえ残らなくなりました。
韓国語検索のために、Elasticsearchに形態素解析プラグインのnoriをインストールしました。標準のアナライザーは空白を基準にトークンを分割するため、韓国語の助詞や複合名詞を適切に扱えません。noriを適用すると「済州島」が「済州」と「島」に分解されてインデックスされるため、これまでヒットしなかった検索語もマッチし始めます。ただし今回は、プラグインを追加して基本動作を確認するところまでにとどめ、品詞フィルターや同義語辞書を調整する作業までは行えませんでした。
5.4 運用で注意すべき点
CDCはデータベース内部のメカニズムを使用するため、運用上の注意事項も伴います。その中でも特に注意すべきなのがレプリケーションスロットです。
レプリケーションスロットは、コンシューマーが読み取り済みであることを確認した地点までしかWALを整理しません。逆に言えば、コネクターが停止している間は、その後のWALが蓄積し続けるということです。Podを停止したまま忘れてしまうとデータベースのディスクを圧迫する可能性があるため、コネクターを停止する作業にはスロットの状態確認も組み込み、使用しないスロットは削除するようにしました。
SELECT slot_name, active,
       pg_size_pretty(
         pg_wal_lsn_diff(pg_current_wal_lsn(), confirmed_flush_lsn)
       ) AS retained_wal
  FROM pg_replication_slots;
6. まとめ
検索経路を変更して変わった点を整理すると、次のとおりです。
|
区分 |
従来の構成 |
適用後 |
|---|---|---|
|
検索の実行 |
PostgreSQLの結合クエリ |
Elasticsearchインデックスの検索 |
|
韓国語処理 |
LIKEによる部分文字列マッチング |
nori形態素解析 |
|
関連度順で並べ替え |
登録日の降順に固定 |
スコアベースの並べ替えが可能 |
|
同期方式 |
Logstashによる1分間隔のポーリング |
Debezium CDC(WALサブスクリプション) |
|
削除の反映 |
検知不可。ドキュメントが残る |
削除イベントで反映 |
|
初期ロード |
別途クエリを実行 |
コネクタのスナップショット |
|
サービス構成 |
バックエンドサービスが検索まで担当 |
検索サービスとして分離 |
7. おわりに
今回の作業で長く心に残ったのは、Debeziumというツール自体ではなく、最初に選んだ方式がなぜうまくいかないのかを確認していく過程でした。Logstashは構成がシンプルで、初期ロードも問題なく完了したため、表面的には問題がないように見えました。削除という一つのケースを確認していなければ、そのまま見過ごしていたでしょう。
振り返ってみると、登録と更新を中心に検証していたことが問題でした。この二つは、結果的にデータが残る変更なので、どの方式で同期してもおおむね正常に動作します。実際に方式の違いが明らかになるのは、データが消える場合です。その確認が遅れてしまいました。次に同じようなことをするなら、まず削除から確認するつもりです。技術選定についても一つ学びがありました。ポーリング方式では根本的に何を検知できないのかを最初から知っていれば、Logstashを導入する前に判断できていたはずです。
Tim