
1. 검색을 Elasticsearch로 옮기게 된 배경
제가 참여한 프로젝트는 여행 장소와 그 장소에 딸린 콘텐츠를 여러 언어로 제공하는 플랫폼이었습니다. 사용자가 지역이나 장소 이름을 입력하면 관련 장소와 콘텐츠를 찾아 주는 것이 서비스의 중심 기능이었으므로, 검색의 품질이 곧 서비스의 품질이라고 볼 수 있는 구조였습니다.
데이터 구조에는 한 가지 특징이 있었습니다. 장소 정보가 언어와 무관한 부분과 언어에 따라 달라지는 부분으로 나뉘어 있었다는 점입니다. 좌표나 노출 여부처럼 번역이 필요 없는 값은 장소 테이블에 있고, 장소명이나 주소, 개요처럼 번역이 필요한 값은 다국어 테이블에 언어별로 한 행씩 저장되어 있었습니다. 콘텐츠도 같은 방식으로 언어 코드를 함께 갖고 있었습니다.
정규화 관점에서는 자연스러운 설계입니다. 그런데 검색 입장에서 보면 결과 한 건을 만들기 위해 최소 두 개 이상의 테이블을 봐야 한다는 뜻이기도 합니다. 여기에 카테고리나 태그 조건까지 붙으면 봐야 할 테이블은 더 늘어납니다.
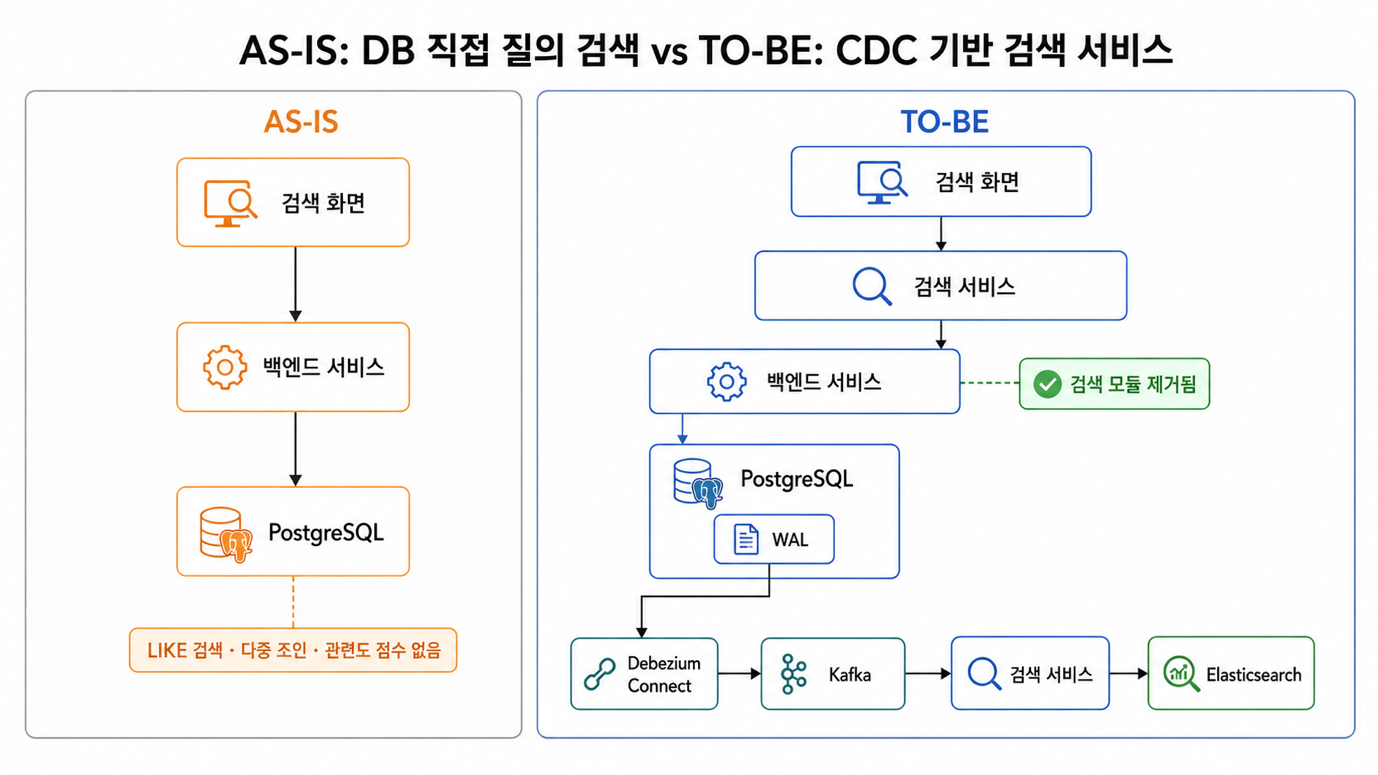
제가 투입되었을 때 검색 화면은 이미 만들어져 있었습니다. 검색 로직은 백엔드 서비스가 PostgreSQL에 직접 질의하는 방식이었고, 제게 주어진 과제는 이 부분을 Elasticsearch 기반으로 바꾸는 것이었습니다. 담당 범위와 기간은 그렇게 길지 않았습니다.
검색 엔진을 따로 둔다는 결정에는 반드시 따라오는 질문이 하나 있습니다. PostgreSQL에 있는 원본을 어떤 경로로 Elasticsearch에 채워 넣고, 이후 변경을 어떻게 따라가게 할 것인가입니다. 이 글은 그 경로를 Logstash로 시작했다가 Debezium 기반 CDC(Change Data Capture, 변경 데이터 캡처)로 바꾸기까지의 기록입니다.
2. 기존 검색 방식과 그 한계
기존 검색은 화면에서 넘어온 조건을 SQL 조건절로 옮겨 여러 테이블을 조인해 조회하는 형태였습니다. 구조를 간단히 옮겨 보면 다음과 비슷했습니다.
SELECT ...
  FROM place p
  JOIN place_lang pl ON p.id = pl.place_id
 WHERE pl.lang_code = :langCode
   AND pl.place_name LIKE '%' || :keyword || '%'
 ORDER BY pl.registered_on DESC
 LIMIT :limit OFFSET :offset
동작 자체에는 문제가 없었습니다. 문제는 검색을 검색답게 만들려고 할 때 생겼습니다.
2.1 한국어 검색 품질을 끌어올릴 수단이 없습니다
LIKE 검색은 문자열이 그대로 들어 있는지만 확인합니다. 단어의 형태나 의미는 보지 않기 때문에 "제주도 펜션"으로 검색하면 "제주 펜션"이 걸리지 않습니다. 조사가 붙거나 띄어쓰기가 달라지면 그대로 미검색이 됩니다.
여러 단어를 입력했을 때 일부만 맞는 결과를 어떻게 다룰지도 정하기 어려웠습니다. AND로 묶으면 결과가 거의 없고, OR로 묶으면 관련 없는 것까지 쏟아집니다. 그 사이를 조절할 방법이 마땅치 않았습니다. 앞뒤로 와일드카드가 붙은 LIKE 패턴은 인덱스를 타지 못한다는 점도 계속 마음에 걸렸습니다.
다국어 서비스라는 점이 이 문제를 한 번 더 키웠습니다. 언어마다 필요한 처리가 다른데, LIKE는 어떤 언어든 똑같이 문자열 포함 여부만 볼 뿐입니다.
2.2 조건이 늘어날수록 쿼리가 무거워집니다
장소 하나를 결과로 만들려면 장소 테이블과 다국어 테이블을 조인해야 했고, 카테고리 조건이 붙으면 조인이 두 개 더 늘었습니다. 콘텐츠 검색도 사정이 비슷했습니다.
여기에 페이징이 겹치면 부담이 더 커집니다. 목록과 함께 총 건수를 내려 주어야 했는데, 그러려면 같은 조인을 카운트용으로 한 번 더 수행해야 합니다. OFFSET 방식은 뒤쪽 페이지로 갈수록 읽고 버리는 행이 늘어납니다. 검색 조건을 하나 추가하는 일이 곧 데이터베이스 부하를 늘리는 일이 되는 구조였습니다.
2.3 관련도 정렬이 불가능합니다
가장 답답했던 부분입니다. WHERE 절은 조건에 맞는지 아닌지만 판단할 뿐, 얼마나 잘 맞는지를 점수로 돌려주지 않습니다. 그래서 정렬 기준은 등록일 내림차순으로 고정되어 있었고, 검색어와 가장 관련 있는 장소를 위로 올린다는 요구는 표현할 방법이 없었습니다.
주변 장소를 찾는 기능도 같은 한계를 안고 있었습니다. 위도와 경도의 범위로 걸러내는 방식이라 실제로는 원이 아니라 사각형 영역을 조회하는 것이었고, 가까운 순서로 정렬할 수도 없었습니다. 자동완성이나 오타 보정, 동의어 처리도 마찬가지로 전부 직접 만들어야 했습니다.
이쯤에서 검색 전용 저장소를 따로 두는 편이 낫다는 판단에 도달했습니다. 그런데 저장소를 하나 더 두는 순간 곧바로 다음 문제가 생깁니다. 원본은 PostgreSQL에 있고 검색은 Elasticsearch에서 이루어지므로, 두 저장소를 계속 맞춰 주어야 합니다.
가장 단순한 방법은 백엔드 서비스가 데이터를 저장한 직후에 색인 API를 함께 호출하는 것입니다. 이 방법은 처음부터 후보에서 뺐습니다. 하나의 요청이 서로 다른 두 저장소에 쓰기를 하게 되는데 데이터베이스 트랜잭션은 Elasticsearch까지 보호해 주지 않고, 둘 중 하나만 실패하면 어긋난 상태를 알아챌 방법도 없기 때문입니다. 검색을 붙이자고 기존 서비스 코드 곳곳에 색인 호출을 심어야 한다는 점도 마음에 들지 않았습니다. 그래서 동기화는 애플리케이션 바깥에서 처리하기로 방향을 잡았습니다
3. 첫 번째 선택은 Logstash였습니다
애플리케이션 바깥에서 PostgreSQL의 데이터를 Elasticsearch로 옮기는 방법을 찾다가 처음 고른 것은 Logstash였습니다.
이유는 단순했습니다. Elastic 진영의 구성 요소라 Elasticsearch와 붙이기 쉽고, JDBC input 플러그인에 SQL 한 벌만 적어 두면 조회 결과가 그대로 인덱스로 들어갑니다. 조인 쿼리를 그대로 쓸 수 있으니 여러 테이블을 합친 문서를 만들기에도 편했습니다. 무엇보다 메시지 브로커 같은 구성 요소를 새로 올리지 않아도 되니 도입 부담이 가장 적었습니다.
검색 대상이 되는 두 종류의 데이터를 각각 같은 이름의 인덱스로 보내도록 input을 두 벌 구성했습니다. 변경을 어떻게 알아낼 것인가에 대한 답은 수정 시각 컬럼이었습니다. 마지막으로 읽은 시각을 Logstash가 기억해 두고, 그보다 나중에 수정된 행만 다시 조회하는 방식입니다. 폴링 주기는 1분으로 두었습니다.
jdbc {
  schedule  => "* * * * *"
  statement => "SELECT ... FROM content
                 WHERE modified_on > :sql_last_value ORDER BY modified_on ASC"
  use_column_value => true
  tracking_column  => "modified_on"
}
색인 문서의 ID를 원본의 기본키로 맞춰 두었기 때문에, 같은 행이 여러 번 조회되어도 덮어쓰기가 되어 중복이 쌓이지는 않았습니다. 처음 전체 데이터를 채워 넣는 것도, 이후 수정된 내용이 검색에 반영되는 것도 여기까지로 충분해 보였습니다.
실제로 등록과 수정만 확인하는 동안에는 아무 문제가 없었습니다. 문제는 그 다음이었습니다.
4. 삭제가 반영되지 않는 문제와 Debezium으로의 전환
4.1 지운 데이터가 검색에 계속 남았습니다
테스트 데이터를 정리하다가 이상한 것을 발견했습니다. PostgreSQL에서 지운 장소가 검색 목록에는 그대로 남아 있었습니다. 처음엔 제 설정 실수인 줄 알았습니다. 색인이 늦어지는 것이라고도 생각했습니다. 폴링 주기가 1분이니 조금 기다리면 사라질 것이라고 본 것입니다. 그런데 한참 뒤에 다시 확인해도 그대로였습니다. 설정을 몇 번 더 들여다보고 나서야, 이것이 설정 실수가 아니라 방식 자체의 한계라는 것을 알았습니다.
4.2 폴링은 남아 있는 행만 볼 수 있습니다
JDBC input 플러그인은 주기적으로 SELECT를 실행해 그 결과를 Elasticsearch로 보냅니다. 여기서 중요한 것은 이 방식이 볼 수 있는 것은 지금 조회되는 행뿐이라는 점입니다.
수정 시각이 특정 값보다 큰 행을 달라는 질문은, 애초에 테이블에 남아 있는 것들 중에서 고르는 질문입니다. 행이 삭제되면 조회 결과에서 조용히 빠질 뿐이고, 삭제되었다는 사실 자체는 어디에도 나타나지 않습니다. Logstash 입장에서는 처음부터 없었던 데이터와 방금 지워진 데이터를 구분할 근거가 없는 것입니다.
등록과 수정이 잘 반영되었던 것도 같은 이유에서였습니다. 등록과 수정은 결과적으로 행이 남아 있는 변경이라 조회에 걸리지만, 삭제만 유일하게 흔적을 남기지 않습니다. 그래서 검증할 때 등록과 수정만 확인하면 문제를 놓치기 쉽습니다. 제가 그랬습니다.
남겨진 문서는 검색 서비스에서 단순한 불일치로 끝나지 않습니다. 목록에는 나오는데 눌러 보면 존재하지 않는 상세 화면으로 이동하기 때문에, 사용자 입장에서는 오류로 보입니다.
4.3 우회 방법을 먼저 검토했습니다
Logstash를 유지하면서 해결할 방법이 없는지부터 찾아봤습니다. 두 가지가 떠올랐습니다.
첫 번째는 실제 삭제 대신 삭제 여부를 나타내는 값을 갱신하도록 바꾸는 방법입니다. 삭제가 수정이 되므로 폴링으로도 잡히고, 검색 쿼리에서 걸러 내면 됩니다. 다만 이렇게 하려면 원본 테이블에 컬럼을 추가하고 기존 서비스의 삭제 로직을 전부 손봐야 합니다.
두 번째는 주기적으로 양쪽의 ID 목록을 대조해 원본에 없는 문서를 지우는 방법입니다. 구조를 건드리지 않아도 되지만 데이터가 늘수록 대조 비용이 커지고, 대조 주기만큼은 잘못된 문서가 살아 있게 됩니다.
두 방법 모두 검색이 편하자고 원본 쪽을 바꾸거나 뒤늦게 청소하는 방향이었습니다. 애플리케이션 바깥에서 동기화하려고 고른 방식인데 결국 스키마와 서비스 코드를 건드리게 된다면, 처음에 이 방식을 고른 이유가 무너집니다. 필요한 것은 우회가 아니라 삭제를 삭제로 알려 주는 경로였습니다.
4.4 그래서 Debezium으로 바꿨습니다
Debezium은 데이터베이스의 트랜잭션 로그를 직접 구독합니다. PostgreSQL에서는 논리적 복제(logical replication)를 통해 WAL(Write-Ahead Log)을 읽습니다.
여기가 결정적인 차이입니다. 테이블을 조회하면 삭제된 행은 보이지 않지만, 트랜잭션 로그에는 무엇이 언제 지워졌는지가 기록으로 남습니다. 조회 결과가 아니라 변경 기록을 읽기 때문에 INSERT와 UPDATE는 물론 DELETE도 하나의 이벤트로 전달됩니다.
삭제 이벤트는 다음과 같은 형태로 도착합니다. op 필드가 d이고 before에 지워지기 직전의 값이 담겨 오므로, 무엇이 사라졌는지 명확히 알 수 있습니다.
{
  "op": "d",
  "before": { "id": "...", "lang_code": "ko", ... },
  "after": null
}
삭제가 해결된다는 점이 가장 컸지만, 옮기고 나서 따라온 이점도 있었습니다. 수정 시각 컬럼이 제대로 갱신되었는지에 더 이상 의존하지 않아도 되었습니다. 어떤 경로로 데이터가 바뀌든 로그에는 남기 때문입니다. 처음 전체 데이터를 채워 넣는 작업도 커넥터의 스냅샷 기능이 대신해 주어 별도 쿼리를 만들 필요가 없었습니다.
|
구분 |
Logstash JDBC input |
Debezium CDC |
|---|---|---|
|
보는 대상 |
지금 조회되는 행 |
트랜잭션 로그의 변경 기록 |
|
변경 감지 |
1분 주기 SELECT 폴링 |
WAL 구독 |
|
삭제 감지 |
불가. 결과에서 사라질 뿐 |
삭제 이벤트로 전달 |
|
추적 기준 |
수정 시각 컬럼 |
LSN(로그 시퀀스 번호) |
|
원본 스키마 변경 |
삭제 플래그 도입 시 필요 |
불필요 |
|
초기 적재 |
별도 조회 쿼리 |
스냅샷 기능 내장 |
|
추가 구성 요소 |
없음 |
Kafka, Kafka Connect |
|
운영 부담 |
낮음 |
복제 슬롯과 커넥터 관리 필요 |
물론 대가도 있습니다. Kafka와 Kafka Connect라는 운영 대상이 늘어나고, 복제 슬롯이라는 데이터베이스 자원을 관리해야 합니다. 그럼에도 옮기기로 한 것은 삭제 누락이 우회로 덮을 수 있는 문제가 아니었기 때문입니다. 구성이 단순해도 틀린 결과를 내려 주는 검색은 쓸 수 없습니다.
5. CDC 파이프라인 구성
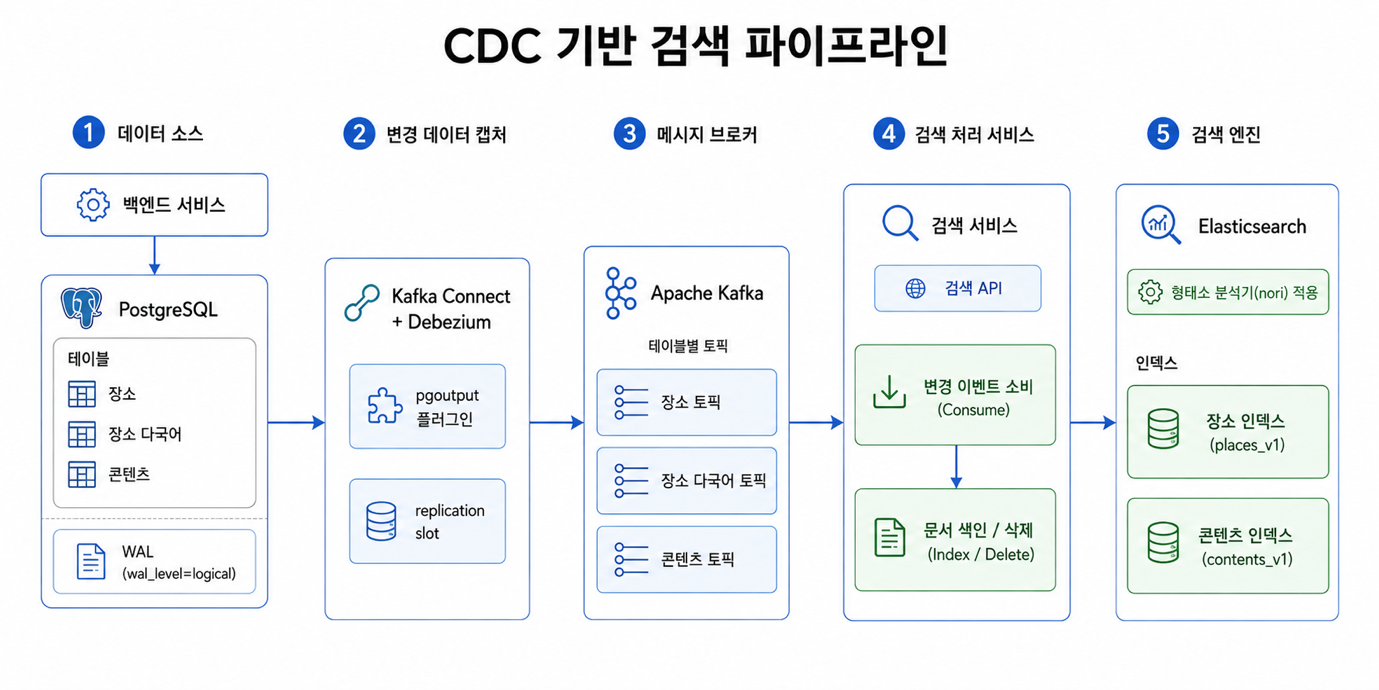
전환 이후의 구성은 Debezium이 PostgreSQL의 변경을 Kafka 토픽으로 흘려보내고, 별도로 분리한 검색 서비스가 이를 소비해 Elasticsearch에 색인하는 형태입니다.
5.1 PostgreSQL 논리적 복제 준비
Debezium이 WAL을 읽으려면 데이터베이스가 논리적 복제를 허용해야 합니다. wal_level을 logical로 올리고 복제 슬롯과 WAL 송신 프로세스 수를 확보했습니다. 재기동이 필요한 항목이라 반영 시점은 따로 협의했습니다.
# postgresql.conf
wal_level = logical
max_replication_slots = 10
max_wal_senders = 10
또 하나 챙겨야 했던 것이 REPLICA IDENTITY입니다. 기본값에서는 UPDATE와 DELETE 이벤트에 기본키만 담기기 때문에, 지워지기 직전의 값을 함께 받으려면 FULL로 올려야 합니다. 다만 FULL은 WAL 기록량을 늘리므로 이전 값이 실제로 필요한 테이블에만 적용했습니다.
5.2 Debezium 커넥터 구성
Kafka Connect는 Debezium 이미지를 그대로 사용해 올렸습니다. 커넥터 설정과 오프셋, 상태가 Kafka 토픽에 저장되기 때문에 컨테이너가 재시작되어도 어디까지 처리했는지를 잃지 않습니다. 커넥터는 REST API로 등록했고, 논리적 디코딩 플러그인은 PostgreSQL에 내장된 pgoutput을 사용했습니다. 별도 플러그인을 설치하지 않아도 되어 환경 구성이 단순해집니다.
{
  "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
  "plugin.name": "pgoutput",
  "topic.prefix": "...",
  "slot.name": "...",
  "table.include.list": "public.place,public.place_lang,public.content",
  "snapshot.mode": "initial",
  "tombstones.on.delete": "false"
}
검색에 필요한 테이블만 구독하도록 목록을 지정한 것은 의도적인 선택이었습니다. 전체 테이블을 구독하면 검색과 무관한 변경까지 파이프라인을 통과하면서 부하만 늘어납니다. 스냅샷 모드를 initial로 두어 기존 데이터의 초기 적재까지 커넥터가 처리하도록 했습니다. Logstash에서 별도 쿼리로 하던 일이 설정 한 줄로 정리된 셈입니다.
5.3 검색 서비스 분리와 형태소 분석기 적용
검색은 기존 백엔드 서비스에서 떼어내 별도의 마이크로서비스로 만들었습니다. 기존 서비스는 PostgreSQL에 데이터를 저장하는 일만 하고, 검색 서비스가 Kafka로 들어오는 변경 이벤트를 소비해 문서를 색인하고 검색 API를 제공합니다.
분리한 이유는 인덱스를 다시 만들거나 매핑을 바꾸는 작업이 기존 서비스 배포와 얽히지 않게 하기 위해서였습니다. 대량 색인이 만들어 내는 부하가 기존 API 응답에 영향을 주지 않아야 한다는 점도 있었습니다. 결과적으로 기존 서비스에서 검색 관련 모듈이 통째로 빠졌고, Elasticsearch를 가리키는 설정조차 남지 않았습니다.
한국어 검색을 위해서는 Elasticsearch에 형태소 분석 플러그인인 nori를 설치했습니다. 기본 분석기는 공백을 기준으로 토큰을 나누기 때문에 한국어의 조사나 복합명사를 제대로 다루지 못합니다. nori를 적용하면 "제주도"가 "제주"와 "도"로 분해되어 색인되므로, 앞서 걸리지 않던 검색어가 매칭되기 시작합니다. 다만 이번에는 플러그인을 얹어 기본 동작을 확인하는 수준까지만 진행했고, 품사 필터나 동의어 사전을 다듬는 작업까지는 손대지 못했습니다.
5.4 운영에서 조심해야 할 부분
CDC는 데이터베이스 내부 메커니즘을 사용하는 만큼 운영 관점의 주의사항도 따라옵니다. 그중 가장 조심해야 하는 것이 복제 슬롯입니다.
복제 슬롯은 소비자가 어디까지 읽었다고 확인해 준 지점까지만 WAL을 정리합니다. 뒤집어 말하면 커넥터가 멈춰 있는 동안에는 그 뒤의 WAL이 계속 쌓인다는 뜻입니다. 파드를 내려 둔 채 잊어버리면 데이터베이스 디스크를 잠식할 수 있어서, 커넥터를 내리는 작업에는 슬롯 상태 확인을 함께 두었고 쓰지 않는 슬롯은 제거하도록 했습니다.
SELECT slot_name, active,
       pg_size_pretty(
         pg_wal_lsn_diff(pg_current_wal_lsn(), confirmed_flush_lsn)
       ) AS retained_wal
  FROM pg_replication_slots;
6. 정리
검색 경로를 바꾸면서 달라진 점을 정리하면 다음과 같습니다.
|
구분 |
기존 구조 |
적용 후 |
|---|---|---|
|
검색 실행 |
PostgreSQL 조인 쿼리 |
Elasticsearch 인덱스 조회 |
|
한국어 처리 |
LIKE 부분 문자열 매칭 |
nori 형태소 분석 |
|
관련도 정렬 |
등록일 내림차순 고정 |
스코어 기반 정렬 가능 |
|
동기화 방식 |
Logstash 1분 폴링 |
Debezium CDC (WAL 구독) |
|
삭제 반영 |
감지 불가. 문서가 남음 |
삭제 이벤트로 반영 |
|
초기 적재 |
별도 조회 쿼리 |
커넥터 스냅샷 |
|
서비스 구성 |
백엔드 서비스가 검색까지 담당 |
검색 서비스로 분리 |
7. 마치며
이번 작업에서 오래 남은 것은 Debezium이라는 도구 자체가 아니라, 처음 고른 방식이 왜 안 되는지를 확인하는 과정이었습니다. Logstash는 구성이 단순하고 초기 적재도 잘 되었기 때문에 겉으로는 문제가 없어 보였습니다. 삭제라는 한 가지 경우를 확인하지 않았다면 그대로 넘어갔을 것입니다.
돌아보면 검증을 등록과 수정 위주로 했던 것이 문제였습니다. 두 경우는 결과적으로 데이터가 남아 있는 변경이라 어떤 방식으로 동기화해도 대체로 잘 동작합니다. 정작 방식의 차이가 드러나는 것은 데이터가 사라지는 경우인데, 그쪽을 늦게 봤습니다. 다음에 비슷한 일을 한다면 삭제부터 확인할 생각입니다. 기술 선택에 대해서도 하나 배웠습니다. 폴링 방식이 근본적으로 볼 수 없는 것이 무엇인지를 처음부터 알았다면, Logstash를 붙여 보기 전에 판단할 수 있었을 것입니다.
Tim