
Bugungi kunda infratuzilma haqida gap ketganda “IaC (Infrastructure as Code)” atamasi juda tanish. Terraform yordamida bulut resurslarini yaratish, Ansible bilan server konfiguratsiyasini avtomatlashtirish, Kubernetes va GitOps orqali ilovalarni joriy etishni boshqarish endi maxsus texnologiyadan ko‘ra operatsiyalarning asosiy qismiga aylandi.
Biroq operatsion muhitni amalda yaratganingizda, IaC shunchaki “infratuzilmani kod yordamida yaratish” bilan tugamaydi. Aksincha, muhim savollar shundan keyin boshlanadi.
-
Terraform nimaga javobgar bo‘lishi kerak?
-
Ansible nimaga javobgar bo‘lishi kerak?
-
Managed Service taqdim etadigan imkoniyatlar bilan o‘zimiz boshqarishimiz kerak bo‘lgan qismlar o‘rtasidagi chegara qayerda?
-
Operatsiyalar davomida o‘zgarish yuz berganda, mavjud resurslarni xavfsiz saqlab qolgan holda muhitni qanday kengaytirish mumkin?
-
Zaxiralash va tiklash shunchaki “sozlangan” sifatida emas, balki “amalda tiklanishi mumkin” sifatida ham tekshirilganmi?
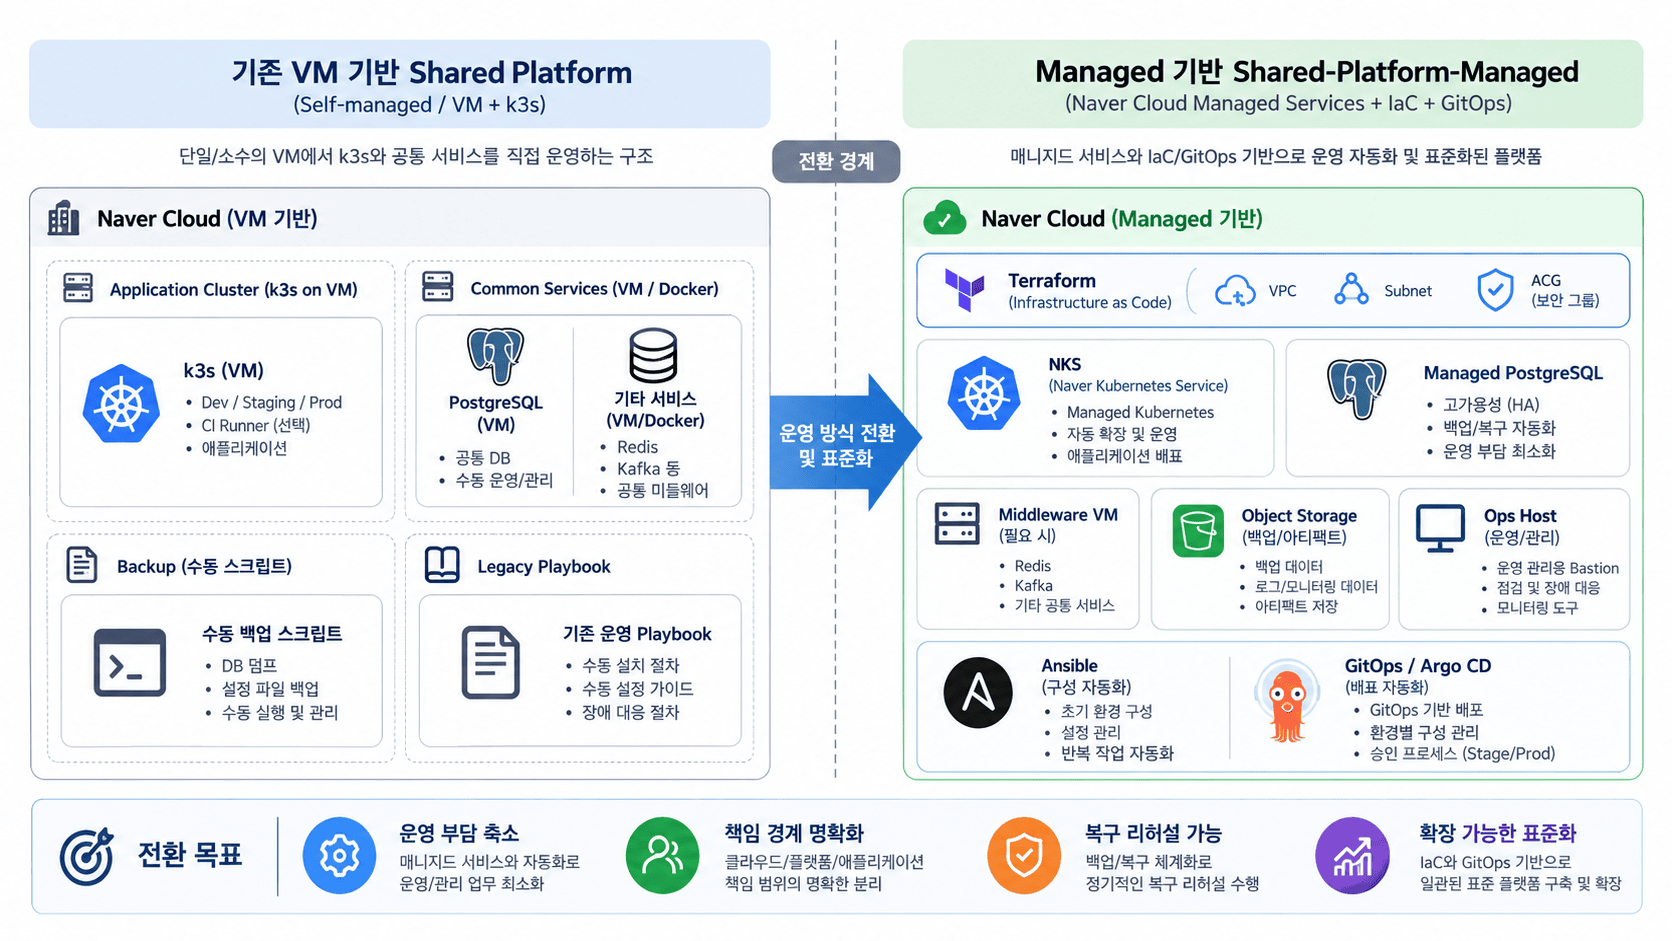
Ushbu maqola Managed Service xizmatlariga asoslangan Naver Cloud muhitida umumiy foydalaniladigan operatsion platformani yaratish bo‘yicha bevosita tajribamiz haqida. Mavjud VM asosidagi arxitekturani bekor qilish o‘rniga, zarur qismlarni saqlab qoldik, Kubernetes va PostgreSQL’ni boshqariladigan xizmatlarga ko‘chirdik hamda Terraform, Ansible va API asosidagi ayrim avtomatlashtirish vositalarini birlashtirib, boshqarish mumkin bo‘lgan tuzilmani yaratdik.
Biz boshidanoq mukammal tuzilma yaratmadik. Aksincha, ish davomida “Bu mas’uliyat bu yerda bo‘lmasligi kerak”, “Bu sozlama juda keng qamrovli” va “Tiklash jarayoni faqat hujjatlarda mavjud, amalda tekshirilmagan” kabi muammolarga qayta-qayta duch keldik. Har safar tuzilmani oz-ozdan takomillashtirdik. Ushbu maqolada sinovlar va xatolarni ham o‘z ichiga olgan holda, hozirgi tuzilma va qarashlarimiz qayd etilgan.
Nega yangi boshqariladigan platformani yaratdik?
Avval Kubernetes va PostgreSQL to‘g‘ridan-to‘g‘ri VM’larda sozlanar va boshqarilardi. Bu yondashuv keng nazorat va tanishlik afzalligini beradi. VM’ga to‘g‘ridan-to‘g‘ri kirib, uning konfiguratsiyasini tekshirishimiz, PostgreSQL superfoydalanuvchisinikiga yaqin imtiyozlar bilan rollar va ma’lumotlar bazalarini boshqarishimiz hamda zarur zaxiralash skriptlarini nisbatan sodda yozishimiz mumkin edi.
Biroq operatsion muhit kengaygani sari to‘g‘ridan-to‘g‘ri boshqarilishi kerak bo‘lgan sohalar tobora katta yuklamaga aylanadi.
-
Kubernetes control plane’ini boshqarish yuklamasi
-
PostgreSQL VM patchlari, nosozliklari, zaxiralash va tiklanishi uchun javobgarlik
-
Node’larni kengaytirish va tarmoq konfiguratsiyasi bo‘yicha qo‘lda qabul qilinadigan qarorlarga tayanish muammosi
-
Operatorlar kirishi, ruxsatlar va audit izlarining murakkabligi
-
Tiklash mashqlarini muntazam o‘tkazishni qiyinlashtiradigan tuzilma
Shu sababli yo‘nalishimizni boshqariladigan xizmatlar markazidagi yondashuv tomon o‘zgartirdik.
-
Kubernetes — Naver Kubernetes Service (NKS)
-
PostgreSQL — Cloud DB for PostgreSQL
-
Umumiy kirish nuqtasi — ops host
-
Redis, Kafka va OpenBao kabi middleware komponentlari dastlab Docker Compose yordamida VM’larda ishlaydi
-
Infratuzilma resurslari Terraform stack yordamida boshqariladi
-
VM’lar ichidagi operatsion konfiguratsiya Ansible playbook yordamida boshqariladi
-
Ilovalarni joriy etish GitOps workflow’idan ajratilgan
Muhim jihat “Hammasini boshqariladigan xizmatlarga o‘tkazamiz” degan fikr emas edi. Aksincha, bizning real maqsadimiz “mas’uliyatni boshqariladigan xizmatlarga qanchalik topshirishimiz va qaysi nuqtadan boshlab o‘zimizning operatsion avtomatlashtirishimiz orqali javobgarlikni olishimizni” aniq ajratish edi.
Avval belgilagan tamoyillarimiz
Jarayon davomida eng ko‘p qayta ko‘rib chiqqan narsamiz vositalarning o‘zi emas, balki javobgarlik chegaralari bo‘ldi. Terraform, Ansible, GitOps va Managed Service’ning barchasi yaxshi vositalar, ammo ularning chegaralari noaniq bo‘lsa, operatsiyalar aslida yanada qiyinlashadi.
Shuning uchun quyidagi tamoyillarni belgiladik.
-
Terraform bulut resurslarining hayotiy sikli uchun javobgar.
-
Ansible VM’lar ichidagi operatsion konfiguratsiya uchun javobgar.
-
GitOps Kubernetes ilovalarini joriy etish uchun javobgar.
-
Managed PostgreSQL ichida ma’lumotlar bazasi, foydalanuvchi, sxema va grant workload bo‘yicha ajratiladi.
-
Zaxiralash konfiguratsiya bilan tugamaydi; u tiklash va tekshirishni ham o‘z ichiga oladi.
-
Kirish ruxsatlari hisoblar bo‘yicha ajratiladi va keng qamrovli siyosatlar minimallashtiriladi.
-
Operatsion o‘zgarishlar uchun avval plan va diff ko‘rib chiqiladi, amaldagi apply esa faqat rejalashtirilgan o‘zgarishlargina qolganida bajariladi.
Bu tamoyillar sodda ko‘rinishi mumkin, ammo amalda ular doimiy ravishda sinovdan o‘tdi. Masalan, Managed PostgreSQL’da DB foydalanuvchilarini Terraform resurslari sifatida yaratish mumkin bo‘lsa-da, operatsiyalar davomida foydalanuvchilar soni oshganida provider butun to‘plamni almashtirish kerakdek o‘zgarishlarni rejalashtiradigan muammoga ega edi. Bunday holatda “hamma ish Terraform orqali bajarilishi kerak” degan tamoyilda turib olish aslida xavfli bo‘lardi.
Oxir-oqibat, ma’lumotlar bazalarining o‘zini Terraform bilan boshqardik, Managed PostgreSQL foydalanuvchilarini rasmiy Naver Cloud API orqali bosqichma-bosqich yaratdik va schema/grant/default privilege boshqaruvini Ansible hamda SQL bootstrap o‘rtasida taqsimladik. Hamma narsani shunchaki IaC bo‘lgani uchun bitta vositaga majburan tiqishtirishdan ko‘ra, holat va tegishli o‘zgarishlar tabiatiga mos vositalarni tanlash muhimroq edi.
Nega Terraform stack’ini ajratdik
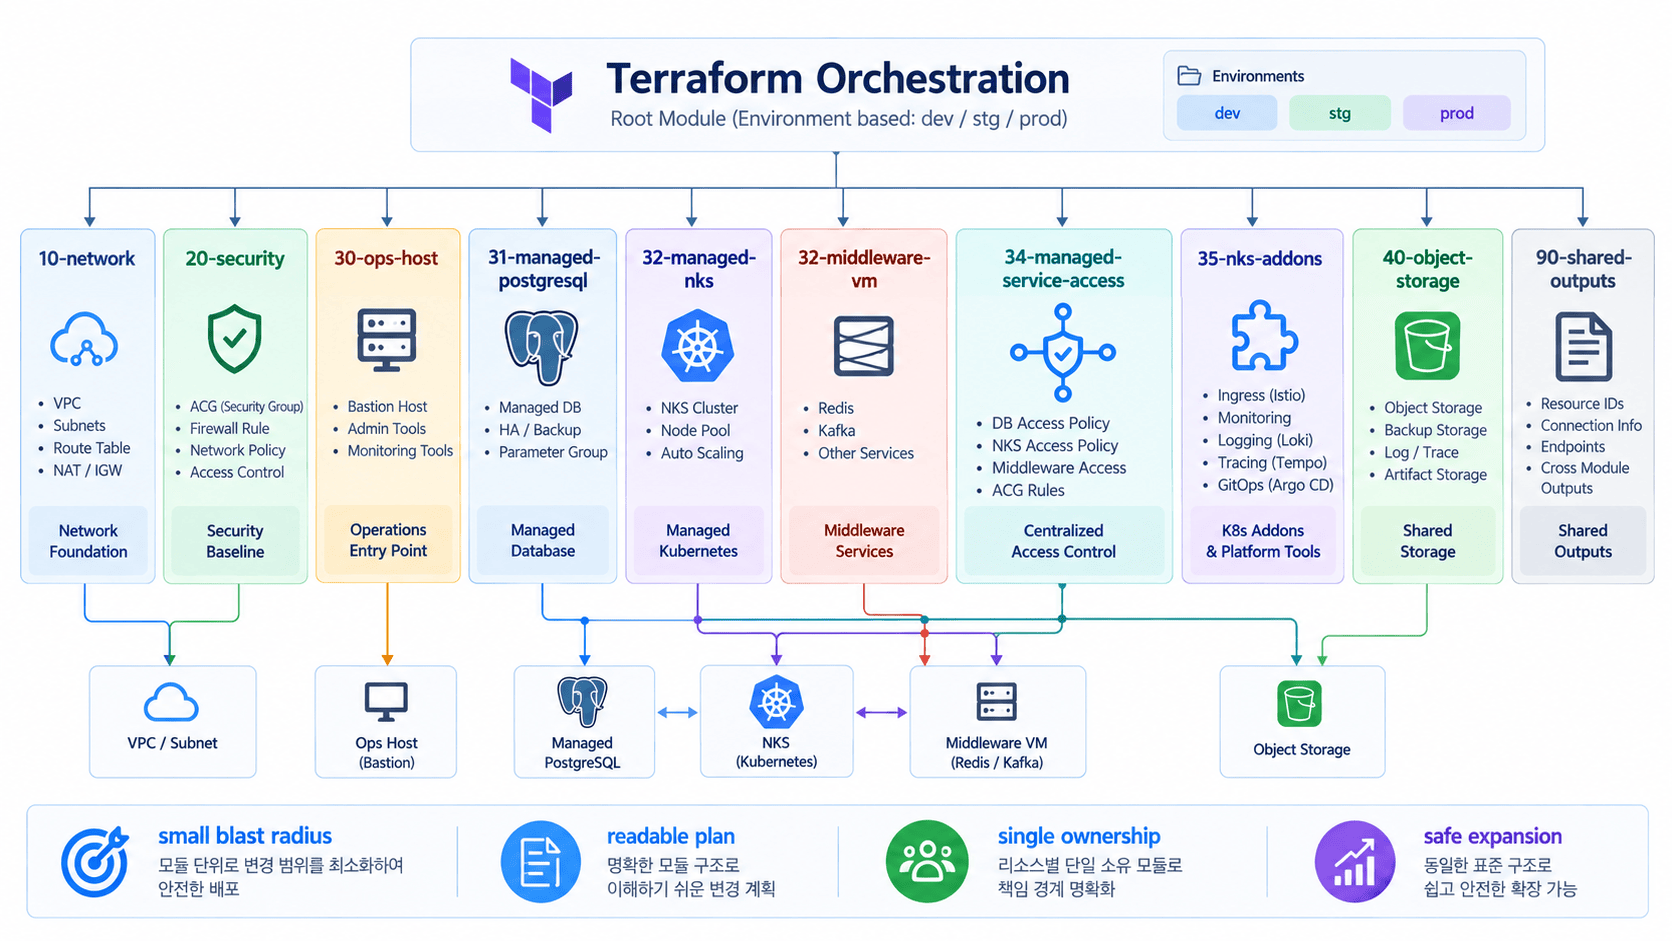
Terraform hamma narsani bitta ulkan root module sifatida boshqarishi mumkin. Biroq operatsion muhitda stack’larni kichikroq birliklarga ajratish xavfsizroq bo‘ldi.
Hozirgi tuzilma taxminan quyidagicha.
shared-platform-managed/
└── terraform/
    ├── 10-network/
    ├── 20-security/
    ├── 30-compute-ops-host/
    ├── 31-managed-postgresql/
    ├── 32-managed-nks/
    ├── 33-compute-middleware-vm/
    ├── 34-managed-service-access/
    ├── 35-nks-addons/
    ├── 40-object-storage/
    └── 90-shared-outputs/
Har bir stack’ning mas’uliyati boshqacha.
-
10-network: VPC, subnet, route, NAT gateway
-
20-security: ACG va asosiy xavfsizlik chegaralari
-
30-compute-ops-host: operatsion kirish nuqtasi vazifasini bajaruvchi ops host
-
31-managed-postgresql: Cloud DB for PostgreSQL instansiyasi
-
32-managed-nks: NKS klasteri va node pool
-
33-compute-middleware-vm: Redis, Kafka, OpenBao va boshqa komponentlar uchun middleware VM
-
34-managed-service-access: NKS, middleware va managed DB o‘rtasidagi kirish qoidalari
-
35-nks-addons: NKS CSI add-on kabi klaster add-on’lari
-
40-object-storage: DB zaxiralari, observability, OpenBao zaxiralari va boshqalar uchun bucketlar
-
90-shared-outputs: boshqa stacklardan olingan chiqishlarni bir joyda ko‘rish imkonini beruvchi umumlashtiruvchi stack
Ularni shu tarzda bo‘lish application tartibini uzaytirishi kabi kamchilikka ega. Biroq ishlash muhitida afzalliklar bu kamchilikdan ustun keldi.
Masalan, node poollar sonini oshirishda tarmoq yoki DB reja ichiga aralashtirilgan bo‘lsa, bu bezovta qiladi. Bitta Object Storage bucketini qo‘shish bilan bir qatorda NKS yoki PostgreSQLdagi o‘zgarishlar ham ko‘rinsa, to‘xtash kerak bo‘ladi. Stacklarni ajratish o‘zgarishlar ko‘lamini va rejani ko‘rib chiqish yukini kamaytiradi.
Yana bir muhim jihat — “yagona egalik”. Masalan, 31-managed-postgresql boshqariladigan PostgreSQL xizmatining o‘zini yaratadi, ammo xizmatga kirish uchun haqiqiy ACG qoidalari 34-managed-service-access yagona egasi bo‘ladigan tarzda tashkil etilgan. Buning sababi shundaki, agar DB va NKS stacklari kirish qoidalarini alohida o‘zgartira boshlasa, drift va ziddiyatlar osonlikcha yuzaga kelishi mumkin.
Tarmoqni keng quring, ammo kirishni tor doirada saqlang
Dastlab subnetlar juda ko‘pdek tuyuldi. Ularni public subnetlar, NAT gateway subnetlari, LB subnetlari, k8s subnetlari, DB subnetlari va middleware subnetlariga ajratish ortiqchadek ko‘rinishi mumkin.
Biroq ishlash muhitida nomlar va maqsadlarni ajratish keyinchalik ishlarni ancha osonlashtirdi.
Masalan, u quyidagicha ko‘rinishga ega edi.
-
public: ops host, NAT gateway, public LB
-
private: NKS worker node, DB, middleware VM, private LB
-
Zone taqsimoti: KR-1 va KR-2ni hisobga olgan holda subnetlarni ajratish
Albatta, har bir subnet boshidanoq murakkab HA tuzilmasida ishlatilmaydi. Middleware VM ham dastlab faqat bitta instance bilan ishga tushdi. Biroq keyinchalik OpenBao, Kafka va Redisni uchta instancegacha kengaytirishda yoki DBni HA/multi-zonega o‘zgartirishda tarmoq nomlari va maqsadlar avvaldan ajratilgan bo‘lsa, xavf ancha kam bo‘ladi.
Bu yerda anglaganim shuki, subnet dizaynini faqat hozirgi holatga asoslanib haddan tashqari soddalashtirsangiz, keyinchalik uni o‘zgartirish qiyinlashadi. Aksincha, boshidanoq hamma narsani ortiqcha avtomatlashtirish shart emas. Muhim jihat “hozir foydalanish uchun sodda, ammo keyinchalik kengaytirish mumkin bo‘lgan nomlar va chegaralardan boshlash” edi.
Managed NKS: uni bevosita boshqarmasligingiz mumkin, ammo dizayn uchun javobgarlik saqlanib qoladi
NKSdan foydalanish Kubernetes control plane uchun operatsion yukni kamaytiradi. Biroq bu Kubernetesning operatsion dizayni yo‘qoladi degani emas.
Joriy konfiguratsiya uchun biz dizaynni KVM asosidagi regional clusterga tayandik va node poollarni zonalar bo‘yicha ajratdik. Masalan, zonalarni shared-a va shared-bga bo‘lib, worker nodelarni bir xil spetsifikatsiyalar bilan muvozanatli tarzda ko‘paytiramiz.
Ishlash jarayonida quyidagiga o‘xshash savollar doim paydo bo‘ladi.
-
Joriy node xotirasidan foydalanish darajasi yetarlimi?
-
Podlarni scale out qilishdan oldin nodelar sonini oshirish kerakmi?
-
Node NotReady holatiga kelganda, Terraform state va console state bir-biriga mos keladimi?
-
PVC talab qiladigan workloadni deploy qilishdan oldin CSI add-on yoqilganmi?
-
LB turini o‘zgartirish yoki PROXY protokolini sozlash mavjud ingressga ta’sir qiladimi?
Haqiqiy operatsiyalarda hatto “bitta node qo‘shish” ham oddiy vazifa emas. Terraform planda faqat node_count o‘zgarayotganini va ACG yoki LB kabi boshqa resurslar o‘zgartirilmayotganini tekshirishingiz kerak. Agar plan maqsadga mos kelmasa, applyni to‘xtatish to‘g‘ri qaror bo‘ladi.
Bu tajriba orqali IaCning afzalligi “o‘zgarishlarni avtomatik qo‘llash”dan ko‘ra “qo‘llashdan oldin aynan nimalar o‘zgarishini ko‘ra olish”da ko‘proq ekanini his qildim.
Managed PostgreSQLdan olgan eng muhim saboqlarim
Managed PostgreSQL eng ko‘p sinov va xatolarga duch kelgan soham bo‘ldi.
Self-hosted PostgreSQLda odatiy bo‘lgan ko‘plab vazifalarni managed PostgreSQLda bajarib bo‘lmas edi.
-
Superuser huquqi mavjud emas.
-
pg_authidni bevosita so‘rab bo‘lmaydi.
-
Globals dumpdan o‘z holicha foydalanish qiyin.
-
Extension egasi service roledan farq qiladi.
-
postgis va pgvector kabi extensionlarni o‘rnatish usuli provayder siyosatlariga amal qiladi.
-
Hatto DB userini yaratishda ham SQL CREATE ROLE o‘rniga Naver Cloudning rasmiy boshqaruv yo‘lidan foydalanish talab qilinishi mumkin.
Dastlab mavjud VM asosidagi bootstrap SQLni shunchaki ko‘chirib o‘tkazishim mumkin deb o‘yladim. Aslida esa unday emas edi. Database creation, user creation, schema creation, grant assignment, extension verification va backup/restore alohida-alohida ajratilishi kerak bo‘ldi.
Hozirda har bir workload uchun quyidagi tuzilmadan foydalanamiz.
shared-platform-managed/
└── workloads/
    ├── devlime-managed/
    ├── banjang-managed/
    └── spicedb-managed/
Har bir workload quyidagi vazifalarga ega.
-
Workload ma’lumotlar bazasini Terraform bilan yaratish
-
Rasmiy Naver Cloud API orqali kerakli DB userlarini bosqichma-bosqich ta’minlash
-
Sxemalar, grantlar va default huquqlarni Ansible bilan moslashtirish
-
Xizmatga xos schema nomlari va role nomlarini aniq belgilash
-
Talab qilinadigan extensionlar uchun dastlabki tekshiruvlarni bajarish
Masalan, devlime bitta devlime_prd ma’lumotlar bazasi ichida devlime, vizend va modlime schema hamda role oilalarini birgalikda boshqaradi. banjang ham xuddi shunday banjang_prd ichida banjang, vizend va modlime oilalarini alohida belgilaydi.
Bu yondashuvning afzalligi shundaki, “ma’lumotlar bazasi bitta, ammo mas’uliyatlarni deklarativ tarzda ajratish mumkin”. Aksincha, kamchiligi dastlabki ta’riflar biroz batafsil bo‘lib qolishidir. Biroq xizmatlar qo‘shilganda yoki operatsiyalar vaqtida role huquqlari yetishmaganda qayerga o‘zgartirish kiritish kerakligini aniq aniqlash imkoniyati kattaroq foyda berdi.
PgBouncer va search_path muammosi
Ishlab chiqarish DBsidagi ulanishlar sonini hisobga olgan holda PgBouncerni ham sozladik. Xizmatlar PostgreSQLga bevosita ulanadigan o‘rniga, tuzilma PgBouncer orqali ulanishlar poolini ulashadi.
Bu jarayonda ham kutilmagan muammolar yuz berdi. Ayrim xizmatlar JDBC URL ichidagi currentSchema orqali schemani ko‘rsatgan, ammo PgBouncer startup parametri sifatida uzatilgan search_pathni o‘z holicha qayta ishlamaslikka sozlangan edi. Buning sababi search_path ignore_startup_parameters tarkibiga kiritilgan edi.
Dastlab PgBouncer konfiguratsiyasidan search_path ignore sozlamasini olib tashlash muammoni hal qiladigandek tuyuldi. Biroq bu barcha xizmatlardan keladigan ulanishlarga ta’sir qilishi mumkin edi, ishlash jarayonida umumiy PgBouncer konfiguratsiyasini o‘zgartirish esa xavfli bo‘lgan.
Oxir-oqibat, xavfsizroq yondashuv DB role uchun ma’lumotlar bazasiga xos default search_pathni belgilash bo‘ldi.
-
Service role avval o‘z schemasiga murojaat qiladi.
-
Managed PostgreSQL’da kengaytma o‘rnatilgan sxemani search_path tarkibiga kiriting.
-
Hatto PgBouncer orqali ulanganda ham, sxema aniqlanishi rolning standart sozlamalari orqali barqarorlashtiriladi.
Bu tajriba “ilova URL manzilidagi sozlamalar” va “DB rolning o‘zidagi standart sozlamalar”dan qaysi biri operatsion standart sifatida ishlatilishi kerakligini qayta ko‘rib chiqishimga sabab bo‘ldi. Operatsiyalar davomida ulanish yo‘li o‘zgarganda ham amal qiladigan sozlamalar, boshqacha aytganda, DB darajasidagi rol standartlari ko‘pincha barqarorroq bo‘ldi.
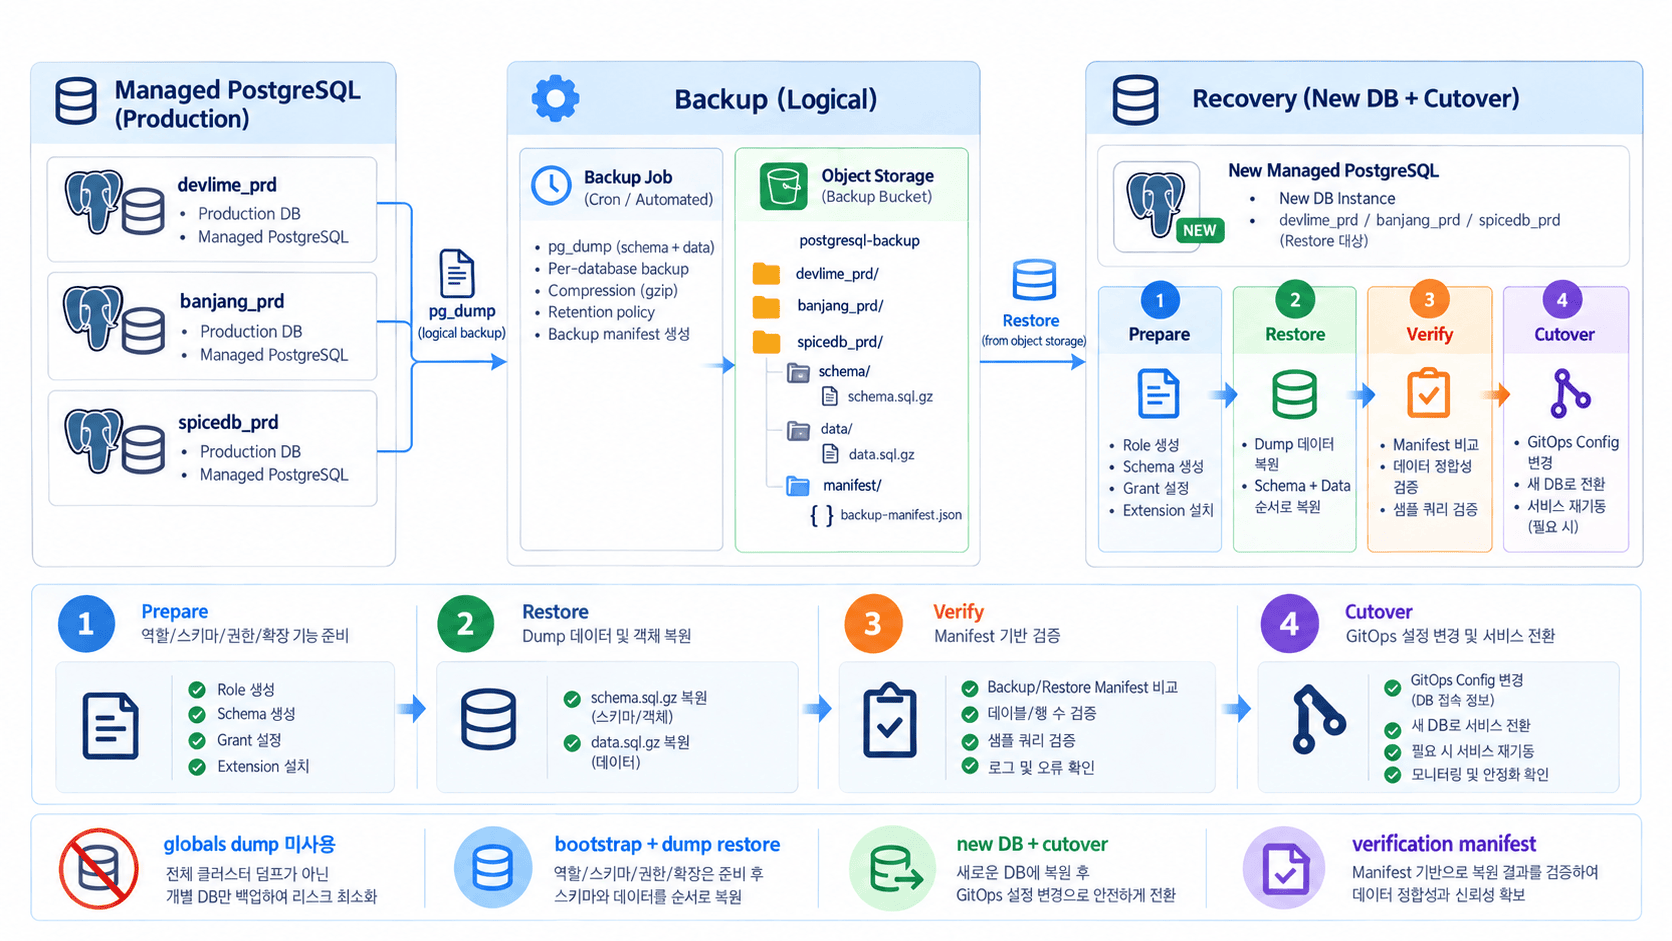
Zaxira nusxasi shunchaki dump fayli emas; u qayta tiklash imkoniyatini ham o‘z ichiga oladi.
Zaxira nusxalarini yaratish jarayonida ham ko‘p sinov va xatolar bo‘ldi. Ayniqsa, managed PostgreSQL’da globals dump’ga o‘z holicha tayanish qiyin bo‘lgani sababli, zaxiralash va qayta tiklash o‘rtasidagi chegarani qayta belgilashimizga to‘g‘ri keldi.
Amaldagi standartlar quyidagicha.
-
Managed PostgreSQL instansiyasining o‘zi Naver Cloud'ning avtomatik zaxira nusxalaridan foydalanadi.
-
Shuningdek, har bir ish yuklamasi DB’si uchun alohida mantiqiy zaxira nusxalarini yaratamiz.
-
globals dump standart holatda ishlatilmaydi.
-
bootstrap rollar, sxemalar, grantlar va kengaytmalarni tayyorlash uchun javob beradi.
-
dump restore ma’lumotlar va umumiy obyektlarni qayta tiklash uchun javob beradi.
-
Qayta tiklashdan so‘ng verification manifest yordamida sxema/jadval/qatorlar sonini taqqoslaymiz.
Dastlab “Zaxira fayli object storage’ga yuklansa, shuning o‘zi yetarli emasmi?” deb o‘ylash oson. Biroq amalda qayta tiklashni bajarganingizda bunday emasligi ayon bo‘ladi.
Qayta tiklash jarayoni quyidagi savollarga javob bera olishi kerak.
-
Yangi DB yaratish mumkinmi?
-
Foydalanuvchi va sxema ruxsatlarini qayta moslashtirish mumkinmi?
-
Qayta tiklashni kengaytmalar to‘qnashuvisiz bajarish mumkinmi?
-
Dump ichidagi sxema DDL’i bilan managed DB provayder tomonidan boshqariladigan sxema to‘qnashadimi?
-
Qayta tiklashdan so‘ng qatorlar yoki sxemalar sonini tekshirish mumkinmi?
-
Haqiqiy xizmat yangi DB’dan foydalanishi uchun cutover’ni amalga oshirish mumkinmi?
Shu sababli qayta tiklash stekini ham ish yuklamasidan ajratdik.
shared-platform-managed/
└── recovery/
    ├── devlime-managed/
    └── banjang-managed/
Ishlab chiqarish DB stekiga vaqtincha qayta tiklash DB’sini qo‘shish xavfli edi. Amaliyotda managed PostgreSQL provayderining xususiyatlari sababli ma’lumotlar bazalari ro‘yxatidagi o‘zgarishlar ba’zan almashtirish sifatida ko‘rindi. Shuning uchun qayta tiklashni alohida stekka ajratdik va mashq DB’si hamda hodisa paytidagi cutover DB’si uchun alohida nomlash qoidalarini belgiladik.
Standart qayta tiklash strategiyasi — yangi DB + cutover. Ishlab chiqarish DB’sini bevosita tozalab, qayta tiklashdan ko‘ra, uni yangi DB’ga qayta tiklash, tekshirish va keyin ilovaning ulanishini almashtirish xavfsizroq.
OpenBao zaxira nusxalari PostgreSQL zaxira nusxalariga qaraganda sezgirroq.
OpenBao, Kafka va Redis kabi yechimlar middleware VM’ida Docker Compose yordamida joylashtiriladigan tuzilmani qurdik. Hozircha bitta tugunli sozlamadan boshlayapmiz, biroq keyinchalik uning ahamiyati oshsa, uchta tugungacha kengaytirish yoki managed muqobilga ko‘chirish mumkin bo‘lishi uchun chegaralarni ochiq qoldirdik.
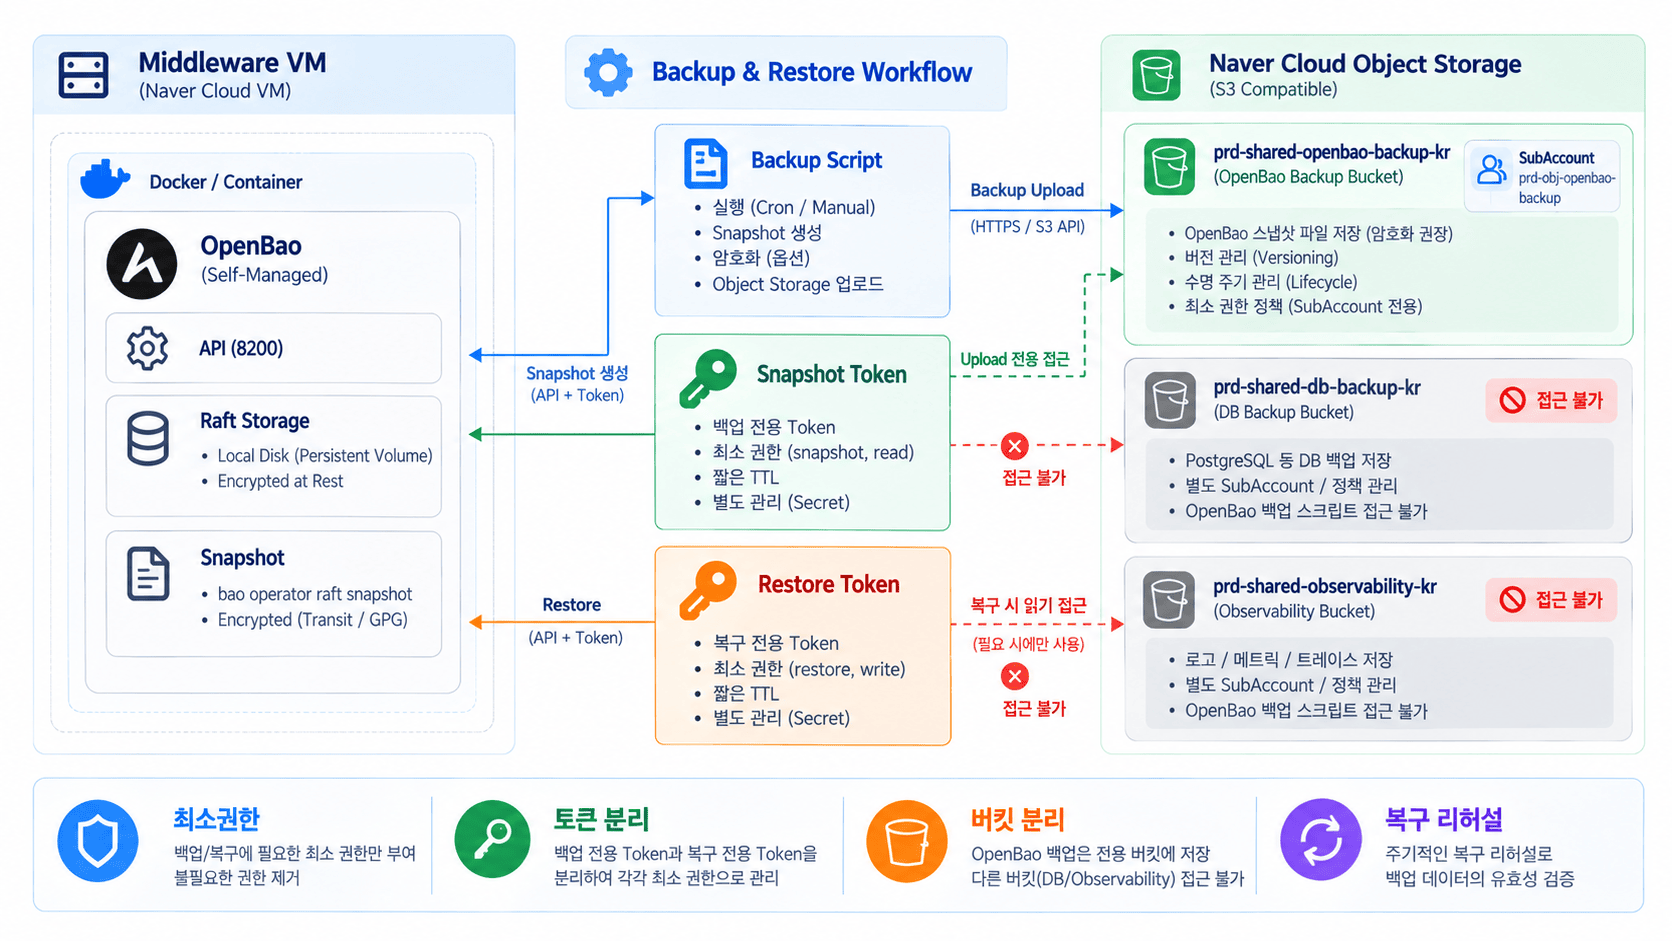
Ular orasida OpenBao zaxiralash nuqtayi nazaridan ayniqsa muhim edi. OpenBao shunchaki ilova emas; u sirlar omboridir. Shu sababli uni PostgreSQL mantiqiy zaxira nusxalari bilan bir xil bucket, bir xil hisob va bir xil ruxsatlardan foydalanib aralashtirish maqsadga muvofiq emas edi.
Amaldagi yo‘nalish quyidagicha.
-
OpenBao raft snapshot’lari uchun maxsus Object Storage bucket’dan foydalanish
-
OpenBao zaxira nusxalari uchun maxsus SubAccount’dan foydalanish
-
Uni DB zaxira nusxalari hisobidan ajratish
-
Snapshot tokeni va qayta tiklash tokenini ajratish
-
Oddiy operatsiyalar vaqtida qayta tiklash tokenini bo‘sh holda saqlash
-
Qayta tiklashni faol OpenBao’da bevosita emas, alohida mashq yoki texnik xizmat ko‘rsatish oynasida bajarish
Bu jarayonning bir qismi sifatida kirish huquqlarini boshqarishni ham alohida tashkil etdik. Naver Cloud Terraform provider’i SubAccount, siyosat tayinlash va kirish kalitlari kabi sohalarni yetarli darajada qamrab olmagani sababli, accessctl.py deb nomlangan yordamchi skript yaratdik.
Bu skript quyidagilarni boshqaradi.
-
SubAccount’ning kutilgan holati
-
foydalanuvchi yaratgan siyosat
-
bucket doirasidagi ruxsat
-
siyosat tayinlash
-
kirish kalitini yaratish
-
Mavjud keng qamrovli siyosatlarni olib tashlash rejasi
Bu yerda ham muhim saboq oldik. Object Storage bucket siyosatlari faqat bucket nomi bo‘yicha moslashtirilmaydi; ular Resource Manager NRN’ni talab qiladi. Shuning uchun bucket nomi berilganda, jarayonni Resource Manager API orqali aniq bucket NRN’ini qidirib topadigan va uni siyosatda aks ettiradigan qilib takomillashtirdik.
Operatsion ruxsatlarni shunchaki ishlaydigan qilishdan ko‘ra, ularni faqat zarur darajada ishlaydigan qilish muhimroq. Ayniqsa, zaxira nusxasi hisobi har bir bucket’ga kira olmasligi, faqat o‘z bucket’iga kira olishi kerak.
Ansible “server konfiguratsiyasini avtomatlashtirish”dan ko‘ra, operatsion tartib-taomillarni hujjatlashtirishga yaqinroq.
Ansible shunchaki paketlarni o‘rnatish yoki fayllarni nusxalash vositasidek ko‘rinishi mumkin. Biroq bu loyihada Ansible playbook’i operatsion tartib-taomillarni rasmiylashtirishga xizmat qildi.
Masalan, ops host quyidagilarni tayyorlaydi.
-
kubectl
-
helm
-
ncp-iam-authenticator
-
kubeconfig generation helper
-
boshqariladigan PostgreSQL ulanish yordamchisi
-
PostgreSQL mantiqiy zaxira nusxalash xizmati/taymeri
Middleware VM quyidagilarni tayyorlaydi.
-
Docker Engine
-
Docker Compose plagini
-
OpenBao compose/xizmati
-
Kafka compose/xizmati
-
Redis compose/xizmati
-
zaxiralash skripti karkasi
-
OpenBao ishga tushirish/unseal yordamchisi
Wrapper skripti ayniqsa foydali bo‘ldi. Playbook’ga qarab, ayrim vazifalar root rejimida, boshqalari esa ops rejimida ishga tushirilishi kerak. Shu sababli run-playbook.sh joriy inventory’dagi ansible_user qiymatini tekshiradi va u mos kelmasa, ishga tushirishni rad etadi.
Bunday kichik himoya mexanizmlari haqiqiy operatsiyalarda muhim ahamiyatga ega. Playbook’ni noto‘g‘ri foydalanuvchi bilan ishga tushirish konfiguratsiyaning yarimta qo‘llanishi yoki chalkash ruxsatlarga olib kelishi mumkin. IaC avtomatlashtirish bo‘lgani sababli, u kichik xatolarni tezda kattalashtirib, yirik muammolarga aylantirishi mumkin. Shu bois biz ishga tushirishdan oldin bajarilishni rad eta oladigan tuzilmaga muhtoj edik.
GitOps va IaC o‘rtasidagi munosabat
Terraform va Ansible’ning mavjudligi GitOps’ga bo‘lgan ehtiyojni yo‘q qilmaydi. Aksincha, ularning vazifalari turlicha.
-
Terraform: bulut resurslarining hayotiy sikli
-
Ansible: ichki VM operatsion konfiguratsiyasi va bootstrap
-
GitOps: Kubernetes resurslarining kerakli holati
-
workload bootstrap: ichki ma’lumotlar bazasi tuzilmasini moslashtirish
Masalan, ilova replikalari sonini oshirish, PgBouncer ulanish URL’ini qo‘llash yoki Ingress/LB sozlamalarini o‘zgartirish GitOps domeniga kiradi. Boshqa tomondan, NKS node pool’ini kengaytirish Terraform domeniga kiradi. Boshqariladigan PostgreSQL foydalanuvchilari va sxema ruxsatlarini moslashtirish esa workload bootstrap domeniga kiradi.
Agar bu chegaralar aniq belgilanmasa, operatsion muammo yuzaga kelganda o‘zgarishlarni qayerda amalga oshirish kerakligi noaniq bo‘lib qoladi. Aslida, chegaralar noaniq bo‘lgani sababli tuzilmani bir necha marta qayta tashkil qildim. Workload’larni shared-platform-managed ostiga ko‘chirish ham buning sabablaridan biri edi. Joriy tuzilmada workload’larning amaldagi boshqariladigan platformaga bog‘liqligi yo‘ldan ham ko‘rinib turadi.
Joriy tuzilmani bir jumlada umumlashtirish
Joriy tuzilmani quyidagicha umumlashtirish mumkin.
Terraform bulut resurslari uchun boshlang‘ich asosni yaratadi, Ansible operatsion kirish nuqtalari va ichki VM konfiguratsiyasini tayyorlaydi, workload’ga xos bootstrap boshqariladigan PostgreSQL’ning ichki holatini moslashtiradi, GitOps esa Kubernetes ilovalarining kerakli holatini boshqaradi.
Biroz batafsilroq:
-
shared-platform-managed/terraform: tarmoq, xavfsizlik, NKS, PostgreSQL, middleware VM, Object Storage
-
shared-platform-managed/ansible: ops xost, NKS vositalari, ma’lumotlar bazasiga kirish/zaxiralash, middleware VM konfiguratsiyasi
-
shared-platform-managed/workloads: devlime, banjang va spicedb uchun DB/sxema/rol/grant
-
shared-platform-managed/recovery: tiklash mashqlari va yangi DB + cutover’ga tayyorgarlik
-
shared-platform-managed/access: Object Storage SubAccount va minimal ruxsat siyosati
-
Alohida GitOps repozitoriysi: amaldagi Kubernetes ilova/infratuzilma manifestlari
Bu tuzilmaning afzalligi shundaki, har bir bosqich nisbatan aniq. Kamchiligi esa uni birinchi marta ko‘rayotgan kishiga kataloglar juda ko‘pdek tuyulishidir. Shu sababli hujjatlar va runbook’lar ham muhim ahamiyat kasb etdi.
Operatsiyalar davomida men ayniqsa muhim deb topgan nazorat nuqtalari
1. Terraform plan — “qo‘llashdan oldingi qo‘llanma”
plan shunchaki apply’dan oldingi bosqich emas. Operatorlar uchun u o‘zgarishlar bo‘yicha qo‘llanmadir. Agar mo‘ljallangan resurslardan boshqa o‘zgarishlar ko‘rinsa, to‘xtash kerak.
Bitta Object Storage bucket’ini qo‘shish uchta mavjud siyosatni yangilanish sifatida ko‘rsatgan holat bo‘lgan. Ruxsatlarda amalda hech qanday farq yo‘q edi; bu API condition: {} qiymatini qaytargani sababli taqqoslashdagi noto‘g‘ri ijobiy natija edi. Bunday holatlarda to‘g‘ri yondashuv apply’ni ishga tushirishdan oldin taqqoslash mantiqini tuzatishdir.
2. Boshqariladigan xizmatlar mas’uliyatni yo‘q qilmaydi; uni o‘zgartiradi
NKS’dan foydalanish control plane operatsiyalarini kamaytiradi. Biroq node pool, add-on, ingress, storage class va resurs bosimini boshqarish baribir zarur.
Managed PostgreSQL’dan foydalanish ma’lumotlar bazasi dvigateliga oid operatsiyalarni kamaytiradi. Biroq buning o‘rniga rol, sxema, kengaytma va zaxiralash/tiklash strategiyalari yanada aniqroq ishlab chiqilishi kerak.
3. Zaxiralash har doim tiklash va tekshirishgacha davom etishi kerak
Zaxira faylining mavjudligi tiklash mumkinligini anglatmaydi. managed PostgreSQL’da globals dump cheklovlari mavjud, OpenBao turli snapshot va restore token’laridan foydalanadi, Object Storage ruxsatlari ham alohida boshqarilishi kerak.
PostgreSQL uchun hozirda prepare -> restore -> verify oqimini yo‘lga qo‘ydim, OpenBao uchun raft snapshot zaxiralash/tiklash yordamchisini esa hali ham tartibga keltirmoqdaman.
4. Hisob va ruxsat doiralarini keyin toraytirgandan ko‘ra, boshidanoq cheklangan ko‘lamlardan boshlash yaxshiroq
Dastlab keng Object Storage ruxsatlari yordamida tezda ulanishni xohlashingiz mumkin. Biroq operatsion zaxiralash hisoblari ayniqsa sezgir hisoblanadi.
Joriy yo‘nalish DB backup, observability, Banjang vault va OpenBao backup’ni alohida SubAccount’lar hamda bucket ko‘lamidagi siyosatlarga ajratishdan iborat.
5. Hujjatlar ham IaC’ning bir qismidir
Faqat Terraform va Ansible kodi operatorlarga nima uchun narsalar aynan shu tarzda sozlanganini tushunishni qiyinlashtiradi. Shu sababli README, tiklash qo‘llanmasi, cutover qo‘llanmasi va kirish qo‘llanmasini takomillashtirishda davom etdim.
Hujjatlar keyinroq alohida yozilmasligi kerak; ular tuzilma bilan birga o‘zgarishi zarur edi. Amalda tiklash mashqlarini o‘tkazish davomida runbook’ni ham bir necha marta qayta ko‘rib chiqdim.
Qolgan vazifalar
Joriy tuzilmani yakunlangan deb hisoblamayman. Hali bajarilishi kerak bo‘lgan vazifalar aniq mavjud.
-
Middleware VM’ni bitta tugunli sozlamadan HA arxitekturasiga kengaytirish mezonlarini belgilash
-
OpenBao tiklash mashqi muhitini ajratish
-
Object Storage hayotiylik davri va saqlash siyosatlarini IaC sifatida boshqarish
-
NKS tugunlarini avtomatik masshtablash yoki qo‘shimcha masshtablash mezonlarini belgilash
-
PgBouncer’dan foydalanish doirasini kengaytirish va har bir xizmat uchun tekshiruvni avtomatlashtirish
-
Dasturchi/operator kirish hisoblarini individuallashtirish
-
Maxfiy ma’lumotlarni boshqarish usulini yanada tartibga solish
-
Runbook va amaldagi avtomatlashtirish o‘rtasidagi tafovutni bartaraf etish
Ammo hozircha hech bo‘lmaganda, “nima qayerda boshqariladi” degan masala avvalgidan ancha ravshanlashdi. Muammo yuzaga kelganda esa qaysi stack, qaysi playbook va qaysi workload definition’ni ko‘rib chiqish kerakligini aniqlash osonlashdi.
Xulosa
Ushbu loyiha ustida ishlash IaC haqidagi qarashlarimni biroz o‘zgartirdi.
Avvaliga IaC’ni shunchaki “Terraform yordamida infratuzilma qurish” deb o‘ylash oson. Ammo operatsion muhitda buning o‘zi yetarli emas.
Aslida, IaC operatsion bilimlarni tizimlashtirish jarayoniga ko‘proq o‘xshaydi.
-
Qaysi resurslar mavjud bo‘lishi kerak
-
Bu resurslarga kim egalik qiladi
-
Ular qanday tartibda yaratilishi kerak
-
Qanchalik darajada avtomatlashtirish va qayerda tasdiqlash talab etilishi
-
Nosozlik yuz berganda tiklash uchun nimadan foydalanish
-
Tiklash haqiqatan ham ishlashini qanday isbotlash
IaC ushbu savollarga javob beradigan kod va hujjatlar birgalikda mavjud bo‘lgandagina operatsion jihatdan yaroqli bo‘ladi.
Terraform infratuzilma skeletini yaratdi. Ansible VM’lar ichidagi operatsion konfiguratsiyani takrorlanadigan jarayonga aylantirdi. workload bootstrap boshqariladigan PostgreSQL’ning ichki holatini deklarativ tarzda muvofiqlashtirdi. GitOps Kubernetes ilovalari holatini uzluksiz muvofiqlashtirish uchun standartga aylandi. Backup/recovery runbook esa “nosozlik yuz berganda haqiqatan ham tiklay olamizmi” degan savolga javobni tekshirish uchun xavfsizlik tarmog‘iga aylandi.
Hali takomillashtirish uchun katta imkoniyatlar mavjud. Shunga qaramay, self-hosted’ga markazlashgan tuzilmadan managed’ga markazlashgan tuzilmaga o‘tar ekanmiz, menimcha, biz nafaqat bulut resurslarini yaratish, balki operatsion mas’uliyatlarni taqsimlash, o‘zgarishlarning ta’sir doirasini kamaytirish va tiklanishi mumkin bo‘lgan tuzilma qurish orqali oldinga qadam tashladik.
Bu yakunlanishdan ko‘ra uzluksiz takomillashtirish jarayoniga yaqinroq. Ammo bu jarayondan olingan eng katta saboq aniq.
Yaxshi IaC — muvaffaqiyatli qo‘llanadigan kod emas; u operatorlarga o‘zgarishlarni ishonch bilan amalga oshirish imkonini beradigan tuzilmadir.
Andy