
요즘 인프라를 이야기할 때 “IaC(Infrastructure as Code)”라는 말은 너무 익숙합니다. Terraform으로 클라우드 리소스를 만들고, Ansible로 서버 설정을 자동화하고, Kubernetes와 GitOps로 애플리케이션 배포를 관리하는 방식은 이제 특별한 기술이라기보다 운영의 기본기에 가까워졌습니다.
그런데 실제 운영 환경을 구성해보면, IaC는 단순히 “코드로 인프라를 만든다”는 수준에서 끝나지 않습니다. 오히려 중요한 질문은 그다음부터 시작됩니다.
-
무엇을 Terraform이 책임져야 하는가?
-
무엇은 Ansible이 책임져야 하는가?
-
Managed Service가 제공하는 영역과 우리가 직접 운영해야 하는 영역의 경계는 어디인가?
-
운영 중 변경이 생겼을 때, 기존 리소스를 안전하게 유지하면서 어떻게 확장할 것인가?
-
백업과 복구는 “설정되어 있다”가 아니라 “실제로 복구 가능하다”까지 확인되어 있는가?
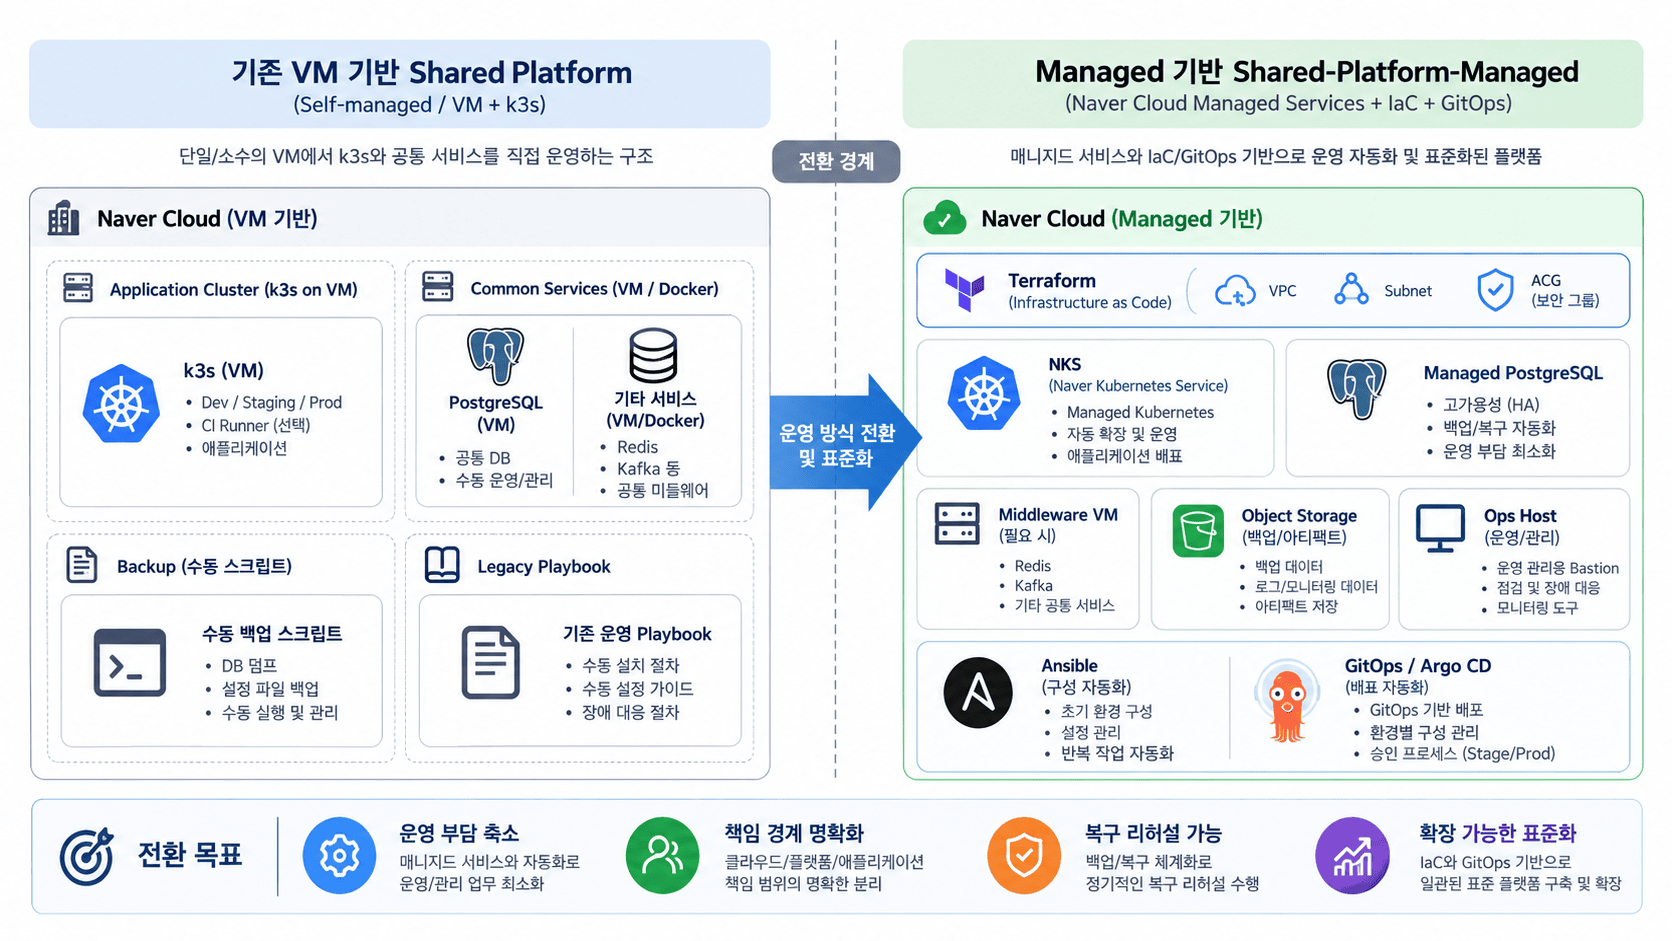
이번 글은 네이버 클라우드 환경에서 운영용 shared platform을 managed 기반으로 구성하면서 정리한 경험담입니다. VM 기반으로 운영하던 기존 구조를 그대로 버리기보다는, 필요한 부분은 유지하고, Kubernetes와 PostgreSQL은 managed service로 옮기며, Terraform과 Ansible, 일부 API 기반 자동화를 조합해 운영 가능한 구조로 만들어가는 과정이었습니다.
처음부터 완벽한 구조를 만든 것은 아닙니다. 오히려 진행하면서 “이 책임은 여기 있으면 안 되겠다”, “이 설정은 너무 넓다”, “복구 절차가 문서만 있고 실제 검증은 안 되어 있다” 같은 문제를 계속 마주했고, 그때마다 구조를 조금씩 다듬었습니다. 이 글은 그 시행착오를 포함해 현재 기준의 구조와 생각을 정리한 기록입니다.
왜 새 managed platform을 만들었나
기존에는 VM 기반으로 Kubernetes와 PostgreSQL을 직접 구성하는 방식이 있었습니다. 이 방식은 제어권이 넓고 익숙하다는 장점이 있습니다. VM에 직접 들어가서 설정을 보고, PostgreSQL superuser에 가까운 권한으로 role과 database를 다루고, 필요한 백업 스크립트도 비교적 단순하게 작성할 수 있습니다.
하지만 운영 환경이 커질수록 직접 운영해야 하는 영역이 점점 부담이 됩니다.
-
Kubernetes control plane 운영 부담
-
PostgreSQL VM 패치, 장애, 백업, 복구 책임
-
노드 증설과 네트워크 구성을 수동 판단에 의존하는 문제
-
운영자 접근, 권한, 감사 추적의 복잡성
-
복구 리허설을 반복하기 어려운 구조
그래서 방향을 managed 중심으로 바꾸었습니다.
-
Kubernetes는 Naver Kubernetes Service(NKS)
-
PostgreSQL은 Cloud DB for PostgreSQL
-
공통 접근 지점은 ops host
-
Redis, Kafka, OpenBao 같은 middleware는 우선 VM 기반 Docker Compose로 시작
-
인프라 리소스는 Terraform stack으로 관리
-
VM 내부 운영 구성은 Ansible playbook으로 관리
-
애플리케이션 배포는 GitOps 흐름으로 분리
중요한 것은 “모든 것을 managed로 바꾸자”가 아니었습니다. 오히려 현실적인 목표는 “어디까지 managed service에 맡기고, 어디부터 우리가 운영 자동화로 책임질지 명확히 나누자”였습니다.
가장 먼저 정한 원칙
진행하면서 가장 많이 되돌아본 것은 도구 자체가 아니라 책임 경계였습니다. Terraform, Ansible, GitOps, Managed Service는 모두 좋은 도구지만, 경계가 흐려지면 오히려 운영이 어려워집니다.
그래서 아래 원칙을 잡았습니다.
-
클라우드 리소스의 생명주기는 Terraform이 책임진다.
-
VM 내부 운영 구성은 Ansible이 책임진다.
-
Kubernetes 애플리케이션 배포는 GitOps가 책임진다.
-
Managed PostgreSQL 내부의 database, user, schema, grant는 workload 단위로 분리한다.
-
백업은 설정으로 끝내지 않고 restore와 verify까지 포함한다.
-
접근 권한은 계정 단위로 분리하고, broad policy는 줄인다.
-
운영 변경은 plan과 diff를 먼저 보고, 실제 apply는 의도한 변경만 남았을 때 수행한다.
이 원칙은 단순해 보이지만 실제로는 계속 시험대에 올랐습니다. 예를 들어 managed PostgreSQL에서 DB user를 Terraform resource로 만들 수는 있었지만, 운영 중 user가 늘어나는 상황에서 provider가 전체 교체처럼 plan을 잡는 문제가 있었습니다. 이 경우 “Terraform으로 다 해야 한다”는 원칙을 고집하면 오히려 위험해집니다.
결국 database 자체는 Terraform으로 관리하되, managed PostgreSQL user는 Naver Cloud 공식 API 기반으로 증분 생성하고, schema/grant/default privilege는 Ansible과 SQL bootstrap으로 관리하는 구조로 나누었습니다. IaC라고 해서 모든 것을 하나의 도구에 억지로 넣는 것이 아니라, 상태와 변경의 성격에 맞는 도구를 선택하는 것이 더 중요했습니다.
Terraform stack을 나눈 이유
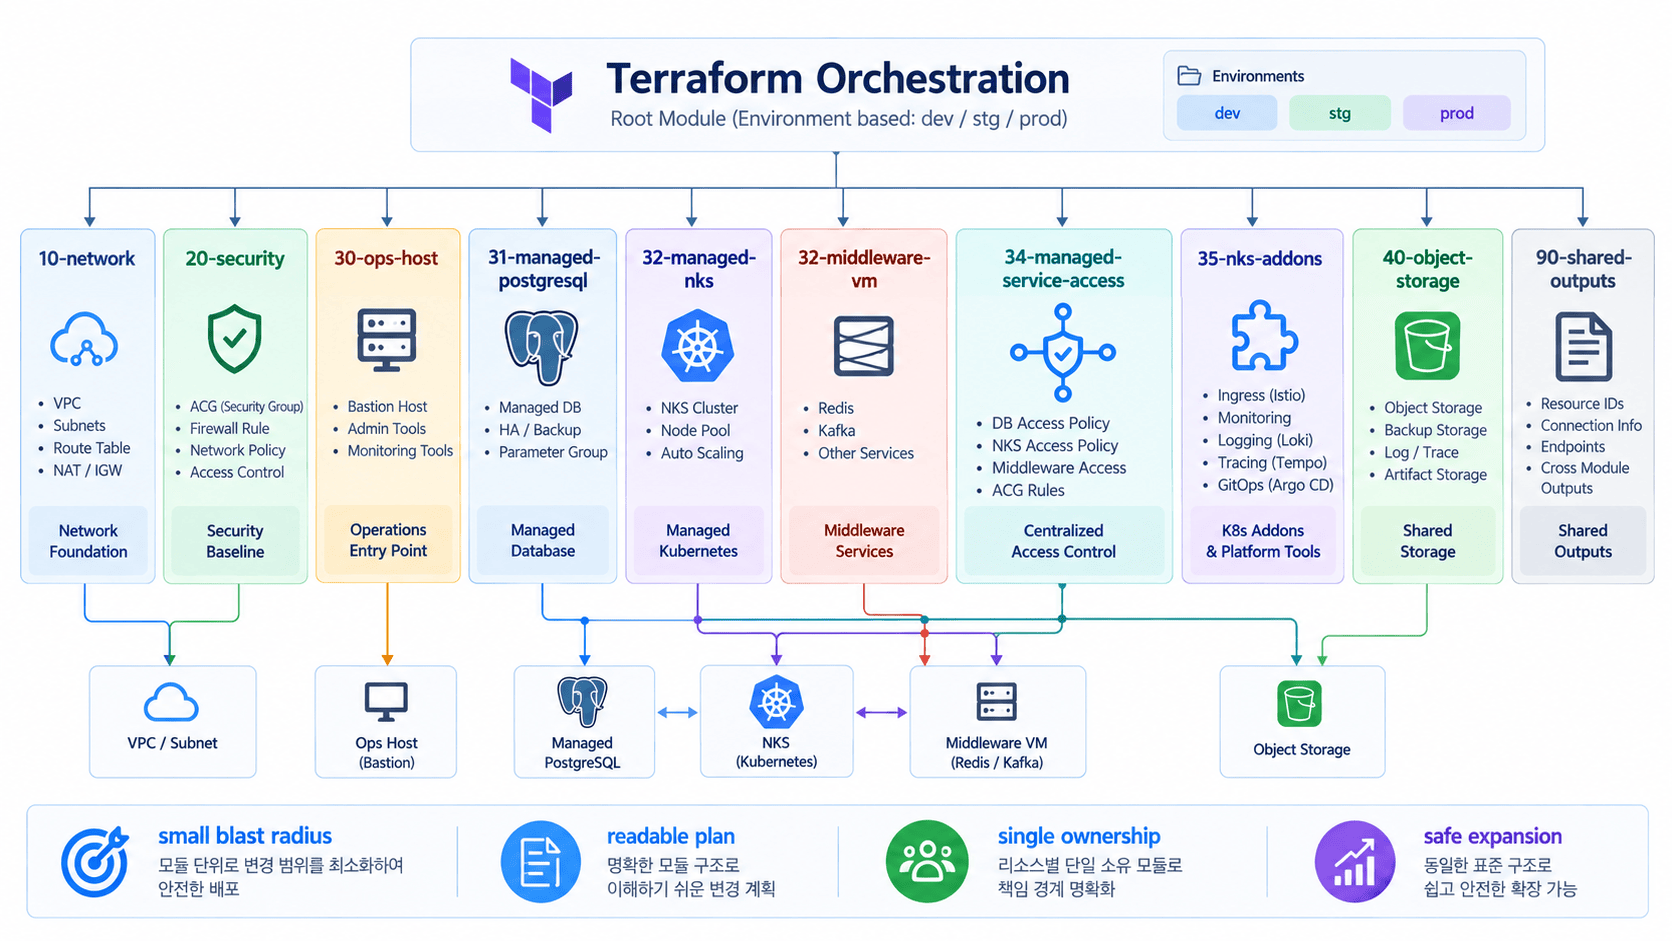
Terraform은 전체를 하나의 거대한 root module로 관리할 수도 있습니다. 하지만 운영 환경에서는 stack을 잘게 나누는 편이 더 안전했습니다.
현재 구조는 대략 이런 식입니다.
shared-platform-managed/
└── terraform/
    ├── 10-network/
    ├── 20-security/
    ├── 30-compute-ops-host/
    ├── 31-managed-postgresql/
    ├── 32-managed-nks/
    ├── 33-compute-middleware-vm/
    ├── 34-managed-service-access/
    ├── 35-nks-addons/
    ├── 40-object-storage/
    └── 90-shared-outputs/
각 stack은 책임이 다릅니다.
-
10-network: VPC, subnet, route, NAT gateway
-
20-security: ACG와 기본 보안 경계
-
30-compute-ops-host: 운영 진입점 역할의 ops host
-
31-managed-postgresql: Cloud DB for PostgreSQL 인스턴스
-
32-managed-nks: NKS cluster와 node pool
-
33-compute-middleware-vm: Redis, Kafka, OpenBao 등을 위한 middleware VM
-
34-managed-service-access: NKS, middleware, managed DB 간 접근 규칙
-
35-nks-addons: NKS CSI add-on 같은 cluster add-on
-
40-object-storage: DB backup, observability, OpenBao backup 등 bucket
-
90-shared-outputs: 다른 stack output을 한곳에서 확인하는 요약 stack
이렇게 나누면 적용 순서가 길어지는 단점은 있습니다. 하지만 운영 환경에서는 그 단점보다 장점이 컸습니다.
예를 들어 노드풀을 늘리는 작업을 할 때, network나 DB가 plan에 같이 섞이면 불안합니다. Object Storage 버킷 하나를 추가하는 작업에서 NKS나 PostgreSQL 변경이 같이 보이면 멈춰야 합니다. stack을 나누면 변경 반경이 작아지고, plan을 읽는 부담도 줄어듭니다.
또 하나 중요한 점은 “단일 소유자”입니다. 예를 들어 managed PostgreSQL 자체는 31-managed-postgresql이 만들지만, 실제 서비스 접근 ACG 규칙은 34-managed-service-access가 단일 소유하도록 정리했습니다. DB stack과 NKS stack이 각자 접근 규칙을 만지기 시작하면 drift와 충돌이 생기기 쉽기 때문입니다.
네트워크는 넓게 만들고, 접근은 좁게 잡는다
처음에는 subnet이 많아 보였습니다. public subnet, NAT gateway subnet, LB subnet, k8s subnet, DB subnet, middleware subnet까지 나누면 과한 것처럼 느껴질 수 있습니다.
하지만 운영 환경에서는 이름과 용도를 분리해두는 것이 나중에 훨씬 편했습니다.
예를 들면 이런 식입니다.
-
public: ops host, NAT gateway, public LB
-
private: NKS worker node, DB, middleware VM, private LB
-
zone 분산: KR-1, KR-2를 고려한 subnet 분리
물론 모든 subnet이 처음부터 복잡한 HA 구조로 쓰이는 것은 아닙니다. middleware VM도 처음에는 1대로 시작했습니다. 하지만 나중에 OpenBao, Kafka, Redis를 3대로 확장하거나, DB를 HA/multi-zone으로 바꿔야 할 때 네트워크 이름과 용도가 이미 분리되어 있으면 훨씬 덜 위험합니다.
여기서 느낀 점은, subnet 설계는 현재만 보고 너무 단순화하면 나중에 다시 손대기 어렵다는 것입니다. 반대로 처음부터 모든 것을 과하게 자동화할 필요도 없습니다. 핵심은 “지금은 단순하게 쓰되, 나중에 확장 가능한 이름과 경계로 시작하는 것”이었습니다.
Managed NKS: 직접 운영하지 않아도 설계 책임은 남는다
NKS를 사용하면 Kubernetes control plane 운영 부담은 줄어듭니다. 하지만 그렇다고 Kubernetes 운영 설계가 사라지는 것은 아닙니다.
현재 구성에서는 KVM 기반 regional cluster 방향을 기준으로 잡고, node pool을 zone 단위로 분리했습니다. 예를 들어 shared-a, shared-b처럼 zone을 나누고, 같은 스펙의 worker node를 균형 있게 늘리는 방식입니다.
운영 중에는 이런 고민이 계속 생깁니다.
-
현재 노드 메모리 사용률이 충분한가?
-
파드를 다중화하기 전에 노드를 먼저 늘려야 하는가?
-
노드 하나가 NotReady가 되었을 때 Terraform state와 콘솔 상태가 일치하는가?
-
PVC가 필요한 workload를 올리기 전에 CSI add-on이 활성화되어 있는가?
-
LB 타입 변경이나 PROXY protocol 설정이 기존 ingress에 영향을 주는가?
특히 실제 운영에서는 “노드 1개 추가”도 단순한 작업이 아닙니다. Terraform plan에서 정말 node_count만 바뀌는지, ACG나 LB 같은 다른 리소스가 변경되지 않는지 확인해야 합니다. plan이 의도와 다르면 apply를 멈추는 것이 맞습니다.
이 경험을 통해 IaC의 장점은 “자동으로 apply한다”가 아니라 “적용 전에 무엇이 바뀌는지 정확히 볼 수 있다”에 더 가깝다고 느꼈습니다.
Managed PostgreSQL에서 가장 많이 배운 것
가장 시행착오가 많았던 부분은 managed PostgreSQL이었습니다.
self-hosted PostgreSQL에서는 자연스럽게 하던 작업이 managed PostgreSQL에서는 안 되는 경우가 많았습니다.
-
superuser 권한이 없다.
-
pg_authid를 직접 조회할 수 없다.
-
globals dump를 그대로 쓰기 어렵다.
-
extension owner가 서비스 role과 다르다.
-
postgis, pgvector 같은 extension 설치 방식이 provider 정책을 따른다.
-
DB user 생성도 SQL CREATE ROLE이 아니라 Naver Cloud 공식 관리 경로를 타야 하는 경우가 있다.
처음에는 기존 VM 기반 bootstrap SQL을 그대로 가져오면 될 것 같았습니다. 하지만 실제로는 그렇지 않았습니다. database 생성, user 생성, schema 생성, grant 부여, extension 확인, backup/restore를 각각 분리해야 했습니다.
현재는 workload별로 이런 구조를 둡니다.
shared-platform-managed/
└── workloads/
    ├── devlime-managed/
    ├── banjang-managed/
    └── spicedb-managed/
각 workload는 다음 책임을 가집니다.
-
Terraform으로 workload database 생성
-
Naver Cloud 공식 API로 필요한 DB user 증분 보장
-
Ansible로 schema, grant, default privilege 정렬
-
서비스별 schema naming과 role naming을 명시
-
필요한 extension preflight 수행
예를 들어 devlime은 devlime_prd 하나의 DB 안에 devlime, vizend, modlime 계열 schema와 role을 함께 관리합니다. banjang도 banjang_prd 안에 banjang, vizend, modlime 계열을 나누어 정의합니다.
이 방식의 장점은 “DB는 하나지만 책임은 선언적으로 분리”할 수 있다는 점입니다. 반대로 단점은 처음 정의가 조금 장황해진다는 것입니다. 하지만 운영 중에 서비스가 늘어나거나 role 권한이 빠졌을 때, 어디를 고쳐야 하는지 명확해지는 장점이 더 컸습니다.
PgBouncer와 search_path 문제
운영 DB connection 수를 고려하면서 PgBouncer도 구성했습니다. 서비스가 직접 PostgreSQL에 붙는 대신, PgBouncer를 통해 connection pool을 공유하는 구조입니다.
이 과정에서도 예상치 못한 문제가 있었습니다. 일부 서비스는 JDBC URL의 currentSchema를 통해 schema를 지정하고 있었는데, PgBouncer는 startup parameter로 전달되는 search_path를 그대로 처리하지 않는 구성이었습니다. ignore_startup_parameters에 search_path가 포함되어 있었기 때문입니다.
처음에는 PgBouncer 설정에서 search_path 무시를 제거하면 될 것처럼 보였습니다. 하지만 전체 서비스 접속에 영향을 줄 수 있고, 운영 중 공통 PgBouncer 설정을 바꾸는 것은 위험했습니다.
결국 더 안전한 방향은 DB role에 database별 기본 search_path를 설정하는 것이었습니다.
-
서비스 role은 자기 schema를 먼저 본다.
-
managed PostgreSQL에서 extension이 위치한 schema도 search_path에 포함한다.
-
PgBouncer를 타더라도 role 기본값으로 schema resolution이 안정화된다.
이 경험은 “애플리케이션 URL에 있는 설정”과 “DB role 자체의 기본 설정” 중 무엇을 운영 기준으로 삼을지 다시 생각하게 했습니다. 운영에서는 가능한 한 연결 경로가 바뀌어도 유지되는 설정, 즉 DB role 수준의 기본값이 더 안정적인 경우가 많았습니다.
백업은 dump 파일이 아니라 복구 가능성까지다
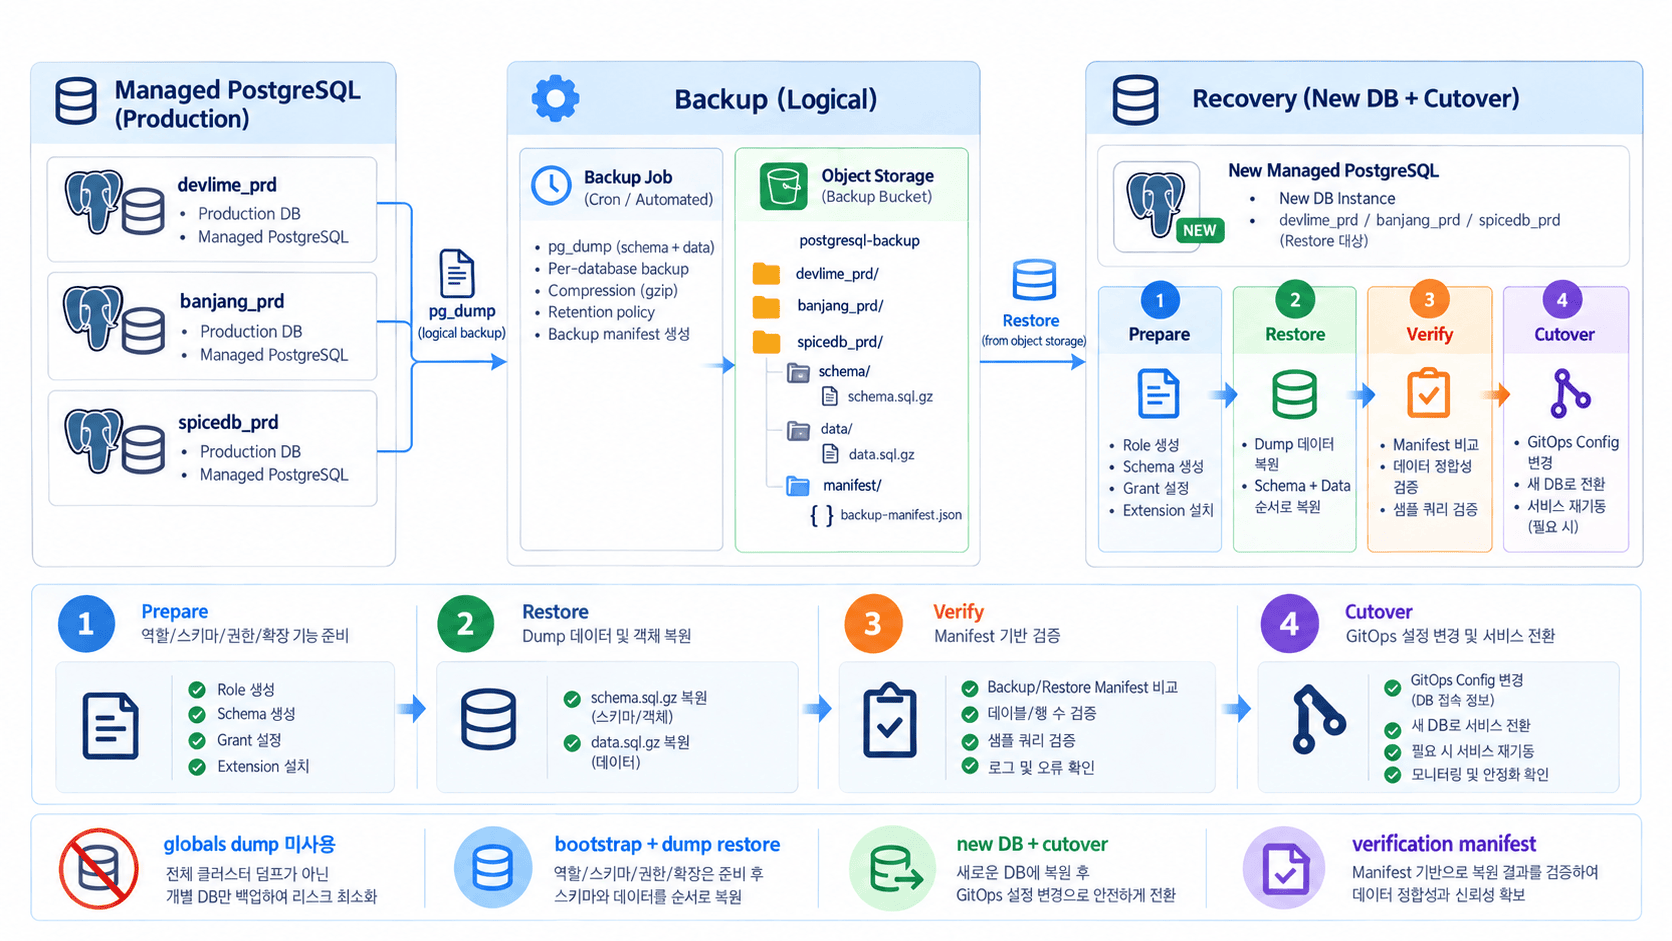
백업도 많은 시행착오가 있었습니다. 특히 managed PostgreSQL에서는 globals dump를 그대로 신뢰하기 어렵기 때문에 백업과 복구의 경계를 다시 잡아야 했습니다.
현재 기준은 다음과 같습니다.
-
managed PostgreSQL 인스턴스 자체는 Naver Cloud의 자동 백업을 사용한다.
-
별도로 workload DB 단위 logical backup도 수행한다.
-
globals dump는 기본으로 사용하지 않는다.
-
role, schema, grant, extension 준비는 bootstrap이 책임진다.
-
dump restore는 데이터와 일반 객체 복구를 담당한다.
-
restore 후 verification manifest로 schema/table/row count를 비교한다.
처음에는 “백업 파일이 object storage에 올라가면 충분하지 않을까?”라고 생각하기 쉽습니다. 하지만 실제로 복구해보면 그렇지 않습니다.
복구는 다음 질문에 답할 수 있어야 합니다.
-
새 DB를 만들 수 있는가?
-
user와 schema 권한을 다시 맞출 수 있는가?
-
extension 충돌 없이 restore할 수 있는가?
-
dump 안의 schema DDL과 managed DB의 provider-managed schema가 충돌하지 않는가?
-
복구 후 row count나 schema count를 검증할 수 있는가?
-
실제 서비스가 새 DB를 보도록 cutover할 수 있는가?
그래서 recovery stack도 workload와 분리했습니다.
shared-platform-managed/
└── recovery/
    ├── devlime-managed/
    └── banjang-managed/
운영 DB stack에 recovery DB를 임시로 끼워 넣는 방식은 위험했습니다. 실제로 managed PostgreSQL provider 특성상 database 목록 변경이 replacement처럼 보이는 상황도 있었습니다. 그래서 recovery는 별도 stack으로 분리하고, rehearsal DB와 incident cutover DB naming 규칙도 따로 정리했습니다.
기본 복구 전략은 new DB + cutover입니다. 운영 DB를 바로 clean하고 restore하는 방식보다, 새 DB에 복구한 뒤 검증하고 애플리케이션 연결을 전환하는 편이 더 안전합니다.
OpenBao 백업은 PostgreSQL 백업보다 더 민감하다
middleware VM에는 OpenBao, Kafka, Redis 같은 솔루션을 Docker Compose 기반으로 올리는 구조를 만들었습니다. 지금은 single-node로 시작하지만, 나중에 중요도가 올라가면 3대로 확장하거나 managed 대안으로 옮길 수 있도록 경계를 열어두었습니다.
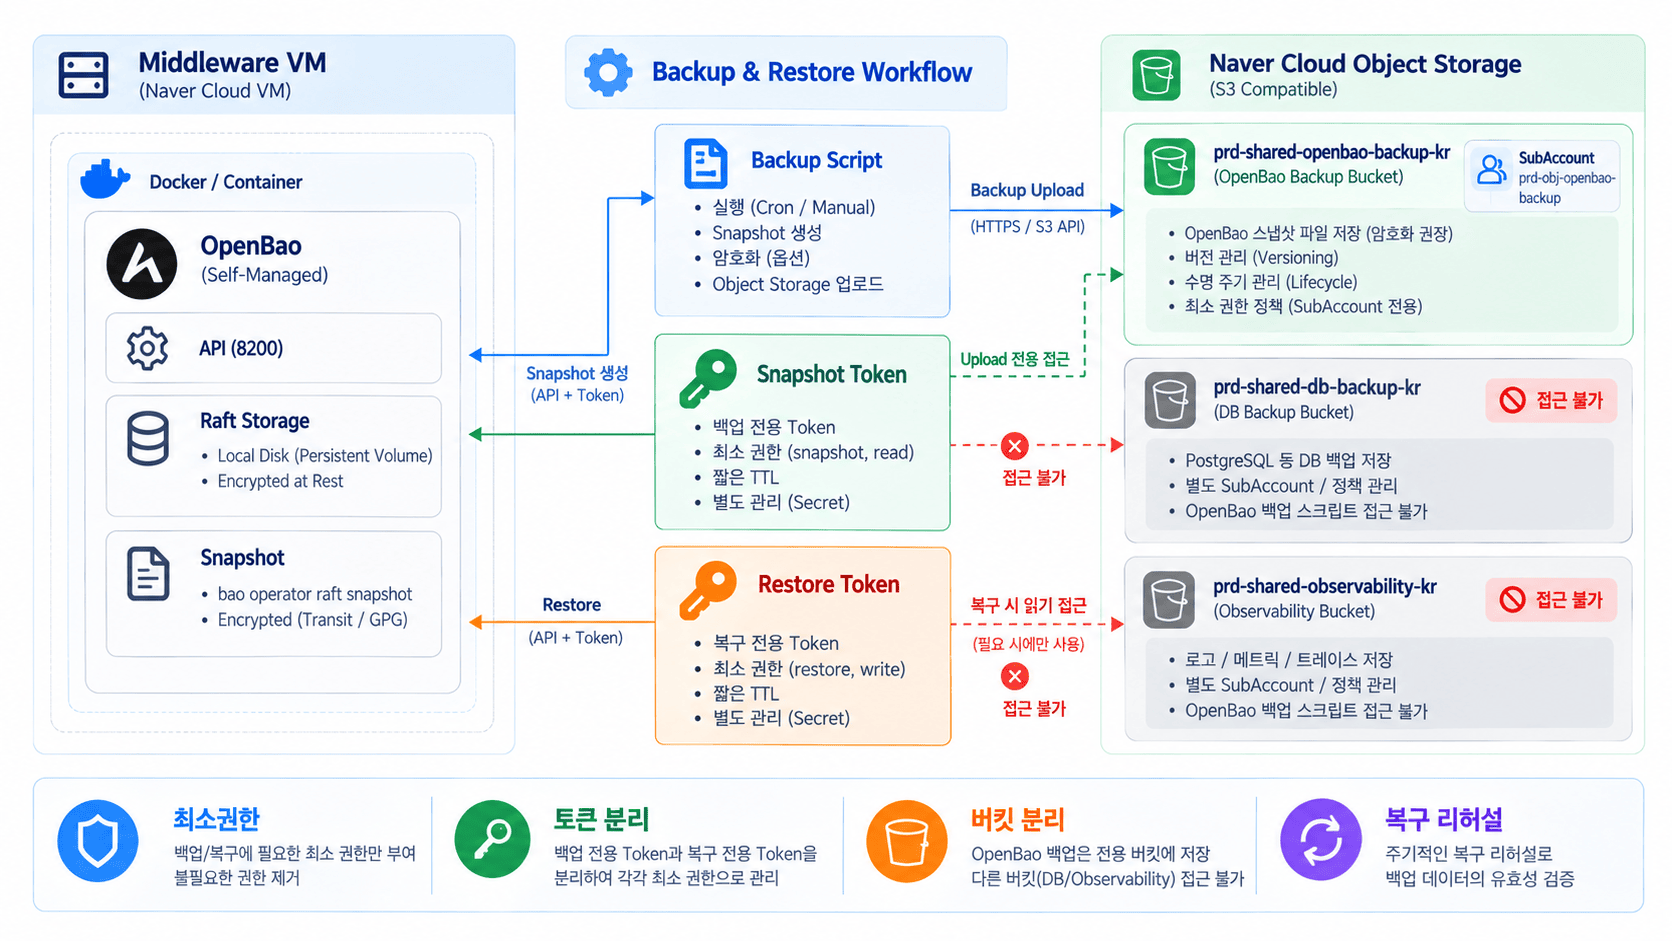
그중 OpenBao는 특히 백업 관점이 중요했습니다. OpenBao는 단순한 애플리케이션이 아니라 secret store입니다. 따라서 PostgreSQL logical backup과 같은 버킷, 같은 계정, 같은 권한으로 섞는 것은 적절하지 않았습니다.
현재 방향은 다음과 같습니다.
-
OpenBao raft snapshot 전용 Object Storage bucket 사용
-
OpenBao backup 전용 SubAccount 사용
-
DB backup 계정과 분리
-
snapshot token과 restore token 분리
-
평시에는 restore token을 비워둠
-
restore는 live OpenBao에 바로 하지 않고 별도 리허설 또는 점검 시간에 수행
이 과정에서 access 관리도 별도로 정리했습니다. Naver Cloud Terraform provider가 SubAccount, policy assignment, access key까지 충분히 다루지 못하는 영역이 있어, accessctl.py라는 보조 스크립트를 만들었습니다.
이 스크립트는 다음을 관리합니다.
-
SubAccount desired state
-
user-created policy
-
bucket scoped permission
-
policy assignment
-
access key 생성
-
기존 broad policy 제거 계획
여기서도 중요한 교훈이 있었습니다. Object Storage bucket policy는 단순히 bucket name만으로 매칭되지 않고 Resource Manager NRN이 필요했습니다. 그래서 bucket 이름을 쓰면 Resource Manager API로 정확한 bucket NRN을 조회해 policy에 반영하도록 보강했습니다.
운영 권한은 “동작하게 하는 것”보다 “필요한 만큼만 동작하게 하는 것”이 더 중요합니다. 특히 백업 계정은 모든 버킷 접근이 아니라 자기 버킷만 접근해야 합니다.
Ansible은 “서버 설정 자동화”보다 운영 절차의 문서화에 가깝다
Ansible은 패키지 설치나 파일 복사만 하는 도구처럼 보일 수 있습니다. 하지만 이번 작업에서는 Ansible playbook이 운영 절차를 코드화하는 역할을 했습니다.
예를 들어 ops host는 다음을 준비합니다.
-
kubectl
-
helm
-
ncp-iam-authenticator
-
kubeconfig 생성 helper
-
managed PostgreSQL 접속 helper
-
PostgreSQL logical backup service/timer
middleware VM은 다음을 준비합니다.
-
Docker Engine
-
Docker Compose plugin
-
OpenBao compose/service
-
Kafka compose/service
-
Redis compose/service
-
backup script scaffold
-
OpenBao init/unseal helper
특히 wrapper script가 유용했습니다. playbook에 따라 root mode로 실행해야 하는 것과 ops mode로 실행해야 하는 것이 다릅니다. 그래서 run-playbook.sh가 현재 inventory의 ansible_user를 보고 맞지 않으면 실행을 거부하도록 했습니다.
이런 작은 가드레일이 실제 운영에서는 중요합니다. 잘못된 사용자로 playbook을 실행하면 반쯤 적용되거나 권한이 꼬일 수 있습니다. IaC는 자동화이기 때문에 오히려 작은 실수를 빠르게 크게 만들 수 있습니다. 그래서 “실행 전 거절”이 가능한 구조가 필요했습니다.
GitOps와 IaC의 관계
Terraform과 Ansible이 있다고 해서 GitOps가 필요 없어지는 것은 아닙니다. 오히려 책임이 다릅니다.
-
Terraform: 클라우드 리소스 생명주기
-
Ansible: VM 내부 운영 구성과 bootstrap
-
GitOps: Kubernetes 리소스 desired state
-
workload bootstrap: DB 내부 구조 정렬
예를 들어 애플리케이션 replica를 늘리거나, PgBouncer 연결 URL을 반영하거나, Ingress/LB 설정을 바꾸는 일은 GitOps 영역입니다. 반면 NKS node pool을 늘리는 일은 Terraform 영역입니다. managed PostgreSQL user와 schema 권한을 맞추는 일은 workload bootstrap 영역입니다.
이 경계를 구분해두지 않으면 운영 중 문제가 생겼을 때 “어디를 고쳐야 하는지”가 흐려집니다. 실제로 몇 번은 경계가 애매해서 다시 정리했습니다. workloads를 shared-platform-managed 아래로 옮긴 것도 그 이유 중 하나입니다. 지금 구조에서는 workload가 현재 managed platform에 의존한다는 사실이 경로에서도 드러납니다.
현재 구조를 한 문장으로 요약하면
현재 구조는 다음 문장으로 요약할 수 있습니다.
Terraform으로 클라우드 리소스의 기준선을 만들고, Ansible로 운영 진입점과 VM 내부 구성을 준비하며, workload별 bootstrap으로 managed PostgreSQL 내부 상태를 정렬하고, GitOps로 Kubernetes 애플리케이션 desired state를 관리한다.
조금 더 풀면 다음과 같습니다.
-
shared-platform-managed/terraform: 네트워크, 보안, NKS, PostgreSQL, middleware VM, Object Storage
-
shared-platform-managed/ansible: ops host, NKS 도구, DB 접속/백업, middleware VM 구성
-
shared-platform-managed/workloads: devlime, banjang, spicedb의 DB/schema/role/grant
-
shared-platform-managed/recovery: 복구 리허설과 new DB + cutover 준비
-
shared-platform-managed/access: Object Storage SubAccount와 least-privilege policy
-
별도 GitOps 저장소: 실제 Kubernetes app/infra manifests
이 구조의 장점은 각 단계가 비교적 명확하다는 점입니다. 단점은 처음 보는 사람에게 디렉터리가 많아 보인다는 점입니다. 그래서 문서와 runbook이 같이 중요해졌습니다.
운영하면서 특히 중요하다고 느낀 체크포인트
1. Terraform plan은 “적용 전 설명서”다
plan은 단순히 apply 전 단계가 아닙니다. 운영자에게는 변경 설명서입니다. 의도한 리소스 외에 다른 변경이 보이면 멈춰야 합니다.
Object Storage bucket 하나를 추가하는데 기존 policy 3개가 update로 보인 적이 있었습니다. 실제 권한 차이는 없고 API가 condition: {}를 붙여 반환해서 생긴 비교 오탐이었습니다. 이런 경우 apply하기 전에 비교 로직을 고치는 것이 맞습니다.
2. Managed Service는 책임이 사라지는 것이 아니라 바뀌는 것이다
NKS를 쓰면 control plane 운영은 줄어듭니다. 하지만 node pool, add-on, ingress, storage class, resource pressure 관리는 여전히 필요합니다.
Managed PostgreSQL을 쓰면 엔진 운영은 줄어듭니다. 하지만 role, schema, extension, backup/restore 전략은 오히려 더 명시적으로 설계해야 합니다.
3. Backup은 반드시 restore와 verify까지 이어져야 한다
백업 파일이 있다고 복구 가능한 것은 아닙니다. managed PostgreSQL은 globals dump 제약이 있고, OpenBao는 snapshot token과 restore token이 다르며, Object Storage 권한도 전용으로 관리해야 합니다.
현재는 PostgreSQL 쪽은 prepare -> restore -> verify 흐름을 만들었고, OpenBao는 raft snapshot backup/restore helper를 정리하는 중입니다.
4. 계정과 권한은 나중에 좁히기보다 처음부터 좁게 가는 편이 낫다
처음에는 넓은 Object Storage 권한으로 빨리 붙이고 싶을 수 있습니다. 하지만 운영 백업 계정은 특히 민감합니다.
현재는 DB backup, observability, Banjang vault, OpenBao backup을 각각 별도 SubAccount와 bucket scoped policy로 분리하는 방향을 잡았습니다.
5. 문서도 IaC의 일부다
Terraform과 Ansible 코드만으로는 운영자가 “왜 이렇게 되어 있는지”를 알기 어렵습니다. 그래서 README, recovery guide, cutover guide, access guide를 계속 보강했습니다.
문서는 나중에 따로 쓰는 것이 아니라, 구조가 바뀔 때 같이 바뀌어야 했습니다. 실제로 복구 리허설을 하면서 runbook도 여러 번 고쳤습니다.
아직 남아 있는 과제
현재 구조가 완성형이라고 보지는 않습니다. 아직 남은 과제도 분명합니다.
-
middleware VM을 single-node에서 HA 구조로 확장할 기준 정리
-
OpenBao restore 리허설 환경 분리
-
Object Storage lifecycle/retention 정책의 IaC화
-
NKS node autoscaling 또는 증설 기준 정리
-
PgBouncer 적용 범위 확대와 서비스별 검증 자동화
-
개발자/운영자 접근 계정의 개인화
-
민감 정보 관리 방식의 추가 정리
-
runbook과 실제 자동화 사이의 drift 제거
하지만 적어도 지금은 “어디서 무엇을 관리하는가”가 이전보다 훨씬 명확해졌습니다. 그리고 문제가 생겼을 때 어느 stack, 어느 playbook, 어느 workload 정의를 봐야 하는지 추적하기 쉬워졌습니다.
마무리
이번 작업을 하면서 IaC에 대한 생각이 조금 바뀌었습니다.
처음에는 IaC를 “Terraform으로 인프라를 만드는 것” 정도로 생각하기 쉽습니다. 하지만 운영 환경에서는 그것만으로 충분하지 않습니다.
IaC는 결국 운영 지식을 구조화하는 과정에 가깝습니다.
-
어떤 리소스가 존재해야 하는지
-
누가 그 리소스의 소유자인지
-
어떤 순서로 만들어야 하는지
-
어디까지 자동화하고 어디서 승인해야 하는지
-
장애가 났을 때 무엇으로 복구할지
-
복구가 실제로 되는지 어떻게 증명할지
이 질문에 답하는 코드와 문서가 함께 있어야 운영 가능한 IaC가 됩니다.
Terraform은 인프라의 뼈대를 만들었습니다. Ansible은 VM 내부 운영 구성을 반복 가능하게 했습니다. workload bootstrap은 managed PostgreSQL 내부 상태를 선언적으로 맞췄습니다. GitOps는 Kubernetes 애플리케이션 상태를 지속적으로 맞추는 기준이 되었습니다. 그리고 backup/recovery runbook은 “장애가 났을 때 정말 돌아올 수 있는가”를 확인하는 안전망이 되었습니다.
아직 개선할 부분은 많습니다. 그래도 self-hosted 중심 구조에서 managed 중심 구조로 옮겨오면서, 단순히 클라우드 리소스를 만든 것이 아니라 운영 책임을 나누고, 변경 반경을 줄이고, 복구 가능한 구조로 한 걸음 나아갔다고 생각합니다.
완성보다는 계속 다듬어가는 과정에 가깝습니다. 하지만 그 과정에서 얻은 가장 큰 교훈은 분명합니다.
좋은 IaC는 apply가 잘 되는 코드가 아니라, 운영자가 안심하고 변경할 수 있는 구조다.
Andy