
最近インフラについて語るとき、「IaC(Infrastructure as Code)」という言葉はすっかり身近なものになりました。Terraformでクラウドリソースを作成し、Ansibleでサーバー設定を自動化し、KubernetesとGitOpsでアプリケーションのデプロイを管理する方法は、もはや特別な技術というより、運用の基本に近いものになっています。
しかし、実際の運用環境を構成してみると、IaCは単に「コードでインフラを作る」という段階で終わりません。むしろ重要な問いは、その先から始まります。
-
何をTerraformに担わせるべきなのか?
-
何をAnsibleに担わせるべきなのか?
-
Managed Serviceが提供する領域と、私たちが直接運用すべき領域の境界はどこなのか?
-
運用中に変更が発生したとき、既存のリソースを安全に維持しながら、どのように拡張するのか?
-
バックアップと復旧は、「設定されている」だけでなく、「実際に復旧可能である」ことまで確認できているのか?
今回の記事は、Naver Cloud環境で運用向けshared platformをmanagedベースで構成しながら整理した経験談です。VMベースで運用していた既存の構成をそのまま捨てるのではなく、必要な部分は維持しつつ、KubernetesとPostgreSQLはmanaged serviceへ移行し、Terraform、Ansible、一部のAPIベースの自動化を組み合わせて、運用可能な構成へ作り上げていった過程です。
最初から完璧な構成を作れたわけではありません。むしろ進める中で、「この責任はここに置くべきではない」、「この設定は広すぎる」、「復旧手順は文書にあるだけで、実際の検証ができていない」といった問題に何度も直面し、そのたびに構成を少しずつ整えていきました。この記事は、そうした試行錯誤も含め、現時点での構成と考え方を整理した記録です。
なぜ新しいmanaged platformを作ったのか
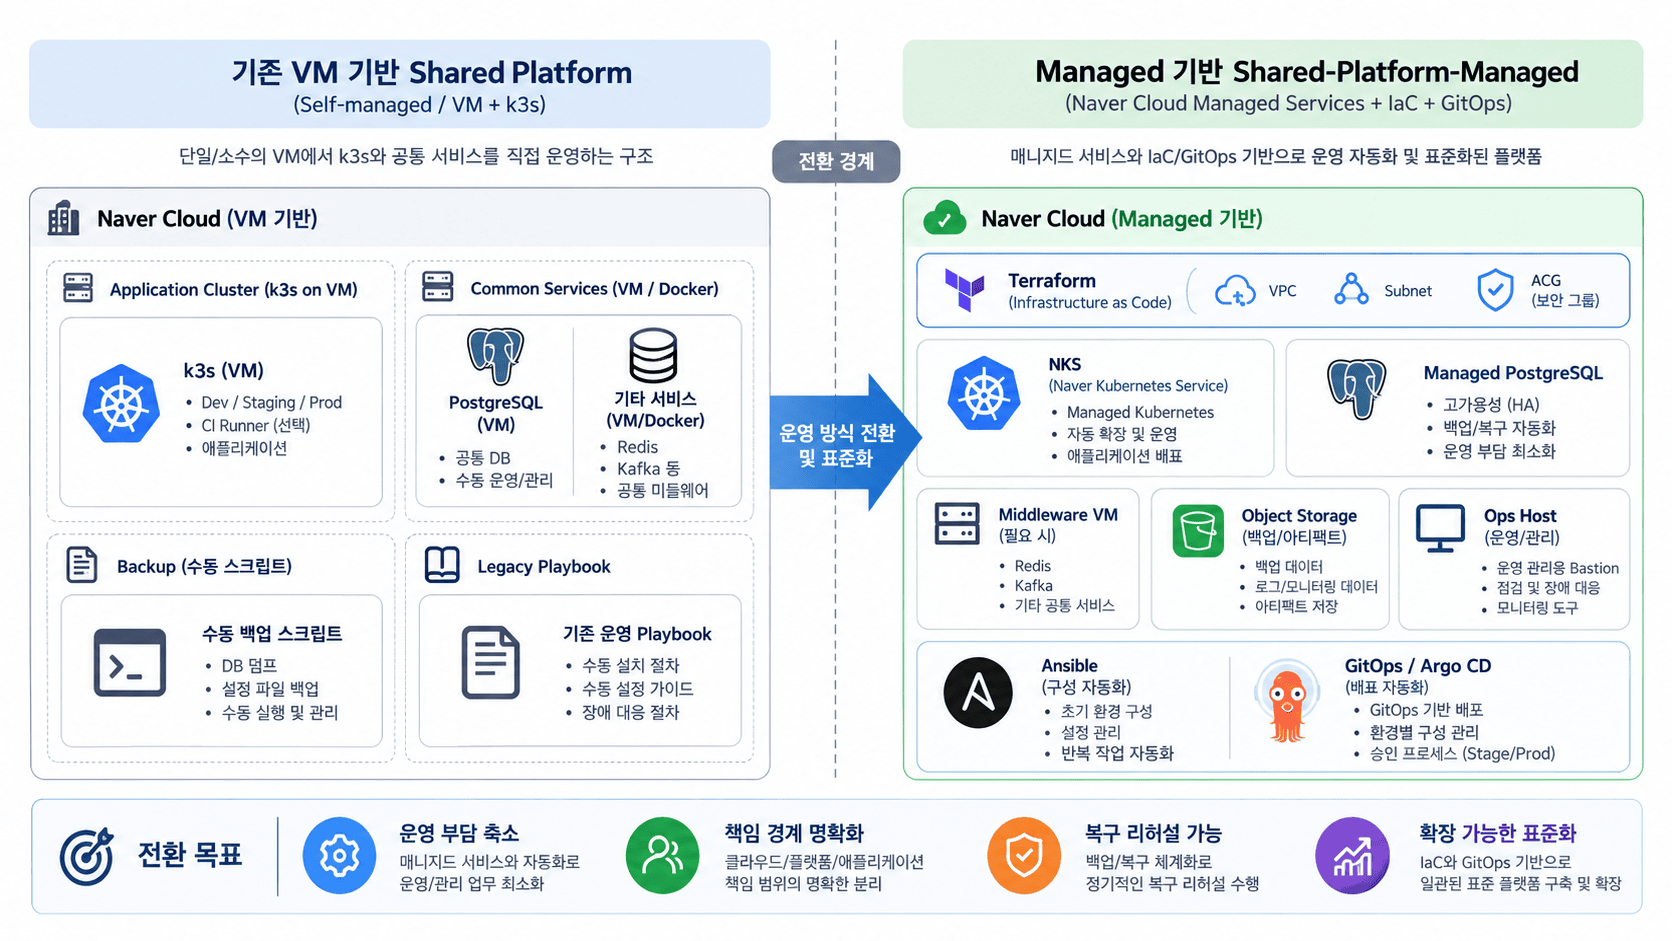
以前は、VMベースでKubernetesとPostgreSQLを直接構成する方式を採用していました。この方式には、制御できる範囲が広く、慣れているという利点があります。VMに直接ログインして設定を確認し、PostgreSQL superuserに近い権限でroleやdatabaseを扱い、必要なバックアップスクリプトも比較的簡単に作成できます。
しかし、運用環境が大きくなるほど、直接運用しなければならない領域が次第に負担になります。
-
Kubernetes control planeの運用負担
-
PostgreSQL VMのパッチ適用、障害、バックアップ、復旧に関する責任
-
ノードの増設とネットワーク構成を手動判断に依存する問題
-
運用担当者のアクセス、権限、監査追跡の複雑さ
-
復旧リハーサルを繰り返しにくい構成
そこで、方針をmanaged中心へと変更しました。
-
KubernetesはNaver Kubernetes Service(NKS)
-
PostgreSQLはCloud DB for PostgreSQL
-
共通のアクセス地点はops host
-
Redis、Kafka、OpenBaoなどのmiddlewareは、まずVMベースのDocker Composeで開始
-
インフラリソースはTerraform stackで管理
-
VM内部の運用構成はAnsible playbookで管理
-
アプリケーションのデプロイはGitOpsのフローとして分離
重要なのは、「すべてをmanagedに変えよう」ということではありませんでした。むしろ現実的な目標は、「どこまでをmanaged serviceに任せ、どこからを私たちが運用自動化によって責任を持つのかを明確に分けよう」ということでした。
最初に定めた原則
進める中で最も振り返ることが多かったのは、ツールそのものではなく責任の境界でした。Terraform、Ansible、GitOps、Managed Serviceはいずれも優れたツールですが、境界が曖昧になると、かえって運用が難しくなります。
そこで、以下の原則を定めました。
-
クラウドリソースのライフサイクルはTerraformが担う。
-
VM内部の運用構成はAnsibleが担う。
-
KubernetesアプリケーションのデプロイはGitOpsが担う。
-
Managed PostgreSQL内部のdatabase、user、schema、grantは、workload単位で分離する。
-
バックアップは設定だけで終わらせず、restoreとverifyまで含める。
-
アクセス権限はアカウント単位で分離し、broad policyは減らす。
-
運用変更はまずplanとdiffを確認し、実際のapplyは意図した変更だけが残った時点で実行する。
この原則は単純に見えますが、実際には何度も試されることになりました。たとえばmanaged PostgreSQLでDB userをTerraform resourceとして作成することはできましたが、運用中にuserが増える状況では、providerが全体置換のようなplanを作成してしまう問題がありました。この場合、「すべてTerraformで行う」という原則に固執すると、かえって危険になります。
最終的に、database自体はTerraformで管理しつつ、managed PostgreSQL userはNaver Cloud公式APIを基盤として増分作成し、schema/grant/default privilegeはAnsibleとSQL bootstrapで管理する構成に分けました。IaCだからといって、すべてを1つのツールに無理やり押し込むのではなく、状態と変更の性質に合ったツールを選ぶことのほうが重要でした。
Terraform stackを分けた理由
Terraformでは、全体を1つの巨大なroot moduleで管理することもできます。しかし、運用環境ではstackを細かく分けるほうが安全でした。
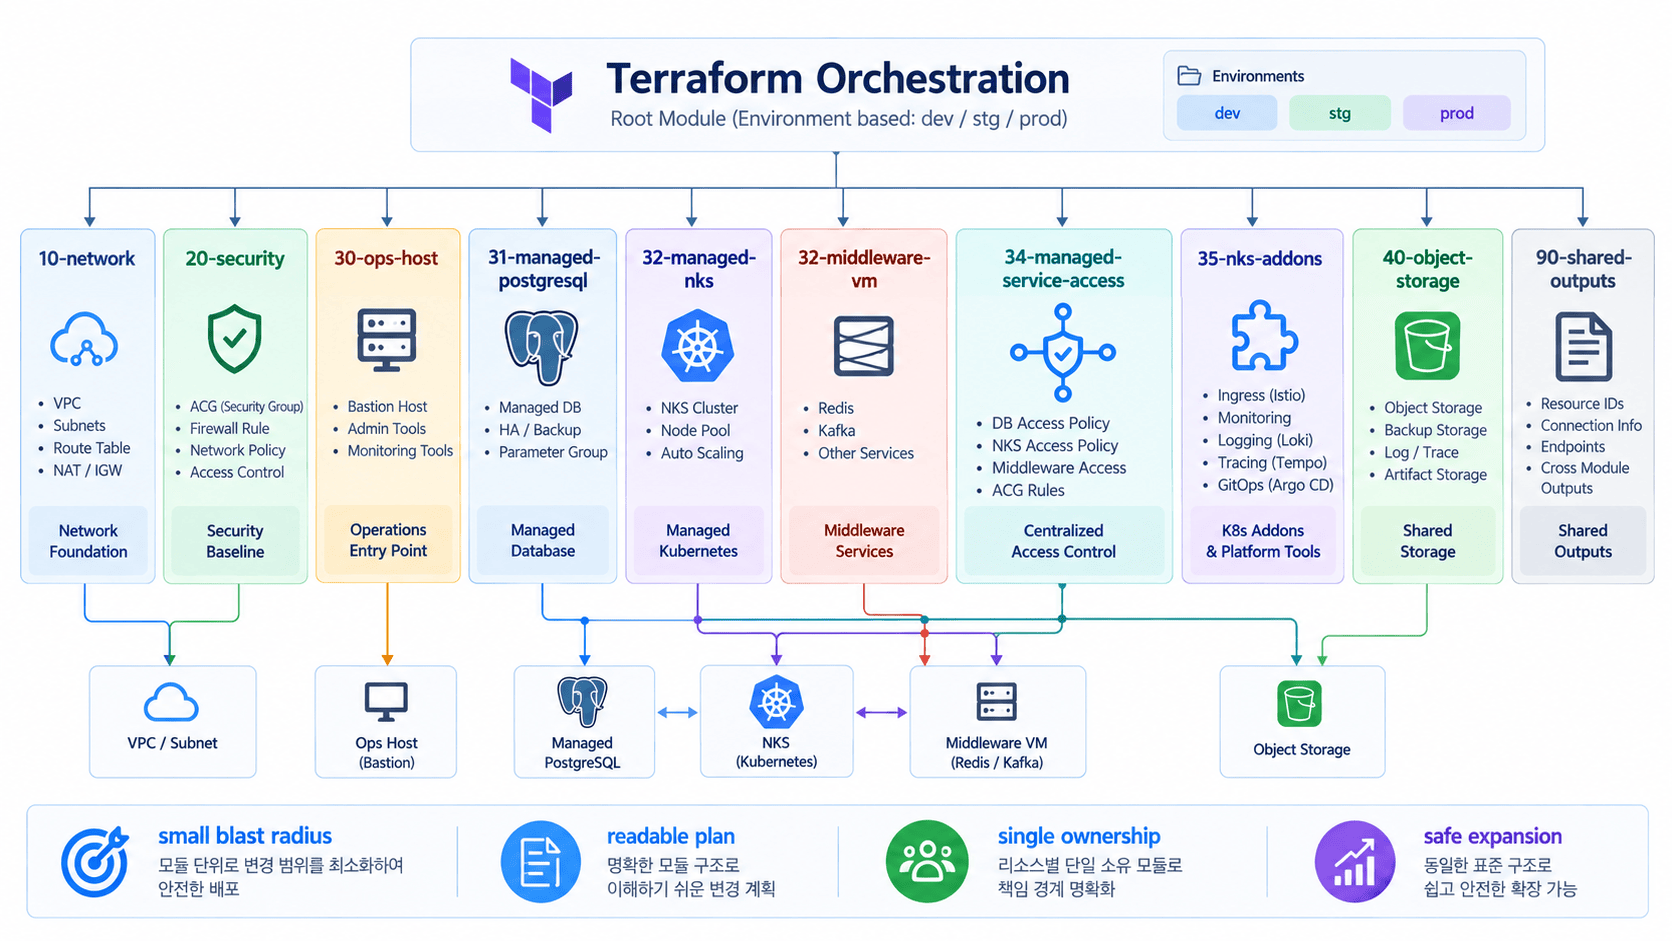
現在の構成は、おおむね次のようになっています。
shared-platform-managed/
└── terraform/
    ├── 10-network/
    ├── 20-security/
    ├── 30-compute-ops-host/
    ├── 31-managed-postgresql/
    ├── 32-managed-nks/
    ├── 33-compute-middleware-vm/
    ├── 34-managed-service-access/
    ├── 35-nks-addons/
    ├── 40-object-storage/
    └── 90-shared-outputs/
各stackにはそれぞれ異なる責任があります。
-
10-network: VPC、subnet、route、NAT gateway
-
20-security: ACGと基本的なセキュリティ境界
-
30-compute-ops-host: 運用の入口となるops host
-
31-managed-postgresql: Cloud DB for PostgreSQLインスタンス
-
32-managed-nks: NKS clusterとnode pool
-
33-compute-middleware-vm: Redis、Kafka、OpenBaoなどのためのmiddleware VM
-
34-managed-service-access: NKS、middleware、managed DB間のアクセスルール
-
35-nks-addons: NKS CSI add-onなどのcluster add-on
-
40-object-storage: DB backup、observability、OpenBao backupなどのバケット
-
90-shared-outputs: 他のstackのoutputを1か所で確認するためのsummary stack
このように分けると、適用順序が長くなるというデメリットがあります。しかし運用環境では、そのデメリットを上回るメリットがありました。
例えば、ノードプールを増やす作業を行う際に、networkやDBがplanに一緒に混ざっていると不安になります。Object Storageのバケットを1つ追加する作業でNKSやPostgreSQLの変更まで表示されたら、作業を止めるべきです。stackを分けると変更範囲が小さくなり、planを読み取る負担も減ります。
もう1つ重要なのは「単一の所有者」です。例えばmanaged PostgreSQL自体は31-managed-postgresqlが作成しますが、実際のサービスアクセス用ACGルールは34-managed-service-accessが単一の所有者となるよう整理しました。DB stackとNKS stackがそれぞれアクセスルールを変更し始めると、driftや競合が発生しやすいためです。
ネットワークは広く作り、アクセスは狭く設定する
最初はsubnetが多く見えました。public subnet、NAT gateway subnet、LB subnet、k8s subnet、DB subnet、middleware subnetまで分けると、過剰な設計のように感じるかもしれません。
しかし運用環境では、名前と用途を分けておくほうが、後になってはるかに扱いやすくなりました。
例えば次のような形です。
-
public: ops host、NAT gateway、public LB
-
private: NKS worker node、DB、middleware VM、private LB
-
zone分散: KR-1、KR-2を考慮したsubnet分割
もちろん、すべてのsubnetを最初から複雑なHA構成で使うわけではありません。middleware VMも最初は1台から始めました。しかし後になってOpenBao、Kafka、Redisを3台に拡張したり、DBをHA/multi-zoneに変更したりする際に、ネットワークの名前と用途がすでに分離されていれば、はるかに安全に対応できます。
ここで感じたのは、subnet設計を現在の状況だけを見て単純化しすぎると、後から再び手を入れるのが難しくなるということです。一方で、最初からすべてを過度に自動化する必要もありません。重要なのは、「今はシンプルに使いながら、後で拡張できる名前と境界から始めること」でした。
Managed NKS: 直接運用しなくても設計責任は残る
NKSを使用すると、Kubernetes control planeの運用負担は軽減されます。しかし、だからといってKubernetesの運用設計がなくなるわけではありません。
現在の構成では、KVMベースのregional cluster方針を基準とし、node poolをzone単位で分離しました。例えばshared-a、shared-bのようにzoneを分け、同じスペックのworker nodeを均衡よく増やす方式です。
運用中は、次のような悩みが継続的に発生します。
-
現在のノードメモリ使用率は十分か?
-
Podを冗長化する前に、まずノードを増やすべきか?
-
ノードが1台NotReadyになったとき、Terraform stateとコンソールの状態は一致しているか?
-
PVCが必要なworkloadを起動する前に、CSI add-onは有効化されているか?
-
LBタイプの変更やPROXY protocolの設定が、既存のingressに影響を与えるか?
特に実際の運用では、「ノードを1台追加する」ことも単純な作業ではありません。Terraform planで本当にnode_countだけが変更されるのか、ACGやLBなど他のリソースが変更されないのかを確認する必要があります。planが意図と異なる場合は、applyを止めるべきです。
この経験を通じて、IaCのメリットは「自動的にapplyする」ことではなく、「適用前に何が変更されるのかを正確に確認できる」ことにより近いと感じました。
Managed PostgreSQLから最も多く学んだこと
最も試行錯誤が多かったのはmanaged PostgreSQLでした。
self-hosted PostgreSQLでは自然に行っていた作業が、managed PostgreSQLではできないことが多くありました。
-
superuser権限がない。
-
pg_authidを直接参照できない。
-
globals dumpをそのまま使用するのが難しい。
-
extension ownerがサービスroleと異なる。
-
postgisやpgvectorなどのextensionのインストール方式がproviderのポリシーに従う。
-
DB userの作成も、SQL CREATE ROLEではなく、Naver Cloudの公式管理経路を通す必要がある場合がある。
最初は、既存のVMベースのbootstrap SQLをそのまま持ってくればよいと思っていました。しかし、実際はそうではありませんでした。databaseの作成、userの作成、schemaの作成、grantの付与、extensionの確認、backup/restoreをそれぞれ分離する必要がありました。
現在はworkloadごとに次のような構成にしています。
shared-platform-managed/
└── workloads/
    ├── devlime-managed/
    ├── banjang-managed/
    └── spicedb-managed/
各workloadは次の責任を担います。
-
Terraformでworkload databaseを作成
-
Naver Cloud公式APIで必要なDB userを追加的に保証
-
Ansibleでschema、grant、default privilegeを整合させる
-
サービスごとのschema namingとrole namingを明示
-
必要なextensionのpreflightを実行
例えばdevlimeでは、devlime_prdという1つのDB内で、devlime、vizend、modlime系列のschemaとroleをまとめて管理します。banjangでも、banjang_prd内でbanjang、vizend、modlime系列を分けて定義します。
この方式のメリットは、「DBは1つでも責任を宣言的に分離」できる点です。一方で、最初の定義が少し冗長になるというデメリットがあります。しかし運用中にサービスが増えたり、roleの権限が不足したりした場合に、どこを修正すべきかが明確になるメリットのほうが大きくなりました。
PgBouncerとsearch_pathの問題
運用DBのconnection数を考慮し、PgBouncerも構成しました。サービスが直接PostgreSQLに接続するのではなく、PgBouncerを介してconnection poolを共有する構成です。
この過程でも予期しない問題がありました。一部のサービスはJDBC URLのcurrentSchemaを通じてschemaを指定していましたが、PgBouncerはstartup parameterとして渡されるsearch_pathをそのまま処理しない構成になっていました。ignore_startup_parametersにsearch_pathが含まれていたためです。
最初は、PgBouncerの設定からsearch_pathの無視を削除すればよいように見えました。しかし、すべてのサービスの接続に影響する可能性があり、運用中に共通のPgBouncer設定を変更するのは危険でした。
最終的に、より安全な方法は、DB roleにdatabaseごとのデフォルトsearch_pathを設定することでした。
-
サービスroleは自分のschemaを最初に参照する。
-
managed PostgreSQLでは、extensionが配置されているschemaもsearch_pathに含める。
-
PgBouncerを経由する場合でも、roleのデフォルト値によってschema resolutionが安定する。
この経験から、「アプリケーションURLにある設定」と「DB role自体のデフォルト設定」のどちらを運用基準にするかを改めて考えるようになりました。運用では、接続経路が変わっても維持される設定、つまりDB roleレベルのデフォルト値のほうが安定するケースが多くありました。
バックアップとはdumpファイルではなく、復元可能性までを含むもの
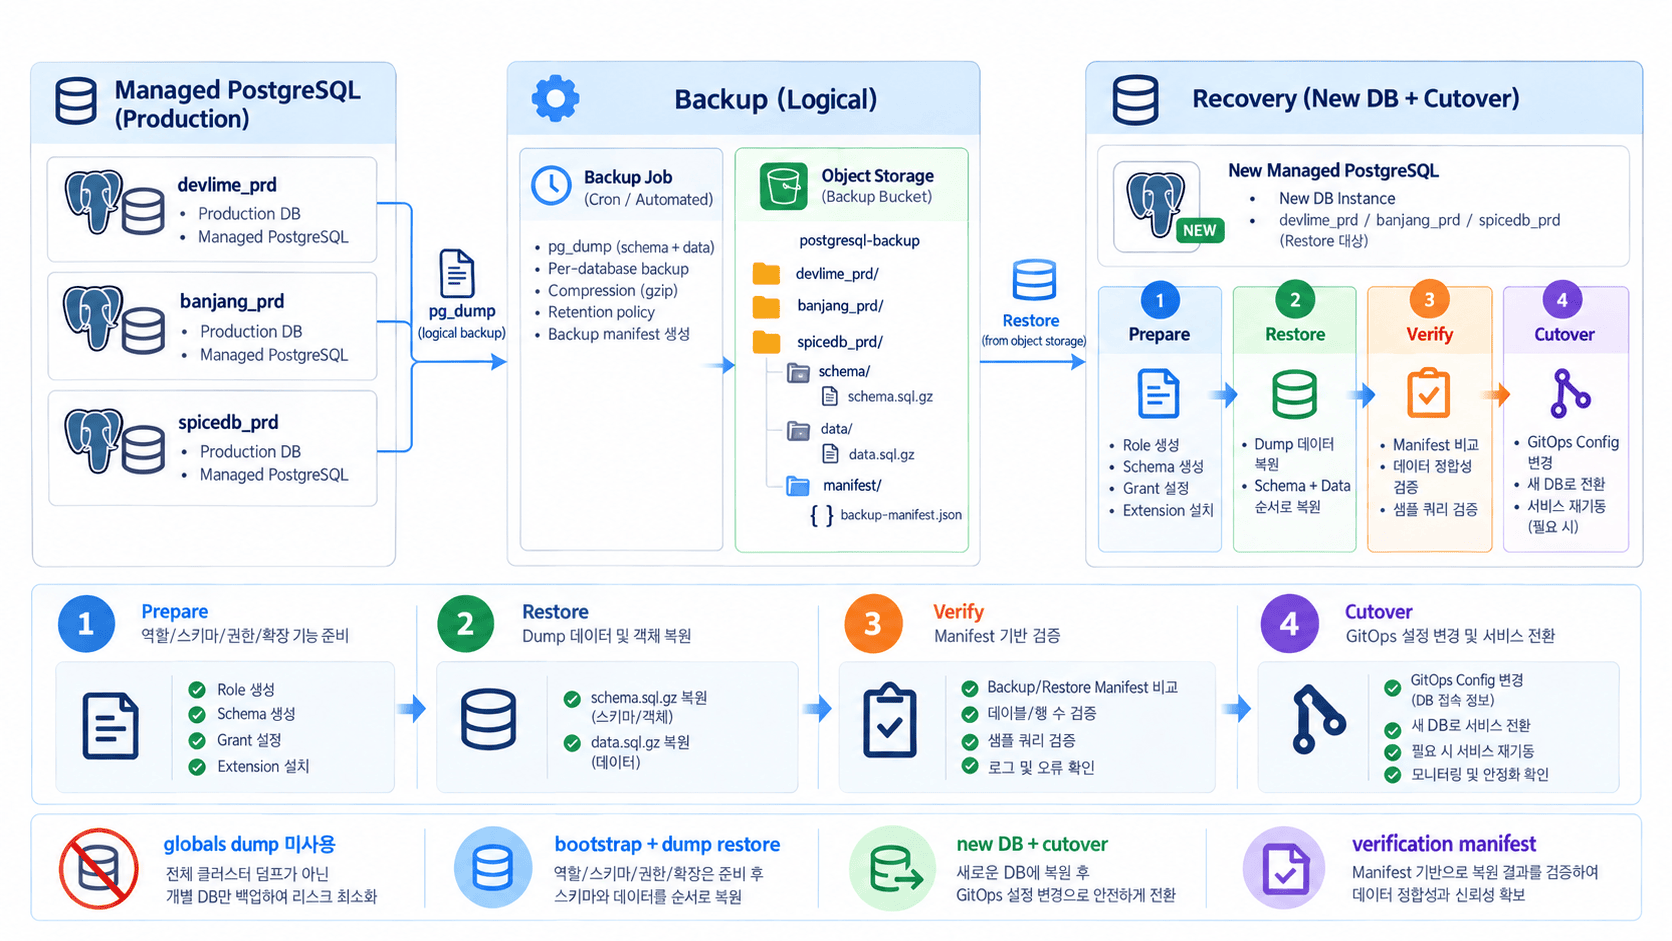
バックアップについても多くの試行錯誤がありました。特にmanaged PostgreSQLではglobals dumpをそのまま信頼するのが難しいため、バックアップと復元の境界を改めて定義する必要がありました。
現在の基準は次のとおりです。
-
managed PostgreSQLインスタンス自体には、Naver Cloudの自動バックアップを使用する。
-
別途、workload DB単位のlogical backupも実行する。
-
globals dumpはデフォルトでは使用しない。
-
role、schema、grant、extensionの準備はbootstrapが担当する。
-
dump restoreは、データと一般オブジェクトの復元を担当する。
-
restore後にverification manifestでschema/table/row countを比較する。
最初は「バックアップファイルがobject storageにアップロードされれば十分なのではないか」と考えがちです。しかし、実際に復元してみると、そうではありません。
復元では、次の質問に答えられなければなりません。
-
新しいDBを作成できるか?
-
userとschemaの権限を再び適切に設定できるか?
-
extensionの競合なしにrestoreできるか?
-
dump内のschema DDLとmanaged DBのprovider-managed schemaが競合しないか?
-
復元後にrow countやschema countを検証できるか?
-
実際のサービスが新しいDBを参照するようにcutoverできるか?
そのため、recovery stackもworkloadから分離しました。
shared-platform-managed/
└── recovery/
    ├── devlime-managed/
    └── banjang-managed/
運用DB stackにrecovery DBを一時的に組み込む方法は危険でした。実際、managed PostgreSQL providerの特性上、database一覧の変更がreplacementのように扱われる状況もありました。そのため、recoveryは別のstackに分離し、rehearsal DBとincident cutover DBのnaming規則も別途整理しました。
基本的な復元戦略はnew DB + cutoverです。運用DBを直接cleanしてrestoreする方法よりも、新しいDBに復元して検証した後、アプリケーションの接続先を切り替えるほうが安全です。
OpenBaoのバックアップはPostgreSQLのバックアップよりも慎重な扱いが必要
middleware VMには、OpenBao、Kafka、RedisなどのソリューションをDocker Composeベースで構築する構成にしました。現在はsingle-nodeで始めていますが、将来重要度が高まった場合に3台へ拡張したり、managedの代替サービスへ移行したりできるよう、境界を開けてあります。
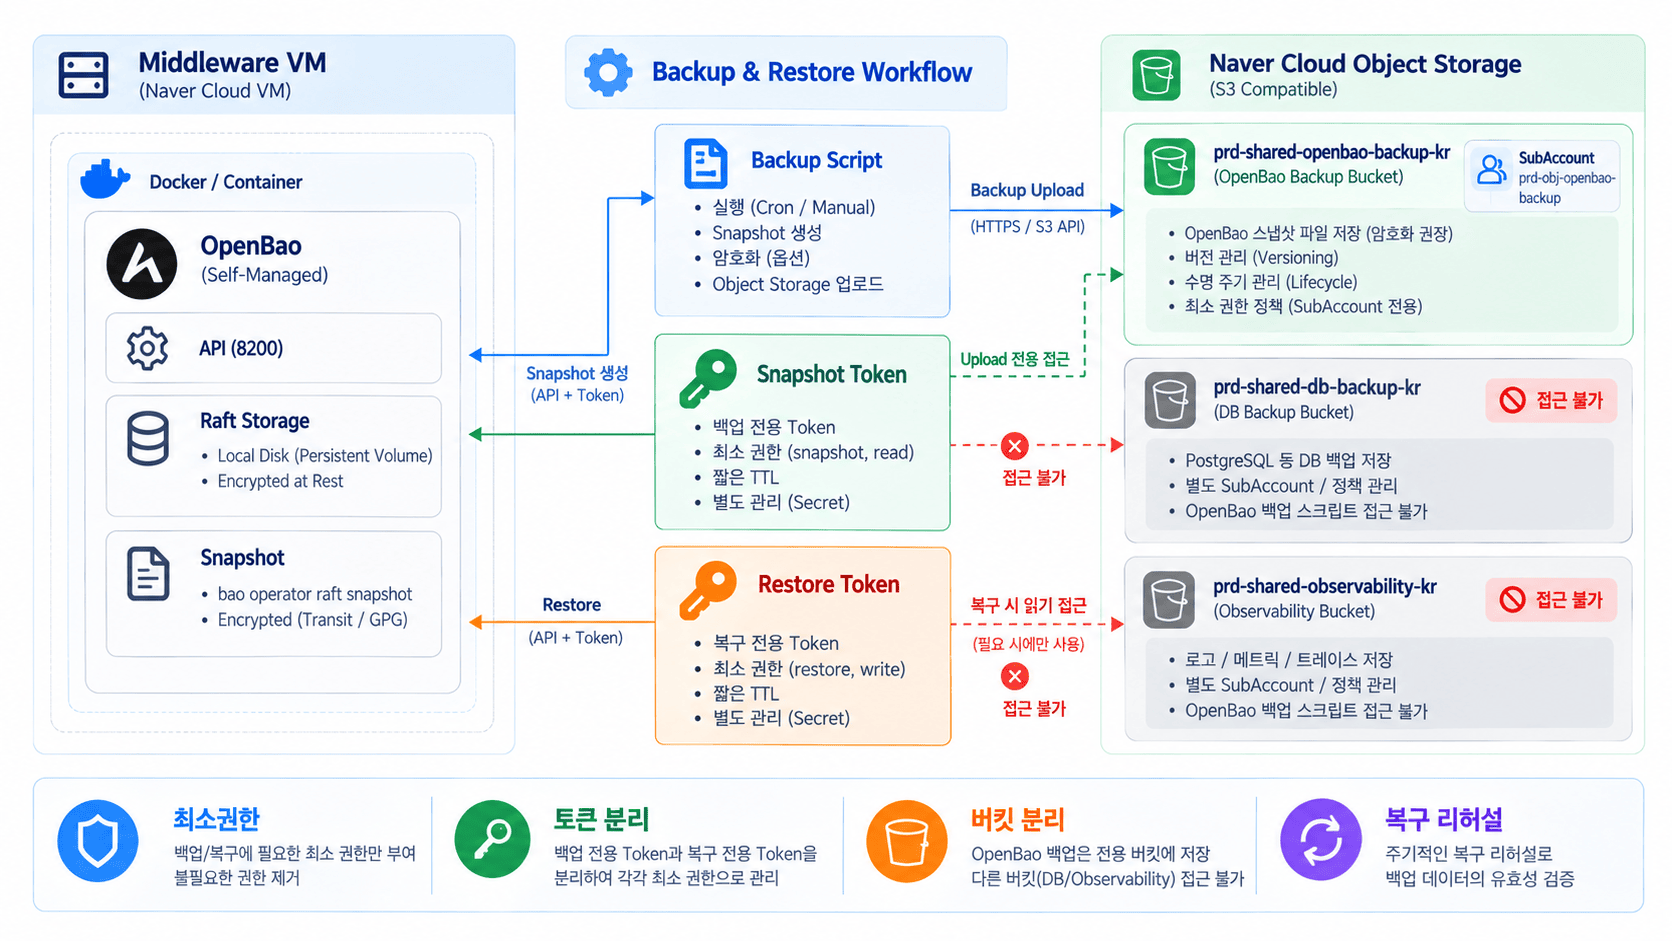
その中でも、OpenBaoは特にバックアップの観点が重要でした。OpenBaoは単なるアプリケーションではなくsecret storeです。そのため、PostgreSQL logical backupと同じバケット、同じアカウント、同じ権限で混在させるのは適切ではありませんでした。
現在の方針は次のとおりです。
-
OpenBao raft snapshot専用のObject Storage bucketを使用する
-
OpenBao backup専用のSubAccountを使用する
-
DB backupアカウントから分離する
-
snapshot tokenとrestore tokenを分離する
-
平常時はrestore tokenを空にしておく
-
restoreは稼働中のOpenBaoに直接行わず、別途リハーサルまたは点検時間に実施する
この過程でaccess管理も別途整理しました。Naver Cloud Terraform providerでは、SubAccount、policy assignment、access keyまで十分に扱えない領域があるため、accessctl.pyという補助スクリプトを作成しました。
このスクリプトでは、次の項目を管理します。
-
SubAccount desired state
-
user-created policy
-
bucket scoped permission
-
policy assignment
-
access keyの生成
-
既存のbroad policyを削除する計画
ここでも重要な教訓がありました。Object Storage bucket policyは単にbucket nameだけで照合されるのではなく、Resource Manager NRNが必要でした。そのため、bucket名を指定するとResource Manager APIで正確なbucket NRNを照会し、policyに反映するよう強化しました。
運用権限は「動作させること」よりも、「必要な範囲だけ動作させること」のほうが重要です。特にバックアップアカウントは、すべてのバケットにアクセスするのではなく、自分のバケットだけにアクセスできなければなりません。
Ansibleは「サーバー設定の自動化」よりも、運用手順の文書化に近い
Ansibleは、パッケージのインストールやファイルのコピーだけを行うツールのように見えるかもしれません。しかし今回の作業では、Ansible playbookが運用手順をコード化する役割を果たしました。
例えば、ops hostでは次のものを準備します。
-
kubectl
-
helm
-
ncp-iam-authenticator
-
kubeconfig生成helper
-
managed PostgreSQL 接続ヘルパー
-
PostgreSQL 論理バックアップサービス/タイマー
middleware VM は次のものを準備します。
-
Docker Engine
-
Docker Compose plugin
-
OpenBao compose/service
-
Kafka compose/service
-
Redis compose/service
-
backup script scaffold
-
OpenBao init/unseal helper
特に wrapper script が役立ちました。playbook に従って root mode で実行すべきものと ops mode で実行すべきものが異なります。そのため、run-playbook.sh が現在の inventory の ansible_user を確認し、適切でない場合は実行を拒否するようにしました。
このような小さなガードレールが、実際の運用では重要です。誤ったユーザーで playbook を実行すると、途中まで適用されたり、権限が混乱したりする可能性があります。IaC は自動化であるため、むしろ小さなミスを速やかに大きな問題へ拡大させることがあります。そのため、「実行前に拒否」できる構造が必要でした。
GitOps と IaC の関係
Terraform と Ansible があるからといって、GitOps が不要になるわけではありません。むしろ、それぞれの責任が異なります。
-
Terraform: クラウドリソースのライフサイクル
-
Ansible: VM 内部の運用構成と bootstrap
-
GitOps: Kubernetes リソースの desired state
-
workload bootstrap: DB 内部構造の整合
例えば、アプリケーションの replica を増やしたり、PgBouncer の接続 URL を反映したり、Ingress/LB の設定を変更したりする作業は GitOps の領域です。一方、NKS node pool を増やす作業は Terraform の領域です。managed PostgreSQL の user と schema の権限を整合させる作業は workload bootstrap の領域です。
この境界を区別しておかないと、運用中に問題が発生した際、「どこを修正すべきか」が曖昧になります。実際、何度か境界が曖昧で、改めて整理したことがありました。workloads を shared-platform-managed 配下に移したのも、その理由の一つです。現在の構造では、workload が現在の managed platform に依存しているという事実が、パスからも分かります。
現在の構造を一文で要約すると
現在の構造は、次の一文で要約できます。
Terraform でクラウドリソースの基準線を作り、Ansible で運用のエントリーポイントと VM 内部の構成を準備し、workload ごとの bootstrap で managed PostgreSQL 内部の状態を整合させ、GitOps で Kubernetes アプリケーションの desired state を管理する。
もう少し詳しく説明すると、次のようになります。
-
shared-platform-managed/terraform: ネットワーク、セキュリティ、NKS、PostgreSQL、middleware VM、Object Storage
-
shared-platform-managed/ansible: ops host、NKS ツール、DB 接続/バックアップ、middleware VM 構成
-
shared-platform-managed/workloads: devlime、banjang、spicedb の DB/schema/role/grant
-
shared-platform-managed/recovery: 復旧リハーサルと new DB + cutover の準備
-
shared-platform-managed/access: Object Storage SubAccount と least-privilege policy
-
別の GitOps リポジトリ: 実際の Kubernetes app/infra manifests
この構造の利点は、各段階が比較的明確であることです。欠点は、初めて見る人にはディレクトリが多く見えることです。そのため、ドキュメントと runbook が同じように重要になりました。
運用していて、特に重要だと感じたチェックポイント
1. Terraform plan は「適用前の説明書」である
plan は単なる apply 前の段階ではありません。運用者にとっては変更内容の説明書です。意図したリソース以外の変更が表示された場合は、停止すべきです。
Object Storage bucket を一つ追加するだけなのに、既存の policy 3 つが update として表示されたことがありました。実際の権限に差はなく、API が condition: {} を付けて返していたために発生した比較上の誤検知でした。このような場合は、apply する前に比較ロジックを修正するのが正しい対応です。
2. Managed Service は責任がなくなるのではなく、責任の内容が変わる
NKS を使用すると、control plane の運用は減ります。しかし、node pool、add-on、ingress、storage class、resource pressure の管理は依然として必要です。
Managed PostgreSQL を使用すると、エンジンの運用は減ります。しかし、role、schema、extension、backup/restore 戦略は、むしろより明示的に設計する必要があります。
3. Backup は必ず restore と verify までつなげる
バックアップファイルがあるからといって、復旧できるとは限りません。managed PostgreSQL には globals dump の制約があり、OpenBao では snapshot token と restore token が異なり、Object Storage の権限も専用に管理する必要があります。
現在、PostgreSQL 側では prepare -> restore -> verify の流れを作成し、OpenBao では raft snapshot backup/restore helper を整理しているところです。
4. アカウントと権限は、後から狭めるより最初から狭くしておく方がよい
最初は広い Object Storage 権限ですぐに接続したくなるかもしれません。しかし、運用バックアップ用のアカウントは特に慎重に扱う必要があります。
現在は、DB backup、observability、Banjang vault、OpenBao backup を、それぞれ別の SubAccount と bucket scoped policy に分離する方針にしています。
5. ドキュメントも IaC の一部である
Terraform と Ansible のコードだけでは、運用者が「なぜこのようになっているのか」を理解するのは困難です。そのため、README、recovery guide、cutover guide、access guide を継続的に補強してきました。
ドキュメントは後から別途作成するものではなく、構造が変わるときに一緒に変更されるべきでした。実際、復旧リハーサルを行う中で、runbook も何度も修正しました。
まだ残っている課題
現在の構造が完成形だとは考えていません。まだ残っている課題も明確にあります。
-
middleware VM を single-node から HA 構造へ拡張するための基準整理
-
OpenBao リストアのリハーサル環境の分離
-
Object Storage の lifecycle/retention ポリシーの IaC 化
-
NKS node autoscaling または増設基準の整理
-
PgBouncer の適用範囲拡大とサービスごとの検証自動化
-
開発者/運用者アクセスアカウントの個別化
-
機密情報の管理方法の追加整理
-
runbook と実際の自動化との間の drift の解消
しかし、少なくとも今は、「どこで何を管理しているのか」が以前よりはるかに明確になりました。そして問題が発生したときに、どの stack、どの playbook、どの workload 定義を確認すべきか追跡しやすくなりました。
まとめ
今回の作業を通じて、IaC に対する考え方が少し変わりました。
最初は、IaC を「Terraform でインフラを構築すること」程度に考えがちです。しかし、運用環境ではそれだけでは十分ではありません。
IaC は結局のところ、運用知識を構造化するプロセスに近いものです。
-
どのリソースが存在すべきか
-
誰がそのリソースの所有者なのか
-
どの順序で作成すべきか
-
どこまで自動化し、どこで承認すべきか
-
障害が発生したとき、何を使って復旧するのか
-
復旧が実際に可能であることを、どのように証明するのか
これらの問いに答えるコードとドキュメントがそろって初めて、運用可能な IaC になります。
Terraform はインフラの骨格を作りました。Ansible は VM 内部の運用設定を再現可能にしました。workload bootstrap は managed PostgreSQL 内部の状態を宣言的に整えました。GitOps は Kubernetes アプリケーションの状態を継続的に整合させる基準となりました。そして backup/recovery runbook は、「障害が発生したときに本当に復旧できるのか」を確認する安全網となりました。
まだ改善すべき点は多くあります。それでも self-hosted 中心の構成から managed 中心の構成へ移行することで、単にクラウドリソースを構築しただけでなく、運用責任を分担し、変更の影響範囲を縮小し、復旧可能な構成へ一歩前進できたと考えています。
完成を目指すというより、継続的に磨き上げていくプロセスに近いものです。しかし、その過程で得た最大の教訓は明確です。
優れた IaC とは、apply がうまく実行されるコードではなく、運用者が安心して変更できる構成である。
Andy