
В наши дни термин «IaC (Infrastructure as Code)» хорошо знаком всем, кто обсуждает инфраструктуру. Создание облачных ресурсов с помощью Terraform, автоматизация конфигурации серверов с помощью Ansible, а также управление развертыванием приложений с помощью Kubernetes и GitOps стали не столько специализированными технологиями, сколько базовой частью эксплуатации.
Однако при фактическом создании операционной среды IaC не ограничивается простым «созданием инфраструктуры с помощью кода». Напротив, именно после этого начинаются важные вопросы.
-
За что должен отвечать Terraform?
-
За что должен отвечать Ansible?
-
Где проходит граница между тем, что предоставляет Managed Service, и тем, чем нам необходимо управлять самостоятельно?
-
Когда во время эксплуатации происходит изменение, как расширить среду, безопасно сохранив существующие ресурсы?
-
Были ли резервное копирование и восстановление проверены не просто как «настроенные», а как «действительно пригодные для восстановления»?
В этой статье описывается наш практический опыт создания общей операционной платформы в среде Naver Cloud на основе управляемых сервисов. Мы не стали отказываться от существующей архитектуры на базе VM: сохранили необходимые части, перенесли Kubernetes и PostgreSQL на управляемые сервисы и объединили Terraform, Ansible и некоторую автоматизацию на основе API, чтобы построить структуру, пригодную для эксплуатации.
Мы не создавали идеальную структуру с самого начала. По мере работы мы неоднократно сталкивались с проблемами вроде «Эта ответственность не должна находиться здесь», «Эта настройка слишком широкая» и «Процедура восстановления существует только в документации и не была практически проверена». Каждый раз мы понемногу совершенствовали структуру. В этой статье описаны текущая структура и наши соображения, включая пройденные испытания и допущенные ошибки.
Зачем мы создавали новую управляемую платформу?
Ранее Kubernetes и PostgreSQL настраивались и эксплуатировались непосредственно на VM. Такой подход дает широкие возможности управления и хорошо знаком. Мы могли напрямую входить в VM для проверки ее конфигурации, управлять ролями и базами данных с привилегиями, близкими к привилегиям суперпользователя PostgreSQL, а также относительно просто писать необходимые скрипты резервного копирования.
Однако по мере роста операционной среды области, которыми необходимо управлять напрямую, становятся все более обременительными.
-
Нагрузка, связанная с эксплуатацией control plane Kubernetes
-
Ответственность за обновление VM PostgreSQL, устранение сбоев, резервное копирование и восстановление
-
Проблема зависимости от ручных решений при расширении узлов и настройке сети
-
Сложность управления доступом операторов, разрешениями и журналами аудита
-
Структура, затрудняющая регулярное проведение тренировок по восстановлению
Поэтому мы начали переходить к подходу, ориентированному на управляемые сервисы.
-
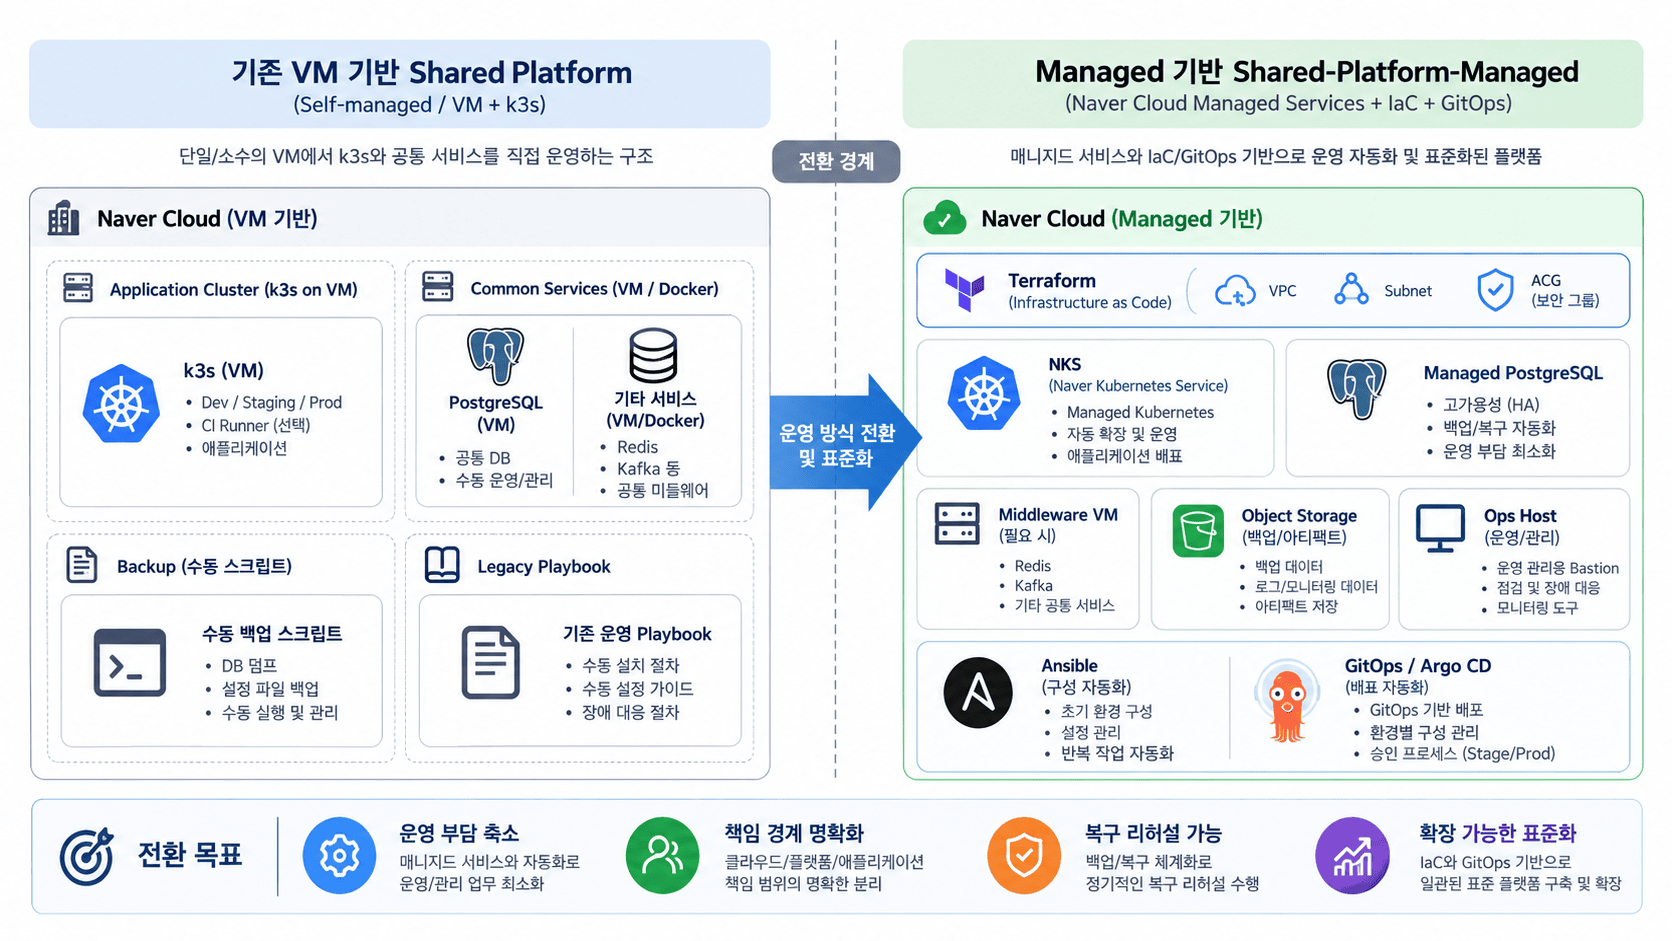
Kubernetes — это Naver Kubernetes Service (NKS)
-
PostgreSQL — это Cloud DB for PostgreSQL
-
Общей точкой доступа является ops host
-
Промежуточное ПО, такое как Redis, Kafka и OpenBao, первоначально запускается на VM с использованием Docker Compose
-
Инфраструктурными ресурсами управляют с помощью Terraform stack
-
Операционной конфигурацией внутри VM управляют с помощью Ansible playbook
-
Развертывание приложений выделено в отдельный рабочий процесс GitOps
Важно было не «перевести все на управляемые сервисы». Наша реалистичная цель заключалась в том, чтобы четко разделить, «до какой степени мы передаем ответственность управляемым сервисам и с какого момента берем ответственность на себя с помощью собственной операционной автоматизации».
Принципы, которые мы установили в первую очередь
В процессе мы чаще всего пересматривали не сами инструменты, а границы ответственности. Terraform, Ansible, GitOps и Managed Service — все это хорошие инструменты, но когда их границы становятся неясными, эксплуатация фактически усложняется.
Поэтому мы установили следующие принципы.
-
Terraform отвечает за жизненный цикл облачных ресурсов.
-
Ansible отвечает за операционную конфигурацию внутри VM.
-
GitOps отвечает за развертывание приложений Kubernetes.
-
В Managed PostgreSQL базы данных, пользователи, схемы и grant разделяются по рабочим нагрузкам.
-
Резервное копирование не заканчивается настройкой; оно включает восстановление и проверку.
-
Разрешения доступа разделяются между учетными записями, а широкое применение политик сводится к минимуму.
-
При внесении операционных изменений сначала следует проверить plan и diff, а фактический apply выполнять только тогда, когда среди оставшихся изменений находятся лишь запланированные изменения.
Эти принципы могут показаться простыми, но на практике им постоянно приходилось подвергаться проверке. Например, хотя в Managed PostgreSQL можно было создавать пользователей DB как ресурсы Terraform, при увеличении количества пользователей во время эксплуатации у провайдера возникала проблема: он планировал изменения так, будто весь набор необходимо заменить. В таком случае буквальное следование принципу «все должно делаться с помощью Terraform» фактически было бы опасным.
В итоге сами базы данных мы стали управлять с помощью Terraform, пользователей Managed PostgreSQL создавали постепенно через официальный API Naver Cloud, а управление схемами, grant и привилегиями по умолчанию разделили между Ansible и SQL bootstrap. Вместо того чтобы принудительно помещать все в один инструмент лишь потому, что это IaC, важнее было выбрать инструменты, соответствующие природе состояния и происходящих изменений.
Почему мы разделили Terraform stack
Terraform может управлять всем как одним огромным root module. Однако в операционной среде безопаснее было разделить stack на более мелкие единицы.
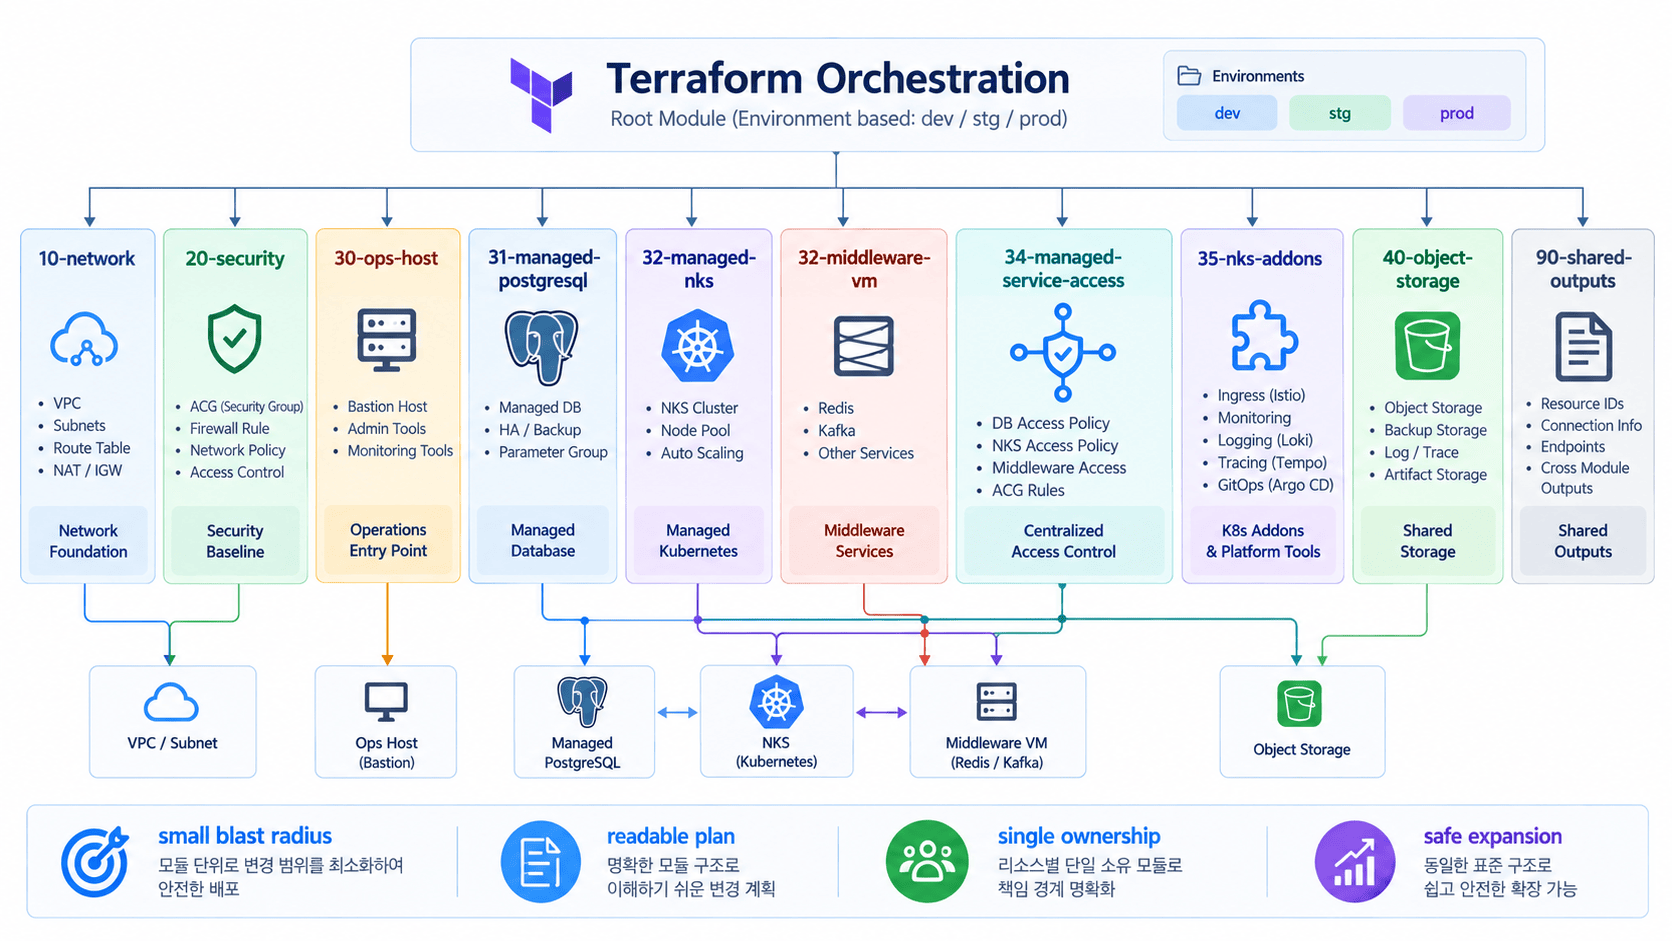
Текущая структура примерно выглядит следующим образом.
shared-platform-managed/
└── terraform/
    ├── 10-network/
    ├── 20-security/
    ├── 30-compute-ops-host/
    ├── 31-managed-postgresql/
    ├── 32-managed-nks/
    ├── 33-compute-middleware-vm/
    ├── 34-managed-service-access/
    ├── 35-nks-addons/
    ├── 40-object-storage/
    └── 90-shared-outputs/
Каждый stack отвечает за разные задачи.
-
10-network: VPC, subnet, route, NAT gateway
-
20-security: ACG и базовые границы безопасности
-
30-compute-ops-host: ops host, выступающий точкой входа в операционную среду
-
31-managed-postgresql: экземпляр Cloud DB for PostgreSQL
-
32-managed-nks: кластер NKS и node pool
-
33-compute-middleware-vm: VM промежуточного ПО для Redis, Kafka, OpenBao и других компонентов
-
34-managed-service-access: правила доступа между NKS, промежуточным ПО и управляемой DB
-
35-nks-addons: дополнения к кластеру, такие как NKS CSI add-on
-
40-object-storage: бакеты для резервных копий БД, наблюдаемости, резервных копий OpenBao и т. д.
-
90-shared-outputs: сводный стек, который предоставляет единое место для просмотра выходных данных других стеков
Такое разделение действительно имеет недостаток: оно увеличивает длительность порядка применения. Однако в рабочей среде преимущества перевесили этот недостаток.
Например, при увеличении количества пулов узлов вызывает беспокойство, если сеть или БД включены в план. Если изменения NKS или PostgreSQL появляются рядом с добавлением одного бакета Object Storage, необходимо остановиться. Разделение стеков уменьшает область изменений и нагрузку при проверке плана.
Ещё один важный момент — «единоличное владение». Например, 31-managed-postgresql создаёт сам управляемый сервис PostgreSQL, но фактические правила ACG для доступа к сервису организованы так, чтобы 34-managed-service-access был их единственным владельцем. Это связано с тем, что дрейф конфигурации и конфликты легко возникают, если стеки БД и NKS начинают независимо изменять правила доступа.
Стройте сеть широко, но сохраняйте доступ узким
Сначала казалось, что подсетей слишком много. Разделение на публичные подсети, подсети NAT-шлюзов, подсети LB, подсети k8s, подсети БД и подсети middleware может показаться избыточным.
Однако в рабочей среде разделение имён и назначений значительно упростило дальнейшую работу.
Например, это выглядело следующим образом.
-
public: хост ops, NAT-шлюз, публичный LB
-
private: рабочий узел NKS, БД, VM middleware, приватный LB
-
Распределение по зонам: разделение подсетей с учётом KR-1 и KR-2
Разумеется, не каждая подсеть с самого начала используется в сложной HA-структуре. VM middleware также сначала состояла всего из одного экземпляра. Однако при последующем расширении OpenBao, Kafka и Redis до трёх экземпляров или при переводе БД в режим HA/multi-zone значительно меньше рисков возникает, если имена и назначения сетей уже разделены.
Здесь я понял, что чрезмерное упрощение проектирования подсетей с учётом только текущей ситуации впоследствии затрудняет внесение изменений. И наоборот, нет необходимости с самого начала автоматизировать всё подряд. Ключевым оказалось «начинать с простых в использовании сейчас имён и границ, которые можно расширить в дальнейшем».
Managed NKS: вы можете не управлять им напрямую, но ответственность за проектирование сохраняется
Использование NKS снижает операционную нагрузку, связанную с control plane Kubernetes. Однако это не означает, что проектирование эксплуатации Kubernetes исчезает.
Для текущей конфигурации мы основывали проектирование на региональном кластере на базе KVM и разделили пулы узлов по зонам. Например, мы делим зоны на shared-a и shared-b и сбалансированно увеличиваем количество рабочих узлов с одинаковыми характеристиками.
В процессе эксплуатации постоянно возникают вопросы вроде следующих.
-
Достаточно ли текущего использования памяти узла?
-
Следует ли увеличить количество узлов до масштабирования подов?
-
Когда узел переходит в состояние NotReady, совпадают ли состояние Terraform и состояние консоли?
-
Включён ли аддон CSI перед развёртыванием рабочей нагрузки, которой требуется PVC?
-
Повлияет ли изменение типа LB или настройка протокола PROXY на существующий ingress?
В реальной эксплуатации даже «добавление одного узла» не является простой задачей. В плане Terraform необходимо проверить, что изменяется только node_count и что другие ресурсы, например ACG или LB, не модифицируются. Если план отличается от намерения, применение следует остановить.
Исходя из этого опыта, я почувствовал, что преимущество IaC заключается не столько в «автоматическом применении изменений», сколько в «возможности точно увидеть, что изменится, до их применения».
Что я узнал прежде всего о Managed PostgreSQL
Managed PostgreSQL оказался областью, где я столкнулся с наибольшим количеством проб и ошибок.
Многие задачи, которые были рутинными при самостоятельном размещении PostgreSQL, оказались невозможными в managed PostgreSQL.
-
Привилегии superuser отсутствуют.
-
Невозможно напрямую выполнить запрос к pg_authid.
-
Использовать globals dump как есть затруднительно.
-
Владелец расширения отличается от роли сервиса.
-
Способ установки таких расширений, как postgis и pgvector, определяется политиками провайдера.
-
Даже для создания пользователя БД может потребоваться официальный путь управления Naver Cloud, а не SQL CREATE ROLE.
Сначала я думал, что можно просто перенести существующий bootstrap SQL на базе VM. На практике это оказалось не так. Создание базы данных, создание пользователей, создание схем, назначение grant, проверку расширений и резервное копирование/восстановление пришлось разделить на отдельные операции.
В настоящее время для каждой рабочей нагрузки мы используем следующую структуру.
shared-platform-managed/
└── workloads/
    ├── devlime-managed/
    ├── banjang-managed/
    └── spicedb-managed/
Каждая рабочая нагрузка отвечает за следующее.
-
Создавать базу данных рабочей нагрузки с помощью Terraform
-
Постепенно обеспечивать наличие необходимых пользователей БД через официальный API Naver Cloud
-
Согласовывать схемы, grant и привилегии по умолчанию с помощью Ansible
-
Явно определять имена схем и ролей, специфичные для сервиса
-
Выполнять необходимые предварительные проверки расширений
Например, devlime совместно управляет семействами схем и ролей devlime, vizend и modlime в одной базе данных devlime_prd. Аналогично banjang отдельно определяет семейства banjang, vizend и modlime в базе данных banjang_prd.
Преимущество такого подхода заключается в том, что «база данных одна, но ответственности можно разделить декларативно». Обратная сторона состоит в том, что первоначальные определения становятся несколько более многословными. Однако возможность чётко определить, где вносить изменения при добавлении сервисов или отсутствии разрешений у ролей во время эксплуатации, оказалась более значимой.
PgBouncer и проблема с search_path
Мы также настроили PgBouncer, учитывая количество подключений к рабочей БД. Вместо прямого подключения сервисов к PostgreSQL используется структура с общим пулом подключений через PgBouncer.
В этом процессе также возникли неожиданные проблемы. Некоторые сервисы указывали схему через currentSchema в JDBC URL, но PgBouncer был настроен так, чтобы не обрабатывать переданный параметр search_path запуска как есть. Это происходило потому, что search_path был включён в ignore_startup_parameters.
Сначала казалось, что удаление настройки игнорирования search_path из конфигурации PgBouncer решит проблему. Однако это могло повлиять на подключения всех сервисов, а изменение общей конфигурации PgBouncer во время эксплуатации было рискованным.
В итоге более безопасным подходом оказалось задать для роли БД значение search_path по умолчанию, специфичное для базы данных.
-
Роль сервиса сначала обращается к собственной схеме.
-
Включите схему, в которой установлено расширение, в search_path в управляемом PostgreSQL.
-
Даже при подключении через PgBouncer разрешение схем стабилизируется настройками роли по умолчанию.
Этот опыт заставил меня пересмотреть, что следует использовать в качестве операционного стандарта: «настройки в URL приложения» или «настройки самой роли БД по умолчанию». В эксплуатации более стабильными часто оказывались настройки, которые сохраняют действие даже при изменении пути подключения, то есть значения по умолчанию на уровне роли БД.
Резервная копия — это нечто большее, чем файл дампа; она включает возможность восстановления.
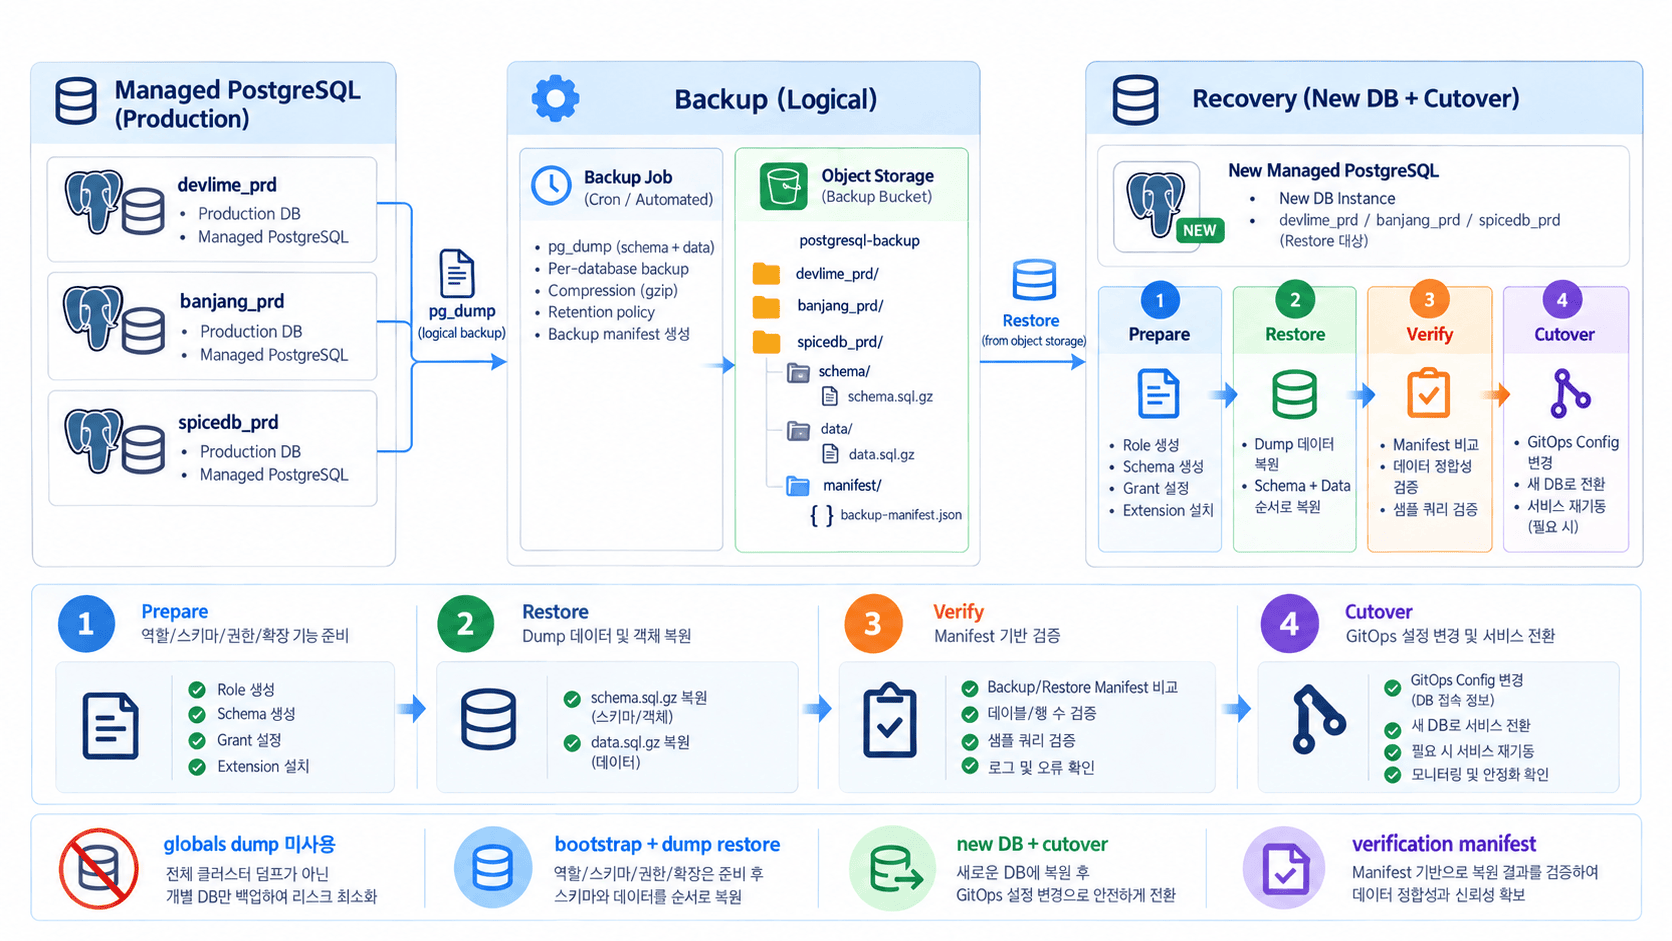
Резервное копирование также потребовало большого количества проб и ошибок. В частности, поскольку в управляемом PostgreSQL трудно использовать globals dump как есть, нам пришлось заново определить границу между резервным копированием и восстановлением.
Текущие стандарты таковы.
-
Сам экземпляр управляемого PostgreSQL использует автоматические резервные копии Naver Cloud.
-
Кроме того, мы выполняем отдельное логическое резервное копирование для каждой рабочей БД.
-
По умолчанию globals dump не используется.
-
bootstrap отвечает за подготовку ролей, схем, разрешений и расширений.
-
dump restore отвечает за восстановление данных и общих объектов.
-
После восстановления мы сравниваем количество схем, таблиц и строк с помощью манифеста проверки.
Сначала легко подумать: «Разве недостаточно загрузить файл резервной копии в объектное хранилище?» Однако при фактическом выполнении восстановления это не так.
Восстановление должно позволять ответить на следующие вопросы.
-
Можно ли создать новую БД?
-
Можно ли повторно согласовать разрешения пользователей и схем?
-
Можно ли выполнить восстановление без конфликтов расширений?
-
Конфликтуют ли DDL схем из дампа со схемой, управляемой провайдером управляемой БД?
-
Можно ли проверить количество строк или схем после восстановления?
-
Можно ли выполнить переключение так, чтобы фактический сервис использовал новую БД?
По этой причине мы также отделили стек восстановления от рабочей нагрузки.
shared-platform-managed/
└── recovery/
    ├── devlime-managed/
    └── banjang-managed/
Временно добавлять БД восстановления в стек рабочей БД было рискованно. На практике из-за особенностей провайдера управляемого PostgreSQL изменения списка баз данных иногда интерпретировались как замены. Поэтому мы выделили восстановление в отдельный стек, а также определили отдельные правила именования для тестовой БД восстановления и БД для переключения при инциденте.
Стратегия восстановления по умолчанию — новая БД + переключение. Вместо непосредственной очистки и восстановления рабочей БД безопаснее восстановить её в новую БД, проверить её, а затем переключить подключение приложения.
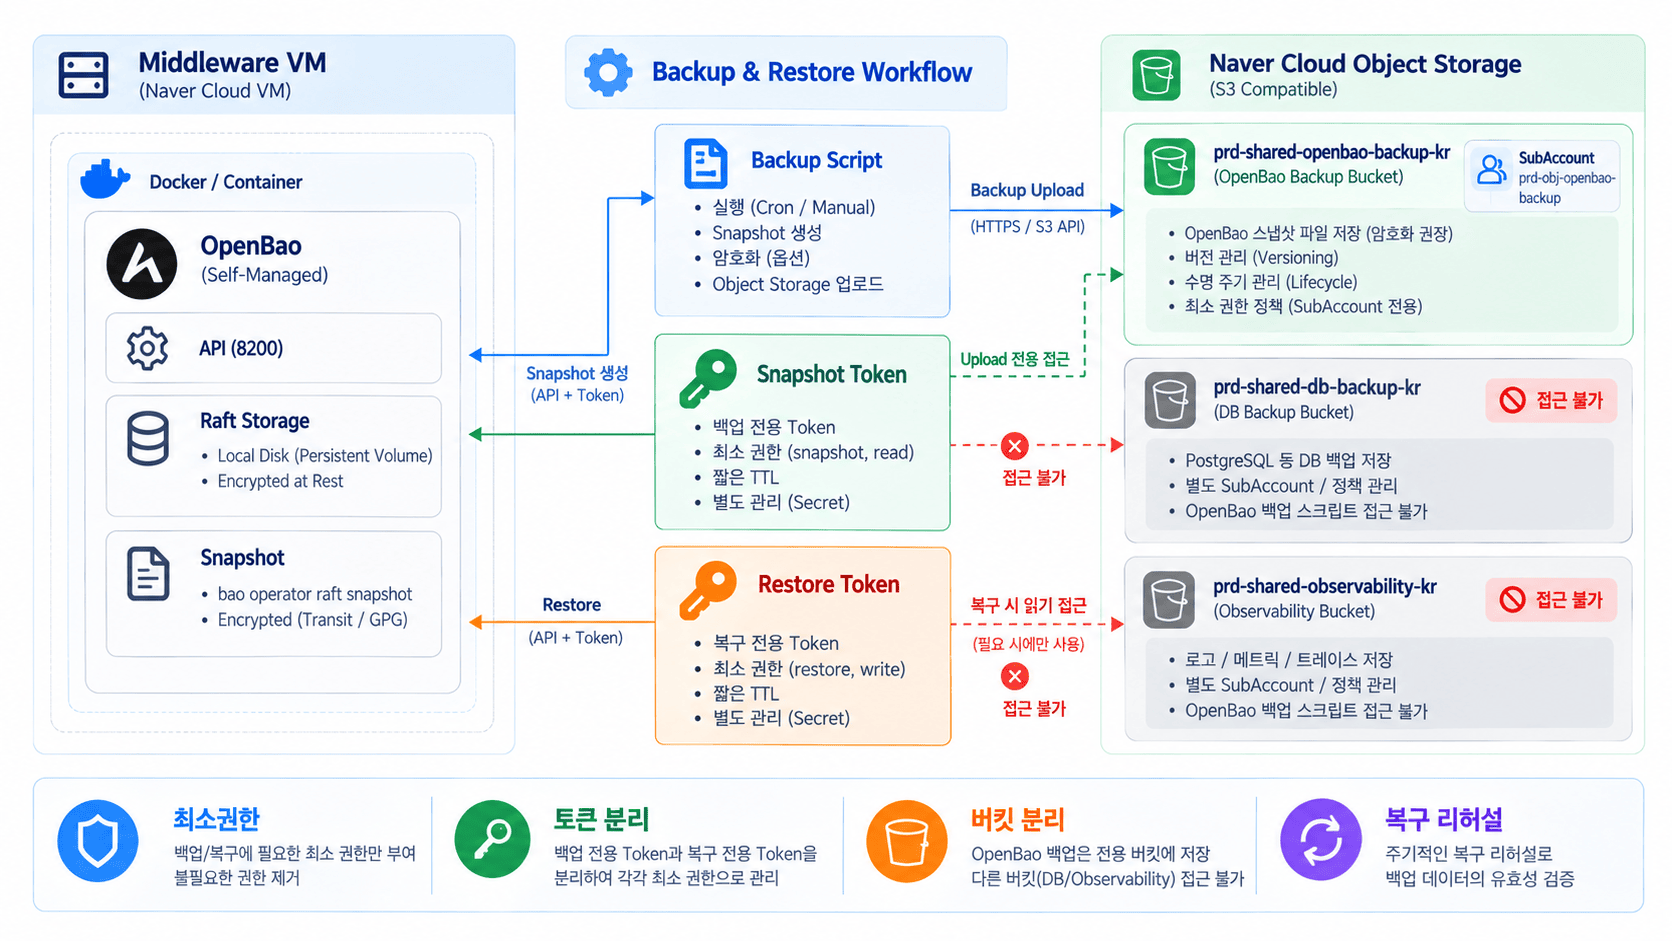
Резервные копии OpenBao требуют большей осторожности, чем резервные копии PostgreSQL.
Мы построили структуру, в которой такие решения, как OpenBao, Kafka и Redis, развёртываются на VM промежуточного ПО с помощью Docker Compose. Мы начинаем с конфигурации одного узла, но оставили возможность расширения до трёх узлов или перехода на управляемую альтернативу, если в дальнейшем важность этих решений возрастёт.
Среди них OpenBao был особенно важен с точки зрения резервного копирования. OpenBao — это не просто приложение, а хранилище секретов. Поэтому было неправильно смешивать его с логическими резервными копиями PostgreSQL, используя один и тот же бакет, одну и ту же учётную запись и одинаковые разрешения.
Текущее направление таково.
-
Использовать выделенный бакет Object Storage для снимков OpenBao raft
-
Использовать выделенный SubAccount для резервных копий OpenBao
-
Отделить его от учётной записи для резервного копирования БД
-
Разделить токен снимка и токен восстановления
-
Оставлять токен восстановления пустым во время обычной работы
-
Выполнять восстановление в отдельное тестовое или техническое окно, а не непосредственно в работающем OpenBao
В рамках этого процесса мы также отдельно организовали управление доступом. Поскольку провайдер Naver Cloud Terraform недостаточно охватывает такие области, как SubAccount, назначение политик и ключи доступа, мы создали вспомогательный скрипт accessctl.py.
Этот скрипт управляет следующими объектами.
-
Целевое состояние SubAccount
-
Политика, созданная пользователем
-
Разрешение с ограничением по бакету
-
Назначение политики
-
Создание ключа доступа
-
План удаления существующих широких политик
Здесь также был получен важный урок. Политики бакетов Object Storage сопоставляются не просто по имени бакета; для этого требуется NRN Resource Manager. Поэтому, если указано имя бакета, мы усовершенствовали процесс: он ищет точный NRN бакета через API Resource Manager и отражает его в политике.
Операционные разрешения важнее ограничивать необходимым минимумом, чем просто добиваться их работоспособности. В частности, учётная запись резервного копирования не должна иметь доступ ко всем бакетам; она должна иметь доступ только к собственному бакету.
Ansible скорее документирует операционные процедуры, чем «автоматизирует настройку серверов».
Ansible может выглядеть всего лишь инструментом для установки пакетов или копирования файлов. Однако в этом проекте плейбук Ansible служил для формализации операционных процедур.
Например, узел ops подготавливает следующее.
-
kubectl
-
helm
-
ncp-iam-authenticator
-
вспомогательный инструмент генерации kubeconfig
-
вспомогательный компонент для подключения к управляемому PostgreSQL
-
сервис/таймер логического резервного копирования PostgreSQL
На виртуальной машине middleware подготавливается следующее.
-
Docker Engine
-
плагин Docker Compose
-
композиция/сервис OpenBao
-
композиция/сервис Kafka
-
композиция/сервис Redis
-
каркас скрипта резервного копирования
-
вспомогательный компонент для инициализации/снятия блокировки OpenBao
Скрипт-обёртка оказался особенно полезным. В зависимости от плейбука одни задачи необходимо выполнять в режиме root, а другие — в режиме ops. Поэтому run-playbook.sh проверяет ansible_user в текущем inventory и отказывается запускаться, если он не совпадает.
Эти небольшие защитные механизмы важны в реальных операциях. Запуск плейбука с неправильным пользователем может привести к частично применённой конфигурации или запутанным правам доступа. Поскольку IaC представляет собой автоматизацию, он действительно может быстро увеличить небольшие ошибки и превратить их в серьёзные проблемы. Поэтому нам потребовалась структура, способная отклонить выполнение ещё до его начала.
Связь между GitOps и IaC
Наличие Terraform и Ansible не устраняет необходимость в GitOps. Их зоны ответственности различаются.
-
Terraform: жизненный цикл облачных ресурсов
-
Ansible: настройка внутренних операций и начальной конфигурации виртуальных машин
-
GitOps: желаемое состояние ресурсов Kubernetes
-
начальная настройка рабочих нагрузок: согласование внутренней структуры базы данных
Например, увеличение количества реплик приложения, применение URL подключения PgBouncer или изменение настроек Ingress/LB относятся к области GitOps. Увеличение пула узлов NKS, с другой стороны, относится к области Terraform. Согласование пользователей управляемого PostgreSQL и разрешений схем относится к области начальной настройки рабочих нагрузок.
Если эти границы не определены чётко, при возникновении операционной проблемы становится непонятно, где вносить изменения. На самом деле я несколько раз реорганизовывал структуру, поскольку границы были неоднозначными. Перенос рабочих нагрузок в shared-platform-managed был одной из причин таких изменений. В текущей структуре зависимость рабочих нагрузок от текущей управляемой платформы также очевидна из пути.
Краткое описание текущей структуры в одном предложении
Текущую структуру можно обобщить следующим образом.
Terraform формирует базовый уровень облачных ресурсов, Ansible подготавливает операционные точки входа и конфигурацию внутренних виртуальных машин, специфичная для рабочих нагрузок начальная настройка согласует внутреннее состояние управляемого PostgreSQL, а GitOps управляет желаемым состоянием приложений Kubernetes.
Если немного подробнее:
-
shared-platform-managed/terraform: сеть, безопасность, NKS, PostgreSQL, виртуальная машина middleware, Object Storage
-
shared-platform-managed/ansible: хост ops, инструменты NKS, доступ к базе данных/резервное копирование, конфигурация виртуальной машины middleware
-
shared-platform-managed/workloads: DB/schema/role/grant для devlime, banjang и spicedb
-
shared-platform-managed/recovery: репетиции восстановления и подготовка новой БД + переключения
-
shared-platform-managed/access: SubAccount Object Storage и политика с минимально необходимыми привилегиями
-
Отдельный репозиторий GitOps: фактические манифесты приложений/инфраструктуры Kubernetes
Преимущество этой структуры заключается в том, что каждый этап относительно понятен. Недостаток — для человека, который видит её впервые, в ней может показаться слишком много каталогов. Поэтому документация и эксплуатационные инструкции также стали важны.
Контрольные точки, которые я счёл особенно важными во время эксплуатации
1. План Terraform — это «руководство перед применением»
plan — это не просто шаг перед apply. Для операторов это руководство по изменениям. Если появляются изменения, относящиеся не к целевым ресурсам, следует остановиться.
Был случай, когда при добавлении одного бакета Object Storage три существующие политики отобразились как изменённые. Фактической разницы в разрешениях не было; это было ложное срабатывание сравнения, вызванное тем, что API возвращал condition: {}. В таких случаях правильный подход — исправить логику сравнения до запуска apply.
2. Управляемые сервисы не устраняют ответственность — они меняют её характер
Использование NKS сокращает объём операций с control plane. Однако по-прежнему необходимы управление пулом узлов, дополнениями, ingress, классом хранилища и нагрузкой на ресурсы.
Использование Managed PostgreSQL сокращает объём операций с движком базы данных. Однако стратегии управления ролями, схемами, расширениями и резервным копированием/восстановлением необходимо, наоборот, проектировать ещё более явно.
3. Резервное копирование всегда должно включать восстановление и проверку
Наличие файла резервной копии не означает, что восстановление возможно. У managed PostgreSQL есть ограничения для дампа глобальных объектов, OpenBao использует разные токены для создания и восстановления снимков, а разрешениями Object Storage также необходимо управлять отдельно.
Для PostgreSQL я уже выстроил процесс prepare -> restore -> verify, а вспомогательный компонент для резервного копирования/восстановления снимка raft для OpenBao всё ещё упорядочиваю.
4. Лучше начинать с узких областей действия учётных записей и разрешений, чем сужать их позднее
Поначалу может возникнуть желание быстро подключиться, предоставив широкие разрешения Object Storage. Однако операционные учётные записи для резервного копирования особенно чувствительны.
Текущее направление — разделить резервное копирование БД, observability, хранилище Banjang и резервное копирование OpenBao на отдельные SubAccount и политики, ограниченные отдельными бакетами.
5. Документация также является частью IaC
Одного кода Terraform и Ansible недостаточно, чтобы операторы понимали, почему всё настроено именно так. Поэтому я продолжаю улучшать README, руководство по восстановлению, руководство по переключению и руководство по доступу.
Документацию не следует писать отдельно позднее; её необходимо было изменять одновременно со структурой. На практике я также несколько раз пересматривал эксплуатационные инструкции во время проведения репетиций восстановления.
Оставшиеся задачи
Я не считаю текущую структуру завершённой. Очевидно, что ещё остаются нерешённые задачи.
-
Определение критериев перехода виртуальной машины middleware с одновузловой конфигурации на архитектуру HA
-
Разделение среды репетиции восстановления OpenBao
-
Управление политиками жизненного цикла и хранения Object Storage как IaC
-
Определение критериев автоматического масштабирования или горизонтального масштабирования узлов NKS
-
Расширение области применения PgBouncer и автоматизация проверки для каждого сервиса
-
Разделение учетных записей доступа разработчиков и операторов
-
Дальнейшая систематизация управления конфиденциальной информацией
-
Устранение расхождений между эксплуатационным руководством и фактической автоматизацией
Но по крайней мере сейчас стало гораздо понятнее, чем раньше, «где и что управляется». А когда возникает проблема, стало проще определить, на какой стек, какой плейбук и какое определение рабочей нагрузки нужно обратить внимание.
Заключение
Работа над этим проектом немного изменила мой взгляд на IaC.
Поначалу легко воспринимать IaC просто как «создание инфраструктуры с помощью Terraform». Но в эксплуатационной среде этого недостаточно.
В конечном счете IaC ближе к процессу структурирования эксплуатационных знаний.
-
Какие ресурсы должны существовать
-
Кому принадлежат эти ресурсы
-
В каком порядке их следует создавать
-
Что автоматизировать и где требуется утверждение
-
Что использовать для восстановления в случае сбоя
-
Как доказать, что восстановление действительно работает
IaC становится пригодным для эксплуатации, когда код и документация, отвечающие на эти вопросы, существуют вместе.
Terraform создал каркас инфраструктуры. Ansible сделал эксплуатационную конфигурацию внутри виртуальных машин воспроизводимой. workload bootstrap декларативно согласовал внутреннее состояние управляемого PostgreSQL. GitOps стал стандартом для непрерывного согласования состояния приложений Kubernetes. А руководство по резервному копированию и восстановлению стало страховочной сеткой для проверки того, «можем ли мы действительно восстановиться при возникновении сбоя».
Возможностей для улучшения по-прежнему много. Тем не менее, переходя от структуры, ориентированной на самостоятельное размещение, к структуре, ориентированной на управляемые сервисы, мы, как мне кажется, сделали шаг вперед — не просто создав облачные ресурсы, а разделив эксплуатационные обязанности, уменьшив радиус поражения изменений и создав структуру, допускающую восстановление.
Это скорее процесс непрерывного совершенствования, чем достижение завершенности. Но главный урок этого процесса очевиден.
Хорошая IaC — это не код, который успешно применяется, а структура, позволяющая операторам уверенно вносить изменения.
Andy