
-Jep, JNI и GIL-
1. Введение: проблемы интеграции разнородных сред выполнения
В современных серверных архитектурах сервисная логика всё реже реализуется на одном языке. Хотя экосистема Python, представленная в первую очередь Numpy и Scipy, стала фактическим стандартом для численного анализа и инференса моделей машинного обучения, стеки на базе JVM по-прежнему имеют преимущества в управлении транзакциями и эксплуатационной стабильности. В результате перед инженерами серверной части встаёт задача объединить сильные стороны двух разных сред выполнения в рамках единого потока обработки сервиса.
Платформа данных судов столкнулась с той же проблемой. Данные о состоянии двигателей и генераторов, уровнях в цистернах и положении корпуса поступают с судов в море каждую минуту, однако основная задача платформы заключается не в хранении этих данных. Она должна выполнять вычисления, интерпретирующие движение корпуса и рассчитывающие степень деградации по сравнению с нормальными показателями. Проблема заключалась в том, что эти вычисления состояли из формул военно-морской архитектуры, ранее написанных и проверенных экспертами предметной области на Python. Они были основаны на предварительно обученных моделях машинного обучения и библиотеках расширений C, для которых соответствующих реализаций на Java не существовало. Кроме того, формулы, подлежащие одобрению классификационного общества, должны были выдавать результаты, совпадающие с существующими вплоть до десятичных знаков.
В этом техническом документе описывается случай, в котором Java Embedded Python (далее Jep) использовался для встраивания интерпретатора Python внутрь процесса JVM. Сначала рассматриваются две проблемы, выявленные в первоначальной реализации, и способы их устранения, затем анализируется внутренняя работа Jep с точки зрения JNI и GIL, чтобы подробно объяснить, почему эти проблемы были структурно неизбежны.
2. Предпосылки выбора технологии: компромисс между разделением процессов и встраиванием в процесс
Существует два основных подхода к интеграции проверенных компонентов Python в сервис. Выделение их в отдельный сервис Python обеспечивает изоляцию сбоев, но влечёт затраты на сетевые обращения и сериализацию при каждом вызове. Встраивание в процесс, напротив, позволяет обмениваться данными непосредственно в общей области памяти процесса.
Определяющим критерием было то, выполнялось ли вычисление внутри потока обработки запроса. Большинство вычислений платформы требовалось выполнять немедленно после получения сенсорных данных, поступающих каждую минуту, а затем сохранять результаты в виде объектов предметной области. Поэтому мы пришли к выводу, что добавление HTTP-обращений и сериализации в этот путь не принесёт практической пользы, и выбрали внутрипроцессный подход. Jep — библиотека, делающая это возможным.
В отличие от Jython, Jep не реализует Python заново поверх JVM. Вместо этого он вызывает оригинальный интерпретатор Python, написанный на C, через JNI (Java Native Interface). Numpy и Scipy в основном являются модулями расширения C и не работают в среде Jython. Поскольку совместимость с расширениями C была обязательным требованием, Jep фактически оставался единственным вариантом.
try (Interpreter interp = new SharedInterpreter()) {
    interp.exec("import numpy as np");
    interp.set("xs", new double[]{1.0, 2.0, 3.0});
    interp.exec("result = float(np.mean(np.array(xs)))");
    double mean = (Double) interp.getValue("result");
}
Интерфейс состоит из трёх операций. set() связывает объект Java с глобальной переменной Python, exec() выполняет код, а getValue() извлекает результат. Объекты Python dict автоматически преобразуются в объекты Java Map, а списки — в объекты List, включая вложенные структуры. При разделении процесса именно здесь пришлось бы добавить определения схем JSON и код сериализации.
3. Ограничения первоначальной реализации и технические проблемные точки
Первоначальная реализация имела простую структуру: создавался один экземпляр Jep для повторного использования, а путь к нативной библиотеке передавался стандартным правилам поиска среды контейнера. Хотя дефект не проявился в среде валидации, после внедрения параллелизма и изменений инфраструктуры в рабочей среде возникли две проблемы разного характера.
3.1. Проектирование с повторным использованием экземпляра: упущенное ограничение привязки к потоку
В первоначальной реализации экземпляр Jep хранился в поле определённого класса и повторно использовался при нескольких вызовах, чтобы снизить стоимость создания интерпретаторов. С точки зрения работы с пулом соединений это было естественным решением, и во время однопоточной валидации оно работало корректно.
Однако экземпляр Jep не был объектом, которым можно было бы делиться таким образом. Подробное обоснование приведено в разделе 4.4, но причина заключается в том, что поле tstate, хранящееся внутри объекта Jep, представляет собой нативный указатель PyThreadState, который должен существовать отдельно для каждого потока. Проблема проявилась, когда к экземпляру обратился рабочий поток, отличный от потока, создавшего его.
Было принято два решения. Во-первых, реализация интерпретатора была переключена на SharedInterpreter. В предыдущей реализации существовала и отдельная проблема: она была несовместима с модулями расширения C, такими как Numpy (раздел 4.3). Во-вторых, для устранения самой проблемы привязки к потоку мы отказались от хранения экземпляра в поле и изменили структуру так, чтобы создавать его в месте использования внутри оператора try-with-resources и немедленно освобождать. Последнее изменение устранило проблему многопоточности.
try (SharedInterpreter jep = new SharedInterpreter()) {
    // 사용하는 스레드에서 직접 생성되고, 블록을 벗어나면 해제됨
}
Это изменение устранило проблему привязки к потоку, но привело к новому компромиссу: затраты на импорт модулей приходилось оплачивать заново при каждом вызове. Способ компенсации этого эффекта обсуждается в разделе 5.2.
3.2. Неявный поиск библиотек: уязвимость к изменениям инфраструктуры
Вторая проблема возникла не в коде приложения, а на уровне конфигурации развёртывания. Изначально мы полагались на стандартные правила поиска среды контейнера для определения местоположения нативной библиотеки Jep и среды выполнения Python. Поскольку система нормально работала без дополнительной настройки, мы не осознавали необходимости явных объявлений.
Проблема проявилась после обновления версии ядра Linux на узле выполнения. Среда выполнения не смогла разрешить путь к библиотеке, и приложение завершилось с ошибкой во время запуска. Сервис не смог запуститься исключительно из-за изменения на уровне инфраструктуры, хотя не изменилась ни одна строка кода приложения.
Решение заключалось в явном объявлении пути к нативной библиотеке с помощью опции JVM -Djava.library.path. Мы непосредственно добавили эту опцию вместе с путём к каталогу библиотек внутри образа контейнера (например, native-libs) в Deployment manifest's spec.template.spec.containers[].args, заменив тем самым зависимость от правил поиска среды выполнения явным объявлением.
# deployment.yml
spec:
  template:
    spec:
      containers:
        - args:
            - "-Djava.library.path=/app/native-libs"
Вывод из этого случая очевиден. Для библиотеки с нативными зависимостями состояние «работает без отдельной конфигурации» не означает, что стабильность обеспечена; оно лишь означает, что среда пока не изменилась.
4. Разбор внутренней работы Jep
Оба сбоя, описанные в разделе 3, были неизбежными следствиями внутренней структуры Jep. Работу и ограничения систем на базе Jep определяют следующие пять механизмов.
4.1. Структура процесса: один процесс, две независимые среды выполнения
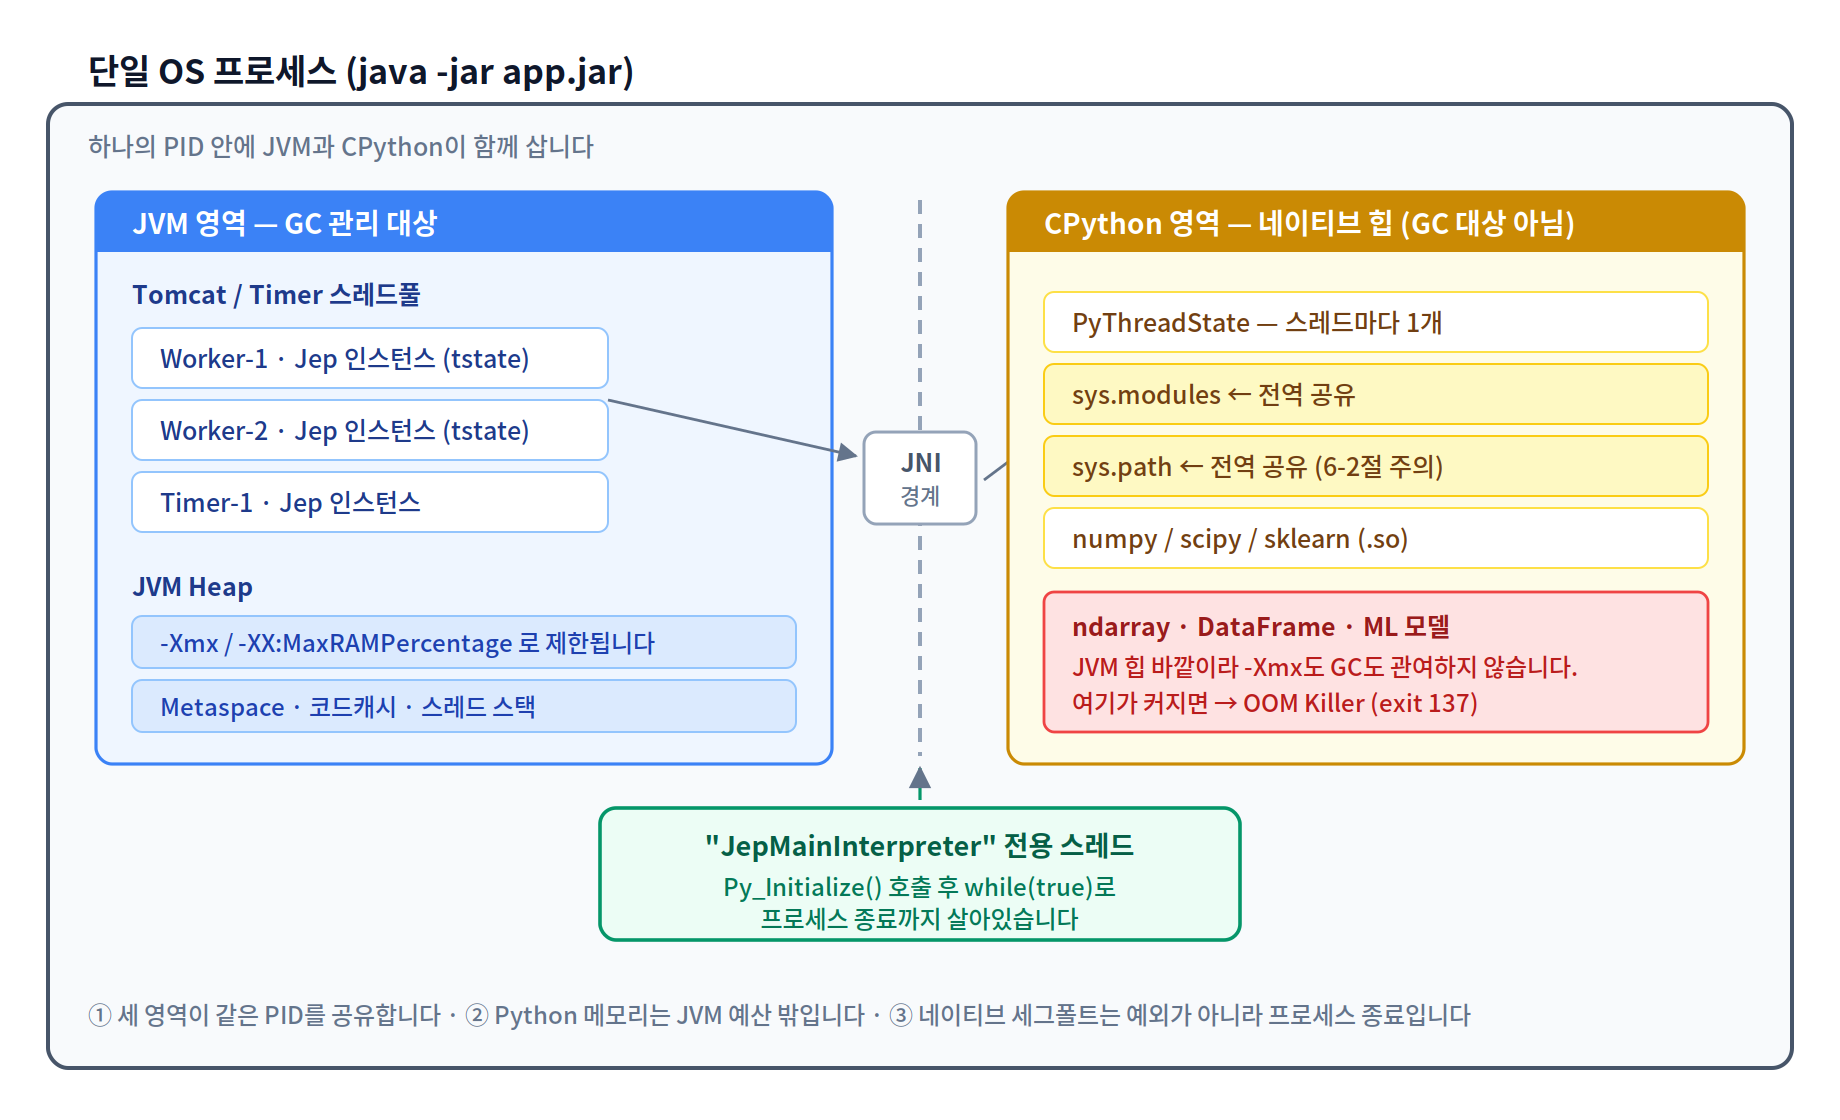
Внутренняя структура процесса
Рисунок 1. Структура, в которой области JVM и Python сосуществуют в рамках одного процесса ОС через границу JNI
В рамках одного процесса ОС сосуществуют три области. Область JVM (пул потоков, экземпляры Jep и куча JVM) полностью управляется GC, тогда как область Python (PyThreadState, sys.modules/sys.path, файлы расширений C .so и буферы ndarray) не управляется GC. Кроме того, существует поток, выделенный для JepMainInterpreter, который сохраняется до завершения процесса.
Наиболее важный факт заключается в том, что память Python выделяется за пределами кучи JVM. Объекты Numpy ndarray, объекты pandas DataFrame и модели joblib находятся в областях нативной памяти, неизвестных JVM, поэтому настройки -Xmx и GC на эти области не влияют.
4.2. Последовательность инициализации: ленивая инициализация и поиск библиотек
// jep/MainInterpreter.java
protected static synchronized MainInterpreter getMainInterpreter() throws Error {
    if (null == instance) {
        instance = new MainInterpreter();
        instance.initialize();
    }
    ...
}
Это сочетание ключевого слова synchronized и шаблона ленивой инициализации. Python инициализируется не при запуске приложения, а при первом вызове new SharedInterpreter(), причём это происходит только один раз за жизненный цикл процесса. Последующие вызовы new SharedInterpreter() отвечают только за создание объектов PyThreadState.
Первым шагом initialize() является загрузка нативной библиотеки через System.loadLibrary("jep"), и именно здесь возникает сбой, описанный в разделе 3.2. Сначала проверяются -Djava.library.path и LD_LIBRARY_PATH, а если оба варианта не срабатывают, LibraryLocator обходит содержимое site-packages. Система может работать и без явного указания пути, но такое поведение полностью зависит от значений по умолчанию в среде выполнения.
Затем Py_Initialize() выполняется в отдельном потоке, называемом JepMainInterpreter. Согласно комментариям в исходном коде, это сделано для предотвращения проблем с GIL, возникающих, когда субинтерпретатор находится в том же потоке, что и главный интерпретатор. Этот поток работает в бесконечном цикле и не завершается. Если поток завершится в то время, когда другой поток выполняет код в области Python, состояние может быть повреждено. Поэтому этот поток присутствует в любой JVM, использующей Jep, до завершения процесса; это следует учитывать заранее, чтобы при анализе дампа потоков не принять его ошибочно за утечку.
4.3. Выбор модели интерпретатора: SharedInterpreter и совместное использование глобального состояния
|
SubInterpreter |
SharedInterpreter |
|
|---|---|---|
|
Основан на |
Py_NewInterpreter() |
Использует главный интерпретатор совместно |
|
sys.modules |
Изолированное |
Общее |
|
Совместимость с модулями расширения C |
Нестабильная (многие компоненты Numpy/Scipy не поддерживаются) |
Стабильная |
|
Загрязнение глобального состояния |
Отсутствует |
Присутствует |
Субинтерпретатор — это функция, создающая несколько состояний интерпретатора. Однако если модуль расширения C использует глобальные статические переменные, это состояние не разделяется между интерпретаторами. Крупные расширения C, такие как Numpy, имеют именно такую структуру, поэтому в среде субинтерпретаторов они могут работать неправильно или завершать процесс. Хотя в рамках PEP 554 и PEP 684 ведётся работа над улучшениями, мы решили, что их сложно применить к текущему стеку, и переключились на SharedInterpreter в разделе 3.1.
Однако этот выбор имеет свою цену, о чём также предупреждает Javadoc. Любое действие, изменяющее поведение модулей, влияет на весь SharedInterpreter; типичные примеры — изменение sys.path или вызов Numpy.seterr(). Поскольку sys.modules является общим, все интерпретаторы используют один и тот же список sys.path, а многократный вызов sys.path.append(...) без проверки условия приводит к накоплению путей. Безопаснее регистрировать пути к модулям через переменные окружения, а не в коде.
4.4. Привязка к потоку: ограничения, обеспечиваемые tstate
// jep/Jep.java
public void isValidThread() throws JepException {
    if (this.thread != Thread.currentThread())
        throw new JepException("Invalid thread access.");
    ...
}
Экземпляры Jep можно использовать только в потоке, в котором они были созданы, и все открытые методы проверяют это при входе. Именно эта логика проверки непосредственно приводит к сбою подхода с повторным использованием экземпляров, описанного в разделе 3.1.
Внутри интерпретатора Python существует структура данных, в которой хранится информация о том, «насколько далеко этот поток продвинулся в выполнении». Она содержит такие сведения, как местоположение выполняемого кода, состояние обработки исключений и стек вызовов. Эта структура называется PyThreadState. Ключевой момент заключается в том, что для каждого потока должна существовать ровно одна такая структура.
На стороне Java Jep хранит адрес этой структуры в поле.
private long tstate; // 실제로는 PyThreadState의 메모리 주소tstate — это имя данного поля, являющееся сокращением от thread state. Поскольку в Java нет эквивалента указателя C, хранится только значение адреса в типе long.
Тот факт, что это значение привязано к потоку, является фундаментальной причиной сбоя, описанного в разделе 3.1. Если другой поток попытается выполнить код Python, используя tstate, который ему не принадлежит, внутреннее состояние интерпретатора будет повреждено. Чтобы предотвратить это, Jep при входе в каждый метод проверяет, совпадает ли вызывающий поток с потоком, в котором был создан экземпляр. В Javadoc также прямо указано, что одновременная активация нескольких интерпретаторов в одном потоке невозможна.
Самый простой способ соблюсти оба ограничения — один экземпляр на поток и использование только в этом потоке — заключается в применении конструкции try-with-resources, которая создаёт экземпляр непосредственно в месте использования и сразу же освобождает его.
4.5. Сериализация с помощью глобальной блокировки интерпретатора (GIL)
Jep не устраняет GIL. Когда поток Java вызывает jep.eval(...), он захватывает GIL и освобождает его при возврате. Поэтому даже если десятки потоков Java вызывают этот метод одновременно, в каждый момент байт-код Python фактически выполняется только одним потоком.
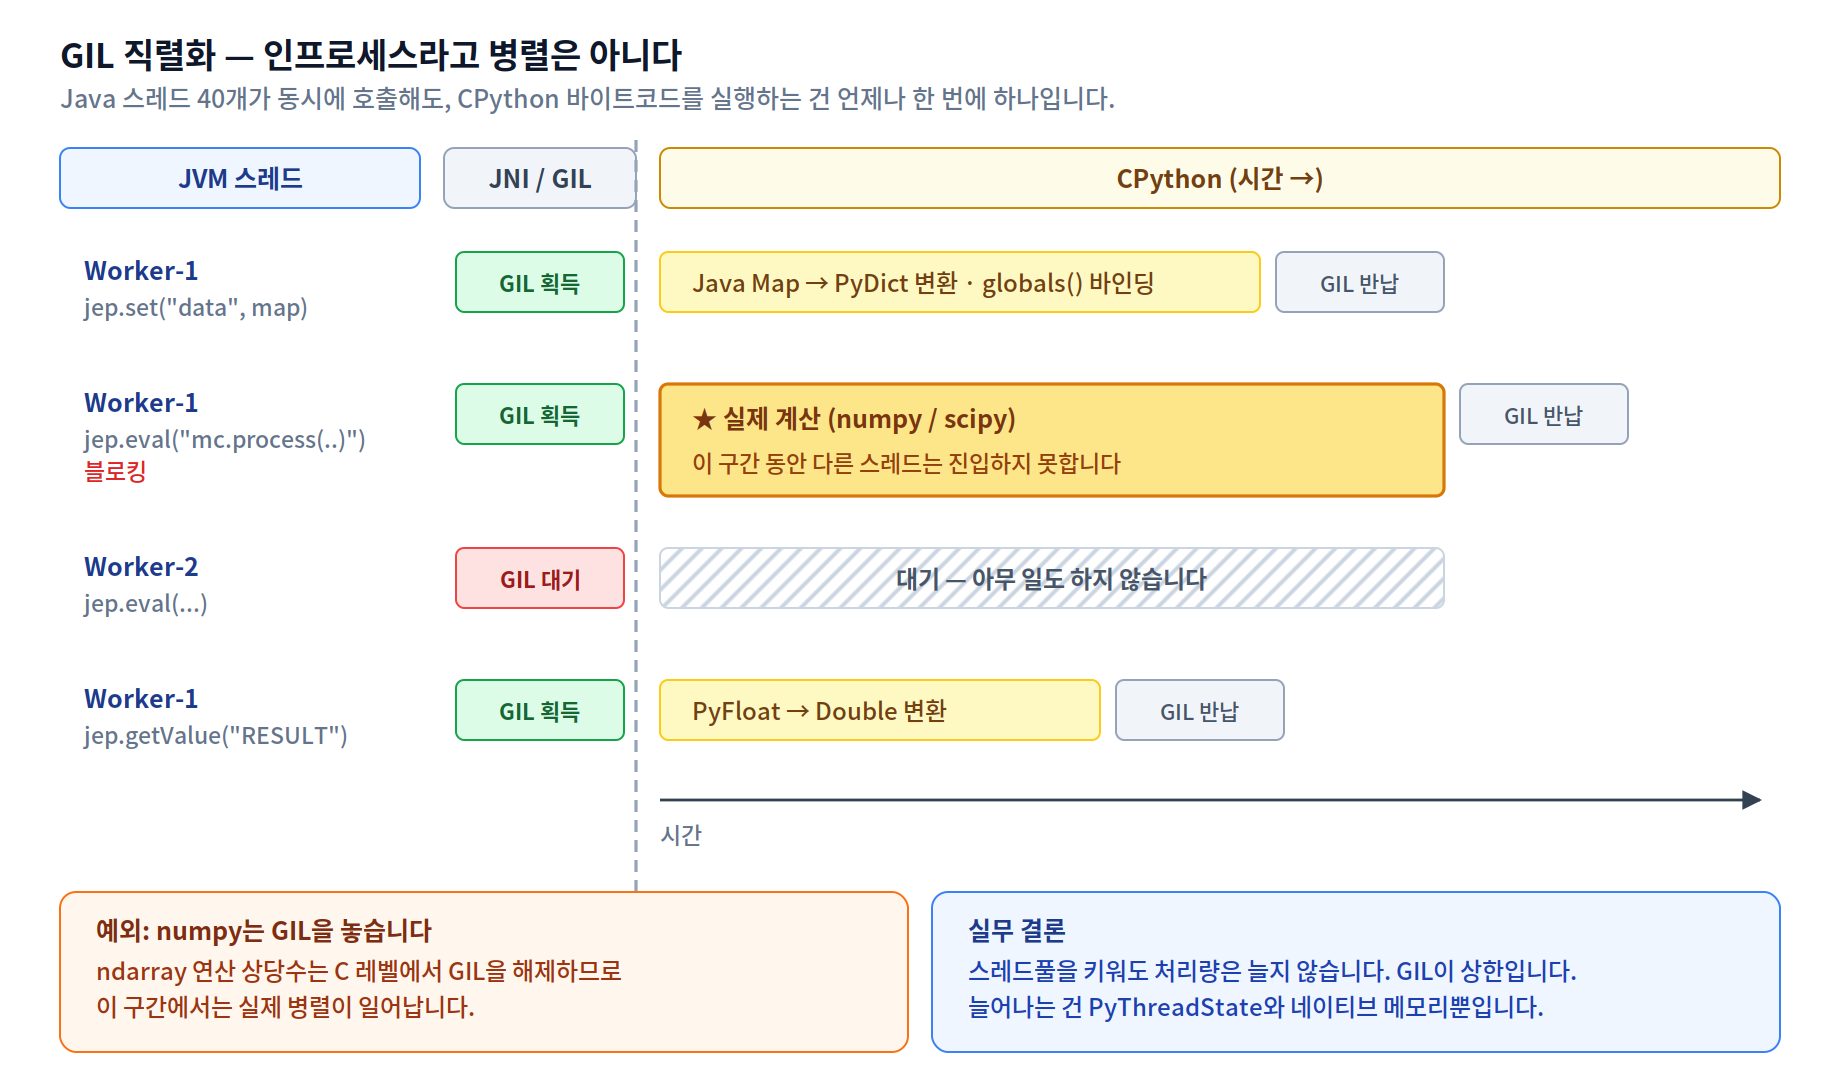
Временная шкала сериализации GIL
Рисунок 2. Пока Worker-1 выполняет операцию, Worker-2 ожидает GIL, в результате чего выполнение сериализуется
Однако многие тяжёлые операции Numpy внутренне освобождают GIL. Циклы на чистом Python полностью сериализуются, но фактическая параллельная обработка происходит во время операций с ndarray, поэтому вычислительную логику выгодно по возможности делегировать уровню Numpy.
Следовательно, увеличение пула потоков для пути выполнения Python не повышает пропускную способность. GIL выступает верхним ограничением, а создание PyThreadState и globals dict для каждого потока лишь увеличивает потребление нативной памяти. Для существенного распараллеливания вычислений, ограниченных производительностью CPU, требуется разделение процессов.
5. Три операционных принципа, выведенных из структурных ограничений
5.1. Перерасчёт бюджета памяти контейнера
Как показано в разделе 4.1, память, используемая уровнем Python, находится за пределами кучи JVM. Значение -XX:MaxRAMPercentage=80 является разумным для типичного контейнера Spring Boot, но в сервисе на Jep это означает, что интерпретатор Python, модули, объекты ndarray и ML-модели должны целиком разместиться в оставшихся 20%. При превышении бюджета ядро завершает контейнер с помощью OOM Killer, вместо того чтобы возникло OutOfMemoryError, и наблюдается только код завершения 137 без дампа кучи. Подходящее значение зависит от фактического потребления памяти на стороне Python, поэтому единственный жизнеспособный подход — напрямую измерить фактическое потребление памяти контейнером с помощью инструментов мониторинга и рассчитать значение в обратную сторону.
5.2. Согласование времени жизни интерпретатора с единицей работы
Подход, описанный в разделе 3.1, устранил проблему привязки к потоку, но осталась другая проблема: создание интерпретатора для каждого вызова приводит к повторным затратам на импорт модулей при каждом вызове. Разумно согласовать время жизни интерпретатора с логической единицей работы (Unit of Work), а не с отдельным вызовом.
// getJep(): SharedInterpreter 생성 + 모듈 import
try (SharedInterpreter jep = this.getJep()) {
   flowA.createBaseline(jep, targetId, param);
   flowB.createBaseline(jep, targetId, param);
   flowC.createBaseline(jep, targetId, param);
}
Поскольку экземпляр не сохраняется в поле, ограничение привязки к потоку сохраняется, а затраты на инициализацию распределяются по всей партии.
5.3. Предварительное проектирование радиуса поражения
Если код расширения C обращается к недопустимой области памяти — ситуация, обычно называемая сегментацией (segfault), — завершается сам процесс, а не выбрасывается исключение Java. Это означает, что такую ошибку нельзя перехватить с помощью try-catch и что восстановление на уровне JVM невозможно. Если отделить сервис, выполняющий вызовы Python, от чистых доменных сервисов, область инцидента такого типа можно ограничить этим сервисом.
6. Заключение: уроки сосуществования, а не встраивания
Самый ценный урок, полученный в процессе реализации, заключается в следующем: «Хотя термин «встраивание» звучит так, будто одна среда выполнения управляет другой, на самом деле он означает, что два независимых механизма выполнения сосуществуют внутри одного процесса».
Два решения, принятые без осознания этого факта, привели к сбоям, описанным в разделе 3. Повторное использование экземпляров Jep по аналогии с объектами пула соединений стало результатом прямого переноса представлений о жизненном цикле объектов JVM на объекты, содержащие нативные указатели. Передача пути к библиотекам на усмотрение окружения по умолчанию стала следствием недооценки того, что нативные зависимости находятся за пределами обычной границы развёртывания приложения JVM. В обоих случаях ничто не препятствовало ошибочному проектному решению на этапе разработки; тревожные сигналы появились только во время выполнения, после того как некорректная реализация уже была создана.
Я пришёл к выводу, что выбор самого Jep был обоснованным. Он позволил интегрировать проверенные ресурсы Python без их переписывания и сохранить структуру, в которой изменения формул, вносимые предметными экспертами, могли немедленно отражаться в системе. Однако компромиссом стало то, что модели памяти, многопоточности и развёртывания пришлось полностью переработать с нуля. Главный вывод этого опыта заключается в том, что для выявления причин сбоев в рабочей среде необходимо сначала понять механизмы работы, лежащие в основе удобства использования.
Pancake Maker