
-Jep、JNI、そしてGIL-
1. はじめに:異種ランタイム(Heterogeneous Runtime)統合が直面する課題
現代のバックエンドアーキテクチャでは、サービスロジックが単一の言語だけで構成されるケースはますます減少しています。数値解析(Numerical Analysis)と機械学習推論の領域では、NumpyやScipyを筆頭とするPythonエコシステムが事実上の標準として定着している一方、トランザクション管理と運用安定性の面では、依然としてJVMベースのスタックが優位に立っています。その結果、バックエンドエンジニアは、異なる2つのランタイム(Runtime)の強みをどのように1つのサービスフローに統合するかという問題に直面することになります。
船舶データプラットフォームも同じ課題を抱えていました。航行中の船舶からエンジンや発電機の状態、タンクレベル、船体姿勢データが毎分単位で取り込まれますが、プラットフォームの本質的な役割は、これらを格納することではなく、船体運動を解析し、正常性能に対する低下レベルを算出する演算(Computation)にあります。問題は、これらの演算が造船工学領域の数式であり、すでにドメイン専門家によってPythonで実装・検証済みの資産である点です。事前学習済みの機械学習モデルとC拡張ライブラリを基盤として構築されているため、Javaには対応実装すら存在せず、船級(Class)承認に関わる計算式では、結果が小数点以下まで従来と一致しなければなりません。
本技術文書では、Java Embedded Python(以下、Jep)を利用してPythonインタープリターをJVMプロセス内部に組み込んだ事例を扱います。初期実装で経験した2つの障害とその対応過程をまず説明し、続いてJepの内部動作構造をJNIおよびGILの観点から分解し、これらの障害がなぜ構造的に必然であったのかを詳しく説明します。
2. 技術選定の背景:プロセス分離とインプロセス組み込みのトレードオフ
検証済みのPython資産をサービスに統合するアプローチは、大きく2つあります。別個のPythonサービスとして分離する方式は、障害分離(Fault Isolation)の面で利点がある一方、呼び出しごとにネットワーク往復(Round Trip)とシリアライズ(Serialization)のコストが発生します。これに対してインプロセス(In-process)組み込みでは、同一プロセスのメモリ空間で直接データをやり取りします。
判断基準は、その演算がリクエスト処理フロー内部に位置するかどうかでした。プラットフォームの演算の大部分は、毎分取り込まれるセンサーデータを受信した時点で即座に計算し、ドメインオブジェクトとして永続化する必要があります。そのため、この経路にHTTPの往復とシリアライズを挿入する実益はないと判断し、インプロセス方式を採用しました。これを可能にするライブラリがJepです。
JepはJythonとは異なり、JVM上でPythonを再実装したものではなく、Cで記述されたオリジナルのPythonインタープリターをJNI(Java Native Interface)経由で呼び出します。NumpyとScipyは大部分がC拡張モジュール(C Extension Module)であり、Jython環境では動作しません。そのため、C拡張との互換性が必須要件だった今回の状況では、選択肢は事実上Jepしかありませんでした。
try (Interpreter interp = new SharedInterpreter()) {
    interp.exec("import numpy as np");
    interp.set("xs", new double[]{1.0, 2.0, 3.0});
    interp.exec("result = float(np.mean(np.array(xs)))");
    double mean = (Double) interp.getValue("result");
}
インターフェースは3つの動詞で構成されます。set()でJavaオブジェクトをPythonのグローバル変数にバインドし、exec()でコードを実行し、getValue()で結果を取り出します。PythonのdictはJavaのMapに、listはListに、ネスト構造も含めて自動的に変換されます。プロセスを分離していたなら、まさにこの箇所にJSONスキーマ定義とシリアライズコードが追加されていたはずです。
3. 初期実装の限界と技術的なペインポイント(Pain Point)
導入初期の実装では、Jepインスタンスを1つ生成して再利用し、ネイティブライブラリのパスはコンテナ環境のデフォルト探索規則に委ねる単純な構造を採用していました。検証環境では欠陥が明らかになりませんでしたが、運用環境の同時実行性とインフラ変更が関与した時点で、性質の異なる2つの問題が発生しました。
3.1. インスタンス再利用設計:スレッドアフィニティ(Thread Affinity)制約の見落とし
初期実装では、インタープリター生成コストを削減する目的で、Jepインスタンスを特定クラスのフィールドに保持し、複数の呼び出しで再利用していました。コネクションプールを扱う感覚からすれば自然な設計であり、単一スレッドの検証区間では正常に動作していました。
しかし、Jepインスタンスはこのように共有できるオブジェクトではありませんでした。詳細な根拠は4.4節で説明しますが、Jepオブジェクトが内部に保持するtstateフィールドが、スレッドごとに1つだけ存在すべきネイティブPyThreadStateポインターだからです。最初に生成したスレッドではない別のワーカースレッドがそのインスタンスにアクセスした時点で、問題が表面化しました。
対応は2つありました。第1に、インタープリター実装をSharedInterpreterに切り替えました。従来の実装には、NumpyのようなC拡張モジュールと互換性がないという別の問題もあったためです(4.3節)。第2に、スレッドアフィニティの問題そのものへの対応として、インスタンスをフィールドに保持する方式を廃止し、try-with-resources構文内で使用時に生成して直ちに解放する構造へ変更しました。スレッド問題を解消したのは後者です。
try (SharedInterpreter jep = new SharedInterpreter()) {
    // 사용하는 스레드에서 직접 생성되고, 블록을 벗어나면 해제됨
}
この変更によりスレッドアフィニティの問題は解消されましたが、その代わりに呼び出しごとにモジュールのimportコストを再度支払うという新たなトレードオフが生じました。この調整については5.2節で扱います。
3.2. 暗黙的なライブラリ探索:インフラ変更に対する脆弱性
2つ目の問題は、アプリケーションコードではなくデプロイ構成層で発生しました。初期段階では、JepネイティブライブラリとPythonランタイムの位置をコンテナ環境のデフォルト探索規則に依存していました。個別の設定がなくても正常に動作していたため、明示的な宣言の必要性を認識していない状態でした。
問題は、実行ノードのLinuxカーネルバージョンが更新された後に表面化しました。ランタイムがライブラリパスを解決できず、アプリケーションは起動段階で失敗しました。アプリケーションコードを1行も変更していないにもかかわらず、インフラ層の変更だけでサービスが起動しない状況になったのです。
対応としては、-Djava.library.path JVMオプションによってネイティブライブラリのパスを明示的に宣言しました。Deploymentマニフェストのspec.template.spec.containers[].argsに、このオプションをコンテナイメージ内のライブラリディレクトリ(例:native-libs)のパスとともに直接追加し、ランタイムの探索規則に依存していた部分を明示的な宣言へ切り替えました。
# deployment.yml
spec:
  template:
    spec:
      containers:
        - args:
            - "-Djava.library.path=/app/native-libs"
この事例が示唆することは明確です。ネイティブ依存性を持つライブラリにおいて、「個別に設定しなくても動作する」状態は、安定性が確保された状態ではなく、単に環境がまだ変化していない状態にすぎません。
4. Jep内部動作構造の分解
3節で述べた2つの障害は、いずれもJepの内部構造から必然的に導かれる結果でした。以下の5つのメカニズムが、Jepベースのシステムの動作と制約を決定します。
4.1. プロセスレイアウト:1つのプロセス、2つの独立したランタイム
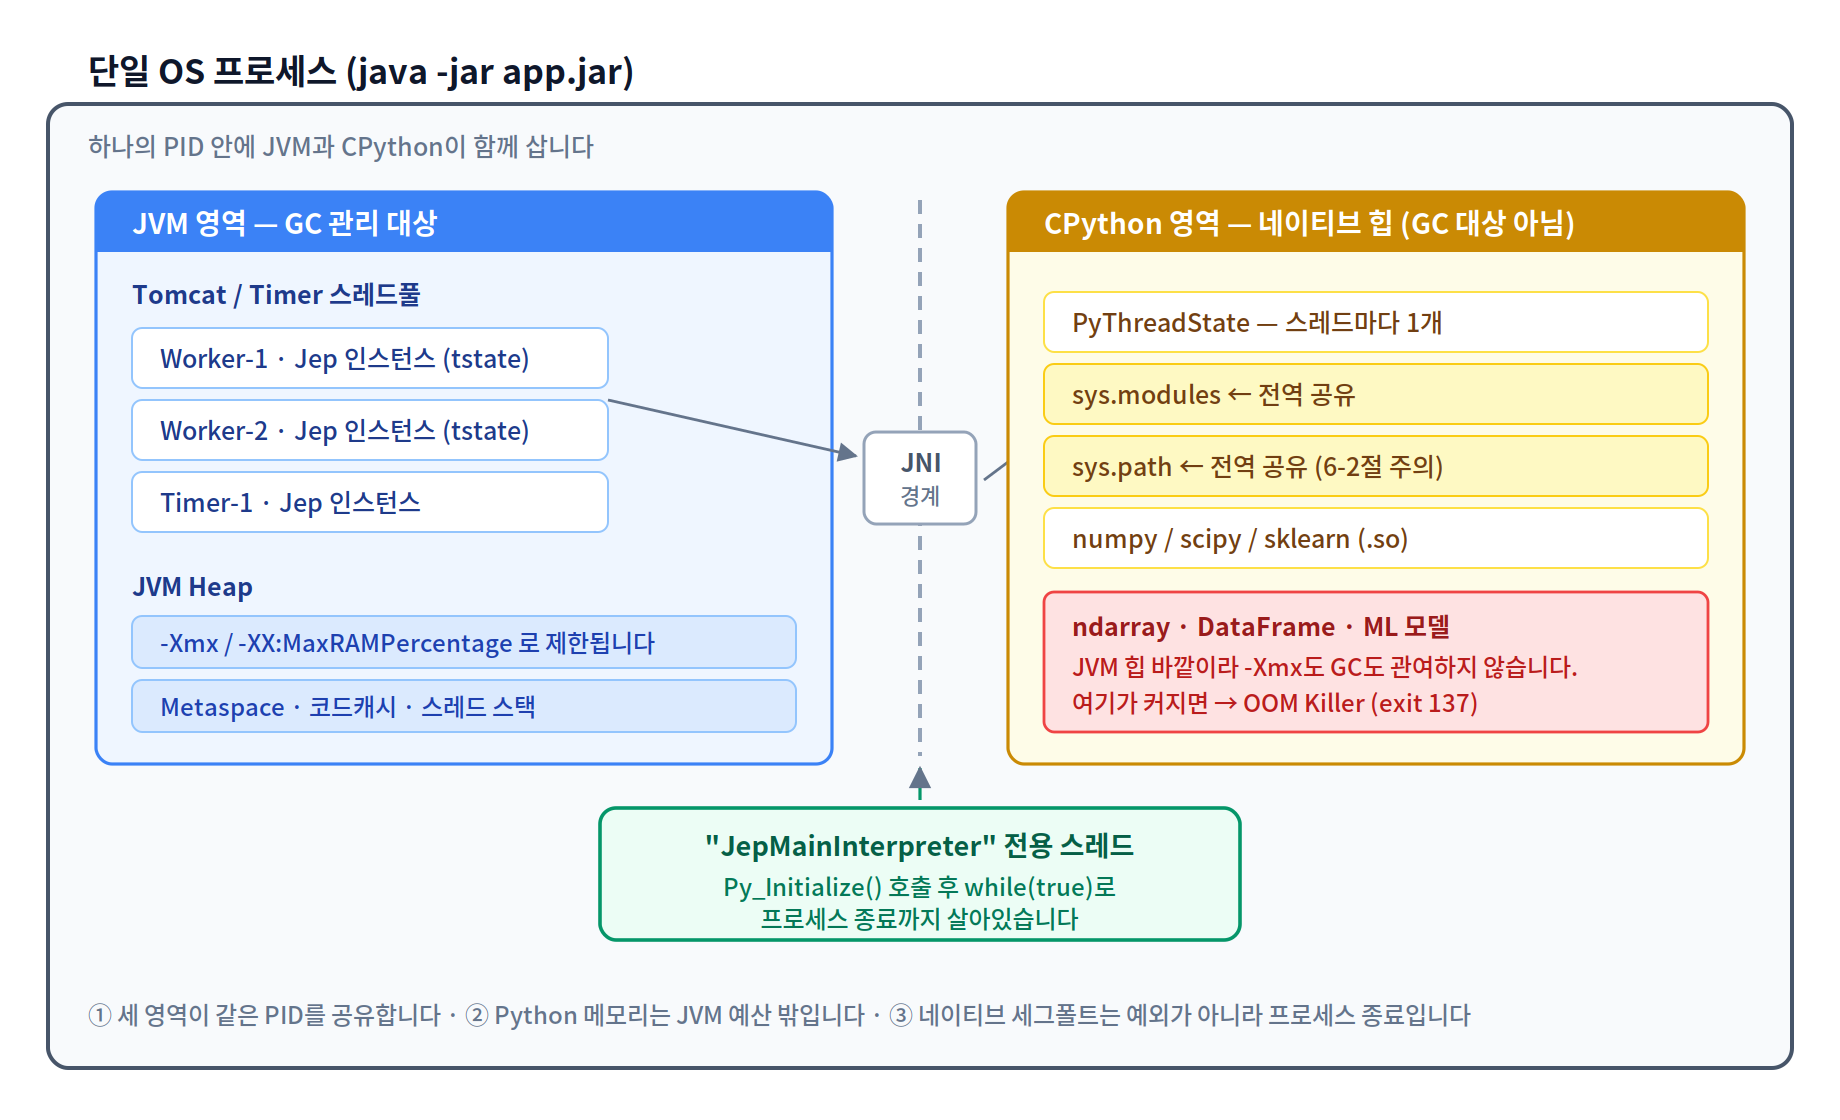
プロセス内部構造
図1。1つのOSプロセス内部で、JNI境界を挟んでJVM領域とPython領域が共存する構造
単一のOSプロセス内部に3つの領域が共存します。JVM領域(スレッドプール、Jepインスタンス、JVM Heap)はすべてGCの管理対象ですが、Python領域(PyThreadState、sys.modules/sys.path、C拡張.so、ndarrayバッファ)はGCの管理対象ではありません。プロセス終了まで存続するJepMainInterpreter専用スレッドも存在します。
最も重要な事実は、PythonのメモリがJVMヒープの外部に割り当てられる点です。Numpy ndarray、pandas DataFrame、joblibモデルはいずれも、JVMが認識できないネイティブメモリ領域に存在し、-Xmx設定とGCはこの領域に関与しません。
4.2. 初期化シーケンス:遅延初期化(Lazy Initialization)とライブラリ探索
// jep/MainInterpreter.java
protected static synchronized MainInterpreter getMainInterpreter() throws Error {
    if (null == instance) {
        instance = new MainInterpreter();
        instance.initialize();
    }
    ...
}
synchronizedキーワードと遅延初期化パターンの組み合わせです。Pythonはアプリケーションの起動時ではなく、最初のnew SharedInterpreter()呼び出し時点で初期化され、これはプロセスのライフサイクル中に一度だけ実行されます。その後のnew SharedInterpreter()呼び出しは、PyThreadStateの生成だけを担当します。
initialize()の第1段階は、System.loadLibrary("jep")によるネイティブライブラリのロードであり、ここが3.2節の障害の根源です。-Djava.library.pathとLD_LIBRARY_PATHを順に参照し、両方が失敗するとLibraryLocatorがsite-packages内部を走査します。パスを明示しなくても動作する可能性はありますが、その動作は実行環境のデフォルト値に全面的に依存します。
続いてPy_Initialize()がJepMainInterpreterという別スレッドで実行されます。ソースコメントによれば、サブインタープリターがメインインタープリターと同じスレッドに配置された場合に発生するGIL問題を回避するためです。このスレッドは無限ループで存続し、終了しません。他のスレッドがPython領域を実行中にこのスレッドが終了すると、状態が破損する可能性があるためです。その結果、Jepを使用するJVMにはこのスレッドがプロセス終了時まで常駐するため、スレッドダンプを分析する際にリークと誤認しないよう、あらかじめ認識しておく必要があります。
4.3. インタープリターモデルの選択:SharedInterpreterとグローバル状態の共有
|
SubInterpreter |
SharedInterpreter |
|
|---|---|---|
|
基盤 |
Py_NewInterpreter() |
メインインタープリターの共有 |
|
sys.modules |
分離 |
共有 |
|
C拡張モジュールの互換性 |
不安定(Numpy/Scipyの多くが非対応) |
安定 |
|
グローバル状態の汚染 |
なし |
あり |
サブインタープリターはインタープリター状態を複数生成する機能ですが、C拡張モジュールがグローバルstatic変数を使用する場合、その状態はインタープリターごとに分離されません。Numpyのような大規模なC拡張がまさにこの構造であるため、サブインタープリター環境では誤動作したり、プロセスが終了したりします。PEP 554およびPEP 684によって改善が進められていますが、現行のスタックでは適用が難しいと判断し、3.1節でSharedInterpreterへ切り替えました。
ただし、この選択には代償があり、Javadocもその点を警告しています。モジュールの動作方式を変更するすべての操作は、すべてのSharedInterpreterに影響します。代表的な例がsys.pathの操作やNumpy.seterr()の呼び出しです。sys.modulesが共有されるため、すべてのインタープリターが同じsys.pathリストを参照します。条件チェックなしにsys.path.append(...)を繰り返すと、パスが累積します。モジュールパスの登録はコードではなく、環境変数で処理するほうが安全です。
4.4. スレッド親和性: tstateが課す制約
// jep/Jep.java
public void isValidThread() throws JepException {
    if (this.thread != Thread.currentThread())
        throw new JepException("Invalid thread access.");
    ...
}
Jepインスタンスは生成スレッドでのみ使用可能であり、すべてのpublicメソッドが進入時点でこれを検証します。3.1節で説明したインスタンス再利用設計が失敗した直接的な原因は、この検証ロジックです。
Pythonインタープリター内部には、「現在このスレッドがどこまで実行中なのか」を保持するデータ構造があります。実行中のコード位置、例外処理の状態、コールスタックなどの情報がここに格納され、この構造体がPyThreadStateです。重要なのは、この構造体がスレッドごとに必ず1つだけ存在しなければならないという点です。
JepはJava側でこの構造体を扱うため、そのメモリアドレスをフィールドとして保持しています。
private long tstate; // 실제로는 PyThreadState의 메모리 주소tstateはこのフィールドの名前であり、thread stateを略した表現です。JavaにはCのポインター概念がないため、long型でアドレス値だけを保持します。
この値がスレッド専用であることが、3.1節の障害の根本原因です。別のスレッドが自分のものではないtstateでPythonコードを実行しようとすると、インタープリター内部の状態が破損します。Jepはこれを防ぐため、メソッドに入るたびに呼び出しスレッドと生成スレッドが一致しているかを検査します。Javadocには、単一スレッドで複数のインタープリターを同時にアクティブ化することも不可能であると明記されています。
1つのスレッドに1つ、かつそのスレッドでのみという2つの制約を満たす最も単純な方法が、使用時に生成して直ちに解放するtry-with-resources構造です。
4.5. グローバルインタープリターロック(GIL、Global Interpreter Lock)による直列化
JepはGILを取り除きません。Javaスレッドがjep.eval(...)を呼び出すと、GILを取得してから戻り時点で解放するため、数十のJavaスレッドが同時に呼び出しても、Pythonバイトコードを実際に実行するスレッドは常に1つです。
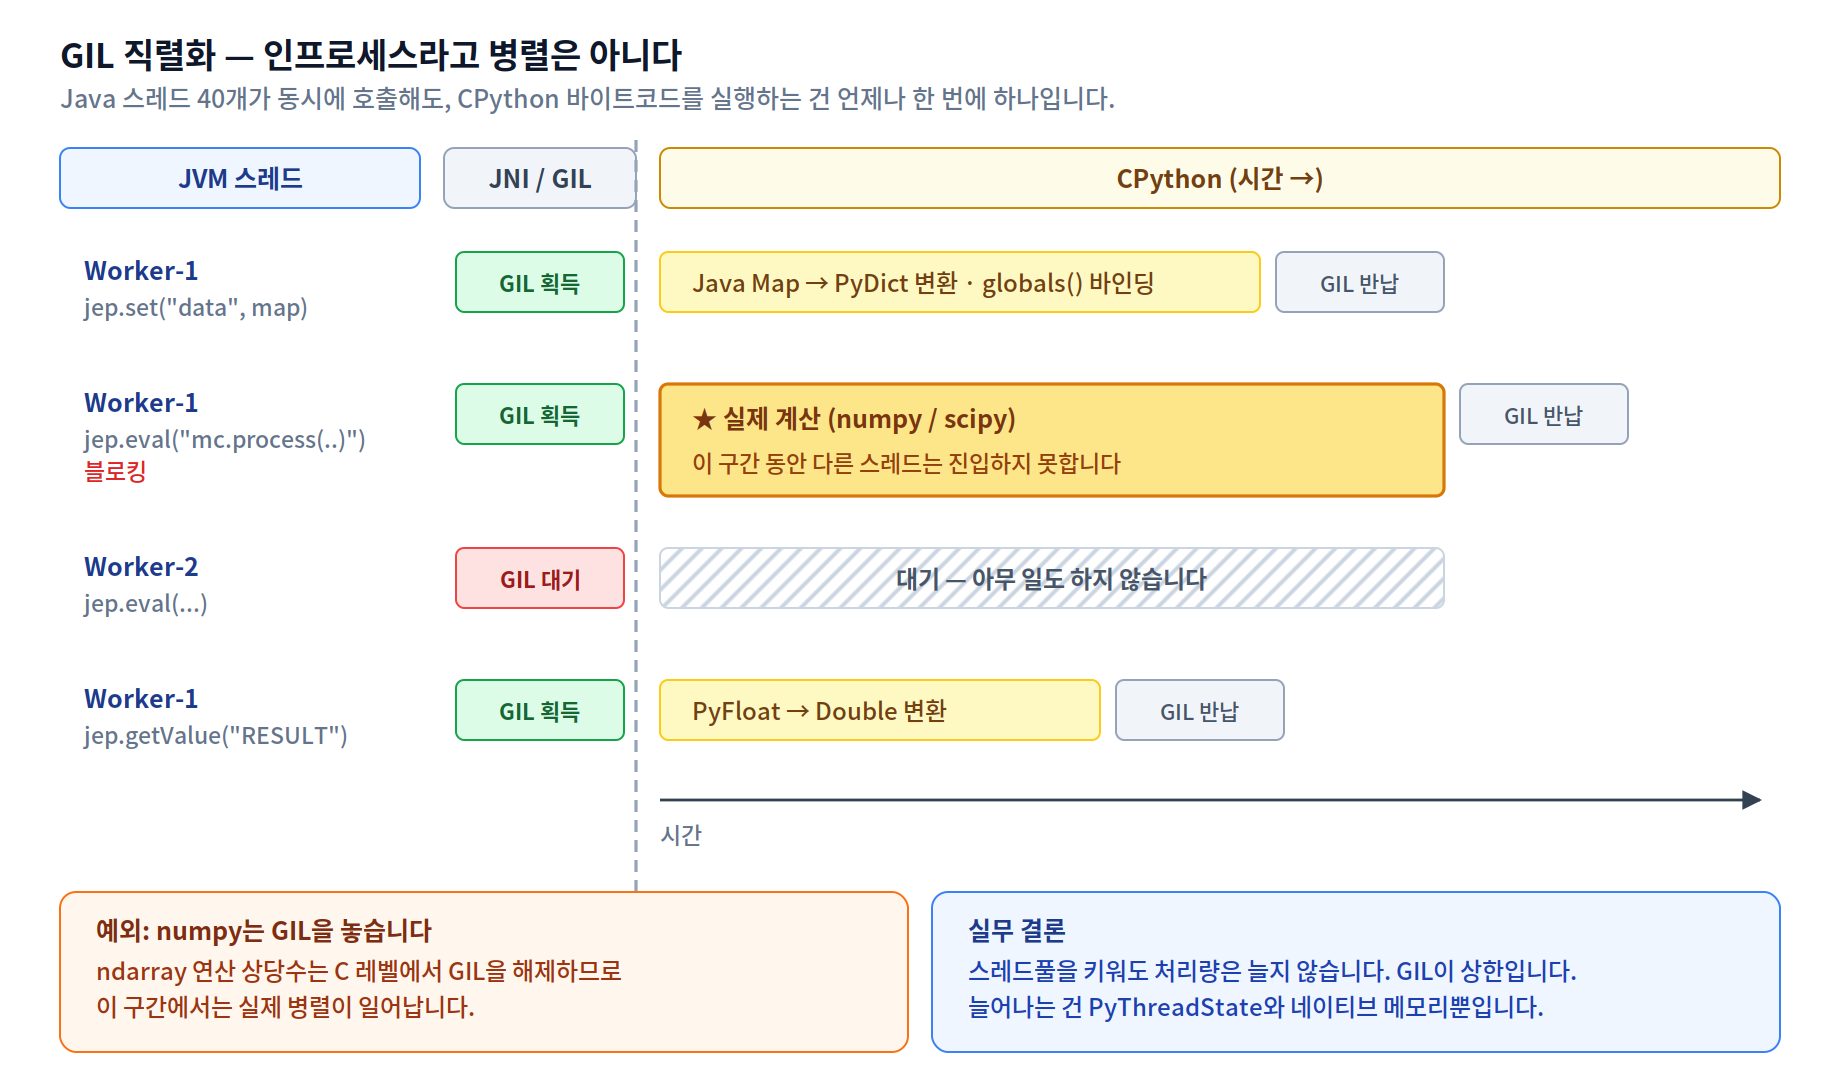
GILによる直列化のタイムライン
図2. Worker-1が処理を実行している間、Worker-2はGILを待機し、実行が直列化される構造
ただし、Numpyの重量級演算の多くは内部でGILを解放します。純粋なPythonループは完全に直列化されますが、ndarray演算の区間では実質的な並列処理が発生するため、演算ロジックを可能な限りNumpy層に委譲するのが有利です。
したがって、Pythonの演算パスのスレッドプールを拡張しても、スループット(Throughput)は増加しません。GILが上限として作用し、むしろスレッドごとにPyThreadStateとglobals dictが生成されるため、ネイティブメモリ使用量だけが増加します。CPUバウンド(CPU-bound)処理を実質的に並列化するには、プロセス分離が必要です。
5. 構造的制約から導かれる3つの運用原則
5.1. コンテナのメモリ予算の再算定
4.1節で見たとおり、Python層のメモリはJVMヒープの外部に位置します。-XX:MaxRAMPercentage=80は一般的なSpring Bootコンテナでは合理的ですが、JepサービスではPythonインタープリター・モジュール・ndarray・MLモデルのすべてを残り20%以内に収めなければならないことを意味します。予算を超過すると、OutOfMemoryErrorではなくカーネルのOOM Killerがコンテナを終了させ、ヒープダンプなしにexit code 137だけが確認されます。適正値は実際にPython側がどれだけメモリを使用するかによって決まるため、コンテナが実際に使用しているメモリ量を監視ツールで直接計測し、逆算する方法以外にありません。
5.2. インタープリターの寿命を作業単位に合わせる
3.1節の対応によってスレッド親和性の問題は解消されましたが、呼び出し単位でインタープリターを生成すると、呼び出しのたびにモジュールのimportコストが再発生するという問題が残りました。インタープリターの寿命は個々の呼び出しではなく、論理的な作業単位(Unit of Work)に合わせるのが合理的です。
// getJep(): SharedInterpreter 생성 + 모듈 import
try (SharedInterpreter jep = this.getJep()) {
   flowA.createBaseline(jep, targetId, param);
   flowB.createBaseline(jep, targetId, param);
   flowC.createBaseline(jep, targetId, param);
}
インスタンスをフィールドに保持しないためスレッド親和性の制約は維持される一方、初期化コストはバッチ単位で償却されます。
5.3. 障害の爆発半径(Blast Radius)の事前設計
C拡張コードが誤ったメモリ領域にアクセスすると(一般にセグフォルトと呼ばれる状況)、Java例外ではなくプロセス自体が停止します。これはtry-catchで捕捉できず、JVM層で復旧する方法もないということです。Python呼び出しを実行するサービスと純粋なドメインサービスを分離しておけば、このような事態が起きても障害の範囲をそのサービス内に限定できます。
6. 結論: エンベディング(Embedding)ではなく共存(Coexistence)がもたらす教訓
この導入プロセスを通じて得た最も価値ある教訓は、「エンベディングという用語は、一方のランタイムがもう一方を制御する構造のように聞こえますが、実際には2つの独立したランタイムが同一プロセス内で共存している状態を意味する」という点です。
この事実を認識しないまま下した2つの判断が、3節の障害につながりました。Jepインスタンスをコネクションプールの感覚で再利用したのは、JVMオブジェクトのライフサイクルに対する感覚を、ネイティブポインターを保持するオブジェクトにそのまま適用した結果でした。また、ライブラリパスを環境のデフォルト値に委ねたのは、ネイティブ依存関係がJVMアプリケーションの通常のデプロイ境界の外側にあるという事実を見落とした結果でした。どちらのケースも設計時には何も阻止してくれず、誤ったものを作った後になって初めて、ランタイムからシグナルが届きました。
Jepの導入自体は妥当な選択だったと判断しています。検証済みのPython資産を再作成することなく統合でき、ドメイン専門家による数式の修正を直ちに反映できる構造を維持できました。ただし、その代償としてメモリ・スレッド・デプロイモデルを最初から再設計する必要がありました。利便性の裏側にある動作構造を先に理解してこそ、運用段階で発生する障害の原因にたどり着けるというのが、今回の経験から得た結論です。
Pancake Maker