
-Jep, JNI, 그리고 GIL-
1. 서론: 이기종 런타임(Heterogeneous Runtime) 통합의 당면 과제
현대의 백엔드 아키텍처에서 서비스 로직이 단일 언어로만 구성되는 경우는 점점 줄어들고 있습니다. 수치 해석(Numerical Analysis)과 머신러닝 추론 영역은 Numpy와 Scipy를 필두로 한 Python 생태계가 사실상의 표준으로 자리 잡은 반면, 트랜잭션 관리와 운영 안정성 측면에서는 여전히 JVM 기반 스택이 우위를 점하고 있습니다. 결과적으로 백엔드 엔지니어는 서로 다른 두 런타임(Runtime)의 강점을 어떻게 하나의 서비스 흐름 안에 통합할 것인가라는 문제에 직면하게 됩니다.
선박 데이터 플랫폼 역시 동일한 과제를 안고 있었습니다. 항해 중인 선박에서 엔진 및 발전기 상태, 탱크 레벨, 선체 자세 데이터가 매분 단위로 인입되지만, 플랫폼의 본질적인 역할은 이를 적재하는 것이 아니라 선체 운동을 해석하고 정상 성능 대비 저하 수준을 산출하는 연산(Computation)에 있습니다. 문제는 이 연산들이 조선공학 영역의 수식이며, 이미 도메인 전문가들에 의해 Python으로 작성되고 검증까지 완료된 자산이라는 점입니다. 사전 학습된 머신러닝 모델과 C 확장 라이브러리 위에 구축되어 있어 Java에는 대응 구현체조차 존재하지 않으며, 선급(Class) 승인이 결부된 계산식은 결과가 소수점 아래까지 기존과 일치해야 합니다.
본 기술 문서에서는 Java Embedded Python(이하 Jep)을 활용하여 Python 인터프리터를 JVM 프로세스 내부에 임베딩(Embedding)한 사례를 다룹니다. 초기 구현에서 겪은 두 가지 장애와 그 대응 과정을 먼저 기술하고, 이어서 Jep의 내부 동작 구조를 JNI 및 GIL 관점에서 분해하여 해당 장애들이 왜 구조적으로 필연이었는지를 상세히 서술합니다.
2. 기술 선택의 배경: 프로세스 분리와 인프로세스 임베딩의 트레이드 오프
검증된 Python 자산을 서비스에 통합하는 접근법은 크게 두 가지입니다. 별도 Python 서비스로 분리하는 방식은 장애 격리(Fault Isolation) 측면에서 이점이 있으나 호출마다 네트워크 왕복(Round Trip)과 직렬화(Serialization) 비용이 발생하고, 인프로세스(In-process) 임베딩은 동일 프로세스 메모리 공간에서 직접 데이터를 주고받습니다.
판단 기준은 해당 연산이 요청 처리 흐름 내부에 위치하는가였습니다. 플랫폼의 연산 대부분은 매분 인입되는 센서 데이터를 수신한 시점에 즉시 계산해 도메인 객체로 영속화해야 하므로, 이 경로에 HTTP 왕복과 직렬화를 삽입하는 것은 실익이 없다고 판단해 인프로세스 방식을 채택했습니다. 이를 가능하게 하는 라이브러리가 Jep입니다.
Jep은 Jython과 달리 JVM 위에서 Python을 재구현한 것이 아니라, C로 작성된 원본 Python 인터프리터를 JNI(Java Native Interface)를 통해 호출합니다. Numpy와 Scipy는 대부분 C 확장 모듈(C Extension Module)이며 Jython 환경에서는 구동되지 않으므로, C 확장 호환성이 필수 요건이었던 상황에서 선택지는 사실상 Jep 하나였습니다.
try (Interpreter interp = new SharedInterpreter()) {
    interp.exec("import numpy as np");
    interp.set("xs", new double[]{1.0, 2.0, 3.0});
    interp.exec("result = float(np.mean(np.array(xs)))");
    double mean = (Double) interp.getValue("result");
}
인터페이스는 세 개의 동사로 구성됩니다. set()으로 Java 객체를 Python 전역 변수에 바인딩하고, exec()로 코드를 실행하며, getValue()로 결과를 추출합니다. Python dict는 Java Map으로, list는 List로 중첩 구조까지 자동 변환됩니다. 프로세스를 분리했다면 정확히 이 지점에 JSON 스키마 정의와 직렬화 코드가 추가되었을 것입니다.
3. 초기 구현의 한계점과 기술적 페인 포인트(Pain Point)
도입 초기의 구현은 Jep 인스턴스를 하나 생성해 재사용하고, 네이티브 라이브러리 경로는 컨테이너 환경의 기본 탐색 규칙에 위임하는 단순한 구조였습니다. 검증 환경에서는 결함이 드러나지 않았으나, 운영 환경의 동시성과 인프라 변경이 개입되는 시점에 서로 다른 성격의 두 가지 문제가 발생했습니다.
3.1. 인스턴스 재사용 설계: 스레드 친화성(Thread Affinity) 제약의 간과
초기 구현에서는 인터프리터 생성 비용을 절감할 목적으로 Jep 인스턴스를 특정 클래스의 필드에 보관하고 여러 호출에서 재사용했습니다. 커넥션 풀을 다루는 감각에서 보면 자연스러운 설계였고, 단일 스레드 검증 구간에서는 정상 동작했습니다.
그러나 Jep 인스턴스는 이렇게 공유할 수 있는 객체가 아니었습니다. 상세 근거는 4.4절에서 기술하겠으나, Jep 객체가 내부에 보유한 tstate 필드가 스레드당 하나만 존재해야 하는 네이티브 PyThreadState 포인터이기 때문입니다. 최초 생성 스레드가 아닌 다른 워커 스레드가 해당 인스턴스에 접근하는 시점에 문제가 표면화되었습니다.
대응은 두 가지였습니다. 첫째, 인터프리터 구현체를 SharedInterpreter로 전환했습니다. 기존 구현체는 Numpy 같은 C 확장 모듈과 호환되지 않는 문제가 별도로 있었기 때문입니다(4.3절). 둘째, 스레드 친화성 문제 자체에 대한 대응으로, 인스턴스를 필드에 보관하는 방식을 폐기하고 try-with-resources 구문 내에서 사용 시점에 생성한 뒤 즉시 해제하는 구조로 변경했습니다. 스레드 문제를 해소한 것은 후자입니다.
try (SharedInterpreter jep = new SharedInterpreter()) {
    // 사용하는 스레드에서 직접 생성되고, 블록을 벗어나면 해제됨
}
이 변경으로 스레드 친화성 문제는 해소되었으나, 대신 호출마다 모듈 import 비용을 재지불하는 새로운 트레이드 오프가 발생했습니다. 이에 대한 조정은 5.2절에서 다룹니다.
3.2. 암묵적 라이브러리 탐색: 인프라 변경에 대한 취약성
두 번째 문제는 애플리케이션 코드가 아니라 배포 구성 계층에서 발생했습니다. 초기에는 Jep 네이티브 라이브러리와 Python 런타임의 위치를 컨테이너 환경의 기본 탐색 규칙에 의존하고 있었습니다. 별도 설정 없이도 정상 동작했기 때문에 명시적 선언의 필요성을 인지하지 못한 상태였습니다.
문제는 실행 노드의 리눅스 커널 버전이 상향된 이후 표면화되었습니다. 런타임이 라이브러리 경로를 해석하지 못했고, 애플리케이션은 기동 단계에서 실패했습니다. 애플리케이션 코드는 한 줄도 변경되지 않은 상태에서, 인프라 계층의 변경만으로 서비스가 기동하지 않는 상황이었습니다.
대응은 -Djava.library.path JVM 옵션을 통해 네이티브 라이브러리 경로를 명시적으로 선언하는 방식이었습니다. Deployment 매니페스트의 spec.template.spec.containers[].args에 해당 옵션을 컨테이너 이미지 내 라이브러리 디렉터리(예: native-libs) 경로와 함께 직접 추가하여, 런타임의 탐색 규칙에 의존하던 부분을 명시적 선언으로 전환했습니다.
# deployment.yml
spec:
  template:
    spec:
      containers:
        - args:
            - "-Djava.library.path=/app/native-libs"
이 사례가 시사하는 바는 명확합니다. 네이티브 의존성을 갖는 라이브러리에서 “별도로 설정하지 않아도 동작하는” 상태는 안정성이 확보된 상태가 아니라, 환경이 아직 변하지 않은 상태일 뿐입니다.
4. Jep 내부 동작 구조의 분해
3절의 두 장애는 모두 Jep의 내부 구조에서 필연적으로 도출되는 결과였습니다. 다음의 다섯 가지 메커니즘이 Jep 기반 시스템의 동작과 제약을 결정합니다.
4.1. 프로세스 레이아웃: 하나의 프로세스, 두 개의 독립 런타임
프로세스 내부 구조
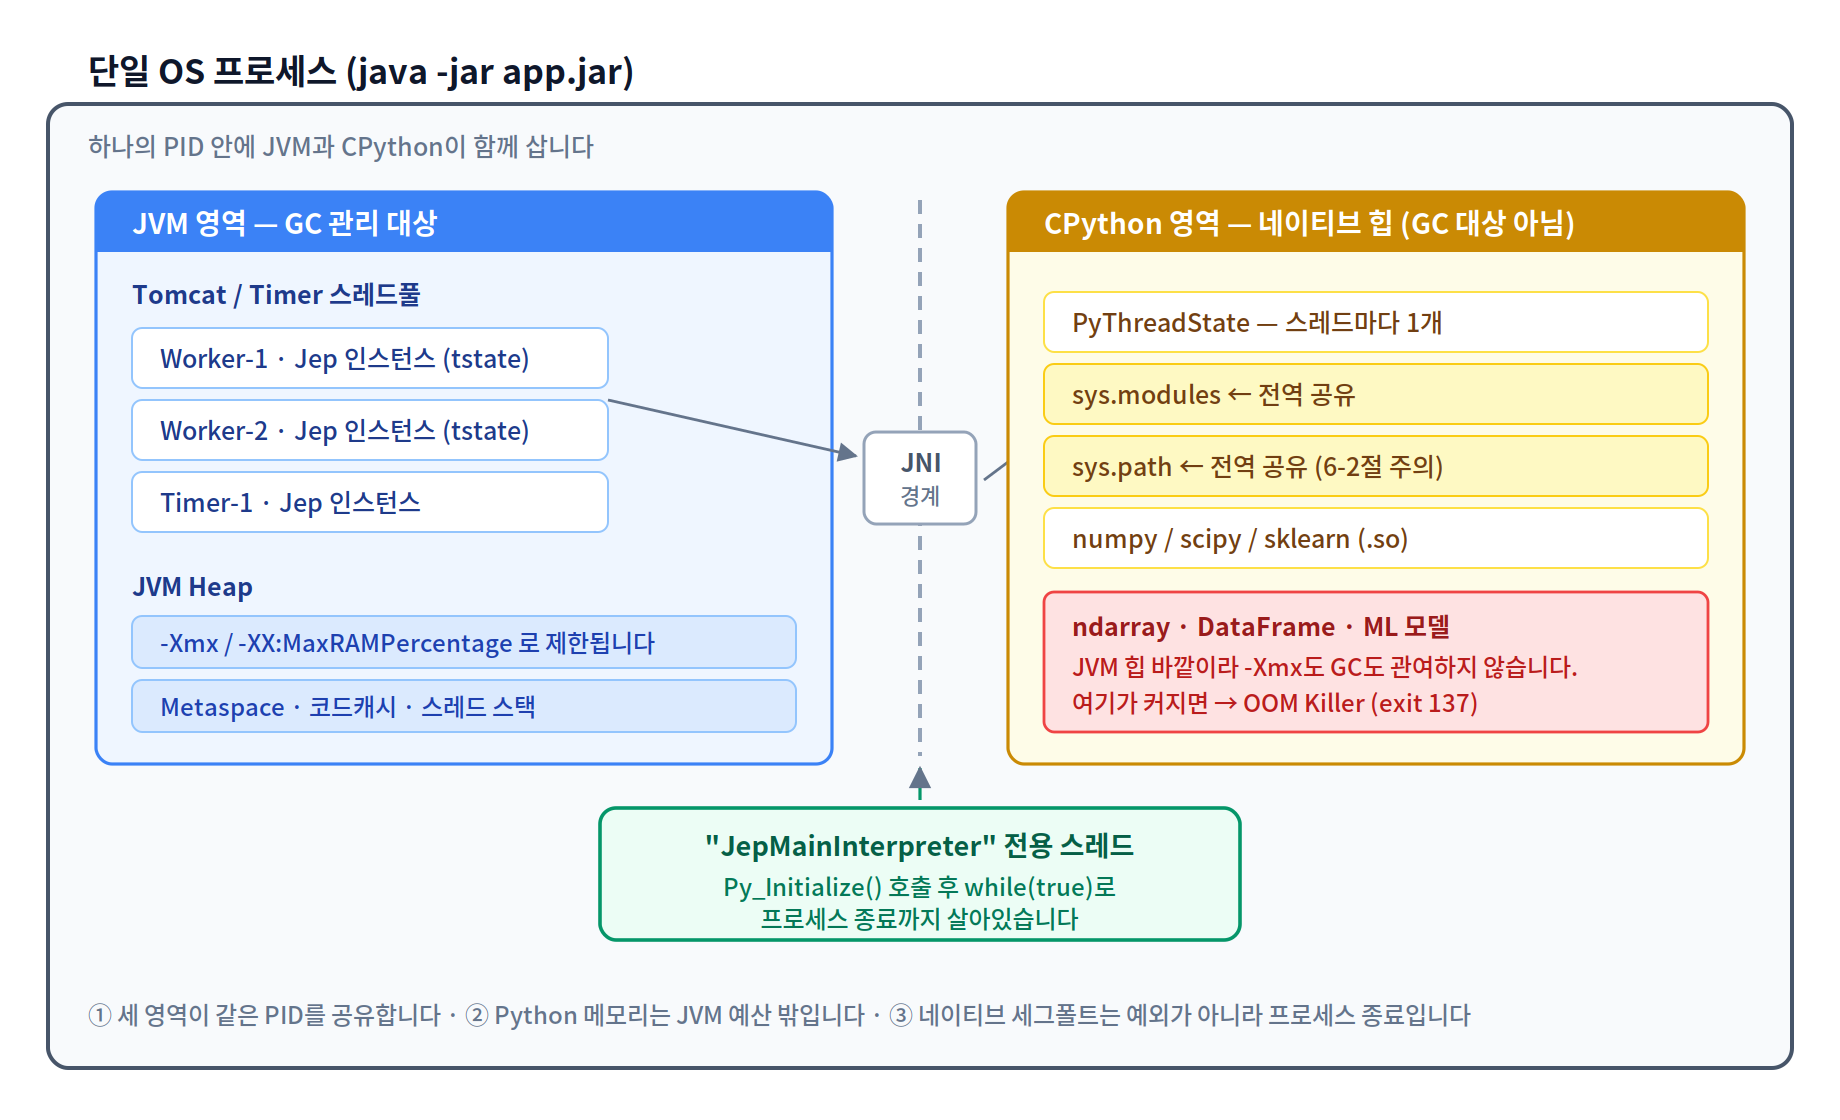
그림 1. 하나의 OS 프로세스 내부에 JVM 영역과 Python 영역이 JNI 경계를 사이에 두고 공존하는 구조
단일 OS 프로세스 내부에 세 영역이 공존합니다. JVM 영역(스레드풀, Jep 인스턴스, JVM Heap)은 전부 GC 관리 대상이고, Python 영역(PyThreadState, sys.modules/sys.path, C 확장 .so, ndarray 버퍼)은 GC 관리 대상이 아닙니다. 프로세스 종료까지 존속하는 JepMainInterpreter 전용 스레드도 존재합니다.
가장 중요한 사실은 Python의 메모리가 JVM 힙 외부에 할당된다는 점입니다. Numpy ndarray, pandas DataFrame, joblib 모델은 모두 JVM이 인지하지 못하는 네이티브 메모리 영역에 존재하며, -Xmx 설정과 GC는 이 영역에 관여하지 않습니다.
4.2. 초기화 시퀀스: 지연 초기화(Lazy Initialization)와 라이브러리 탐색
// jep/MainInterpreter.java
protected static synchronized MainInterpreter getMainInterpreter() throws Error {
    if (null == instance) {
        instance = new MainInterpreter();
        instance.initialize();
    }
    ...
}
synchronized 키워드와 지연 초기화 패턴의 조합입니다. Python은 애플리케이션 기동 시점이 아니라 최초의 new SharedInterpreter() 호출 시점에 초기화되며, 이는 프로세스 생애 주기 동안 단 한 번만 수행됩니다. 이후의 new SharedInterpreter() 호출은 PyThreadState 생성만을 담당합니다.
initialize()의 첫 단계는 System.loadLibrary("jep")를 통한 네이티브 라이브러리 로딩이며, 이 지점이 3.2절 장애의 근원입니다. -Djava.library.path와 LD_LIBRARY_PATH를 차례로 참조하고, 둘 다 실패하면 LibraryLocator가 site-packages 내부를 순회합니다. 경로가 명시되지 않아도 동작할 수 있으나, 그 동작은 실행 환경의 기본값에 전적으로 의존합니다.
이어서 Py_Initialize()가 JepMainInterpreter라는 별도 스레드에서 수행되는데, 소스 주석에 따르면 서브인터프리터가 메인 인터프리터와 동일한 스레드에 위치할 때 생기는 GIL 문제를 피하기 위해서입니다. 이 스레드는 무한 루프로 존속하며 종료되지 않습니다. 다른 스레드가 Python 영역 실행 중에 이 스레드가 종료되면 상태가 손상될 수 있기 때문입니다. 결과적으로 Jep을 사용한 JVM에는 이 스레드가 프로세스 종료 시점까지 상주하므로, 스레드 덤프 분석 시 누수로 오인하지 않도록 인지해 두어야 합니다.
4.3. 인터프리터 모델 선택: SharedInterpreter와 전역 상태 공유
|
SubInterpreter |
SharedInterpreter |
|
|---|---|---|
|
기반 |
Py_NewInterpreter() |
메인 인터프리터 공유 |
|
sys.modules |
격리 |
공유 |
|
C 확장 모듈 호환성 |
불안정 (Numpy/Scipy 다수 미지원) |
안정 |
|
전역 상태 오염 |
없음 |
있음 |
서브인터프리터는 인터프리터 상태를 복수로 생성하는 기능이나, C 확장 모듈이 전역 static 변수를 쓰는 경우 그 상태가 인터프리터별로 분리되지 않습니다. Numpy 같은 대규모 C 확장이 정확히 이 구조라서, 서브인터프리터 환경에서는 오동작하거나 프로세스가 종료됩니다. PEP 554 및 PEP 684로 개선이 진행 중이지만 현재 스택 기준으로는 적용이 어렵다고 판단해 3.1절에서 SharedInterpreter로 전환했습니다.
다만 이 선택에는 대가가 따르며, Javadoc 또한 이를 경고합니다. 모듈 동작 방식을 바꾸는 모든 행위는 전체 SharedInterpreter에 영향을 미치며, sys.path 조작이나 Numpy.seterr() 호출이 대표적인 사례입니다. sys.modules가 공유되므로 모든 인터프리터가 동일한 sys.path 리스트를 참조하며, 조건 검사 없이 sys.path.append(...)를 반복하면 경로가 누적됩니다. 모듈 경로 등록은 코드가 아닌 환경변수로 처리하는 편이 안전합니다.
4.4. 스레드 친화성: tstate가 강제하는 제약
// jep/Jep.java
public void isValidThread() throws JepException {
    if (this.thread != Thread.currentThread())
        throw new JepException("Invalid thread access.");
    ...
}
Jep 인스턴스는 생성 스레드에서만 사용 가능하며, 모든 public 메서드가 진입 시점에 이를 검증합니다. 3.1절에서 기술한 인스턴스 재사용 설계가 실패한 직접적인 원인이 이 검증 로직입니다.
Python 인터프리터 내부에는 "지금 이 스레드가 어디까지 실행 중인지"를 담아두는 자료구조가 있습니다. 실행 중인 코드 위치, 예외 처리 상태, 호출 스택 같은 정보가 여기 들어가며, 이 구조체가 PyThreadState입니다. 핵심은 이 구조체가 스레드 하나당 반드시 하나씩만 존재해야 한다는 점입니다.
Jep은 Java 쪽에서 이 구조체를 다루기 위해 그 메모리 주소를 필드로 들고 있습니다.
private long tstate; // 실제로는 PyThreadState의 메모리 주소tstate는 이 필드의 이름이며, thread state를 줄인 표현입니다. Java에는 C의 포인터 개념이 없으므로 long 타입으로 주소값만 보관합니다.
이 값이 스레드 전용이라는 사실이 3.1절 장애의 근본 원인입니다. 다른 스레드가 자신의 것이 아닌 tstate로 Python 코드를 실행하려 하면 인터프리터 내부 상태가 손상되며, Jep은 이를 막기 위해 메서드 진입 시마다 호출 스레드와 생성 스레드의 일치 여부를 검사합니다. Javadoc은 단일 스레드에서 복수 인터프리터를 동시에 활성화하는 것 역시 불가능함을 명시합니다.
한 스레드에 하나, 그 스레드에서만이라는 두 제약을 충족시키는 가장 단순한 방법이 사용 시점에 생성하고 즉시 해제하는 try-with-resources 구조입니다.
4.5. 전역 인터프리터 락(GIL, Global Interpreter Lock)의 직렬화
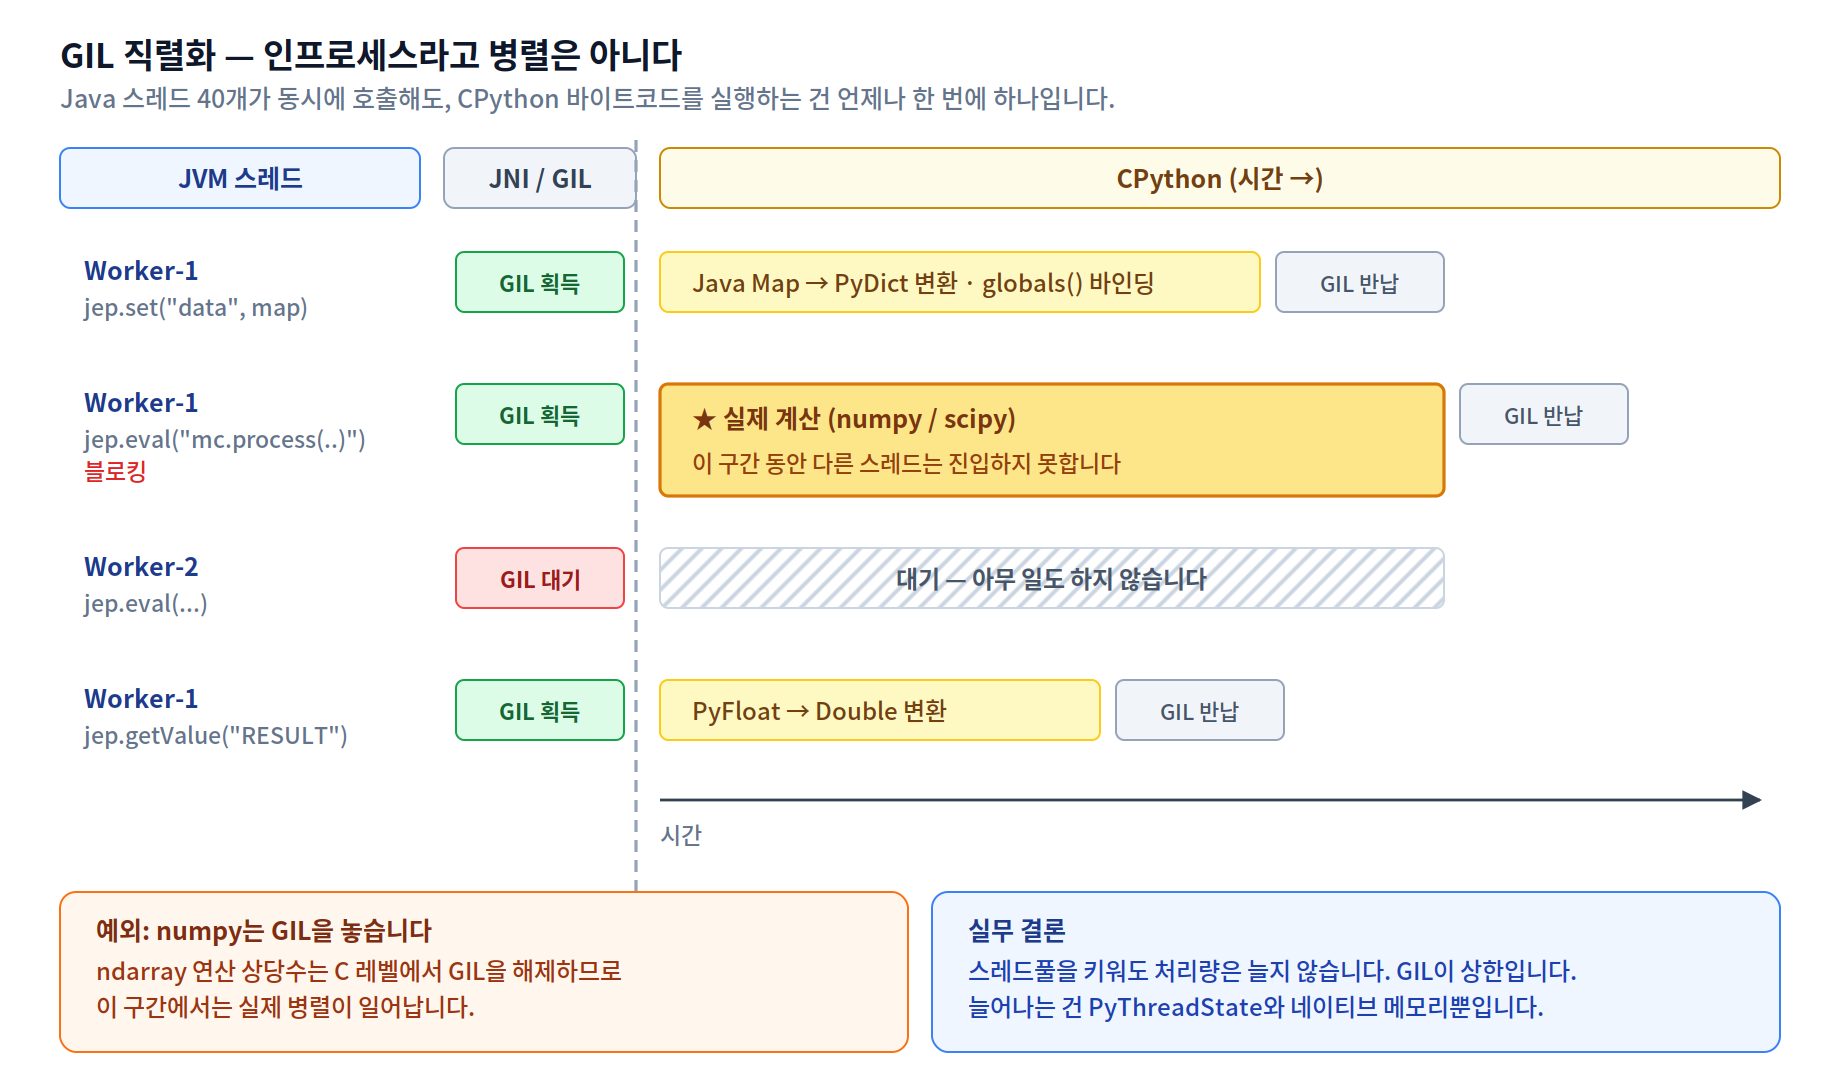
Jep은 GIL을 제거하지 않습니다. Java 스레드가 jep.eval(...)을 호출하면 GIL을 획득한 뒤 반환 시점에 반납하므로, 수십 개의 Java 스레드가 동시에 호출해도 Python 바이트코드를 실제로 수행하는 스레드는 항상 하나입니다.
GIL 직렬화 타임라인
그림 2. Worker-1이 연산을 수행하는 동안 Worker-2는 GIL을 대기하며, 실행이 직렬화되는 구조
다만 Numpy의 중량 연산 상당수는 내부적으로 GIL을 반납합니다. 순수 Python 루프는 완전히 직렬화되지만 ndarray 연산 구간에서는 실질적인 병렬 처리가 발생하므로, 연산 로직을 가능한 한 Numpy 계층으로 위임하는 것이 유리합니다.
따라서 Python 연산 경로의 스레드풀을 확장하더라도 처리량(Throughput)은 증가하지 않습니다. GIL이 상한으로 작용하며, 오히려 스레드마다 PyThreadState와 globals dict가 생성되어 네이티브 메모리 사용량만 증가합니다. CPU 바운드(CPU-bound) 작업의 실질적 병렬화를 위해서는 프로세스 분리가 필요합니다.
5. 구조적 제약에서 도출되는 3가지 운영 원칙
5.1. 컨테이너 메모리 예산의 재산정
4.1절에서 본 대로 Python 계층의 메모리는 JVM 힙 외부에 위치합니다. -XX:MaxRAMPercentage=80은 일반 Spring Boot 컨테이너에서는 합리적이나, Jep 서비스에서는 Python 인터프리터·모듈·ndarray·ML 모델이 전부 잔여 20% 내에서 해결돼야 함을 의미합니다. 예산을 초과하면 OutOfMemoryError가 아니라 커널의 OOM Killer가 컨테이너를 종료시키며, 힙 덤프 없이 exit code 137만 확인됩니다. 적정값은 실제로 Python 쪽이 얼마나 메모리를 쓰는지에 달려 있으므로, 컨테이너가 실제 점유 중인 메모리량을 모니터링 도구로 직접 찍어보고 거꾸로 계산하는 방법 외에는 없습니다.
5.2. 인터프리터 수명의 작업 단위 정렬
3.1절의 대응으로 스레드 친화성 문제는 해소되었으나, 호출 단위로 인터프리터를 생성하면 매 호출마다 모듈 import 비용이 재발생한다는 문제가 남았습니다. 인터프리터의 수명은 개별 호출이 아니라 논리적 작업 단위(Unit of Work)에 정렬시키는 것이 합리적입니다.
// getJep(): SharedInterpreter 생성 + 모듈 import
try (SharedInterpreter jep = this.getJep()) {
   flowA.createBaseline(jep, targetId, param);
   flowB.createBaseline(jep, targetId, param);
   flowC.createBaseline(jep, targetId, param);
}
인스턴스를 필드에 보관하지 않으므로 스레드 친화성 제약은 유지되면서, 초기화 비용은 배치 단위로 상각됩니다.
5.3. 장애 폭발 반경(Blast Radius)의 사전 설계
C 확장 코드가 잘못된 메모리 영역을 건드리면(흔히 세그폴트라 부르는 상황) Java 예외가 아니라 프로세스 자체가 죽습니다. try-catch로 잡을 수 없고 JVM 계층에서 복구할 방법도 없다는 뜻입니다. Python 호출을 수행하는 서비스와 순수 도메인 서비스를 분리해 두면, 이런 일이 나도 장애 범위를 그 서비스 안으로 한정할 수 있습니다.
6. 결론: 임베딩(Embedding)이 아니라 공존(Coexistence)이 주는 교훈
본 도입 과정을 통해 얻은 가장 값진 교훈은 “임베딩이라는 용어가 한쪽 런타임이 다른 쪽을 통제하는 구조처럼 들리지만, 실제로는 두 개의 독립적인 런타임이 동일 프로세스 내에서 공존하는 상태를 의미한다”는 점입니다.
이 사실을 인지하지 못한 상태에서 내린 두 번의 판단이 3절의 장애로 이어졌습니다. Jep 인스턴스를 커넥션 풀 감각으로 재사용한 것은 JVM 객체의 생명주기 감각을 네이티브 포인터 보유 객체에 그대로 적용한 결과였고, 라이브러리 경로를 환경 기본값에 위임한 것은 네이티브 의존성이 JVM 애플리케이션의 통상적인 배포 경계 밖에 있다는 사실을 간과한 결과였습니다. 두 사례 모두 설계 시점에는 아무것도 막아주지 않았고, 이미 잘못 만든 뒤 런타임에서야 신호가 왔습니다.
Jep 도입 자체는 타당한 선택이었다고 판단합니다. 검증된 Python 자산을 재작성 없이 통합할 수 있었고, 도메인 전문가의 수식 수정이 곧바로 반영되는 구조를 유지할 수 있었습니다. 다만 그 대가로 메모리·스레드·배포 모델을 처음부터 다시 설계해야 했습니다. 편의성 이면의 동작 구조를 먼저 이해해야, 운영 단계의 장애 원인에 접근할 수 있다는 것이 이번 경험의 결론입니다.
Pancake Maker