
Интегрированный дизайн бэкенда с сохранением границ сервисов и продвижением общей автоконфигурации
1. Введение
По мере увеличения числа микросервисов растёт не только бизнес-функциональность. Для каждого сервиса требуется Pod, а внутри каждой JVM создаются Spring Context, пул потоков и пул соединений. Цели развёртывания и мониторинга также увеличиваются пропорционально числу сервисов. Если даже сервисы с низким трафиком поддерживаются как независимые исполняемые единицы, границы сервисов остаются чёткими, однако это приводит к дублированию ресурсов времени выполнения и увеличению операционных издержек.
Непосредственной причиной пересмотра подхода к интеграции стал проект в сфере здравоохранения. На тот момент было выявлено примерно 90 ограниченных контекстов (Bounded Contexts), и, исходя из предположения, что каждый BC содержит 3–5 сервисов, могло потребоваться 250–300 исполняемых экземпляров. Это естественная конфигурация, если каждый сервис должен масштабироваться независимо, однако тот факт, что одинаковые затраты на выполнение возникали бы даже для сервисов с низкой фактической нагрузкой, потребовал дополнительного рассмотрения.
Мы не планировали с самого начала внедрять MultiDatasource. Отправной точкой стал следующий вопрос.
Можем ли мы снизить постоянные затраты на Pods и JVM, сохранив логические границы сервисов?
Чтобы ответить на этот вопрос, в статье обобщаются рассмотренные нами подходы к интеграции, PoC интеграции на уровне исходного кода, процесс применения MultiDatasource и наш опыт устранения конфликтов Spring Context. В статье также объясняется, почему конфигурации, повторявшиеся в нескольких сервисах, были вынесены в общую автоконфигурацию Prologue, и описываются результаты её применения.
2. Число Pods и число JVM — разные задачи
Первый приходящий в голову подход — разместить несколько контейнеров в одном Pod. С точки зрения Kubernetes это может уменьшить число Pods, а контейнеры в одном Pod могут совместно использовать сетевое пространство имён. Однако если в каждом контейнере запускается независимое приложение Spring Boot, число JVM остаётся неизменным.
Каждая JVM независимо имеет собственные heap, GC, пул потоков, Spring Context и пул соединений. Поэтому объединение только Pods при сохранении отдельных JVM может уменьшить число объектов Kubernetes, но не обеспечивает достаточного снижения дублирующихся затрат времени выполнения, на которое была направлена эта работа.
Чтобы существенно сократить операционные ресурсы, нам потребовалось собрать модули нескольких сервисов в одно приложение Boot и запускать их в одной JVM и одном Spring Context.
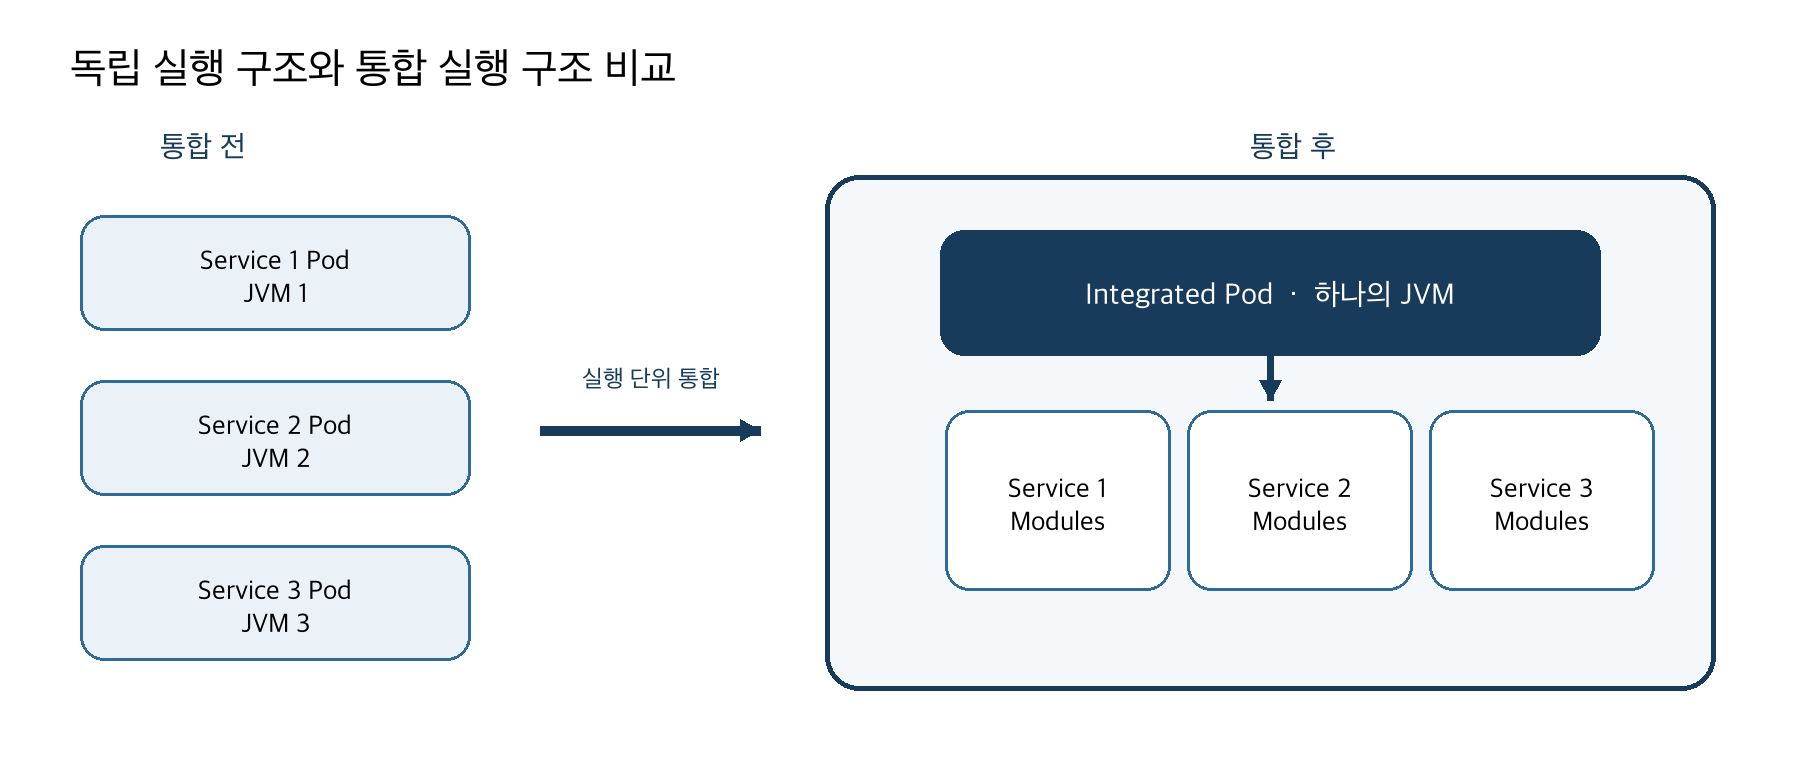
Рисунок 1. Переход от независимых конфигураций Pod и JVM к интегрированной конфигурации Boot
Это не означает, что мы намерены переработать несколько сервисов в один сервис. Ключевая идея заключается в объединении единиц развёртывания и выполнения при сохранении кода и владения данными каждого сервиса.
3. Целью интеграции была обратимость
В настоящее время этот подход в основном используется в конфигурациях, объединяющих Gate и Guard, Metro и Inflo, а также Bro и Porto в одно приложение Boot. В каждом случае объединяются два сервиса, однако сама структура не ограничивается двумя сервисами. При добавлении сервисов в топологию пять и более сервисов также могут быть объединены в один Boot и одну JVM в соответствии с требованиями конкретной площадки.
После интеграции трафик конкретного сервиса может возрасти или может потребоваться более строгая изоляция отказов. В таких случаях должна существовать возможность снова отделить этот сервис в независимую исполняемую единицу. Если интеграция становится необратимым изменением, мы можем потерять долгосрочную операционную гибкость в обмен на краткосрочную экономию ресурсов.
По этим причинам мы сформулировали следующие принципы.
• По возможности совместно использовать ресурсы выполнения.
• Сохранять границы пакетов и модулей Gradle каждого сервиса.
• Сохранять границы доступа к данным и транзакций каждого сервиса.
• Обеспечить возможность изменять состав сервисов, необходимый для каждой площадки.
• Обеспечить возможность при необходимости снова разделять интегрированные сервисы на независимые приложения Boot.
Основным источником проблемы с затратами было дублирование Pods и JVM, а не DB. На тот момент существенных проблем с ресурсами DB не было. Если бы конфигурация DB изменялась одновременно, владение данными, миграции, область действия отказов и стратегия отката изменились бы все сразу. Поэтому мы рассматривали интеграцию времени выполнения и интеграцию DB как отдельные решения.
Мы интегрировали исполняемые единицы, сохранив существующие границы персистентности каждого сервиса. Это стало предпосылкой использования нескольких DataSources в одном приложении Boot.
4. Мы рассмотрели несколько подходов к интеграции
Существовало несколько способов интеграции времени выполнения. Мы рассмотрели такие подходы, как размещение нескольких контейнеров в одном Pod, объединение существующих JAR в classpath, использование Parent и Child ApplicationContexts, а также сборка сервисов на уровне исходного кода в единый граф сборки. Мы также изучили прокси или общие пулы соединений для уменьшения самого числа соединений с DB, а также Native Image для сокращения объёма памяти времени выполнения.
|
Подход |
Сокращение числа JVM |
Влияние на существующий код |
Гибкость композиции сервисов |
Результат рассмотрения |
|---|---|---|---|---|
|
Несколько контейнеров в одном Pod |
Низкое |
Низкое |
Высокое |
Число Pods уменьшается, но затраты на JVM сохраняются. |
|
Объединение существующих JAR в classpath |
Высокое |
Низкое |
Высокое |
Управление согласованностью версий Config и артефактов является сложным. |
|
Parent и Child ApplicationContexts |
Высокое |
Среднее |
Высокое |
Изоляция контекстов возможна, но сложность реализации и эксплуатации высока. |
|
Интегрированная сборка на уровне исходного кода |
Высокое |
Среднее |
Высокое |
Конфликты можно обнаружить на раннем этапе в едином графе сборки. |
|
Использование общего DB-прокси или пула соединений |
Нет |
Низкая |
Нерелевантно |
Он работает только с DB-соединениями и не может уменьшить количество JVM. |
|
Native Image |
Частично возможно |
Высокая |
Нерелевантно |
Это не устраняет напрямую конфликты между компоновкой сервисов и Spring Context. |
Подход с компоновкой JAR также технически возможен. Каждый репозиторий может публиковать артефакт библиотеки вместо исполняемого Boot JAR, а отдельный проект сборки может выбирать необходимые версии и упаковывать их в единый Boot JAR. Однако простое объединение приложений, спроектированных для независимого выполнения, непосредственно перед развертыванием оказалось сложным.
DataSource, JPA, Flyway, SecurityFilterChain, Component Scan и имена Bean были настроены в расчете на независимое выполнение. Управление матрицей версий артефактов для каждого сервиса дополнительно усложняет комбинации развертывания.
В итоге мы сначала проверили подход, при котором исходные модули, за исключением Boot-модуля каждого сервиса, собирались в едином рабочем пространстве Gradle, а выделенный для интеграции Boot-модуль служил единственной точкой входа для выполнения. Хотя этот подход требует первоначальных затрат на интеграцию, он позволил быстро обнаруживать конфликты на этапах компиляции и запуска.
5. Мы проверили возможность интеграции пяти сервисов
В PoC мы собрали Checkpoint, Metro, Gallery, Pigeon и Vault в одном репозитории и одном Boot-приложении. Эта конфигурация должна была проверить возможность объединения пяти и более сервисов, а не просто обеспечить поддержку пары сервисов.
integrated
 ├─ checkpoint-* modules
 ├─ metro-* modules
 ├─ gallery-* modules
 ├─ pigeon-* modules
 ├─ vault-* modules
 └─ integrated-boot
Интеграция выполнялась в следующем порядке.
1. Мы подключили модули сервисов из каждого проекта, исключив Boot-модули, отвечающие за независимое выполнение.
2. Мы создали integrated-boot как точку входа для всего приложения.
3. Мы переместили объекты Config из существующих Boot-модулей в модули сервисов или интеграционный Boot-модуль в соответствии с их фактическими обязанностями.
4. Мы заменили внешние зависимости от артефактов на зависимости от проектов Gradle в рамках одной сборки.
5. Мы явно настроили автоматическую конфигурацию клиентов и удалили дублирующиеся регистрации Component.
6. Мы запустили одно приложение и вызвали API инициализации.
7. Мы проверили, что данные каждого сервиса корректно сохранялись в принадлежащем этому сервису DataSource.
Функциональная проверка показала, что пять сервисов работают в одном Pod и одной JVM, а данные корректно загружаются в DataSource каждого сервиса. Это подтвердило, что количество интегрируемых сервисов не ограничено двумя, а может масштабироваться в зависимости от топологии и ограничений ресурсов.
Однако в этом PoC не измерялись использование CPU, использование heap или степень снижения затрат при фактическом производственном трафике. Мы подтвердили структурный эффект от уменьшения количества Pod и дублирующихся ресурсов выполнения, но не выразили его напрямую в виде показателя снижения затрат. Фактическую экономию необходимо измерять в производственной среде, рассматривая одновременно CPU, heap, GC, количество потоков и DB-соединений.
6. Сложнее всего оказался Spring Context, а не упаковка
Во время PoC больше времени, чем размещение исходных файлов в одном репозитории, потребовало разрешение конфликтов Bean и Config.
В независимых приложениях каждый Bean существовал только один раз, но в интегрированном Context они обнаруживались одновременно. В частности, RestClient регистрировался как @Component и одновременно создавался через AutoConfiguration, что приводило к конфликтам, связанным с именами или типами Bean. Когда определенный пакет клиента исключался из Component Scan, внешние клиенты интеграции с тем же именем также исключались, создавая еще одну проблему.
Одной успешной компиляции было недостаточно, чтобы считать интеграцию завершенной. Поскольку единый Spring Context сканировал все сервисы вместе, проявились дублирующиеся регистрации и проблемы условной конфигурации, которые не возникали в средах независимого выполнения.
Этот опыт подтвердил необходимость следующих правил для модулей сервисов, которые могут интегрироваться.
• Интеграционный Boot владеет точкой входа для выполнения.
• Повторно используемый клиент должен регистрироваться только одним из двух способов: через Component Scan или через AutoConfiguration.
• Имена пакетов должны отражать границы сервисов не только в маршрутизации, но и в правилах сканирования и исключения.
• Модули сервисов не должны создавать дублирующиеся Bean в режимах независимого и интегрированного выполнения.
• Общую конфигурацию инфраструктуры необходимо отделять от настроек, специфичных для сервиса.
В конечном счете более важной проблемой, чем различие между интеграцией исходного кода и компоновкой JAR, оказалось обеспечение совместного существования нескольких сервисов без конфликтов в едином Spring Context. Этот опыт стал критерием определения области последующей стандартизации Prologue.
7. Мы сохранили границы DataSource и DB
Использование одной JVM не обязательно означает, что должен использоваться один DataSource. Границы выполнения и границы данных — это отдельные решения.
Даже после интеграции каждый сервис независимо сохранил следующие компоненты постоянного хранения.
• Каждый сервис сохраняет собственный DataSource.
• Каждый сервис сохраняет собственный EntityManagerFactory.
• Каждый сервис сохраняет собственный JpaTransactionManager.
• Каждый сервис сохраняет собственный EntityManager.
• Каждый сервис сохраняет собственную область сканирования Spring Data JPA Repository.
• Каждый сервис сохраняет собственную миграцию Flyway.
Даже когда Gate и Guard собираются в одном Boot-приложении, их единицы постоянного хранения остаются разделенными следующим образом.
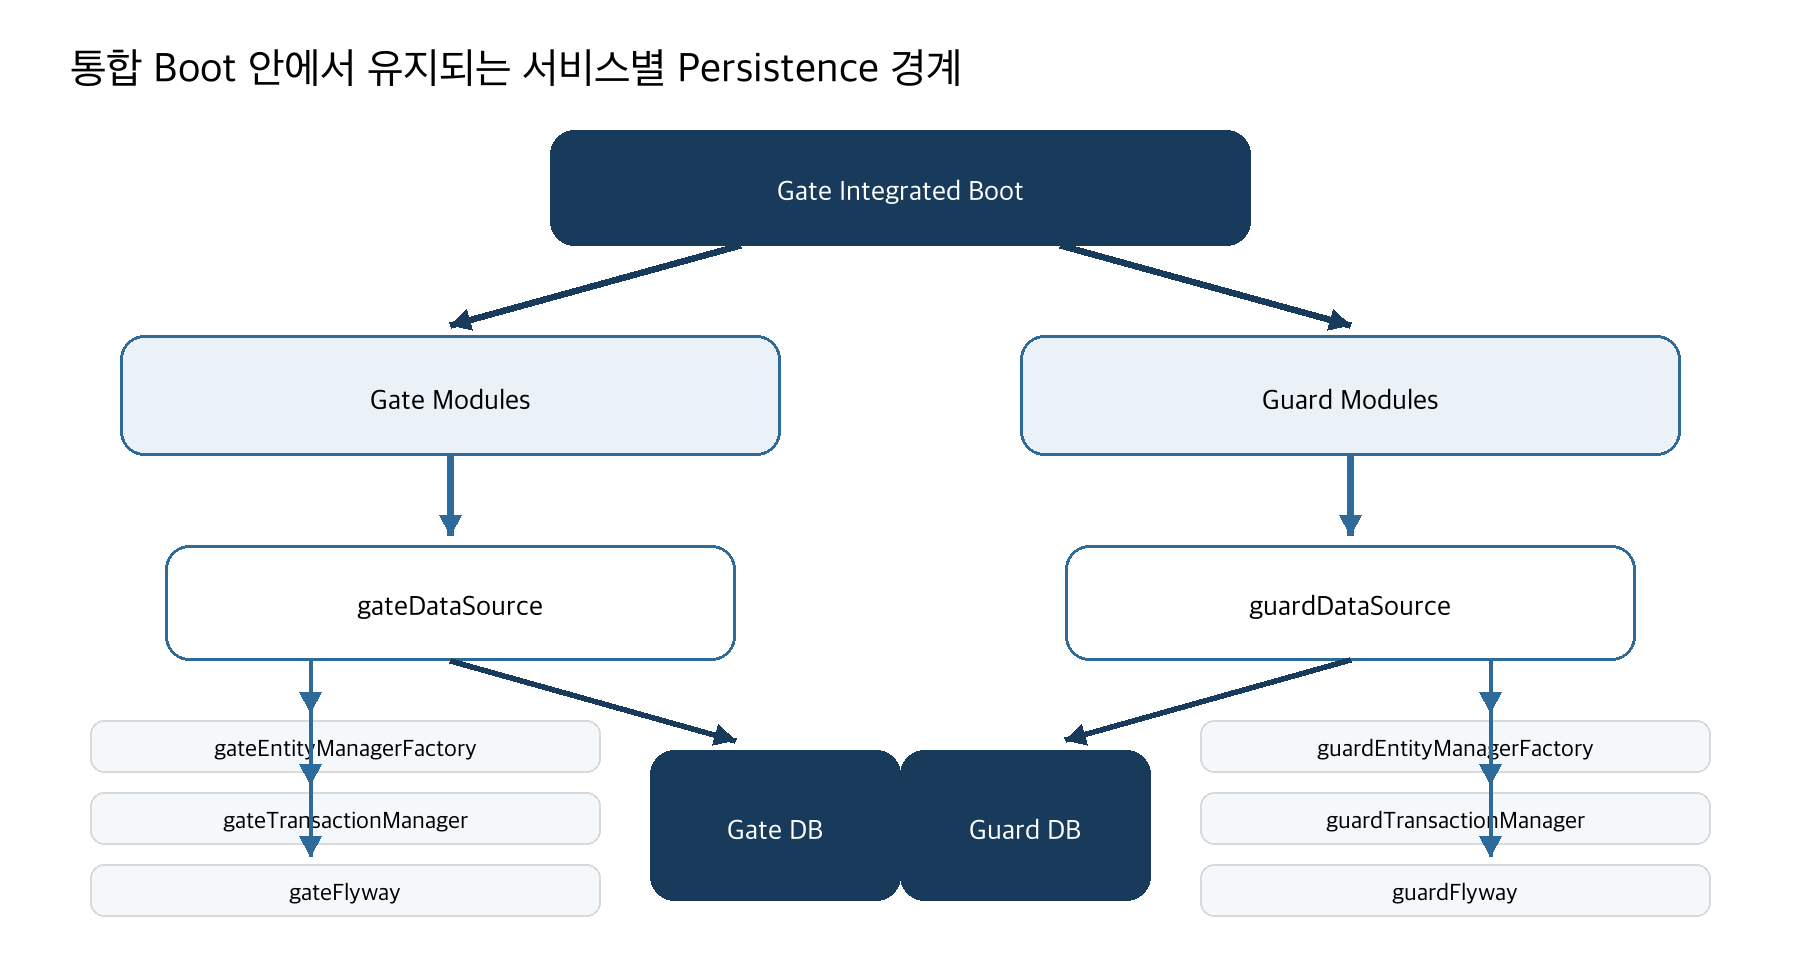
Рисунок 2. Границы постоянного хранения Gate и Guard, сохраненные в одном Boot
При такой структуре Entity и Repository одного сервиса не смешиваются с единицей постоянного хранения другого сервиса. Историей миграций и порядком их выполнения каждого сервиса можно управлять независимо, а изменения уровня данных можно минимизировать при повторном выделении конкретного сервиса в независимый Boot. Еще одним важным преимуществом является возможность принимать решения об интеграции единиц выполнения и изменениях топологии DB отдельно друг от друга.
С другой стороны, каждый DataSource создает собственный пул соединений, поэтому общий лимит соединений необходимо распределить между сервисами. Если к каждому DataSource без изменений применить настройки HikariCP по умолчанию, количество DB-соединений после интеграции может оказаться выше ожидаемого. Поэтому maximumPoolSize и minimumIdle для каждого пула, а также max_connections DB необходимо рассчитывать с учетом всей интегрированной топологии.
Сам по себе MultiDatasource не является причиной проблемы с подключением. Однако если несколько пулов не управляются совместно, это может стать новой операционной проблемой.
8. Мы выбирали транзакции на основе пакета
Одной регистрации нескольких DataSource недостаточно. Необходимо определить, какой TransactionManager должен использовать типичный @Transactional.
Можно многократно указывать qualifier в коде каждого сервиса следующим образом.
@Transactional("gateTransactionManager")Однако при таком подходе код сервиса должен напрямую учитывать интегрированную структуру развертывания. Если сервисы снова разделить или настроить в другой комбинации, количество мест, требующих изменений, также увеличится.
Поскольку пакет сервиса уже использовался как стабильная логическая граница, мы выбрали маршрутизацию на основе пакетов.
io.vizend.gate.* → gateTransactionManager
io.vizend.guard.* → guardTransactionManager
other package → default service TransactionManager
Если разработчик явно указывает qualifier, например @Transactional("customTransactionManager"), это решение сохраняется. Только если qualifier отсутствует, мы связываем сервис и TransactionManager на основе пакета объявляющего класса.
@Primary EntityManager предоставляется в виде прокси маршрутизации. Если с текущей транзакцией связан только один EntityManagerFactory, он делегирует вызов общему EntityManager этого сервиса. Если вложено несколько ресурсов транзакций, он выбирает целевой ресурс на основе имени текущей транзакции и правил пакетов. Если активной транзакции нет, используется настроенный сервис по умолчанию.
Такое поведение нельзя скрывать, выдавая его за магию. Перемещение пакета может изменить маршрутизацию транзакций, а пакеты, не подпадающие под правила, возвращаются к сервису по умолчанию. Поэтому мы зафиксировали соглашения об именовании пакетов, приоритет qualifier и поведение отката с помощью тестов и документации.
Кроме того, JpaTransactionManager каждого сервиса представляет отдельную локальную транзакцию. Он не объединяет изменения в двух DataSource в одну атомарную транзакцию. Если необходимо совместно изменять несколько баз данных, следует пересмотреть требования к REQUIRES_NEW, компенсирующим действиям, outbox, повторам и идемпотентности либо к отдельной стратегии распределенных транзакций.
9. Мы выявили повторяющуюся конфигурацию в Gate, Metro и Bro
Изначально интегрированный Boot напрямую владел конфигурацией MultiDatasource. Вместо того чтобы помещать ее в общую библиотеку до достаточной проверки требований и исключений, мы решили сначала подтвердить необходимые правила, применив их в реальных сервисах.
Ситуация изменилась по мере распространения одного и того же шаблона интеграции на Gate, Metro и Bro.
|
Интегрированный Boot |
Сервисы, собранные вместе |
Характеристики, выявленные в ходе применения |
|---|---|---|
|
Gate |
Gate + Guard |
Мы подтвердили базовый сценарий маршрутизации транзакций на основе пакетов. |
|
Metro |
Metro + Inflo |
Мы подтвердили наличие сбоев во взаимодействии между сервисами и на границах распространения транзакций. |
|
Bro |
Bro + Porto |
Когда некоторые сервисы отключались, нам снова приходилось выбирать фактически используемый сервис по умолчанию. |
|
PoC расширения |
Checkpoint + Metro + Gallery + Pigeon + Vault |
Мы подтвердили, что по тем же принципам можно собрать и более пяти сервисов. |
Следующий код повторялся в каждом интегрированном Boot.
• Создавались DataSource и JPA Beans с единообразными именами.
• Настраивалось сканирование пакетов Entity и Repository.
• Настраивались параметры и выполнение Flyway для конкретного сервиса.
• Регистрировались псевдонимы Bean по умолчанию.
• Обрабатывалось состояние включения каждого сервиса.
• Настраивалась маршрутизация TransactionManager и EntityManager.
Каждый раз, когда в production увеличивалось количество комбинаций сервисов, нам приходилось копировать одну и ту же Config. При изменении общей логики требовалось найти каждый интегрированный Boot и применить одинаковые изменения, а вероятность того, что каждый сервис реализует ее в немного отличающейся форме, также возрастала. Вместо снижения эксплуатационных затрат Pod за счет интеграции во время выполнения мы получили новые затраты на сопровождение из-за повторяющейся Java Config и вариаций для конкретных сервисов.
10. Мы подняли повторяющиеся правила на уровень Prologue
Выявив общие правила и исключения в Gate, Metro и Bro, мы перенесли конфигурацию MultiDatasource в Prologue. Это было не просто перемещение кода сервисов в общий модуль; это была работа по превращению правил, многократно проверенных в нескольких сервисах, в контракт платформы.
Автоконфигурация MultiDatasource в Prologue использует подход opt-in. Чтобы не затрагивать существующие сервисы с одним DataSource, она работает только в приложениях, которые явно ее включили. Для использующих ее сервисов остаются только указание собираемых сервисов и границы пакетов.
vizend:
  prologue:
    multi-datasource:
      enabled: true
      default-service: gate
      services:
        gate:
          base-package: io.vizend.gate
        guard:
          enabled: ${vizend.guard.enabled:true}
          base-package: io.vizend.guard
Информация о подключении, HikariCP и переопределения Flyway остаются в существующих настройках datasource для конкретных сервисов. В зависимости от топологии Prologue регистрирует Beans персистентности и конфигурацию маршрутизации для каждого сервиса.
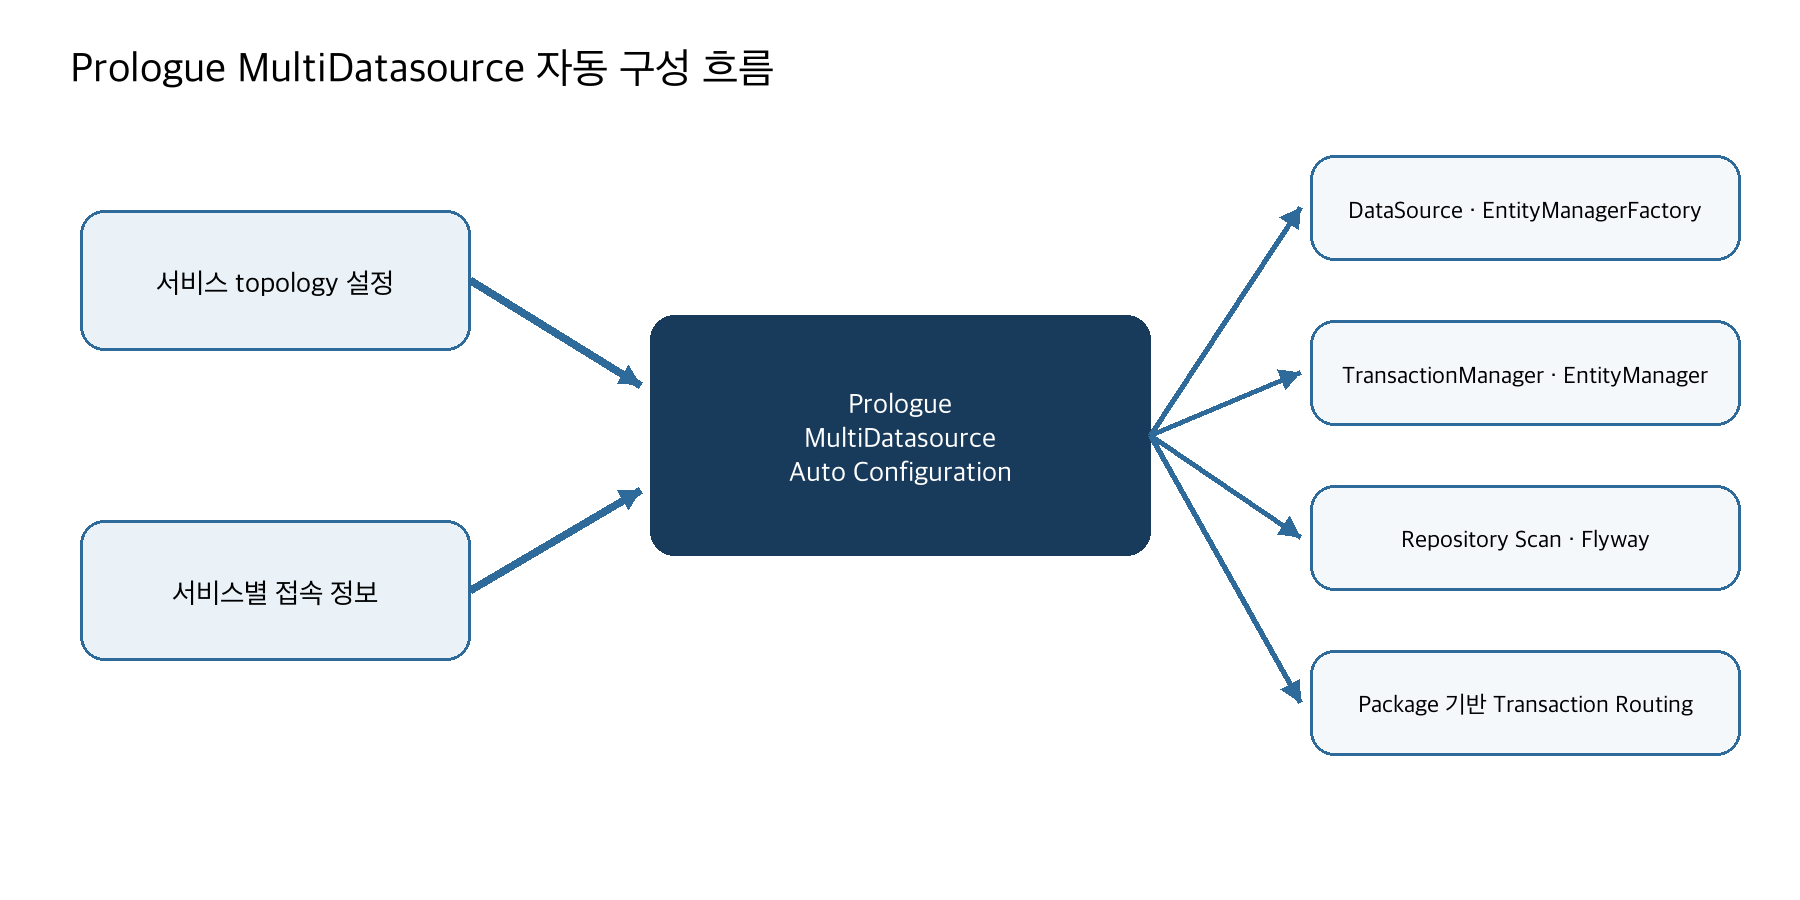
Рисунок 3. Роль Prologue в преобразовании конфигурации топологии в фактическую конфигурацию персистентности
Граница обобщения также имела значение. Мы не стали переносить в Prologue каждое различие. Настройки, необходимые только для структуры вызовов конкретного сервиса, например сгенерированный код Store или основанный на имени TransactionTemplate, были оставлены в использующем их сервисе.
Общая библиотека не предназначена для поглощения каждого исключения. Она должна предоставлять контракты, которым несколько сервисов обязаны единообразно следовать, тогда как обязанности, специфичные для сервиса, должны оставаться в каждом сервисе.
11. Что изменилось после обобщения с помощью Prologue
Во-первых, при создании нового интегрированного Boot приходится копировать меньше Java Config. Сервисы могут сосредоточиться на топологии и информации о подключении, а Prologue единообразно применяет правила создания Bean.
Во-вторых, изменения комбинации сервисов стали явной конфигурацией. Конкретную топологию персистентности можно исключить с помощью значения enabled сервиса. Мы также обработали комбинации, в которых настроенный сервис по умолчанию отключен, чтобы сервис по умолчанию можно было выбрать из фактически активных сервисов.
В-третьих, снизилась стоимость интеграции и разделения. Аннотациям транзакций и реализациям репозиториев в коде сервиса больше не нужно напрямую знать форму развертывания. В интегрированном Boot маршрутизацией занимается Prologue; в независимом Boot используется только конфигурация персистентности этого сервиса.
В-четвертых, стали ясны контракты, которые необходимо тестировать. Мы организовали следующие пункты как основные цели проверки автоконфигурации.
• Проверить, что Prologue не создает Beans персистентности, если функция отключена.
• Убедиться, что созданы все бины, необходимые каждому активному сервису.
• Убедиться, что Repository использует правильный persistence unit.
• Убедиться, что стандартная аннотация @Transactional выбирает TransactionManager, соответствующий пакету.
• Убедиться, что явные квалификаторы сохранены.
• Убедиться, что сервис по умолчанию определяется корректно в соответствии с комбинацией включённых сервисов.
• Убедиться, что Flyway выполняется для БД и схемы каждого сервиса.
• Убедиться, что существующий метод запуска для сервисов с одним DataSource не затронут.
Сложно оценивать стандартизацию исключительно по сокращению количества строк кода. Более существенным изменением стало то, что нам больше не нужно многократно изменять Config в каждом интегрированном Boot, требующем одинаковых изменений, а новые комбинации сервисов теперь можно описывать с помощью объявлений топологии.
12. Извлечённые уроки в ходе реализации
12.1 Архитектурные изменения следует начинать с эксплуатационных проблем
MultiDatasource не был целью. Он был средством сохранить границы сервисов, одновременно сократив регулярные затраты на Pods и JVM. Поскольку проблема, которую требовалось решить, была ясна, мы смогли избежать изменений, не связанных с этой проблемой, например объединения всех DataSources в один.
12.2 Границы выполнения и границы данных не обязательно должны изменяться одновременно
Запуск сервисов в одной JVM и использование одной БД — независимые решения. Разделение этих решений уменьшает масштаб изменений и повышает гибкость, позволяя снова разделить сервисы по мере их роста.
12.3 Безопаснее сначала проверять решение на сервисах, а затем распространять этот подход на платформу
Если бы мы с самого начала проектировали универсальную автоматическую конфигурацию, было бы сложно полностью понять реальные конфликты Bean, неактивные сервисы, переходы между сервисами по умолчанию и корректировки для отдельных сервисов. Поскольку мы стандартизировали решение только после того, как одни и те же проблемы повторились в нескольких сервисах, мы смогли конкретно определить обязанности и границы Prologue.
12.4 Чем удобнее маршрутизация, тем более явным должен быть контракт
Маршрутизация на основе пакетов делает код сервиса более компактным, но без понимания правил пакетов, поведения при отклонении и ограничений транзакций её поведение может быть трудно предсказать. Чем больше мы автоматизируем, тем более явными должны быть конфигурация, документация и интеграционные тесты.
12.5 Сокращение Pod указывает на потенциал снижения затрат и должно отличаться от результатов измерений
Объединение сервисов в одной JVM, вероятно, позволит сократить дублирование heap и пулов потоков. С другой стороны, увеличивается область, в которой один сбой затрагивает несколько сервисов, а пулы соединений нескольких DataSources по-прежнему необходимо контролировать. Итоговая оценка должна одновременно измерять CPU, heap, GC, подключения к БД и область распространения сбоев в реальной среде развёртывания.
13. Заключение
В рамках этой работы мы объединили затраты на выполнение, но не владение сервисами и не границы данных.
Мы сократили количество Pods и JVM, сохранив пакет, persistence unit и границы транзакций каждого сервиса. С помощью PoC интеграции на уровне исходного кода мы подтвердили, что пять сервисов могут работать в одном Spring Context. Впоследствии, применяя этот подход главным образом к Gate, Metro и Bro, мы обнаружили проблему повторения одного и того же Config и перенесли достаточно проверенные правила MultiDatasource в общую auto-configuration Prologue.
Такая структура подходит не для каждого сервиса. Сервисы, для которых важны независимое масштабирование, разные циклы развёртывания или строгая изоляция сбоев, могут лучше подходить для отдельных Pods. Важно не привязываться с самого начала к одной форме развёртывания. Сохраняя границы сервисов и владение данными, сервисы можно объединять или снова разделять в соответствии с эксплуатационной средой.
Хорошая архитектура не создаётся простым разделением системы на небольшие части. Её необходимо собирать с учётом текущего эксплуатационного масштаба, сохраняя необходимые границы, и предусмотреть возможность снова разделить её при изменении обстоятельств.
David