
서비스 경계를 유지한 통합 백엔드 설계와 공통 자동 구성 승격 과정
1. 들어가며
마이크로서비스가 늘어나면 비즈니스 기능만 늘어나는 것이 아닙니다. 서비스마다 Pod와 JVM이 필요하고, 각 JVM 안에는 Spring Context, thread pool, connection pool이 만들어집니다. 배포 대상과 모니터링 대상도 서비스 수에 비례하여 증가합니다. 트래픽이 많지 않은 서비스까지 독립 실행 단위로 유지하면 서비스 경계는 명확하지만, 그 대가로 반복되는 런타임 자원과 운영 비용을 감수해야 합니다.
통합 방식을 검토하게 된 직접적인 계기는 헬스케어 프로젝트였습니다. 당시 약 90개의 Bounded Context가 식별되었고, 각 BC에 3~5개의 서비스가 존재한다고 가정하면 250~300개 수준의 실행 인스턴스가 필요할 수 있었습니다. 모든 서비스가 독립적으로 확장되어야 한다면 자연스러운 구성이지만, 실제 부하가 크지 않은 서비스에도 동일한 실행 비용이 발생한다는 점은 다시 검토할 필요가 있었습니다.
처음부터 MultiDatasource를 도입하려고 한 것은 아니었습니다. 출발점은 다음 질문이었습니다.
서비스의 논리적 경계를 유지하면서 Pod와 JVM의 반복 비용을 줄일 수 있는가?
이 글에서는 이 질문을 해결하기 위해 검토한 통합 방식과 소스 레벨 통합 PoC, MultiDatasource 적용 과정, Spring Context 충돌 해결 경험을 정리합니다. 또한 여러 서비스에서 반복되던 구성을 Prologue의 공통 자동 구성으로 승격한 이유와 적용 결과를 설명합니다.
2. Pod 수와 JVM 수는 같은 문제가 아닙니다
처음 생각할 수 있는 방법은 여러 컨테이너를 하나의 Pod에 배치하는 것입니다. Kubernetes 관점에서는 Pod 수를 줄일 수 있고, 같은 Pod 안의 컨테이너가 네트워크 namespace를 공유할 수 있습니다. 그러나 컨테이너마다 독립적인 Spring Boot 애플리케이션을 실행하면 JVM 수는 그대로 유지됩니다.
각 JVM은 heap, GC, thread pool, Spring Context와 connection pool을 독립적으로 가집니다. 따라서 Pod만 합치고 JVM을 유지하는 방식은 Kubernetes 오브젝트 수는 줄일 수 있어도, 이번 작업에서 해결하려던 런타임 중복 비용을 충분히 줄이지 못합니다.
운영 자원을 실질적으로 줄이려면 여러 서비스의 모듈을 하나의 Boot 애플리케이션에서 조립하고, 하나의 JVM과 Spring Context에서 실행해야 했습니다.
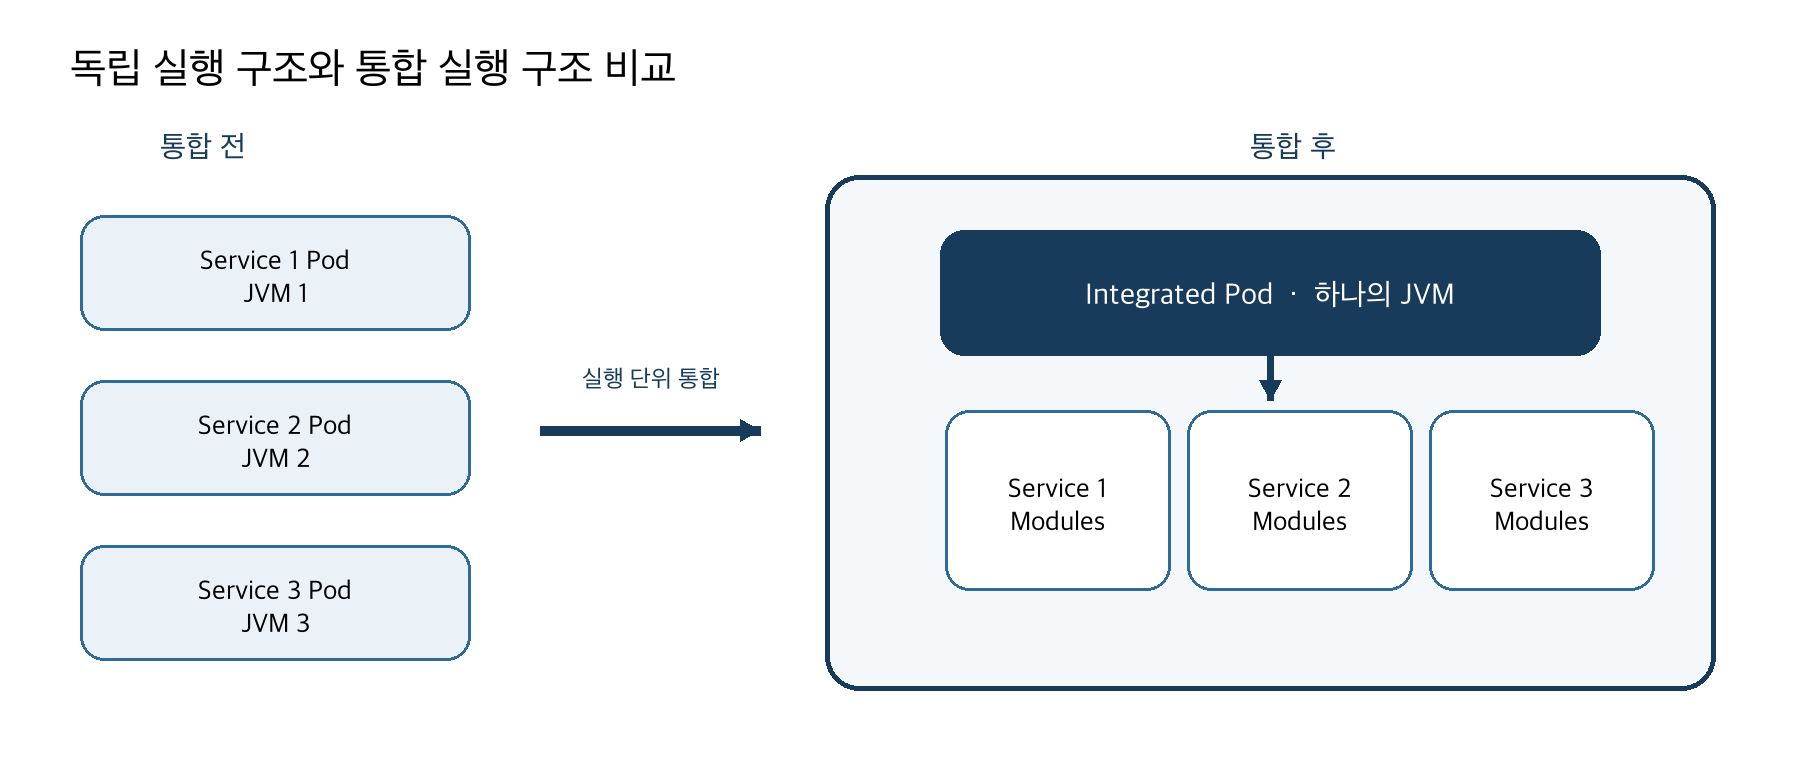
그림 1. 독립 Pod와 JVM 구성에서 통합 Boot 구성으로의 변화
여기서 여러 서비스를 하나의 서비스로 재설계하려는 것은 아닙니다. 배포와 실행 단위는 합치되, 서비스별 코드와 데이터 소유권은 유지하는 것이 핵심입니다.
3. 통합의 목표는 가역성이었습니다
현재 주요 적용 사례는 Gate와 Guard, Metro와 Inflo, Bro와 Porto를 하나의 Boot 애플리케이션으로 조립하는 구성입니다. 각 사례는 두 서비스를 조립하지만 구조 자체가 두 서비스에 제한되지는 않습니다. topology에 서비스를 추가하면 사이트 요구에 따라 다섯 개 이상의 서비스도 하나의 Boot와 JVM에 조립할 수 있습니다.
통합 이후 특정 서비스의 트래픽이 증가하거나 더 강한 장애 격리가 필요해질 수도 있습니다. 이 경우 해당 서비스를 다시 독립 실행 단위로 분리할 수 있어야 합니다. 통합이 일방향 변경이 되면 단기적인 자원 절감과 맞바꾸어 장기적인 운영 유연성을 잃을 수 있습니다.
이러한 이유로 다음 원칙을 정했습니다.
• 실행 자원은 가능한 범위에서 공유합니다.
• 서비스별 package와 Gradle 모듈 경계는 유지합니다.
• 데이터 접근과 트랜잭션 경계는 서비스별로 유지합니다.
• 사이트별로 필요한 서비스 조합을 변경할 수 있어야 합니다.
• 통합된 서비스는 필요할 때 다시 독립 Boot로 분리할 수 있어야 합니다.
비용 문제의 중심은 DB가 아니라 Pod와 JVM의 반복이었습니다. 당시 DB 자원에는 큰 문제가 없었습니다. DB 구성까지 동시에 변경하면 데이터 소유권, migration, 장애 범위와 롤백 전략까지 한꺼번에 바뀝니다. 따라서 런타임 통합과 DB 통합을 별개의 결정으로 다루었습니다.
실행 단위는 통합하되 기존 서비스별 persistence 경계는 유지했습니다. 이것이 하나의 Boot 애플리케이션에서 여러 DataSource를 사용하게 된 배경입니다.
4. 여러 통합 방식을 검토했습니다
런타임을 통합하는 방법은 하나가 아니었습니다. Pod 안에 여러 컨테이너를 배치하는 방식, 기존 JAR를 classpath에서 조합하는 방식, Parent와 Child ApplicationContext를 사용하는 방식, 소스 레벨에서 하나의 build graph로 조립하는 방식 등을 검토했습니다. DB connection 자체를 줄이기 위한 proxy나 connection pool 공유, 런타임 메모리를 줄일 수 있는 Native Image도 함께 살펴보았습니다.
|
방식 |
JVM 절감 |
기존 코드 영향 |
서비스 조합 유연성 |
검토 결과 |
|---|---|---|---|---|
|
하나의 Pod에 여러 컨테이너 배치 |
낮음 |
낮음 |
높음 |
Pod 수는 줄지만 JVM 비용이 유지됩니다. |
|
기존 JAR의 classpath 조합 |
높음 |
낮음 |
높음 |
Config와 artifact 버전 정합성 관리가 복잡합니다. |
|
Parent와 Child ApplicationContext |
높음 |
중간 |
높음 |
Context 격리는 가능하지만 구현과 운영 복잡도가 큽니다. |
|
소스 레벨 통합 빌드 |
높음 |
중간 |
높음 |
하나의 build graph에서 충돌을 조기에 발견할 수 있습니다. |
|
DB proxy 또는 connection pool 공유 |
없음 |
낮음 |
무관 |
DB connection만 다루며 JVM 수는 줄이지 못합니다. |
|
Native Image |
일부 가능 |
높음 |
무관 |
서비스 조합과 Spring Context 충돌을 직접 해결하지 못합니다. |
JAR 조합 방식도 기술적으로는 가능합니다. 각 저장소가 실행 가능한 Boot JAR가 아니라 library artifact를 발행하고, 별도의 assembly 프로젝트가 필요한 버전을 선택하여 하나의 Boot JAR로 만들 수 있습니다. 다만 독립 실행을 전제로 만든 애플리케이션을 배포 직전에 단순히 합치기는 어려웠습니다.
DataSource, JPA, Flyway, SecurityFilterChain, Component Scan과 Bean 이름이 모두 독립 실행을 전제로 구성되어 있었습니다. 여기에 서비스별 artifact version matrix까지 관리하면 배포 조합에 따른 복잡도가 커집니다.
최종적으로 서비스의 Boot 모듈을 제외한 소스 모듈을 하나의 Gradle workspace에서 조립하고, 통합 전용 Boot 모듈이 유일한 실행 진입점이 되는 방식을 먼저 검증했습니다. 이 방식은 초기 통합 비용이 들지만, compile 단계와 기동 단계에서 충돌을 빠르게 발견할 수 있다는 장점이 있었습니다.
5. 다섯 개 서비스로 통합 가능성을 검증했습니다
PoC에서는 Checkpoint, Metro, Gallery, Pigeon, Vault를 하나의 저장소와 하나의 Boot 애플리케이션으로 조립했습니다. 두 서비스만 묶을 수 있는 구조가 아니라, 다섯 개 이상의 조합도 가능한지 확인하기 위한 구성이었습니다.
integrated
 ├─ checkpoint-* modules
 ├─ metro-* modules
 ├─ gallery-* modules
 ├─ pigeon-* modules
 ├─ vault-* modules
 └─ integrated-boot
통합은 다음 순서로 진행했습니다.
1. 각 프로젝트에서 독립 실행을 담당하던 Boot 모듈을 제외하고 서비스 모듈을 가져왔습니다.
2. 전체 애플리케이션의 진입점이 되는 integrated-boot를 만들었습니다.
3. 기존 Boot 모듈에 있던 Config를 실제 책임에 맞는 서비스 모듈 또는 통합 Boot로 이동했습니다.
4. 외부 artifact 의존성을 같은 build 안의 Gradle project 의존성으로 변경했습니다.
5. Client 자동 구성을 명시하고 중복 Component 등록을 제거했습니다.
6. 하나의 애플리케이션을 기동하여 초기화 API를 호출했습니다.
7. 각 서비스의 데이터가 서비스별 DataSource에 정상적으로 저장되는지 확인했습니다.
기능 검증 결과, 다섯 개 서비스가 하나의 Pod와 JVM에서 실행되었고 서비스별 DataSource에도 데이터가 정상적으로 적재되었습니다. 이 결과를 통해 통합 가능한 서비스 수가 두 개로 고정된 것이 아니라 topology와 자원 한도에 따라 확장될 수 있음을 확인했습니다.
다만 이 PoC에서는 실제 운영 트래픽을 사용한 CPU, heap 또는 비용 절감률을 측정하지 못했습니다. Pod 수와 중복 런타임 자원이 줄어드는 구조적 효과는 확인했지만, 이를 곧바로 비용 절감 수치로 표현하지는 않았습니다. 실제 절감 효과는 운영 환경에서 CPU, heap, GC, thread 수와 DB connection을 함께 측정해야 합니다.
6. 어려웠던 부분은 패키징보다 Spring Context였습니다
PoC 과정에서 소스 파일을 한 저장소에 배치하는 작업보다 더 많은 시간이 필요했던 부분은 Bean과 Config 충돌이었습니다.
독립 애플리케이션에서는 각자 하나만 존재하던 Bean이 통합 Context에서는 동시에 발견되었습니다. 특히 RestClient가 @Component로 등록되는 동시에 AutoConfiguration에서도 생성되면서 Bean 이름 또는 타입이 충돌했습니다. 특정 client package를 Component Scan에서 제외했을 때는 이름이 같은 외부 연동 client까지 함께 제외되는 문제도 발생했습니다.
단순히 compile이 성공했다고 해서 통합이 완료된 것은 아니었습니다. 하나의 Spring Context가 모든 서비스를 함께 scan하면서 독립 실행 환경에서는 드러나지 않던 중복 등록과 조건부 설정 문제가 나타났습니다.
이 경험을 통해 통합 가능한 서비스 모듈에는 다음 규칙이 필요하다는 점을 확인했습니다.
• 실행 진입점은 통합 Boot가 소유합니다.
• 재사용 가능한 client는 Component Scan과 AutoConfiguration 중 한 방식으로만 등록합니다.
• package 이름은 routing뿐 아니라 scan과 exclude 규칙에서도 서비스 경계를 나타내야 합니다.
• 서비스 모듈은 독립 실행과 통합 실행에서 같은 Bean을 중복 생성하지 않아야 합니다.
• 공통 인프라 설정과 서비스 전용 보정을 구분해야 합니다.
결국 소스 통합과 JAR 조합의 차이보다 중요한 문제는 여러 서비스가 하나의 Spring Context에서 충돌 없이 공존할 수 있도록 만드는 것이었습니다. 이 경험은 이후 Prologue 공통화의 범위를 결정하는 기준이 되었습니다.
7. DataSource와 DB 경계는 유지했습니다
하나의 JVM을 사용한다고 해서 DataSource도 반드시 하나여야 하는 것은 아닙니다. 런타임 경계와 데이터 경계는 서로 다른 결정입니다.
통합 이후에도 각 서비스는 다음 persistence 구성 요소를 독립적으로 유지했습니다.
• 서비스별 DataSource를 유지합니다.
• 서비스별 EntityManagerFactory를 유지합니다.
• 서비스별 JpaTransactionManager를 유지합니다.
• 서비스별 EntityManager를 유지합니다.
• 서비스별 Spring Data JPA Repository scan 범위를 유지합니다.
• 서비스별 Flyway migration을 유지합니다.
Gate와 Guard를 하나의 Boot 애플리케이션으로 조립하더라도 persistence unit은 다음과 같이 분리됩니다.
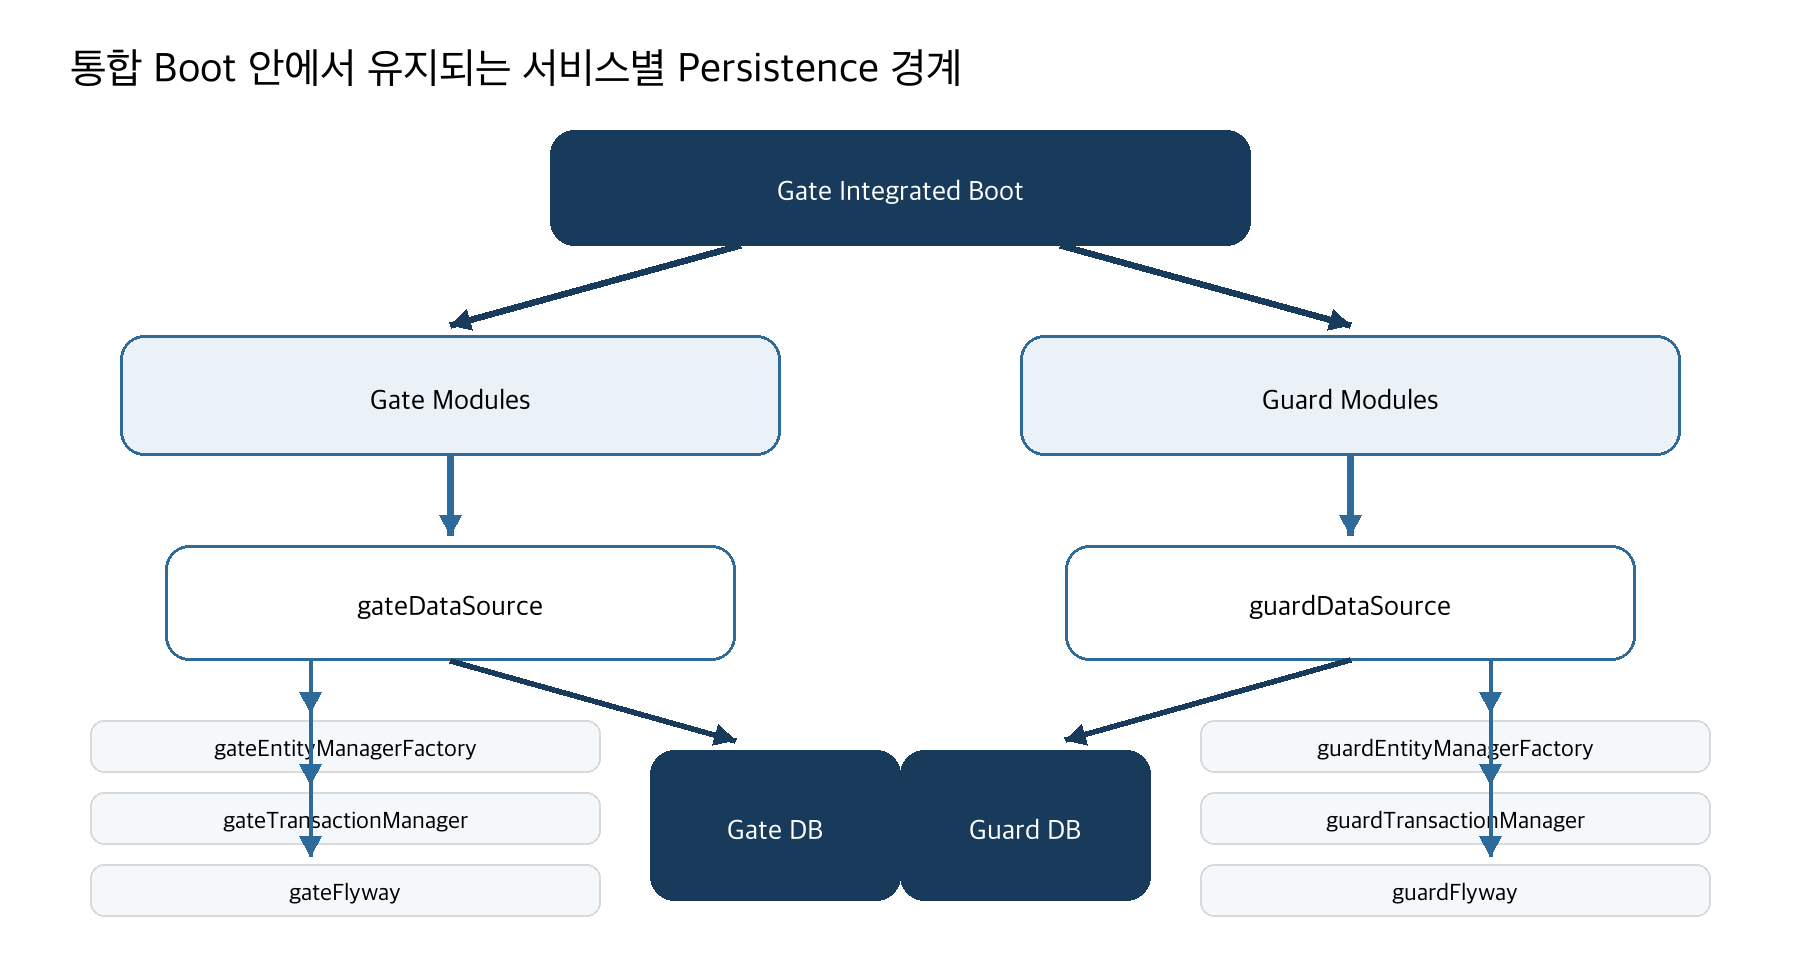
그림 2. 하나의 Boot 안에서 유지되는 Gate와 Guard의 persistence 경계
이 구조에서는 한 서비스의 Entity와 Repository가 다른 서비스의 persistence unit에 섞이지 않습니다. 서비스별 migration history와 실행 순서를 독립적으로 관리할 수 있으며, 특정 서비스를 다시 독립 Boot로 분리할 때 데이터 계층의 변경도 줄일 수 있습니다. 실행 단위의 통합 여부와 DB topology 변경 여부를 따로 결정할 수 있다는 점도 중요한 장점입니다.
반면 DataSource마다 connection pool이 만들어지므로 전체 connection budget을 서비스별로 나누어야 합니다. HikariCP의 기본값을 모든 DataSource에 그대로 적용하면 통합 이후 DB connection 수가 예상보다 많아질 수 있습니다. 따라서 각 pool의 maximumPoolSize, minimumIdle과 DB의 max_connections를 통합 topology 전체 관점에서 계산해야 합니다.
MultiDatasource 자체가 connection 문제의 원인은 아닙니다. 다만 여러 pool을 함께 관리하지 않으면 새로운 운영 문제가 될 수 있습니다.
8. package를 기준으로 트랜잭션을 선택했습니다
DataSource를 여러 개 등록하는 것만으로는 충분하지 않습니다. 일반적인 @Transactional이 어떤 TransactionManager를 사용해야 하는지 결정해야 합니다.
각 서비스 코드에 다음과 같이 qualifier를 반복하여 지정할 수 있습니다.
@Transactional("gateTransactionManager")그러나 이 방식은 서비스 코드가 통합 배포 구조를 직접 알아야 합니다. 서비스를 다시 분리하거나 다른 조합으로 구성할 때 수정 지점도 늘어납니다.
서비스 package는 이미 안정적인 논리 경계로 사용하고 있었기 때문에 package 기반 routing을 선택했습니다.
io.vizend.gate.* → gateTransactionManager
io.vizend.guard.* → guardTransactionManager
other package → default service TransactionManager
개발자가 @Transactional("customTransactionManager")처럼 qualifier를 명시한 경우에는 그 결정을 유지합니다. qualifier가 없을 때만 선언 클래스의 package를 기준으로 서비스와 TransactionManager를 연결합니다.
@Primary EntityManager는 routing proxy로 제공합니다. 현재 트랜잭션에 하나의 EntityManagerFactory만 바인딩되어 있으면 해당 서비스의 shared EntityManager로 위임합니다. 여러 트랜잭션 리소스가 중첩되면 현재 트랜잭션 이름과 package 규칙으로 대상을 선택합니다. 활성 트랜잭션이 없다면 설정된 default service를 사용합니다.
이 동작을 마법처럼 숨기면 안 됩니다. package 이동은 transaction routing의 변경이 될 수 있으며, 규칙 밖의 package는 default service로 fallback합니다. 따라서 package 규약, qualifier 우선순위와 fallback 동작을 테스트와 문서로 고정했습니다.
또한 서비스별 JpaTransactionManager는 서로 독립된 로컬 트랜잭션입니다. 두 DataSource의 변경을 하나의 원자적 트랜잭션으로 묶어주지 않습니다. 여러 DB를 함께 변경해야 한다면 REQUIRES_NEW, 보상 처리, outbox, 재시도와 멱등성 또는 별도의 분산 트랜잭션 전략을 요구사항에 맞게 검토해야 합니다.
9. Gate와 Metro와 Bro에서 반복되는 구성을 확인했습니다
초기에는 통합 Boot가 MultiDatasource Config를 직접 소유했습니다. 요구사항과 예외가 충분히 검증되지 않은 상태에서 공통 라이브러리에 먼저 넣기보다, 실제 서비스에서 적용하면서 필요한 규칙을 확인하는 편이 안전하다고 판단했습니다.
동일한 통합 패턴이 Gate, Metro, Bro로 확산되면서 상황이 달라졌습니다.
|
통합 Boot |
함께 조립되는 서비스 |
적용 과정에서 확인한 특징 |
|---|---|---|
|
Gate |
Gate + Guard |
package 기반 transaction routing의 기본 사례를 확인했습니다. |
|
Metro |
Metro + Inflo |
서비스 간 호출 실패와 transaction propagation 경계를 확인했습니다. |
|
Bro |
Bro + Porto |
일부 서비스가 비활성화될 때 실제 default service를 다시 선택해야 했습니다. |
|
확장 PoC |
Checkpoint + Metro + Gallery + Pigeon + Vault |
같은 원칙으로 다섯 개 이상의 서비스도 조립할 수 있음을 확인했습니다. |
각 통합 Boot에는 다음 코드가 반복되었습니다.
• 일정한 이름으로 DataSource와 JPA Bean을 생성했습니다.
• Entity와 Repository package scan을 설정했습니다.
• 서비스별 Flyway 설정과 실행을 구성했습니다.
• 기본 Bean alias를 등록했습니다.
• 서비스 활성화 여부를 처리했습니다.
• TransactionManager와 EntityManager routing을 구성했습니다.
운영 중 서비스 조합이 늘어날 때마다 동일한 Config를 복사해야 했습니다. 공통 로직을 수정할 때는 모든 통합 Boot를 찾아 같은 변경을 반영해야 했고, 서비스마다 조금씩 다른 형태로 구현될 가능성도 커졌습니다. 런타임 통합으로 Pod 운영 비용을 줄이는 대신 반복되는 Java Config와 서비스별 편차라는 새로운 유지보수 비용이 생긴 것입니다.
10. 반복되는 규칙을 Prologue로 승격했습니다
Gate, Metro, Bro에서 공통 규칙과 예외를 확인한 뒤 MultiDatasource 구성을 Prologue로 옮겼습니다. 서비스 코드를 단순히 공통 모듈로 이동한 것이 아니라, 여러 서비스에서 반복하여 검증한 규칙을 플랫폼 계약으로 승격한 작업이었습니다.
Prologue의 MultiDatasource 자동 구성은 opt-in 방식입니다. 기존 단일 DataSource 서비스에 영향을 주지 않도록 명시적으로 활성화한 애플리케이션에서만 동작합니다. 소비 서비스에는 어떤 서비스를 조립할지와 package 경계만 남깁니다.
vizend:
  prologue:
    multi-datasource:
      enabled: true
      default-service: gate
      services:
        gate:
          base-package: io.vizend.gate
        guard:
          enabled: ${vizend.guard.enabled:true}
          base-package: io.vizend.guard
접속 정보와 HikariCP, Flyway override는 기존 서비스별 datasource 설정에 유지합니다. Prologue는 topology를 바탕으로 서비스별 persistence Bean과 routing 구성을 등록합니다.
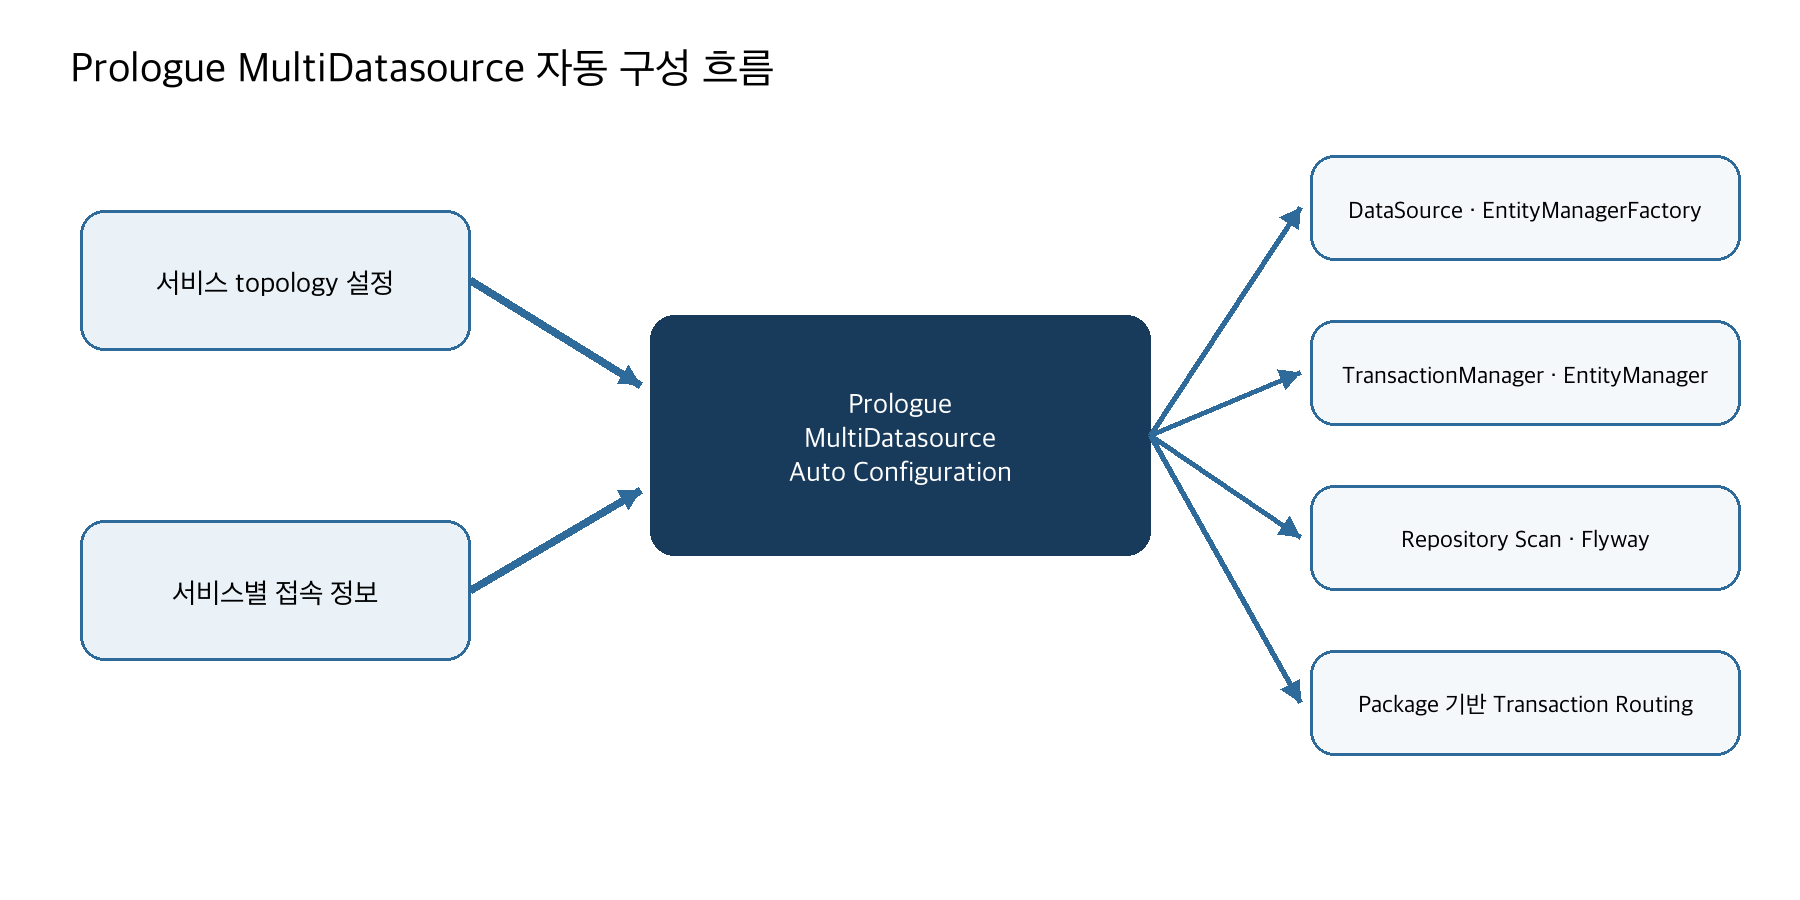
그림 3. topology 설정을 실제 persistence 구성으로 변환하는 Prologue의 역할
공통화의 경계도 중요했습니다. 모든 차이를 Prologue 안으로 밀어 넣지는 않았습니다. 특정 서비스의 코드 생성 Store나 이름 기반 TransactionTemplate처럼 해당 서비스 호출 구조에만 필요한 보정은 소비 서비스에 남겼습니다.
공통 라이브러리는 모든 예외를 흡수하는 장소가 아닙니다. 여러 서비스가 동일하게 지켜야 하는 계약을 제공하고, 서비스 고유 책임은 각 서비스에 남겨야 합니다.
11. Prologue 공통화 이후 달라진 점
첫째, 새로운 통합 Boot를 만들 때 복사해야 하는 Java Config가 줄었습니다. 서비스는 topology와 접속 정보에 집중하고, Bean 생성 규칙은 Prologue가 일관되게 적용합니다.
둘째, 서비스 조합 변경이 명시적인 설정이 되었습니다. 서비스의 enabled 값을 통해 특정 persistence topology를 제외할 수 있습니다. 설정된 default service가 비활성화되는 조합에서도 실제 활성 서비스 가운데 기본 서비스를 결정할 수 있도록 처리했습니다.
셋째, 통합과 분리의 비용이 낮아졌습니다. 서비스 코드의 transaction annotation과 repository 구현은 배포 형태를 직접 알 필요가 없습니다. 통합 Boot에서는 Prologue가 routing을 담당하고, 독립 Boot에서는 해당 서비스의 persistence 구성만 사용하면 됩니다.
넷째, 테스트해야 할 계약이 명확해졌습니다. 다음 항목을 자동 구성의 주요 검증 대상으로 정리했습니다.
• 기능이 비활성화되면 Prologue가 persistence Bean을 만들지 않는지 확인합니다.
• 활성 서비스마다 필요한 Bean이 모두 생성되는지 확인합니다.
• Repository가 올바른 persistence unit을 사용하는지 확인합니다.
• 일반 @Transactional이 package에 맞는 TransactionManager를 선택하는지 확인합니다.
• 명시적 qualifier를 보존하는지 확인합니다.
• 서비스 활성화 조합에 따라 default service가 올바르게 결정되는지 확인합니다.
• Flyway가 각 서비스의 DB와 schema에서 실행되는지 확인합니다.
• 단일 DataSource 서비스의 기존 기동 방식에 영향을 주지 않는지 확인합니다.
공통화는 코드 줄 수를 줄이는 것만으로 평가하기 어렵습니다. 같은 수정이 필요한 통합 Boot마다 Config를 반복해서 바꾸지 않아도 되고, 새로운 서비스 조합도 topology 선언으로 설명할 수 있게 되었다는 점이 더 큰 변화였습니다.
12. 적용 과정에서 얻은 교훈
12.1 아키텍처 변경은 운영 문제에서 출발해야 합니다
MultiDatasource는 목표가 아니었습니다. Pod와 JVM의 반복 비용을 줄이면서 서비스 경계를 보존하기 위한 수단이었습니다. 해결하려는 문제가 명확했기 때문에 DataSource를 하나로 합치는 것처럼 문제와 직접 관계없는 변경을 피할 수 있었습니다.
12.2 실행 경계와 데이터 경계를 함께 움직일 필요는 없습니다
서비스를 하나의 JVM에서 실행하는 것과 하나의 DB를 사용하는 것은 독립적인 선택입니다. 두 결정을 분리하면 변경 범위가 줄고, 서비스가 성장했을 때 다시 분리할 수 있는 여지도 커집니다.
12.3 먼저 서비스에서 검증한 뒤 플랫폼으로 올리는 편이 안전합니다
처음부터 범용 자동 구성을 설계했다면 실제 Bean 충돌, 비활성 서비스, default service 전환과 서비스별 보정을 충분히 알기 어려웠을 것입니다. 여러 서비스에서 같은 문제가 반복된 뒤 공통화했기 때문에 Prologue의 책임과 경계를 구체적으로 정할 수 있었습니다.
12.4 편리한 routing일수록 명시적인 규약이 필요합니다
package 기반 routing은 서비스 코드를 간결하게 만들지만 package 규칙, fallback과 트랜잭션 한계를 모르면 예상하기 어려운 동작이 됩니다. 자동화할수록 설정, 문서와 통합 테스트는 더 명시적이어야 합니다.
12.5 Pod 감소는 비용 절감 가능성을 의미하며 측정 결과와는 구분해야 합니다
하나의 JVM으로 합치면 중복 heap과 thread pool을 줄일 가능성이 큽니다. 반면 하나의 장애가 여러 서비스에 영향을 미치는 범위는 커지고, 여러 DataSource의 connection pool은 여전히 관리해야 합니다. 최종 평가는 실제 배포 환경에서 CPU, heap, GC, DB connection과 장애 범위를 함께 측정해야 합니다.
13. 마치며
이번 작업에서 통합한 것은 서비스의 소유권이나 데이터 경계가 아니라 실행 비용입니다.
Pod와 JVM은 줄이되 서비스별 package, persistence unit과 트랜잭션 경계는 유지했습니다. 소스 레벨 통합 PoC를 통해 다섯 개 서비스가 하나의 Spring Context에서 동작할 수 있음을 확인했습니다. 이후 Gate, Metro, Bro를 중심으로 패턴을 적용하면서 동일한 Config가 반복되는 문제를 발견했고, 충분히 검증한 MultiDatasource 규칙을 Prologue의 공통 자동 구성으로 승격했습니다.
이 구조가 모든 서비스에 적합한 것은 아닙니다. 독립적인 확장, 서로 다른 배포 주기 또는 강한 장애 격리가 중요한 서비스는 별도 Pod가 더 적합할 수 있습니다. 중요한 점은 처음부터 하나의 배포 형태에 고정하지 않는 것입니다. 서비스 경계와 데이터 소유권을 유지하면 운영 환경에 따라 서비스를 합치거나 다시 분리할 수 있습니다.
작게 나누는 것만으로 좋은 아키텍처가 완성되지는 않습니다. 필요한 경계를 지키면서 현재의 운영 규모에 맞게 조립하고, 상황이 바뀌면 다시 분리할 수 있어야 합니다.
David