
サービス境界を維持した統合バックエンド設計と共通自動構成の昇格プロセス
1. はじめに
マイクロサービスが増えると、ビジネス機能だけが増えるわけではありません。サービスごとにPodとJVMが必要になり、各JVM内にはSpring Context、thread pool、connection poolが作成されます。デプロイ対象とモニタリング対象もサービス数に比例して増加します。トラフィックが多くないサービスまで独立した実行単位として維持すると、サービス境界は明確になりますが、その代わりに繰り返し発生するランタイムリソースと運用コストを負担しなければなりません。
統合方式を検討することになった直接的なきっかけは、ヘルスケアプロジェクトでした。当時、約90のBounded Contextが特定されており、各BCに3~5個のサービスが存在すると仮定すると、250~300個程度の実行インスタンスが必要になる可能性がありました。すべてのサービスを独立してスケールさせる必要があるなら自然な構成ですが、実際の負荷が大きくないサービスにも同じ実行コストが発生する点は、改めて検討する必要がありました。
最初からMultiDatasourceを導入しようとしたわけではありませんでした。出発点となったのは、次の問いでした。
サービスの論理的な境界を維持しながら、PodとJVMの繰り返しコストを削減できるか?
この記事では、この問いを解決するために検討した統合方式、ソースレベル統合PoC、MultiDatasourceの適用プロセス、Spring Contextの衝突を解決した経験を整理します。また、複数のサービスで繰り返されていた構成をPrologueの共通自動構成へ昇格させた理由と、その適用結果について説明します。
2. Pod数とJVM数は同じ問題ではありません
最初に考えられる方法は、複数のコンテナを1つのPodに配置することです。Kubernetesの観点ではPod数を減らすことができ、同じPod内のコンテナはネットワークnamespaceを共有できます。しかし、コンテナごとに独立したSpring Bootアプリケーションを実行すると、JVM数はそのまま維持されます。
各JVMはheap、GC、thread pool、Spring Context、connection poolを独立して持ちます。そのため、PodだけをまとめてJVMを維持する方式では、Kubernetesオブジェクト数は減らせても、今回の作業で解決しようとしたランタイムの重複コストを十分に削減できません。
運用リソースを実質的に削減するには、複数サービスのモジュールを1つのBootアプリケーションで組み立て、1つのJVMとSpring Contextで実行する必要がありました。
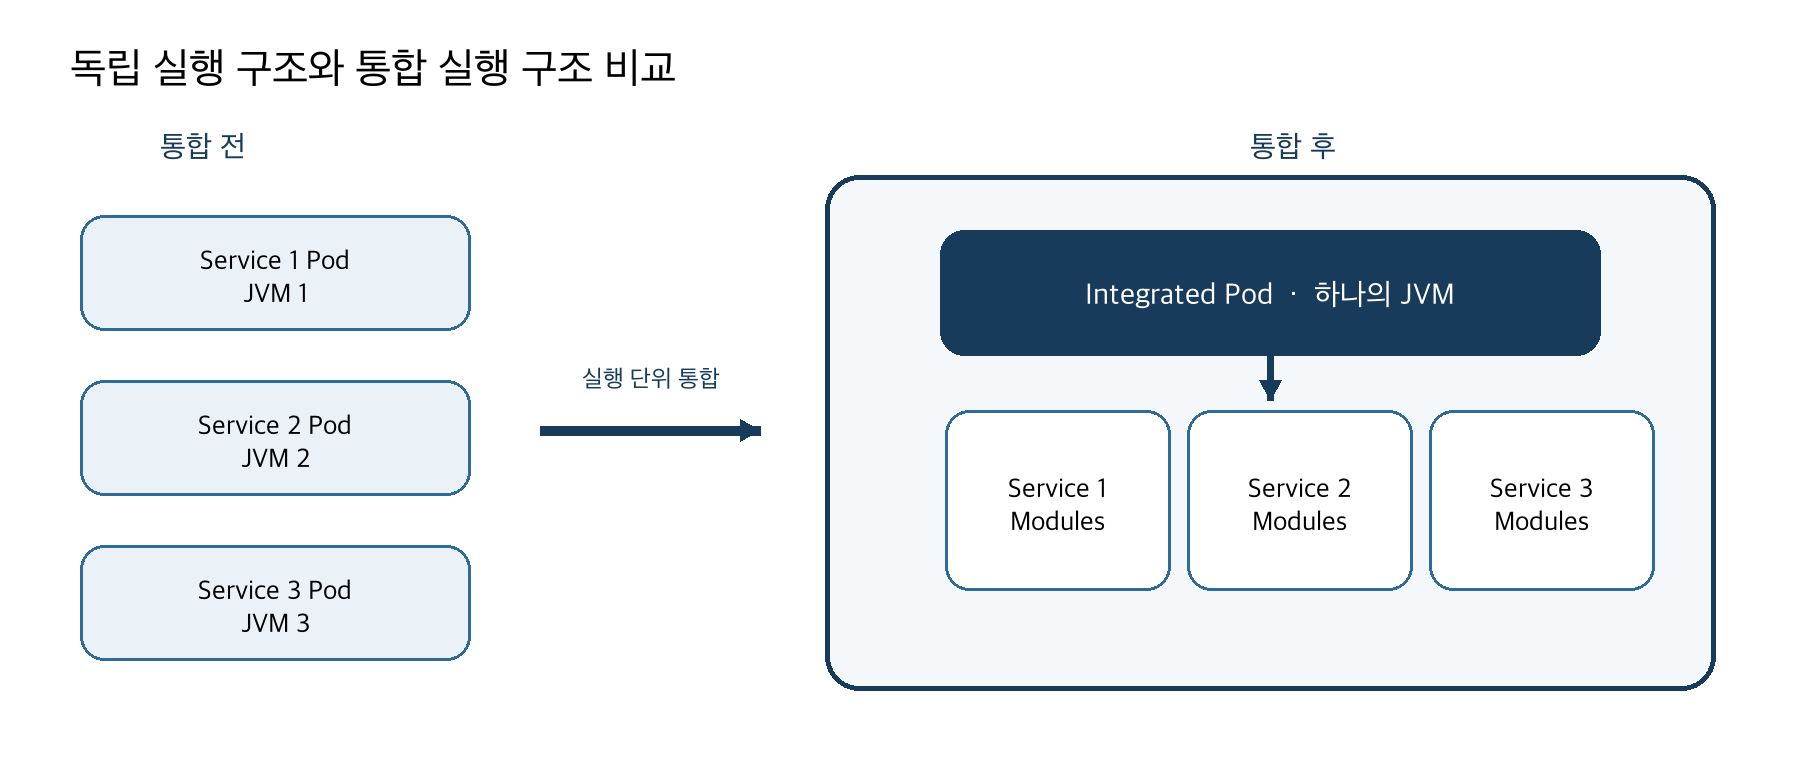
図1. 独立したPodとJVM構成から統合Boot構成への変化
ここで複数のサービスを1つのサービスとして再設計しようとしているわけではありません。デプロイと実行の単位は統合しつつ、サービスごとのコードとデータ所有権は維持することが核心です。
3. 統合の目標は可逆性でした
現在の主な適用事例は、GateとGuard、MetroとInflo、BroとPortoを1つのBootアプリケーションとして組み立てる構成です。各事例では2つのサービスを組み立てていますが、構造自体は2つのサービスに限定されません。topologyにサービスを追加すれば、サイトの要件に応じて5つ以上のサービスも1つのBootとJVMに組み立てることができます。
統合後、特定のサービスのトラフィックが増加したり、より強力な障害分離が必要になったりする可能性もあります。この場合、そのサービスを再び独立した実行単位として分離できなければなりません。統合が一方向の変更になると、短期的なリソース削減と引き換えに、長期的な運用の柔軟性を失う可能性があります。
この理由から、次の原則を定めました。
• 実行リソースは可能な範囲で共有します。
• サービスごとのpackageとGradleモジュール境界は維持します。
• データアクセスとトランザクション境界はサービスごとに維持します。
• サイトごとに必要なサービスの組み合わせを変更できなければなりません。
• 統合されたサービスは、必要なときに再び独立したBootへ分離できなければなりません。
コスト問題の中心はDBではなく、PodとJVMの繰り返しでした。当時、DBリソースには大きな問題がありませんでした。DB構成まで同時に変更すると、データ所有権、migration、障害範囲、ロールバック戦略まで一度に変わります。そのため、ランタイム統合とDB統合は別々の決定として扱いました。
実行単位は統合しつつ、従来のサービスごとのpersistence境界は維持しました。これが、1つのBootアプリケーションで複数のDataSourceを使用することになった背景です。
4. 複数の統合方式を検討しました
ランタイムを統合する方法は1つではありませんでした。Pod内に複数のコンテナを配置する方式、既存のJARをclasspathで組み合わせる方式、ParentとChild ApplicationContextを使用する方式、ソースレベルで1つのbuild graphに組み立てる方式などを検討しました。DB connection自体を削減するためのproxyやconnection poolの共有、ランタイムメモリを削減できるNative Imageについても併せて調査しました。
|
方式 |
JVM削減 |
既存コードへの影響 |
サービス組み合わせの柔軟性 |
検討結果 |
|---|---|---|---|---|
|
1つのPodに複数のコンテナを配置 |
低い |
低い |
高い |
Pod数は減りますが、JVMコストは維持されます。 |
|
既存JARのclasspath組み合わせ |
高い |
低い |
高い |
Configとartifactのバージョン整合性の管理が複雑になります。 |
|
ParentとChild ApplicationContext |
高い |
中程度 |
高い |
Contextの分離は可能ですが、実装と運用の複雑度が高くなります。 |
|
ソースレベル統合ビルド |
高い |
中程度 |
高い |
1つのbuild graphで衝突を早期に発見できます。 |
|
DB proxyまたはconnection poolの共有 |
なし |
低い |
無関係 |
DB connectionのみを扱い、JVM数は減らせません。 |
|
Native Image |
一部可能 |
高い |
無関係 |
サービスの組み合わせとSpring Contextの衝突を直接解決することはできません。 |
JARの組み合わせ方式も技術的には可能です。各リポジトリが実行可能なBoot JARではなくlibrary artifactを発行し、別途用意したassemblyプロジェクトが必要なバージョンを選択して、1つのBoot JARにすることができます。ただし、独立実行を前提に作られたアプリケーションをデプロイ直前に単純に結合するのは困難でした。
DataSource、JPA、Flyway、SecurityFilterChain、Component Scan、Bean名がすべて独立実行を前提に構成されていました。さらにサービスごとのartifact version matrixまで管理すると、デプロイの組み合わせによる複雑さが増大します。
最終的に、サービスのBootモジュールを除くソースモジュールを1つのGradle workspaceで組み立て、統合専用Bootモジュールを唯一の実行エントリポイントとする方式をまず検証しました。この方式は初期の統合コストがかかりますが、compile段階と起動段階で衝突を迅速に発見できるという利点がありました。
5. 5つのサービスで統合可能性を検証しました
PoCでは、Checkpoint、Metro、Gallery、Pigeon、Vaultを1つのリポジトリと1つのBootアプリケーションとして組み立てました。2つのサービスだけを結合できる構造ではなく、5つ以上の組み合わせも可能かを確認するための構成でした。
integrated
 ├─ checkpoint-* modules
 ├─ metro-* modules
 ├─ gallery-* modules
 ├─ pigeon-* modules
 ├─ vault-* modules
 └─ integrated-boot
統合は次の順序で進めました。
1. 各プロジェクトで独立実行を担当していたBootモジュールを除き、サービスモジュールを取り込みました。
2. アプリケーション全体のエントリポイントとなるintegrated-bootを作成しました。
3. 既存のBootモジュールにあったConfigを、実際の責務に合わせてサービスモジュールまたは統合Bootへ移動しました。
4. 外部artifact依存関係を、同じbuild内のGradle project依存関係に変更しました。
5. Clientの自動構成を明示し、重複するComponent登録を削除しました。
6. 1つのアプリケーションを起動し、初期化APIを呼び出しました。
7. 各サービスのデータがサービスごとのDataSourceに正常に保存されることを確認しました。
機能検証の結果、5つのサービスが1つのPodとJVMで実行され、サービスごとのDataSourceにもデータが正常に登録されました。この結果から、統合可能なサービス数は2つに固定されるのではなく、topologyとリソース上限に応じて拡張できることを確認しました。
ただし、このPoCでは実際の本番トラフィックを使用したCPU、heap、またはコスト削減率を測定できませんでした。Pod数と重複するランタイムリソースが減少する構造的な効果は確認しましたが、これを直ちにコスト削減の数値として表現することはしませんでした。実際の削減効果は、本番環境でCPU、heap、GC、thread数、DB connectionを合わせて測定する必要があります。
6. 難しかったのはパッケージングよりもSpring Contextでした
PoCの過程で、ソースファイルを1つのリポジトリに配置する作業よりも多くの時間を要したのは、BeanとConfigの衝突でした。
独立したアプリケーションではそれぞれ1つだけ存在していたBeanが、統合Contextでは同時に検出されました。特にRestClientが@Componentとして登録される一方でAutoConfigurationでも生成されたため、Bean名または型が衝突しました。特定のclient packageをComponent Scanから除外した場合には、同じ名前を持つ外部連携clientまで一緒に除外される問題も発生しました。
単にcompileが成功したからといって、統合が完了したわけではありませんでした。1つのSpring Contextがすべてのサービスを同時にscanすることで、独立実行環境では明らかにならなかった重複登録や条件付き設定の問題が現れました。
この経験から、統合可能なサービスモジュールには次のルールが必要であることを確認しました。
• 実行エントリポイントは統合Bootが所有します。
• 再利用可能なclientは、Component ScanとAutoConfigurationのいずれか一方の方式だけで登録します。
• package名はroutingだけでなく、scanとexcludeのルールでもサービス境界を示す必要があります。
• サービスモジュールは、独立実行と統合実行で同じBeanを重複して生成してはなりません。
• 共通インフラ設定とサービス専用の補正を区別する必要があります。
結局、ソース統合とJARの組み合わせの違いよりも重要な問題は、複数のサービスが1つのSpring Contextで衝突なく共存できるようにすることでした。この経験が、その後のPrologue共通化の範囲を決定する基準となりました。
7. DataSourceとDBの境界は維持しました
1つのJVMを使用するからといって、DataSourceも必ず1つでなければならないわけではありません。ランタイムの境界とデータの境界は、別々に決定するものです。
統合後も、各サービスは次のpersistence構成要素を独立して維持しました。
• サービスごとのDataSourceを維持します。
• サービスごとのEntityManagerFactoryを維持します。
• サービスごとのJpaTransactionManagerを維持します。
• サービスごとのEntityManagerを維持します。
• サービスごとのSpring Data JPA Repository scan範囲を維持します。
• サービスごとのFlyway migrationを維持します。
GateとGuardを1つのBootアプリケーションとして組み立てても、persistence unitは次のように分離されます。
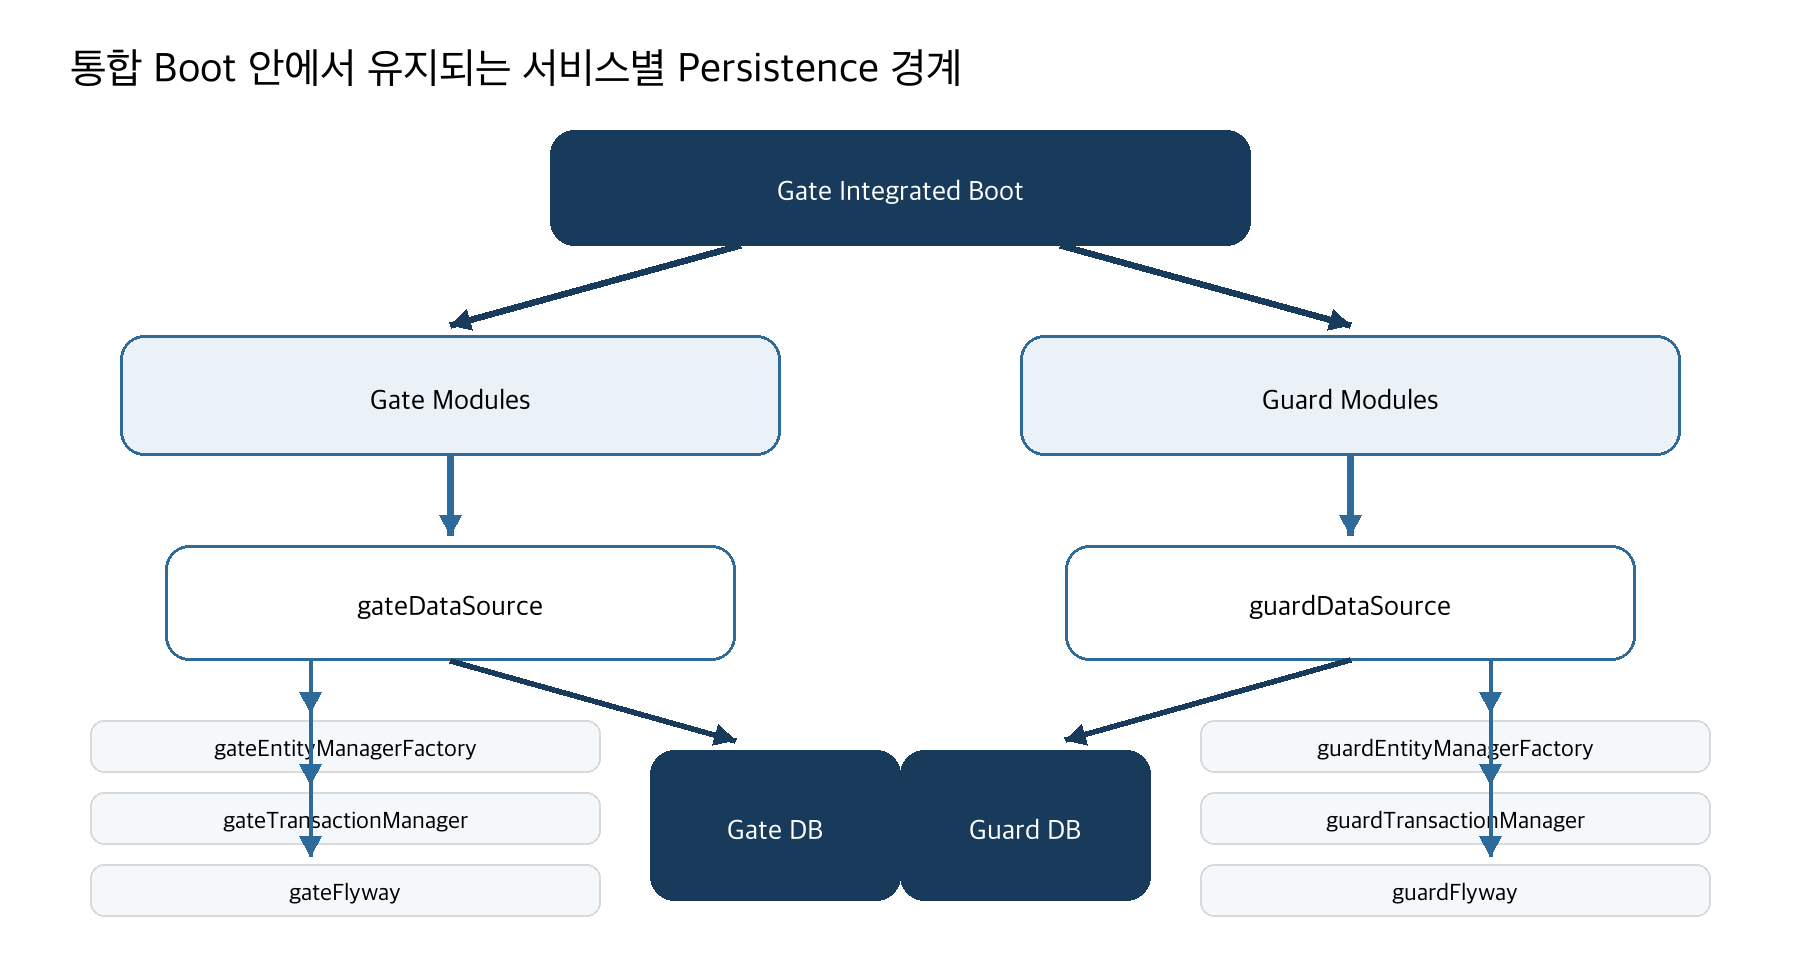
図2. 1つのBoot内で維持されるGateとGuardのpersistence境界
この構造では、あるサービスのEntityとRepositoryが別のサービスのpersistence unitに混在しません。サービスごとのmigration historyと実行順序を独立して管理でき、特定のサービスを再び独立したBootに分離する際のデータ層の変更も抑えられます。実行単位を統合するかどうかと、DB topologyを変更するかどうかを別々に決定できる点も重要な利点です。
一方、DataSourceごとにconnection poolが作成されるため、全体のconnection budgetをサービスごとに配分する必要があります。HikariCPのデフォルト値をすべてのDataSourceにそのまま適用すると、統合後のDB connection数が予想より多くなる可能性があります。そのため、各poolのmaximumPoolSize、minimumIdleとDBのmax_connectionsを、統合されたtopology全体の観点から計算する必要があります。
MultiDatasource自体がconnection問題の原因ではありません。ただし、複数のpoolを一緒に管理しなければ、新たな運用上の問題になる可能性があります。
8. packageを基準にトランザクションを選択しました
DataSourceを複数登録するだけでは十分ではありません。一般的な@TransactionalがどのTransactionManagerを使用すべきかを決定する必要があります。
各サービスコードで、次のようにqualifierを繰り返し指定できます。
@Transactional("gateTransactionManager")しかし、この方法ではサービスコードが統合デプロイ構造を直接把握していなければなりません。サービスを再び分離したり、別の組み合わせで構成したりする際の修正箇所も増えます。
サービスのpackageはすでに安定した論理境界として使用していたため、packageベースのroutingを選択しました。
io.vizend.gate.* → gateTransactionManager
io.vizend.guard.* → guardTransactionManager
other package → default service TransactionManager
開発者が@Transactional("customTransactionManager")のようにqualifierを明示した場合は、その決定を維持します。qualifierがない場合に限り、宣言クラスのpackageを基準にサービスとTransactionManagerを関連付けます。
@Primary EntityManagerはrouting proxyとして提供します。現在のトランザクションに1つのEntityManagerFactoryだけがバインドされている場合は、そのサービスのshared EntityManagerに委譲します。複数のトランザクションリソースがネストしている場合は、現在のトランザクション名とpackage規則によって対象を選択します。アクティブなトランザクションがない場合は、設定されたdefault serviceを使用します。
この動作を魔法のように隠してはいけません。packageの移動はtransaction routingの変更になる可能性があり、規則外のpackageはdefault serviceへfallbackします。そのため、package規約、qualifierの優先順位、fallbackの動作をテストとドキュメントで固定しました。
また、サービスごとのJpaTransactionManagerは互いに独立したローカルトランザクションです。2つのDataSourceに対する変更を、1つの原子的なトランザクションにまとめるものではありません。複数のDBを同時に変更する必要がある場合は、REQUIRES_NEW、補償処理、outbox、再試行と冪等性、または別途分散トランザクション戦略を要件に応じて検討する必要があります。
9. Gate、Metro、Broで繰り返される構成を確認しました
初期には統合BootがMultiDatasource Configを直接所有していました。要件と例外が十分に検証されていない状態で共通ライブラリに先に組み込むよりも、実際のサービスに適用しながら必要な規則を確認する方が安全だと判断しました。
同じ統合パターンがGate、Metro、Broへ拡大するにつれて、状況が変わりました。
|
統合Boot |
一緒に組み立てられるサービス |
適用過程で確認した特徴 |
|---|---|---|
|
Gate |
Gate + Guard |
packageベースのtransaction routingにおける基本的なケースを確認しました。 |
|
Metro |
Metro + Inflo |
サービス間の呼び出し失敗とtransaction propagationの境界を確認しました。 |
|
Bro |
Bro + Porto |
一部のサービスが無効化された際に、実際のdefault serviceを再選択する必要がありました。 |
|
拡張PoC |
Checkpoint + Metro + Gallery + Pigeon + Vault |
同じ原則によって、5つ以上のサービスも組み立てられることを確認しました。 |
各統合Bootには、次のコードが繰り返し記述されていました。
• 一定の名前でDataSourceとJPA Beanを生成しました。
• EntityとRepositoryのpackage scanを設定しました。
• サービスごとのFlyway設定と実行を構成しました。
• デフォルトのBean aliasを登録しました。
• サービスの有効化可否を処理しました。
• TransactionManagerとEntityManagerのroutingを構成しました。
運用中にサービスの組み合わせが増えるたびに、同じConfigをコピーする必要がありました。共通ロジックを修正するときは、すべての統合Bootを探して同じ変更を反映する必要があり、サービスごとに少しずつ異なる形で実装される可能性も高まりました。ランタイム統合によってPodの運用コストを削減する代わりに、繰り返されるJava Configとサービスごとの差異という新たな保守コストが発生したのです。
10. 繰り返される規則をPrologueへ昇格させました
Gate、Metro、Broで共通規則と例外を確認した後、MultiDatasource構成をPrologueへ移しました。サービスコードを単に共通モジュールへ移したのではなく、複数のサービスで繰り返し検証した規則をプラットフォーム契約へ昇格させる作業でした。
PrologueのMultiDatasource自動構成はopt-in方式です。既存の単一DataSourceサービスに影響を与えないよう、明示的に有効化したアプリケーションでのみ動作します。利用サービス側には、どのサービスを組み立てるかとpackage境界だけを残します。
vizend:
  prologue:
    multi-datasource:
      enabled: true
      default-service: gate
      services:
        gate:
          base-package: io.vizend.gate
        guard:
          enabled: ${vizend.guard.enabled:true}
          base-package: io.vizend.guard
接続情報とHikariCP、Flyway overrideは、従来どおりサービスごとのdatasource設定に保持します。Prologueはtopologyに基づいて、サービスごとのpersistence Beanとrouting構成を登録します。
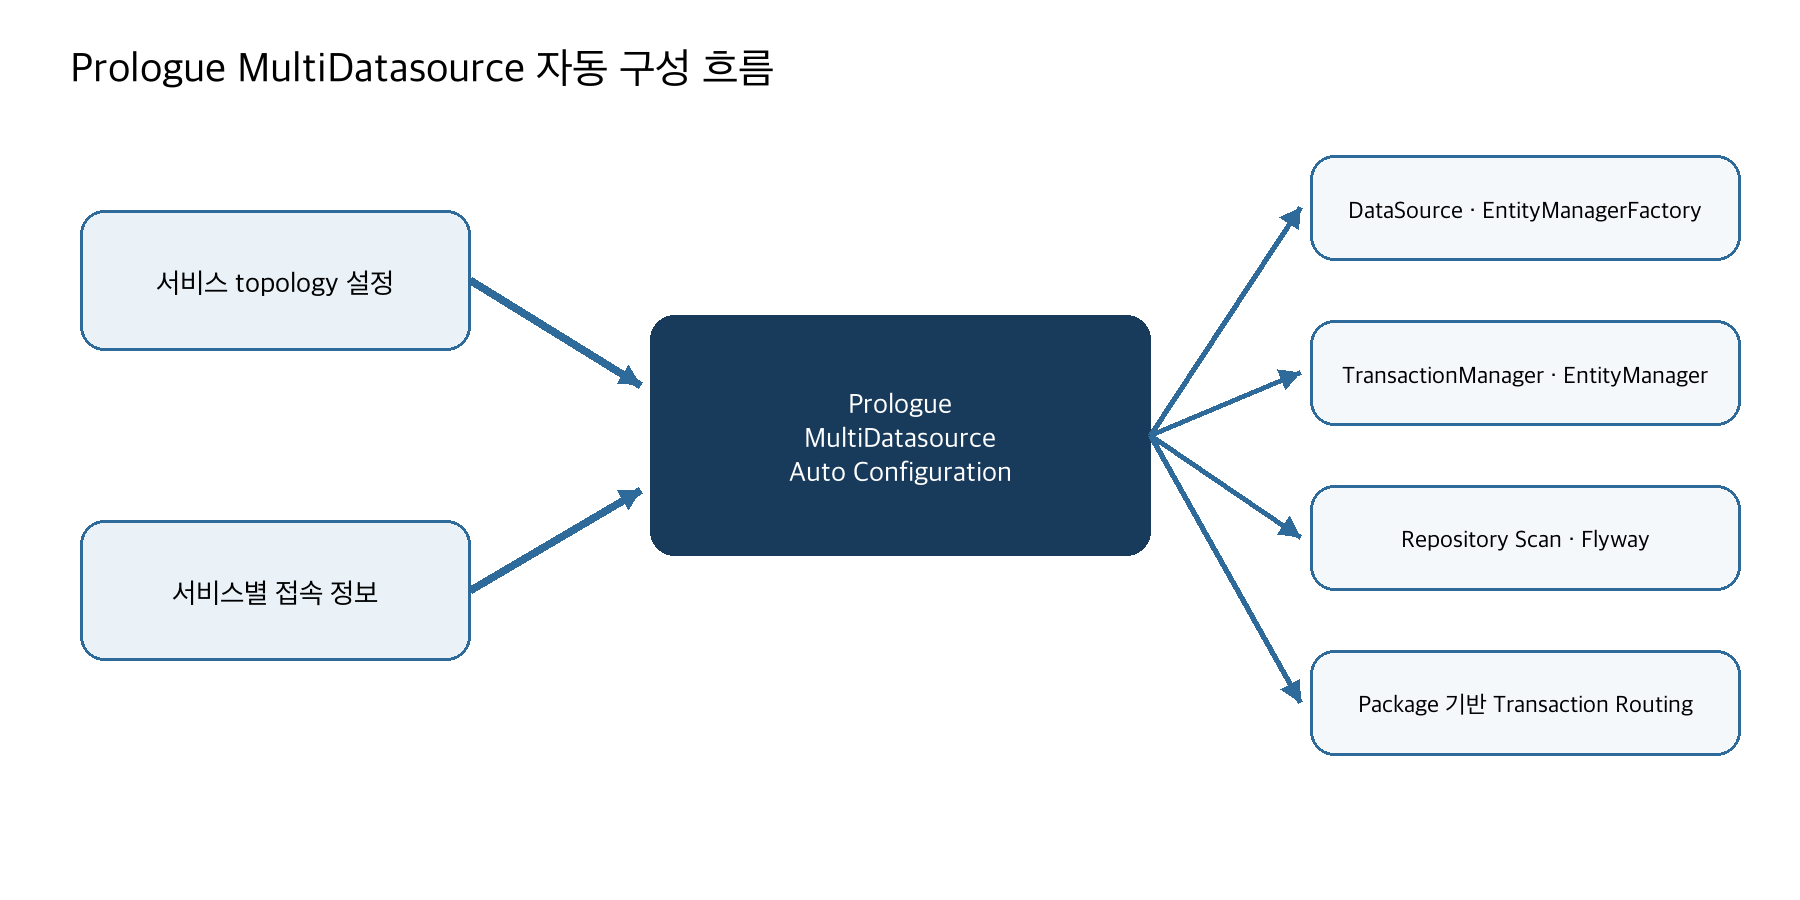
図3. topology設定を実際のpersistence構成へ変換するPrologueの役割
共通化の境界も重要でした。すべての差異をPrologueの中へ押し込んだわけではありません。特定サービスのコード生成Storeや、名前ベースのTransactionTemplateのように、そのサービスの呼び出し構造にのみ必要な補正は利用サービス側に残しました。
共通ライブラリは、すべての例外を吸収する場所ではありません。複数のサービスが同じように守るべき契約を提供し、サービス固有の責任は各サービスに残すべきです。
11. Prologueによる共通化後に変わった点
第一に、新しい統合Bootを作成する際にコピーするJava Configが減りました。サービスはtopologyと接続情報に集中し、Bean生成規則はPrologueが一貫して適用します。
第二に、サービスの組み合わせ変更が明示的な設定になりました。サービスのenabled値によって、特定のpersistence topologyを除外できます。設定されたdefault serviceが無効になる組み合わせでも、実際に有効なサービスの中からデフォルトサービスを決定できるように処理しました。
第三に、統合と分離のコストが低下しました。サービスコードのtransaction annotationとrepository実装は、デプロイ形態を直接把握する必要がありません。統合BootではPrologueがroutingを担当し、独立したBootでは対象サービスのpersistence構成だけを使用すればよくなります。
第四に、テストすべき契約が明確になりました。次の項目を自動構成における主要な検証対象として整理しました。
• 機能が無効化された場合に、Prologueがpersistence Beanを生成しないことを確認します。
• アクティブなサービスごとに必要な Bean がすべて生成されることを確認します。
• Repository が正しい persistence unit を使用していることを確認します。
• 一般的な @Transactional が package に適した TransactionManager を選択することを確認します。
• 明示的な qualifier が保持されることを確認します。
• サービスの有効化の組み合わせに応じて default service が正しく決定されることを確認します。
• Flyway が各サービスの DB と schema で実行されることを確認します。
• 単一 DataSource サービスの既存の起動方式に影響を与えないことを確認します。
共通化は、コードの行数を減らすことだけでは評価しにくいものです。同じ修正が必要な統合 Boot ごとに Config を繰り返し変更しなくてもよくなり、新しいサービスの組み合わせも topology の宣言で説明できるようになった点のほうが、より大きな変化でした。
12. 適用過程で得られた教訓
12.1 アーキテクチャの変更は運用上の問題から始めるべきです
MultiDatasource は目的ではありませんでした。Pod と JVM の重複コストを削減しながら、サービス境界を維持するための手段でした。解決しようとする問題が明確だったため、DataSource を 1 つに統合するような、問題に直接関係しない変更を避けることができました。
12.2 実行境界とデータ境界を同時に動かす必要はありません
サービスを 1 つの JVM で実行することと、1 つの DB を使用することは独立した選択です。2 つの決定を分離すれば変更範囲が小さくなり、サービスが成長したときに再び分離できる余地も大きくなります。
12.3 まずサービスで検証してからプラットフォームに引き上げるほうが安全です
最初から汎用的な自動構成を設計していたら、実際の Bean の衝突、非アクティブなサービス、default service の切り替え、サービスごとの補正について十分に把握することは難しかったでしょう。複数のサービスで同じ問題が繰り返された後に共通化したため、Prologue の責任と境界を具体的に定めることができました。
12.4 便利な routing であるほど、明示的な規約が必要です
package ベースの routing はサービスコードを簡潔にしますが、package の規則、fallback、トランザクションの制約を理解していなければ、予測しにくい動作になります。自動化するほど、設定、ドキュメント、統合テストはより明示的でなければなりません。
12.5 Pod の削減はコスト削減の可能性を意味するものであり、測定結果とは区別する必要があります
1 つの JVM に統合すれば、重複した heap と thread pool を削減できる可能性が高くなります。一方で、1 つの障害が複数のサービスに影響を及ぼす範囲は広がり、複数の DataSource の connection pool も引き続き管理する必要があります。最終的な評価では、実際のデプロイ環境で CPU、heap、GC、DB connection、障害の影響範囲を併せて測定する必要があります。
13. おわりに
今回の作業で統合したのは、サービスの所有権やデータ境界ではなく、実行コストです。
Pod と JVM は削減しつつ、サービスごとの package、persistence unit、トランザクション境界は維持しました。ソースレベルの統合 PoC により、5 つのサービスが 1 つの Spring Context で動作できることを確認しました。その後、Gate、Metro、Bro を中心にパターンを適用する中で、同じ Config が繰り返される問題を発見し、十分に検証した MultiDatasource の規則を Prologue の共通自動構成へと昇格させました。
この構造がすべてのサービスに適しているわけではありません。独立したスケーリング、異なるデプロイサイクル、または強力な障害分離が重要なサービスには、個別の Pod のほうが適している場合があります。重要なのは、最初から 1 つのデプロイ形態に固定しないことです。サービス境界とデータ所有権を維持すれば、運用環境に応じてサービスを統合したり、再び分離したりできます。
小さく分割するだけで、優れたアーキテクチャが完成するわけではありません。必要な境界を守りながら現在の運用規模に合わせて組み立て、状況が変われば再び分離できる必要があります。
David