
1. Возникновение проблемы
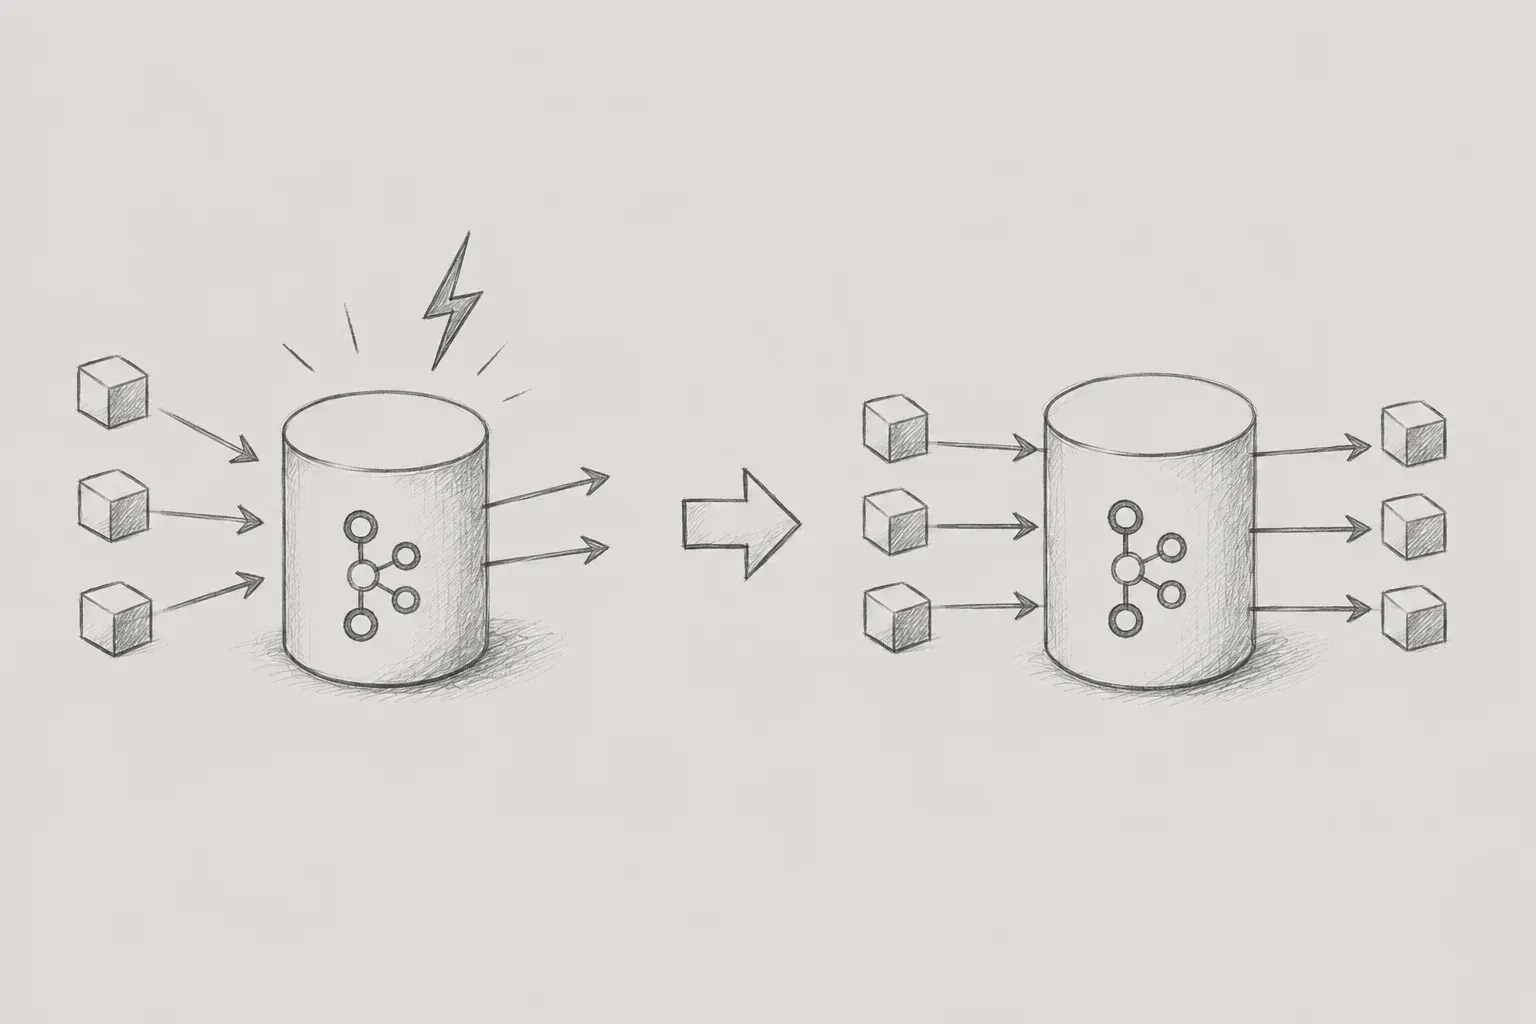
Мы получили запрос о том, что сообщения Kafka неправильно обрабатывались в рабочей среде.
Проверив журналы сервера, мы обнаружили, что перебалансировка Consumer Group регулярно происходила примерно с интервалом в 10 минут.
Чтобы определить причину перебалансировки, мы проверили настройки Consumer и фактическое время обработки сообщений.
В тот момент max.poll.interval.ms было установлено в значение 10 минут, а обработка одного сообщения Kafka занимала более 10 минут.
max.poll.interval.ms — это максимально допустимый интервал между моментом, когда Consumer вызывает poll(), и моментом следующего вызова poll(). Поэтому мы пришли к выводу, что Consumer не мог поддерживать нормальный цикл обработки, поскольку время обработки сообщения превышало это значение, что приводило к перебалансировке.
Настройки на момент выявления проблемы были следующими.
max.poll.interval.ms=600000Сопоставив журналы и настройки, мы подтвердили, что проблема заключалась не в получении сообщений Kafka как таковом, а в том, что время обработки сообщений стало слишком большим и превысило предельный интервал обработки Consumer.
2. Первоначальные меры по эксплуатации
После выявления причины прежде всего необходимо было смягчить ситуацию, при которой в работающем в производственной среде Consumer регулярно происходила перебалансировка.
Соответственно, мы изменили max.poll.interval.ms с исходных 10 минут на 30 минут.
max.poll.interval.ms=1800000Это изменение конфигурации обеспечило Consumer достаточное время для обработки сообщений, даже если текущее время обработки превышало 10 минут.
Однако мы не считали эту меру фундаментальным решением.
Поскольку текущее время обработки составляло 10 минут, изменение настройки на 30 минут могло устранить непосредственную проблему. Однако в будущем та же проблема могла возникнуть снова, если из-за роста объёма данных или увеличения времени обработки в DB время обработки превысило бы 30 минут.
Поэтому в рабочей среде мы сначала изменили конфигурацию, чтобы Consumer мог нормально обрабатывать сообщения, а затем дополнительно исследовали причину длительной обработки сообщений.
3. Анализ причины задержек обработки сообщений
Изучив логику обработки сообщений, мы обнаружили, что при обработке одного сообщения Kafka в MSSQL сохранялось примерно 46 000 записей.
Проблема заключалась не в самом количестве записей — 46 000, — а в том, что для обработки одного сообщения выполнялось множество операций сохранения в DB, из-за чего общее время обработки увеличивалось до более чем 10 минут.
С точки зрения Kafka Consumer это была задача по обработке одного сообщения, однако внутри приложение выполняло множество операций сохранения в DB для обработки этого сообщения.
Поэтому мы пришли к выводу, что необходимо сократить само время обработки сообщений, а не продолжать изменять настройки Consumer.
Мы проследили логику обработки сообщений и изучили каждый этап обработки, подтвердив, что на секцию сохранения в DB приходилась значительная часть общего времени обработки.
Соответственно, мы приступили к улучшению этой секции сохранения в DB, чтобы сократить время обработки Consumer.
Причину этой проблемы и направление её решения можно обобщить следующим образом.
-
Обработка одного сообщения Kafka занимала более 10 минут
-
max.poll.interval.ms было установлено в значение 10 минут
-
Во время обработки сообщений регулярно происходила перебалансировка
-
Секция сохранения в DB занимала значительное время при обработке сообщений
-
Было решено сократить общее время обработки сообщений за счёт улучшения метода сохранения в DB
4. Изменение метода сохранения в DB
Изучив логику обработки сообщений, мы обнаружили, что сохранение примерно 46 000 записей в MSSQL занимало значительное время.
Существующее приложение использовало JPA. Для этого улучшения было необходимо изменить только секцию сохранения в DB в рамках конкретного потока обработки сообщений, заменив её на метод на основе Batch.
Поскольку настройки Batch в JPA могут влиять на операции Hibernate, использующие эти настройки, мы сохранили существующие настройки JPA и применили JdbcTemplate.batchUpdate() только к соответствующей логике сохранения.
jdbcTemplate.batchUpdate(
   sql,
   data,
   batchSize,
   (PreparedStatement ps, T obj) -> {
      // 데이터 바인딩
   }
 );
Ранее операции сохранения в DB повторялись при сохранении нескольких записей. После изменения записи группировались в единицы Batch и вставлялись вместе.
Это позволило улучшить время обработки проблемной секции сохранения в DB, не затрагивая другую логику сохранения, использующую существующий JPA.
5. Сохранение существующего метода генерации ID
При изменении метода сохранения в DB мы также изучили существующий метод генерации ID.
В Entity использовалась стратегия guid в Hibernate, а в существующей среде ID генерировались с помощью NEWID() в MSSQL.
При выполнении вставок напрямую через JdbcTemplate процесс генерации ID, который ранее обрабатывался JPA/Hibernate, необходимо обрабатывать напрямую. Поэтому требовалось настроить процесс так, чтобы ID генерировались так же, как и раньше.
Также можно было генерировать UUID в Java и передавать его, однако в рамках этой задачи мы отдали приоритет сохранению существующего метода генерации ID в системе.
Поэтому мы также настроили Batch Insert на использование NEWID() в MSSQL.
INSERT INTO TABLE_NAME ( ID, COLUMN_A, COLUMN_B)
VALUES (NEWID() , ?, ?)
Это позволило сохранить метод генерации ID, используемый существующей системой, изменив при этом только метод сохранения в DB на Batch Insert.
В этой задаче важным критерием было не только повышение производительности обработки, но и предотвращение ненужных изменений существующего метода генерации данных.
6. Результаты улучшения
После применения Batch Insert время, необходимое для секции обработки в DB, в которой сохранялось примерно 46 000 записей, сократилось, что также улучшило общее время обработки сообщений Kafka.
Когда возникла проблема, перебалансировка регулярно происходила из-за того, что время обработки сообщений превышало max.poll.interval.ms.
Сначала мы изменили max.poll.interval.ms на 30 минут, чтобы смягчить ситуацию в рабочей среде, а затем улучшили секцию сохранения в DB, которая была причиной увеличения времени обработки, применив метод Batch Insert.
В результате время, необходимое для сохранения в DB, сократилось, вместе с ним уменьшилось и общее время обработки сообщений, а повторяющаяся перебалансировка также была устранена.
Важным моментом этого улучшения было то, что мы не просто избежали проблемы, увеличив max.poll.interval.ms до 30 минут. Вместо этого мы разделили эксплуатационное смягчение проблемы, достигнутое за счёт изменения конфигурации, и улучшение кода, направленное на сокращение фактического времени обработки.
Изменение конфигурации было мерой, призванной обеспечить работающему в производственной среде Consumer достаточное время для обработки сообщений, тогда как применение Batch Insert было улучшением, направленным на сокращение фактического времени обработки сообщений.
Это позволило сначала смягчить последствия инцидента в рабочей среде и одновременно устранить фактическую причину задержки обработки.
7. Что мы подтвердили в ходе расследования этой проблемы
В ходе расследования этой проблемы мы подтвердили, что Rebalancing, происходящий в Kafka Consumer, не следует рассматривать исключительно как проблему конфигурации Kafka.
Изначально проблема была описана как «сообщения Kafka не потребляются», но после подтверждения того, что в логах Rebalancing происходил неоднократно, нам удалось сузить круг причин, сопоставив конфигурацию Consumer с фактическим временем обработки сообщений.
В частности, max.poll.interval.ms и фактическое время обработки сообщений имели близкие значения. Подтвердив, что сохранение данных в DB во время обработки сообщений занимало значительное время, мы установили, что явление, похожее на проблему Consumer, на самом деле было связано со временем выполнения логики обработки сообщений.
Мы также подтвердили, что одно лишь увеличение max.poll.interval.ms не может решить проблему.
Увеличение этого параметра позволяет Consumer получить больше времени для обработки сообщений, но если фактическое время обработки продолжит увеличиваться, та же проблема в конечном итоге может возникнуть снова.
Поэтому при возникновении аналогичной проблемы в production мы считаем важным не ограничиваться анализом конкретных значений конфигурации, а определить момент возникновения Rebalancing и сопоставить его с фактическим процессом обработки сообщений, чтобы выяснить, на каком этапе увеличивается время обработки.
В данном случае основным узким местом был этап сохранения данных в DB, однако даже при возникновении того же явления фактической причиной может быть не DB.
Важно не предрешать, что причиной является определённая технология или настройка, а шаг за шагом сужать круг причин, одновременно изучая логи, конфигурацию и фактический процесс обработки.
8. Заключение
Изначально эта проблема выглядела как ситуация, при которой сообщения Kafka не потреблялись должным образом, но, одновременно изучив логи, конфигурацию Consumer и фактическое время обработки, мы смогли сузить круг причин возникновения Rebalancing.
Вместо того чтобы завершать расследование простым изменением max.poll.interval.ms, мы также выявили этап сохранения данных в DB, на котором фактическая обработка сообщений занимала много времени, и улучшили способ обработки.
В частности, мы подтвердили, что при возникновении операционного инцидента необходимо различать быстрое устранение текущих симптомов и анализ фактического процесса обработки для устранения первопричины.
Если в будущем возникнет аналогичная проблема, мы намерены не ограничиваться проверкой места возникновения ошибки или значений конфигурации, а одновременно изучать логи и фактический процесс обработки, шаг за шагом сужать круг причин и улучшать выявленное узкое место.
Ссылки
-
https://kafka.apache.org/0101/generated/consumer_config.html
-
https://docs.spring.io/spring-framework/reference/data-access/jdbc/advanced.html
-
https://docs.hibernate.org/orm/7.3/introduction/html_single/
-
https://learn.microsoft.com/en-us/sql/t-sql/functions/newid-transact-sql?view=sql-server-ver17