
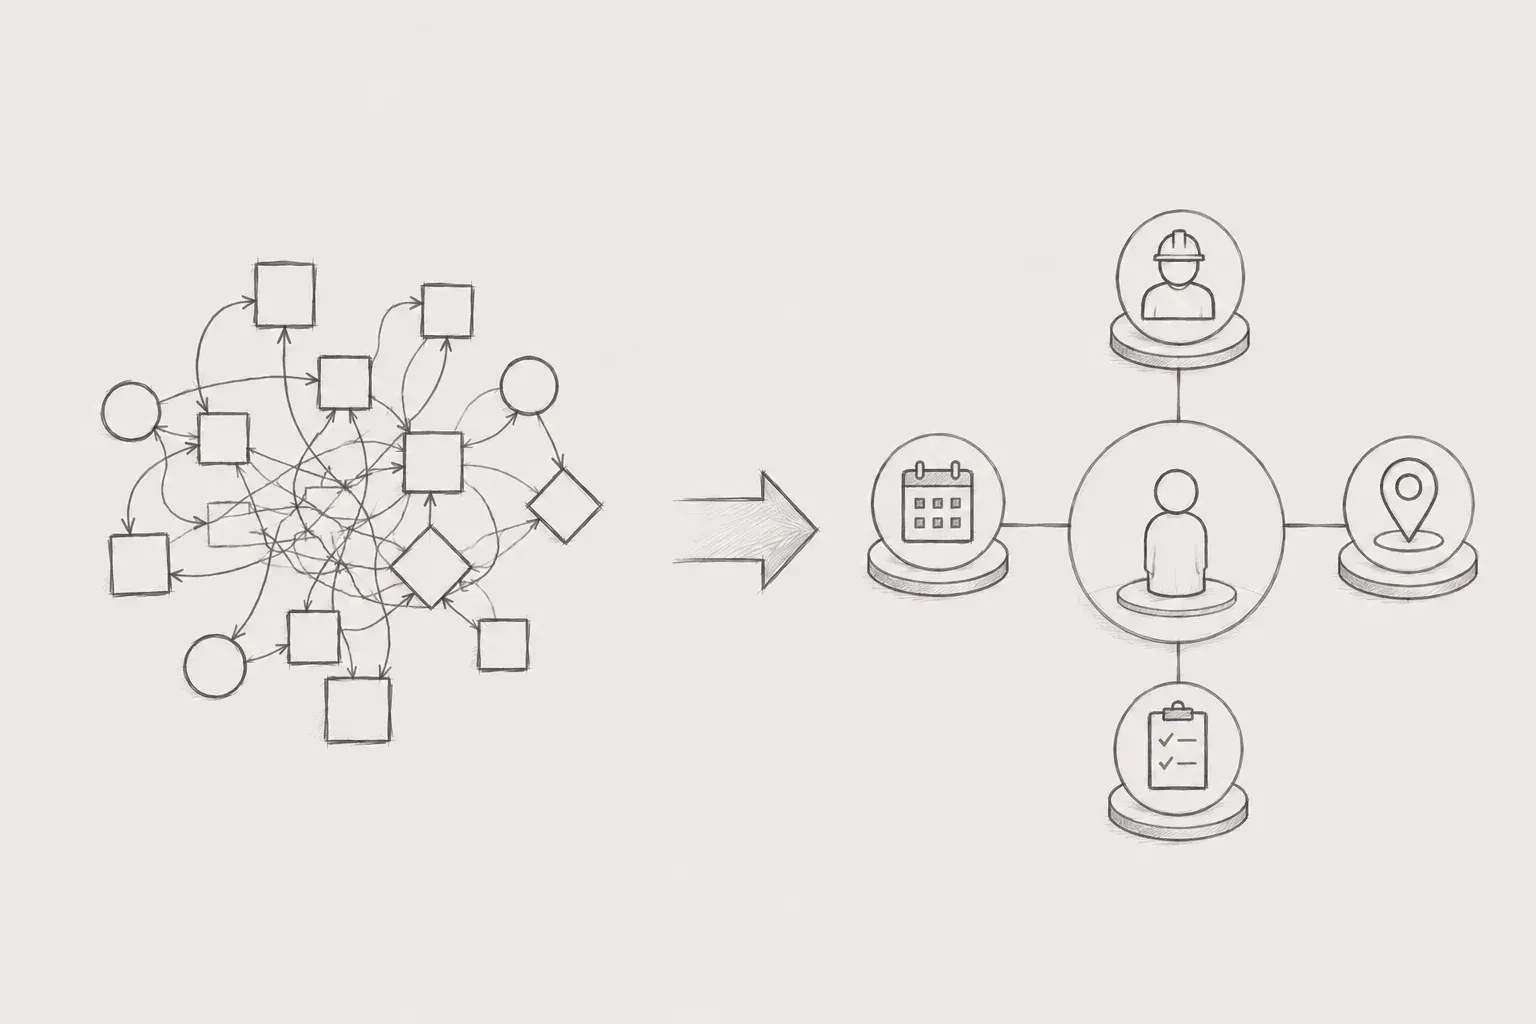
スケジュールのプレッシャーとドメイン設計における現実的な落とし穴
新しいプロジェクトを始める際、多くの開発者はドメイン駆動設計(DDD、Domain-Driven Design)の価値を頭では理解しながらも、現実的な妥協案を選びがちです。特にビジネスの早期リリースを求められるスケジュールのプレッシャーの中では、精緻なドメインモデリングに長い時間を費やすことは困難です。
現場人員管理プラットフォームのプロジェクトでも、開発初期からDDDの思想に基づいてビジネスコードを作成しようと試みました。しかし、逼迫した開発スケジュールの中で急いでドメインを設計していくうちに、アーキテクチャ上重要な核心部分を見落としてしまいました。
当時直面した設計上の限界は、大きく三つありました。
-
ドメインアグリゲート(Aggregate)の範囲設定の欠如: 個々のドメインオブジェクトが、どのライフサイクルとトランザクション範囲を共有すべきかを明確に定義できていませんでした。
-
値オブジェクト(Value Object)の無分別なエンティティ(Entity)化: 識別子を必要とせず、単に属性のまとまりとして表現すべき値オブジェクトまでも、無条件に独立したエンティティとして設計していました。
-
ドメイン間の関係設定の欠落: オブジェクト同士がどのように結び付いて動作するのかを、ドメインレベルで明示的な関係として定義できていませんでした。
この状態でビジネスルールが追加されると、システムの複雑度は急激に上昇し始めました。ドメイン間の関係がコードに宣言されていなかったため、サービスレイヤー(Domain Service)がビジネスロジックを実行するたびに、あちこちに分散したエンティティを直接取得し、コード上で関係を手動で復元しなければなりませんでした。その結果、サービスロジックは肥大化し、整合性の検証も難しくなりました。
私たちは一度立ち止まり、これを正すことにしました。スケジュールのプレッシャーの中で残された技術的負債を解消し、ドメインの自律性を取り戻すために行ったリファクタリングの核心的な過程を共有します。
用語と概念の確立:ユビキタス言語(Ubiquitous Language)をコードに落とし込む
DDDの第一歩は、企画担当者、デザイナー、開発者など、プロジェクトに参加する全員が同じ言葉でコミュニケーションできるユビキタス言語(Ubiquitous Language)を確立することです。リファクタリング前のプロジェクトコードでは、技術的に便利な用語や曖昧な言葉がドメインオブジェクトの名前として使われていました。
「技術の言葉」から「業務の言葉」へ
代表的な例が、求人広告に労働者が応募する行為を表すオブジェクトでした。既存のコードでは、これを単にApplicationと命名していました。開発者の観点では非常に自然な言葉でしたが、この言葉には次のような問題がありました。
-
Applicationは、フレームワークやアプリケーションそのものを指す技術用語と混同され、混乱を招きました。
-
人材供給ビジネスで実際に使われる用語は、現場に登録して働く意思を示す「登録(Enrollment)」に近いものでした。
リファクタリングの過程で、私たちはこれをEnrollmentというドメイン名に変更しました。また、応募書類の審査過程で一時的に生成していたファイルバックアップオブジェクトApplicationWorkerProfileSnapshotのように、技術中心的な言葉であるSnapshotを排除し、ビジネスの観点から直感的なEnrollmentProfileとSubmittedDocumentへと名称を改善しました。
|
[Before] 技術中心の命名 JobApplication ──> ApplicationWorkerProfileSnapshot ──> ApplicationDocumentSnapshot [After] ビジネス(ユビキタス言語)中心の命名 Enrollment ──> EnrollmentProfile ──> SubmittedDocument |
|---|
開発者は今や、コードを書く際に企画書の流れを頭の中で翻訳する必要がなくなりました。コードを読むこと自体が、ビジネスシナリオを読むことと同じになったからです。ドメインモデルを見たときに業務の場面をそのまま想像できるアーキテクチャ、それがユビキタス言語の意味なのだと理解しました。
アグリゲート(Aggregate)の境界設定:無分別なエンティティ化を克服する
初期設計における最大の負債は、「無分別に独立したエンティティとして設計されたオブジェクト」でした。オブジェクト指向とDDDにおいて、エンティティとは固有の識別子(Identity)を持ち、ライフサイクル全体にわたって追跡されるべきオブジェクトです。一方、値オブジェクト(Value Object / Value Group)は識別子を持たず、単に属性を表現し、親オブジェクトのライフサイクルに従属します。
スケジュールに追われ、すべてをテーブル形式のエンティティとして実装すると、各エンティティは独自のテーブル、リポジトリ、ロジックを持つようになりました。その結果、データベース結合が乱用され、整合性を維持するコストが爆発的に増加しました。
JobPostとJobPostRecruitmentの事例
代表的な例が、求人広告の情報を保持するJobPostと、その広告内で具体的な職種ごとの募集人数および単価を表すJobRecruitmentでした。これらは本来、一つの求人広告に完全に従属する下位概念でしたが、初期設計ではそれぞれ独立したStageEntityとして実装されていました。その結果、次のような非効率が発生しました。
-
求人広告を変更する際に募集条件のデータを更新するには、トランザクション内でJobRecruitmentエンティティを別途取得して変更する必要がありました。
-
広告と募集条件のライフサイクルが完全に一致しているにもかかわらず、内部データを直接変更できる経路が外部に開かれていたため、整合性が崩れるリスクが存在しました。
リファクタリングの過程で、私たちはJobRecruitmentを独立したエンティティではなく、識別子を持たない値オブジェクト(Value Object)グループであるValueGroupへと格下げしました。そして、これをJobPostアグリゲートルートの内部に完全に組み込みました。
これにより、募集条件の追加、変更、削除は、親であるJobPostを通じてのみ行われます。外部から個別の募集条件を勝手に操作できない設計にしたことで、「求人広告が公開されているときだけ募集人数を変更できる」というビジネスルールを、JobPost内部でアトミックに完全保証できるようになりました。
ドメイン間の関係設定とサービスレイヤーのスリム化
初期設計段階でドメインエンティティ間の有機的な関連が明確に宣言されていなかったため、ビジネスロジックを処理するサービスレイヤー(Domain Service)には大きな非効率が存在していました。
|
[初期サービスロジックの形式] 1. AエンティティをIDで取得 2. Bエンティティの外部識別子が必要な状況だが関係がないため、Aエンティティの特定のフィールドを直接取り出す 3. 取り出したフィールドの値を基準に、Bエンティティを別途DBからクエリして取得する 4. Cエンティティも同じ方法で手動で組み立ててロジックを処理する |
|---|
ドメイン間の関係設定(@FieldSourceIdなどの外部キーおよび関連フィールドの規約)が有機的でなければ、エンティティは単に独立した砂粒のように分散してしまいます。この状態でロジックを完成させるには、サービスレイヤーは次のような困難な作業を行わなければなりませんでした。
ドメイン関係がなければ、サービスロジックは毎回関係を手動で復元しなければならず、最終的にはサービスレイヤーの肥大化と可読性の低下につながりました。「ロジックの長さが30行を超えるなら、ドメイン設計が間違っている」という指摘は、まさにこの手動による関係復元コードが原因で生じたものでした。
関係設定とリッチなドメインモデルへの移行
私たちは、ドメイン間の外部参照識別子と関係をモデルレベルで明確に再設定しました。各エンティティに関連する外部キー関係を指定し、エンティティ内部で必要な下位のassociationを明示しました。これに加えて、エンティティ外部からフィールドを無分別に変更できないようsetterの乱用を防ぎ、オブジェクトの状態変更は、明確に定義された振る舞いメソッドであるmodifyAttributesを通じてのみ行われるようカプセル化しました。
このように、ドメインが明確な関係を内包し、自ら妥当性を検証しながら状態を変更するようになると、サービスレイヤーはもはや「データを収集して組み立てるコーディネーター」の役割を担う必要がなくなりました。サービスコードは単に永続化コンテキストからルートエンティティを取り出し、ビジネス上の振る舞いを指示してイベントを発行するオーケストレーターとして、劇的にスリム化できました。
ドメインに生命力をコードへ吹き込む
今回のプロジェクトにおけるドメインリファクタリングは、単にデータベースのカラム名を変更したり、パッケージ構造を変更したりするだけの整理作業ではありませんでした。それは「システムがビジネスを見る視点の転換」でした。
厳しいスケジュールの中で急いで進めていると、設計上の負債が積み重なるのは、ある意味避けられないことです。しかし、それを放置したままサービスが巨大化すると、最終的にアーキテクチャは麻痺します。今回のリファクタリングを通じて、値オブジェクトの分離、正しいアグリゲート設計、ドメイン間の明確な関連関係の設定がもたらす強力なメリットを、身をもって実感できました。
-
保守性の効率化: 新しいビジネスルールが追加されたり、ポリシーが変更されたりしたときに、どのオブジェクトのコードを修正すべきか悩む必要がなくなりました。ルールの所有主体であるアグリゲートを見つけ、その中の検証ロジックだけを修正すればよいからです。
-
コミュニケーションの一致:企画者と開発者の間のコミュニケーションミスが大幅に減りました。企画書上のフローとドメインクラス図が1:1でマッピングされることで、異なる言語を解釈するために費やされていたコミュニケーションコストがなくなりました。
-
予測可能性と安定性:カプセル化と厳密なID設計、アグリゲートの隔離によって、予期せぬ副作用(Side Effect)が根本から遮断されました。システムははるかに予測しやすくなり、堅牢になりました。
スケジュールに追われてひたすら走り続けていたとしても、一度歩調を緩めてドメインを整備することは、今後のプロジェクトのスピードを何倍も速くしてくれます。設計について考える同僚の開発者にも、無作為に生成されたエンティティを値オブジェクトとアグリゲートとして構造化し、ドメイン間の関係を正すこの旅を、ぜひ経験してみるよう強く勧めたいと思います。
informalife