
Введение
В ходе реализации проекта мне понадобилось организовать рабочие документы, написанные людьми, в структурированные данные, которые можно было бы использовать в последующих процессах. В документах на естественном языке описывались бизнес-цели, ответственные лица, процедуры обработки, правила и исключения. Люди могут прочитать документы и понять их контекст, но для использования документов программами в таких последующих задачах, как поиск, классификация и проверка, их необходимо преобразовать в согласованные поля и форматы.
Сначала я подумал, что будет достаточно передать LLM документ и инструкции по преобразованию и попросить организовать содержимое в формате JSON. На практике LLM за короткое время выдавала аккуратно выглядящие результаты. Однако иногда в них естественным образом добавлялись процедуры, отсутствовавшие в исходном тексте, или из результата незаметно исчезало важное предложение. Действия ответственного лица и результаты обработки также иногда смешивались.
Например, в исходном тексте может быть сказано только: «Проверяющий может одобрить запрос или запросить дополнительную информацию», однако LLM может добавить правило «Руководитель команды даёт окончательное одобрение», основываясь на общепринятых деловых практиках. Предложение звучит естественно, но в исходном тексте его нет. Если использовать такой результат только потому, что формат JSON является допустимым, предположение модели превращается в бизнес-факт.
Поэтому я переопределил цель: вместо «заставить LLM создать полные данные» — заставить LLM создать структурированные кандидаты, проверить системой структуру и подтверждение в исходном тексте, а человеку — окончательно решить, использовать ли результат.
В этой статье рассматриваются Structured Output, принимающий ответы в заданном формате JSON; JSON Schema, определяющая контракт вывода; Evidence, предоставляющий основание в исходном тексте; и ограниченный процесс Repair, использующий ошибки валидации. Ключевой вопрос заключается в том, как обращаться с вероятностно сгенерированными результатами как с проверяемыми данными.
Итоговая структура, которую следует изучить в первую очередь
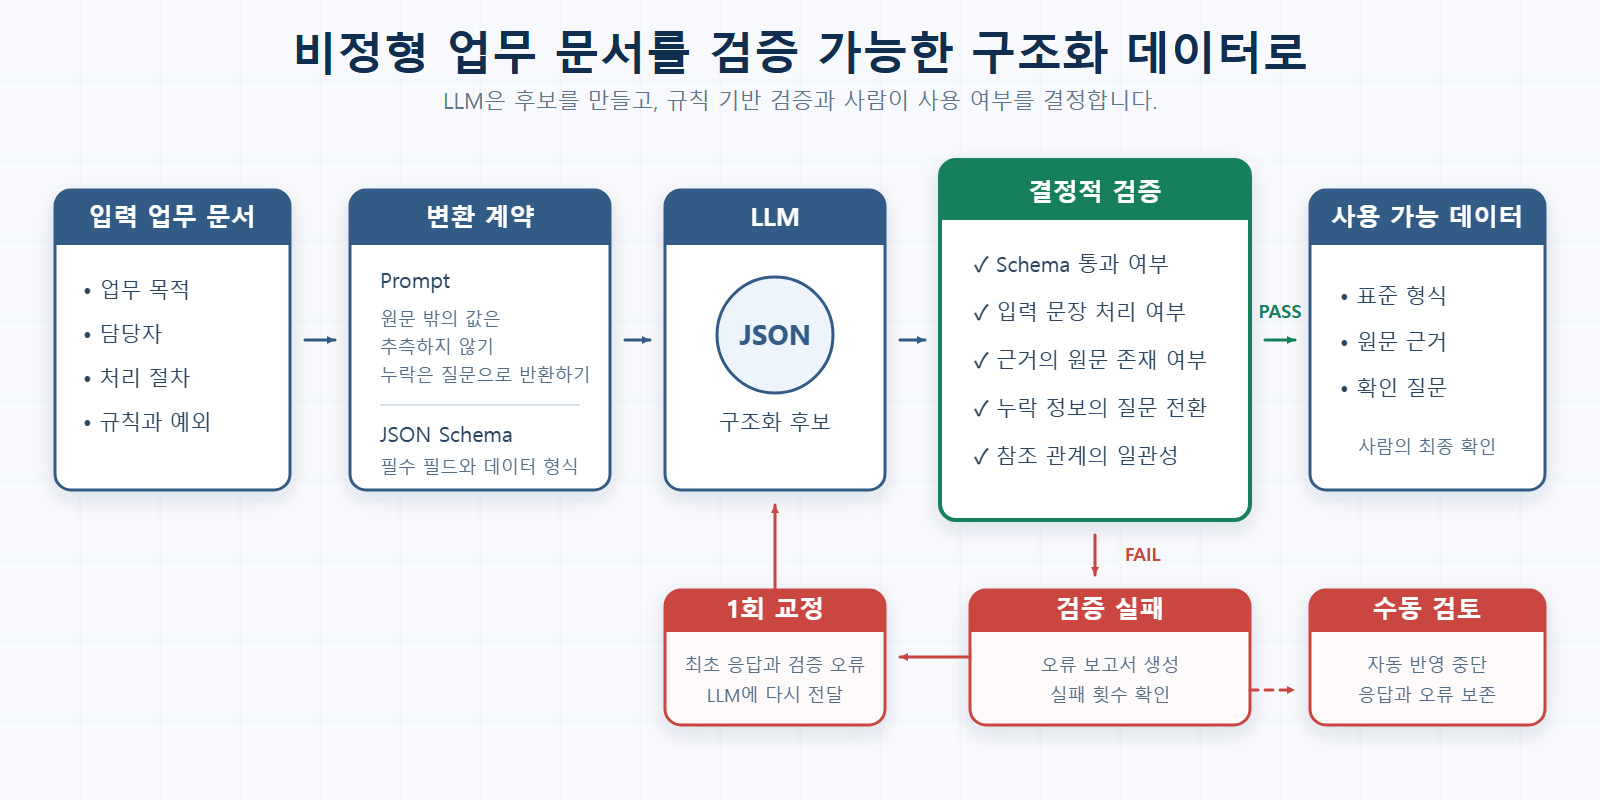
Рисунок 1. Процесс, в котором неструктурированный рабочий документ вместе с Prompt и JSON Schema передаётся системе, после чего результат детерминированно проверяется
Сначала рассмотрим итоговую структуру, которую мы собрали. Исходный текст, Prompt и JSON Schema вместе передаются LLM для создания структурированных кандидатов, а система проверяет структуру, полноту охвата входных данных, подтверждения в исходном тексте и отсутствующую информацию. Здесь под детерминированной валидацией понимается проверка, которая всегда выдаёт один и тот же результат, если к одним и тем же входным данным применяются одни и те же правила. Если валидация завершается ошибкой, система выполняет ограниченное исправление, включающее сведения об ошибках. Если ошибка возникает снова, результат не применяется автоматически, а направляется на ручную проверку.
В следующих разделах последовательно объясняется, какие проблемы возникли при первоначальном подходе и как для их решения мы добавляли каждый этап валидации.
Первоначально задуманная структура: достаточно ли Prompt и JSON Schema?
Исходными входными данными был рабочий документ, написанный человеком. Чтобы упростить объяснение процесса преобразования, в статье используется простой пример под названием «Процедура проверки запроса на выполнение задачи». Приведённые ниже поля данных также разработаны так, чтобы показать связь между документом и структурированным результатом.
Пример рабочего документа для преобразования
작업 요청 검토 절차

배경
현재 작업 요청을 메일과 메신저로 전달하고 있어 요청 상태와 처리 이력을
일관되게 확인하기 어렵습니다.

목표
요청자는 작업 내용을 등록하고 검토 결과를 확인할 수 있어야 합니다.
검토자는 검토가 요청된 작업을 승인하거나 보완을 요청할 수 있어야 합니다.

담당자
- 요청자는 작업 내용을 작성하고 검토를 요청합니다.
- 검토자는 검토가 요청된 작업 내용을 확인합니다.

처리 절차
1. 요청자가 작업 내용을 작성합니다.
2. 요청자가 검토를 요청합니다.
3. 검토자는 요청을 승인하거나 보완을 요청합니다.
4. 검토자는 처리 결과와 검토 의견을 기록합니다.

업무 규칙
- 검토를 요청한 작업만 검토할 수 있습니다.
- 검토 결과에는 처리자와 처리 시각이 포함되어야 합니다.
Результат, который требовалось получить из этого документа
Мне нужен был не краткий пересказ документа. Я хотел связать ответственных лиц и процедуры обработки, описанные в документе, и создать структурированные кандидаты, которые программа могла бы искать и проверять.
|
Содержимое примера документа |
Желаемый структурированный результат |
|---|---|
|
Предыстория и цель |
Цель, которой стремится достичь документ (documentPurpose) |
|
Инициатор запроса и проверяющий |
Список участников с идентификаторами (participants) |
|
Написание, отправка запроса на проверку, одобрение, запрос дополнительной информации и запись результата |
Этапы обработки с указанием ответственных лиц и порядка выполнения (processSteps) |
|
Условия проверки и данные для записи |
Бизнес-правила, которыми необходимо управлять отдельно (rules) |
|
Критерии назначения ответственных лиц, отсутствующие в документе |
Не заполняется произвольно значением nullи вопросами для уточнения (missingFields) |
|
Источник результата |
Цитата из исходного текста, связанная с соответствующим значением (evidence) |
Иными словами, желаемый результат состоит из значений, структурированных на основе документа, вопросов, на которые невозможно ответить только на основании документа, Исходный источник, послуживший основанием для каждого значениятакже необходимо было включить. Только когда целевой результат определён, можно последовательно определить, что было взято из источника, а что отсутствует. Этот критерий мы выразили в виде JSON Schema.
Простая JSON Schema, используемая в качестве контракта вывода
Это упрощённый пример Schema, в котором сохранены только элементы, необходимые для понимания общего процесса.
{
  "type": "object",
  "additionalProperties": false,
  "required": [
    "documentPurpose",
    "participants",
    "processSteps",
    "rules",
    "assignmentRule",
    "missingFields",
    "evidence"
  ],
  "properties": {
    "documentPurpose": { "type": "string" },
    "participants": {
      "type": "array",
      "items": { "type": "object", "required": ["id", "name"] }
    },
    "processSteps": {
      "type": "array",
      "items": { "type": "object", "required": ["order", "actorId", "action"] }
    },
    "rules": { "type": "array" },
    "assignmentRule": {
      "type": ["string", "null"],
      "description": "원문에 배정 기준이 없으면 null"
    },
    "missingFields": {
      "type": "array",
      "items": {
        "type": "object",
        "required": ["fieldPath", "question"]
      }
    },
    "evidence": { "type": "array" }
  }
}
В этом процессе мы распределили обязанности Schema, Prompt и Validator следующим образом.
Schema    : 필수 필드와 데이터 형식을 제한합니다.
Prompt    : 원문에 없는 값은 추측하지 않고 null과 확인 질문으로 반환하게 합니다.
Validator : 참조 관계, 원문 근거, null과 확인 질문의 대응 여부를 검사합니다.
Например, Schema требует, чтобы assignmentRule было обязательным полем, но также допускает значение null. В примере документа лишь объясняется, что проверяющий может одобрить запрос или запросить дополнение; критерий определения ответственного лица среди нескольких проверяющих не указан. Поэтому Prompt настроен не угадывать это значение, а возвращать null вместе с уточняющим вопросом, тогда как Validator проверяет, существуют ли оба значения одновременно.
Структурированные кандидаты, созданные на основе документа
После преобразования приведённого выше документа в структурированные кандидаты, пригодные для чтения программой, он принимает следующий вид. Эта структура данных является примером, созданным для объяснения статьи; это не окончательный ответ, а промежуточный результат, который должен пройти проверку и рассмотрение человеком.
{
  "documentPurpose": "작업 요청의 진행 상황과 처리 이력을 일관되게 확인한다.",
  "participants": [
    { "id": "requester", "name": "요청자" },
    { "id": "reviewer", "name": "검토자" }
  ],
  "processSteps": [
    {
      "order": 1,
      "actorId": "requester",
      "action": "작업 내용을 작성한다."
    },
    {
      "order": 2,
      "actorId": "requester",
      "action": "검토를 요청한다."
    },
    {
      "order": 3,
      "actorId": "reviewer",
      "action": "승인하거나 보완을 요청한다."
    },
    {
      "order": 4,
      "actorId": "reviewer",
      "action": "처리 결과와 검토 의견을 기록한다."
    }
  ],
  "rules": [
    "검토를 요청한 작업만 검토할 수 있다.",
    "검토 결과에는 처리자와 처리 시각을 포함한다."
  ],
  "assignmentRule": null,
  "missingFields": [
    {
      "fieldPath": "assignmentRule",
      "question": "여러 검토자 중 담당자는 어떤 기준으로 정합니까?"
    }
  ],
  "evidence": [
    {
      "fieldPath": "processSteps[1]",
      "sourceExcerpt": "요청자가 검토를 요청합니다."
    }
  ]
}
Для использования этого результата в последующих процессах, таких как поиск и проверка, недостаточно корректного синтаксиса JSON. Дополнительно необходимо убедиться, что из источника не пропущены ответственные лица или процедуры, что Evidence действительно существует в исходном тексте и что модель не выдумала произвольную политику там, где она не была определена.
Сначала мы ожидали получить стабильные результаты, предоставив достаточно подробные Prompt и JSON Schema. С помощью Schema мы ограничили обязательные поля, типы данных и структуры объектов, а ответы получали в формате JSON с использованием функции Structured Output.
Этот подход решил множество базовых проблем. Он значительно сократил такие случаи, как добавление пояснений до или после JSON, включение блоков кода Markdown и различия в названиях полей между запусками. Предоставление Schema, разбор ответа и пути обработки ошибок также можно было многократно проверять с помощью автоматических тестов.
Однако после стабилизации структуры стала отчётливо проявляться ещё более важная проблема. То, что JSON является корректным, и то, что содержание соответствует бизнес-смыслу, — совершенно разные вещи.
Первая проблема: содержание могло быть неверным даже при корректном формате
В ходе оценки часто выявлялась путаница между ответственным лицом, действием и результатом обработки. Даже когда в источнике было сказано: «Проверяющий одобряет запрос или запрашивает дополнение», некоторые ответы создавали нового участника под названием «утверждающий» или добавляли этап под названием «проверка завершена», которых в источнике не было.
Такой результат также может пройти проверку JSON Schema. Это происходит потому, что participants и processSteps являются массивами, а типы их значений корректны. Однако бизнес-содержание изменилось, поскольку были добавлены лицо или процедура, отсутствующие в источнике.
Другой проблемой была непоследовательность в отношениях ссылок. actorId этапа обработки мог отсутствовать в participants, либо один и тот же участник мог быть представлен разными идентификаторами. Каждый объект по отдельности выглядит корректно, но связи между объектами нарушены. Простая нормализация форматов идентификаторов не исправляет неверно интерпретированный смысл.
Начиная с этого момента мы разделили проверку на два уровня.
구조 검증
  - JSON 문법
  - 필수 필드
  - 타입
  - enum
  - key 형식

의미 보존 검증
  - 원문 항목 누락 여부
  - 참여자와 처리 단계의 참조 일관성
  - 처리 순서의 중복과 역전 여부
  - 원문 근거 존재 여부
  - 원문에 없는 값의 임의 생성 여부
Schema по-прежнему оставалась важной, но мы рассматривали её только как необходимое условие. В дополнение к ней мы добавили основанный на правилах Validator, который всегда выносит одинаковое заключение для одинакового входа, а различия между источником и результатом сохраняли как отдельные данные оценки.
Вторая проблема: как найти предложения, которые модель не прочитала?
Когда в ответе LLM отсутствовали некоторые результаты, было трудно определить, действительно ли информация отсутствовала в источнике или модель её пропустила. Эту разницу невозможно установить, проверяя только выходные данные.
Чтобы решить эту проблему, мы разделили входной документ на непустые единицы-предложения и присвоили им идентификаторы. Каждое предложение должно было быть связано с одним или несколькими полями результата либо иметь причину, по которой оно не было преобразовано.
MAPPED    : 하나 이상의 결과 필드와 연결됨
UNMAPPED  : 현재 출력 구조에 대응하는 필드가 없음
EXCLUDED  : 변환 대상이 아닌 문장으로 명시적으로 제외됨
Полнота обязательных полей контролировалась отдельно от состояния входных предложений.
PRESENT      : 원문 근거를 가진 값이 존재함
NEEDS_INPUT  : 원문만으로 확정할 수 없어 사용자 확인이 필요함
Причина такого разделения заключается в том, что информацию, полностью отсутствующую в источнике, невозможно представить как состояние конкретного входного предложения. Охват входных данных отслеживает, «какие предложения были обработаны», а полнота полей определяет, «достаточно ли обязательных значений».
После применения этого подхода к оцениваемому документу мы могли сразу находить необработанные предложения и отличать пропуски модели от ограничений структуры вывода. Мы могли не допускать незаметного исчезновения предложений, не заставляя при этом помещать каждый фрагмент содержания в какое-либо поле.
Третья проблема: даже предложение, похожее на доказательство, могло быть создано моделью
Чтобы повысить надёжность результатов преобразования, мы прикрепляли исходное Evidence к каждому элементу результата. Сначала мы сохраняли возвращённое моделью sourceExcerpt без изменений. Однако оценка показала, что Evidence иногда содержало предложения, обобщённые или перефразированные моделью, а не предложения из источника.
Предположим, например, что исходный текст выглядит следующим образом.
검토자는 요청을 승인하거나 보완을 요청할 수 있습니다.Если модель возвращает приведённое ниже предложение как Evidence, его смысл может показаться похожим.
검토자는 모든 요청의 최종 처리 결과를 결정합니다.Однако второго предложения в источнике нет. Оно подразумевает более широкие полномочия и содержит интерпретацию модели. Если принять его в качестве доказательства, возникает замкнутая ситуация: модель использует созданное ею утверждение как доказательство собственного результата.
Поэтому мы нормализовали только пробельные символы и требовали, чтобы sourceExcerpt действительно присутствовало во входном документе, прежде чем разрешить его прохождение проверки. Это не позволяло одобрять в качестве Evidence предложения, обобщённые или перефразированные моделью.
Однако Exact Match гарантирует лишь наличие предложения в источнике. Отдельным вопросом является то, действительно ли это предложение подтверждает поле, с которым оно связано, поэтому проверку Evidence мы разделили следующим образом.
1단계: 원문성 검증
  sourceExcerpt가 입력 문서에 실제로 존재하는가?

2단계: 연결 검증
  Evidence가 가리키는 fieldPath가 실제 결과 항목과 일치하는가?

3단계: 의미 정합성 검증
  이 문장이 해당 결과를 충분히 뒷받침하는가?
Принадлежность текста источнику можно было проверить правилами, но семантическое соответствие требовало проверки человеком. Мы чётко ограничили область, гарантируемую Validator, проверкой того, существует ли текст в источнике.
Не заполняйте неизвестные значения; заставьте модель задавать вопросы
Когда LLM сталкиваются с пустым местом, они склонны естественным образом заполнять его. В обычном письме это преимущество, но при структурировании бизнес-документов такой подход рискован. Если в источнике не указаны бизнес-цель или границы ответственности, модель может записать распространённые отраслевые практики; результат будет звучать естественно, но всё равно окажется недостоверным.
Чтобы предотвратить это, мы изменили контракт: если обязательное значение невозможно подтвердить в источнике, модель должна вернуть вопрос вместо того, чтобы генерировать это значение.
{
  "missingFields": [
    {
      "fieldPath": "documentPurpose",
      "question": "이 업무가 최종적으로 달성해야 하는 결과는 무엇입니까?"
    }
  ]
}
В этой схеме вопрос не является сообщением об ошибке. Это обычный результат процесса преобразования. Он отличает ситуации, когда информации в источнике недостаточно, от ситуаций, когда модель пропустила содержание, и позволяет пользователю дополнить его на следующем шаге.
При реальных оценках уточняющие вопросы пользователю иногда генерировались чаще, чем ожидалось. Сначала мы считали, что следует уменьшить их количество, но при анализе содержания обнаружили, что многие из них отражали неопределённость, которую раньше модель молча устраняла своими предположениями. Вместо простого сокращения числа вопросов было правильнее объединять дублирующиеся вопросы и отдавать приоритет тем, которые необходимы для принятия реальных решений.
Repair Loop был исправлением на основе результатов проверки, а не повторной попыткой
Если после неудачной проверки повторно отправить тот же неизменённый запрос, результат может оказаться другим, но модель не будет знать, что именно нужно исправить. Поэтому мы разрешили не более одного запроса Repair и включали в повторный запрос следующую информацию.
- 최초 사용자 요청
- 최초 모델 응답
- Schema 및 결정적 Validator 오류
- 누락되거나 원문과 일치하지 않은 항목
Процесс обработки выглядит следующим образом.
Result first = generate(request);
Validation check = validate(first);
if (check.isValid()) return first;

Result repaired = repair(request, first, check.errors());
return validateOrSendToManualReview(repaired);
Мы не разрешали неограниченное число повторных попыток. Результат, который случайно прошёл проверку после многократных вызовов, может скрывать проблемы с качеством. Если второй результат также не проходил проверку, мы останавливались автоматическую обработку и записывали исходный ответ и ошибку.
В ходе одной оценки большинство входных предложений было обработано корректно, но некоторые элементы Evidence слегка перефразировали источник. Несмотря на то что общий результат выглядел достаточно хорошо, система не считала его результатом, допускаемым к одобрению, и направляла его по пути Repair. Этот опыт заставил нас пересмотреть критерий того, следует ли считать «в основном корректный» результат успехом системы.
Что изменилось после внедрения
Изменения после применения структуры проверки можно обобщить следующим образом.
|
До |
После внедрения |
|---|---|
|
Мы вручную сравнивали источник и результат, чтобы определить, не было ли чего-либо пропущено. |
Мы сразу выявляли необработанные входные предложения. |
|
Мы использовали доказательства, возвращённые моделью, без изменений. |
Заблокировано: доказательство, которого нет в исходном тексте. |
|
Значения, которых не было в документе, также были дополнены естественным образом. |
Вместо того чтобы утверждать значение окончательно, я перешёл к формулировке уточняющего вопроса. |
|
Когда проверка завершалась неудачей, я повторял тот же запрос. |
Я указал конкретную ошибку и внёс ограниченное исправление. |
|
Неудачный ответ был отброшен. |
Он был сохранён как данные для регрессионной оценки вместе с ошибкой проверки. |
Записи выполнения были отделены от проверенных данных
Когда я применил один и тот же документ и инструкции к нескольким моделям, все они вернули JSON, но точки отказа у них различались. Некоторые модели пропускали правила, другие добавляли объяснения, которых не было в исходном тексте, а третьи допускали ошибки в ссылочных связях. Поэтому было трудно отследить причины проблем, сохраняя только окончательные результаты.
В записях выполнения сохранялись использованная модель, версия Prompt, входной документ, необработанный ответ, результаты разбора, статус проверки и причины сбоя. Эти записи не являлись окончательными бизнес-данными, а служили материалами для отладки и регрессионной оценки. Только результаты, прошедшие проверку и рассмотренные человеком, преобразовывались в пригодные для использования данные.
Краткое изложение основных положений
-
LLM следует ограничивать ролью генерации структурированных кандидатов, а не использовать как источник окончательных данных.
-
Structured Output уменьшает количество ошибок разбора, но не предотвращает пропуски или неправильные интерпретации.
-
Чтобы выявлять пропуски, необходимо отслеживать статус обработки каждого входного предложения, а не количество результатов.
-
Наличие Evidence в исходном тексте и то, подтверждает ли оно соответствующее поле, необходимо оценивать отдельно.
-
Неудачные ответы и ошибки проверки необходимо сохранять вместе, чтобы обеспечить регрессионную оценку после изменения Prompt, Schema или Validator.
Заключение
Когда я начинал эту работу, я думал, что она заключается в преобразовании документов на естественном языке в JSON. По мере реализации я понял, что настоящая проблема заключалась не в генерации JSON, а в том,насколько далеко следует допускать неопределённые интерпретации, что нужно проверять механически и когда следует снова обратиться к человеку.
Итоговая структура была разработана так, чтобы ограничивать формат с помощью JSON Schema, проверять полноту охвата входных данных и наличие Evidence, а неизвестную информацию оставлять в виде вопросов. При применении генеративного ИИ в бизнес-процессах важно не получить наиболее естественный ответ, а не допустить перехода неверных результатов на следующий этап.
Мой вывод из этой работы заключается в том, что доверие к LLM обеспечивается не более сильным промптом, а системой, которая задаёт вопросы и проверяет их вывод.
Brown