
はじめに
プロジェクトを遂行する中で、人が作成した業務文書を、後続プロセスで利用できる構造化データとして整理する必要がありました。文書には、業務の目的、担当者、処理手順、ルールと例外が自然言語で記述されていました。人は文脈を読み取って理解できますが、プログラムが検索・分類・レビューなどの後続作業に利用するには、一定のフィールドと形式に変換する必要があります。
最初は、文書と変換指示を LLM に渡し、JSON に整理するよう依頼すれば十分だと考えていました。実際、LLM は短時間で見栄えのよい結果を作成しました。しかし、原文にはない手順が自然に追加されたり、重要な一文が結果からひっそり抜け落ちたりすることがありました。担当者が行う行動と処理結果が互いに混在することもありました。
たとえば、原文には「レビュー担当者は依頼を承認するか、補完を依頼できます」とだけ記載されているのに、LLM が一般的な業務慣行を根拠として「チームリーダーが最終承認します」というルールを追加することがあります。文章としては自然ですが、原文にはない内容です。JSON 形式が正しいという理由だけでこの結果を利用すると、モデルの推測が業務上の事実に変わってしまいます。
そこで、目標を「LLM に完成したデータを作成させること」から LLM は構造化候補を作成し、システムは構造と原文の根拠を検査し、人が最終的に利用するかどうかを決定することへと改めて定義しました。
この記事では、定められた JSON 形式で応答を受け取る Structured Output、出力契約を定義する JSON Schema、原文の根拠である Evidence、そして検証エラーを利用した限定的な Repair プロセスについて紹介します。核心は、確率的に生成された結果をどのように検証可能なデータとして扱ったかにあります。
まず確認する最終構成
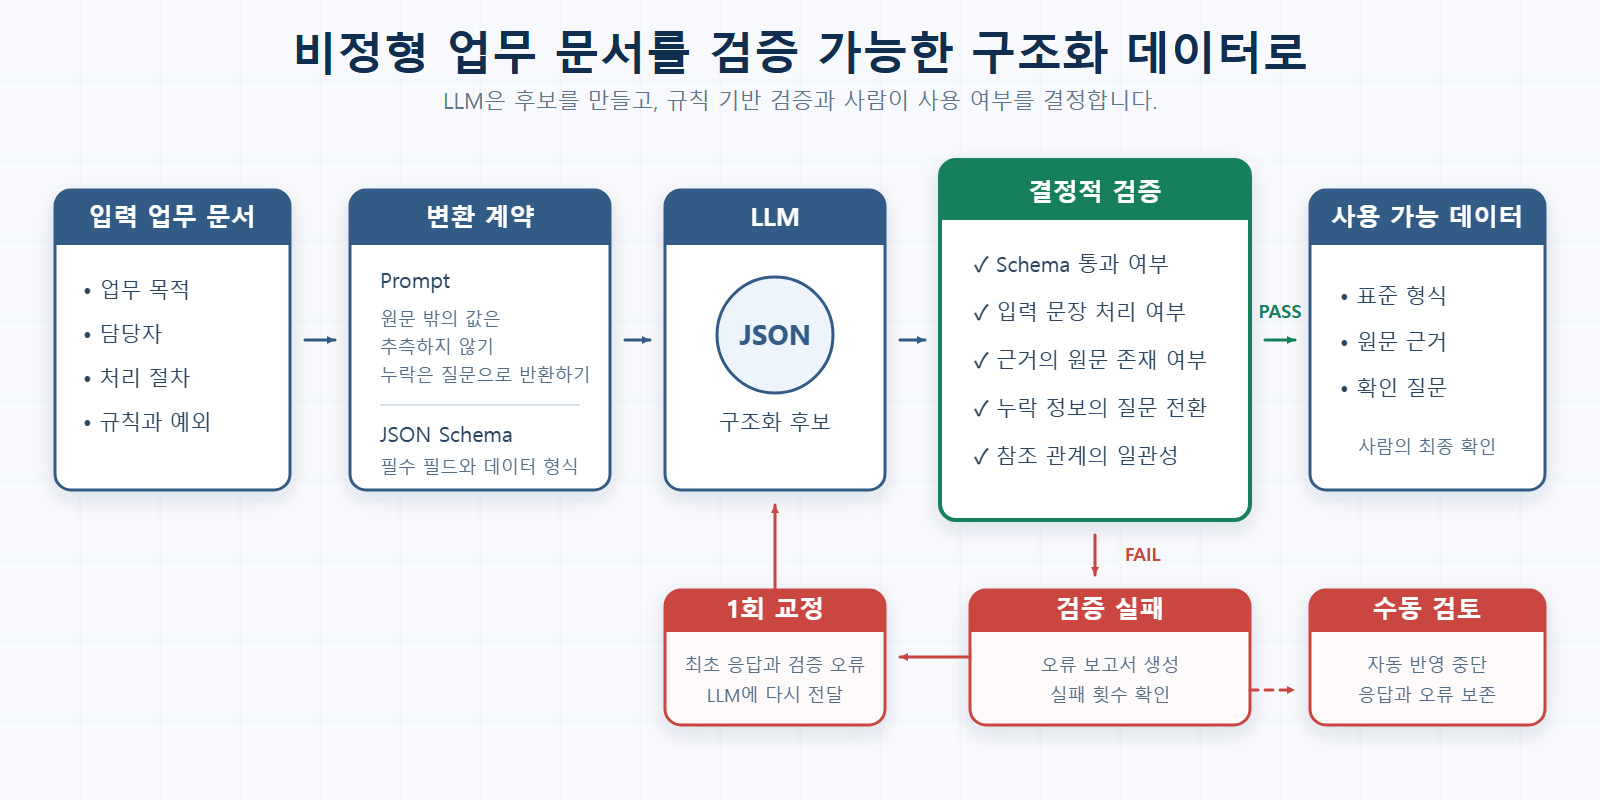
図 1. 非構造化業務文書に Prompt と JSON Schema を同時に提供し、決定的に検証するフロー
まず、最終的に整理した構成を見てみましょう。原文と Prompt、JSON Schema を LLM に同時に渡して構造化候補を作成し、システムが構造・入力カバレッジ・原文の根拠・欠落情報を検査します。ここでいう決定的検証とは、同じ入力にルールを適用すれば常に同じ結果になる検査を意味します。検証に失敗した場合は、エラーを含めて限定的に修正し、再び失敗した場合は自動反映せず、手動レビューの対象へ切り替えます。
以下では、最初に試した方法でどのような問題が発生し、それを解決するために各検証段階をどのように追加したのかを、順を追って説明します。
最初に考えた構成:プロンプトと JSON Schema だけで十分ではないか
初期入力は、人が作成した業務文書でした。変換プロセスをわかりやすく説明するため、この記事では「作業依頼レビュー手順」という簡単な例を使用します。以下のデータフィールドも、文書と構造化結果の関係を示すために構成したものです。
変換対象となるサンプル業務文書
작업 요청 검토 절차

배경
현재 작업 요청을 메일과 메신저로 전달하고 있어 요청 상태와 처리 이력을
일관되게 확인하기 어렵습니다.

목표
요청자는 작업 내용을 등록하고 검토 결과를 확인할 수 있어야 합니다.
검토자는 검토가 요청된 작업을 승인하거나 보완을 요청할 수 있어야 합니다.

담당자
- 요청자는 작업 내용을 작성하고 검토를 요청합니다.
- 검토자는 검토가 요청된 작업 내용을 확인합니다.

처리 절차
1. 요청자가 작업 내용을 작성합니다.
2. 요청자가 검토를 요청합니다.
3. 검토자는 요청을 승인하거나 보완을 요청합니다.
4. 검토자는 처리 결과와 검토 의견을 기록합니다.

업무 규칙
- 검토를 요청한 작업만 검토할 수 있습니다.
- 검토 결과에는 처리자와 처리 시각이 포함되어야 합니다.
この文書から得たい結果
私が求めていたのは、文書を短く要約した文章ではありませんでした。文書に記載された担当者と処理手順を相互に関連付け、プログラムが検索・レビューできる構造化候補を作成することでした。
|
サンプル文書の内容 |
求める構造化結果 |
|---|---|
|
背景と目的 |
文書が解決しようとする目的 (documentPurpose) |
|
依頼者とレビュー担当者 |
識別子を持つ参加者の一覧 (participants) |
|
作成・レビュー依頼・承認・補完依頼・結果記録 |
担当者と順序を持つ処理ステップ (processSteps) |
|
レビュー条件と記録項目 |
個別に管理する業務ルール (rules) |
|
文書にない担当者の割り当て基準 |
任意に補完していない nullと確認質問 (missingFields) |
|
結果の出典 |
該当する値に関連付けられた原文の引用 (evidence) |
つまり、求める出力は 文書の内容を構造化した値, 文書だけでは確定できない質問, 各値の原文根拠も併せて含める必要がありました。目標出力が定まっていれば、原文から何を取得し、何が不足しているのかを一貫して判断できます。この基準をJSON Schemaで表現しました。
出力契約として使用する簡単なJSON Schema
全体の流れを理解するために必要な項目だけを残して簡略化したSchemaの例です。
{
  "type": "object",
  "additionalProperties": false,
  "required": [
    "documentPurpose",
    "participants",
    "processSteps",
    "rules",
    "assignmentRule",
    "missingFields",
    "evidence"
  ],
  "properties": {
    "documentPurpose": { "type": "string" },
    "participants": {
      "type": "array",
      "items": { "type": "object", "required": ["id", "name"] }
    },
    "processSteps": {
      "type": "array",
      "items": { "type": "object", "required": ["order", "actorId", "action"] }
    },
    "rules": { "type": "array" },
    "assignmentRule": {
      "type": ["string", "null"],
      "description": "원문에 배정 기준이 없으면 null"
    },
    "missingFields": {
      "type": "array",
      "items": {
        "type": "object",
        "required": ["fieldPath", "question"]
      }
    },
    "evidence": { "type": "array" }
  }
}
この過程では、Schema、Prompt、Validatorの責任を次のように分けました。
Schema    : 필수 필드와 데이터 형식을 제한합니다.
Prompt    : 원문에 없는 값은 추측하지 않고 null과 확인 질문으로 반환하게 합니다.
Validator : 참조 관계, 원문 근거, null과 확인 질문의 대응 여부를 검사합니다.
例えばSchemaはassignmentRuleを必須フィールドとして要求しますが、nullも許容します。サンプル文書は、レビュアーが承認するか補完を依頼できるとだけ説明しており、複数のレビュアーのうち担当者を決める基準は提供していません。そのためPromptはこの値を推測せず、nullと確認質問を返すようにし、Validatorは実際に両方の値が存在するかを検査します。
文書から作成する構造化候補
上記の文書をプログラムが読み取れる構造化候補に変換すると、次のような形になります。このデータ構造は記事の説明のために作成した例であり、最終的な正解ではなく、検証と人による確認を経る必要がある中間結果です。
{
  "documentPurpose": "작업 요청의 진행 상황과 처리 이력을 일관되게 확인한다.",
  "participants": [
    { "id": "requester", "name": "요청자" },
    { "id": "reviewer", "name": "검토자" }
  ],
  "processSteps": [
    {
      "order": 1,
      "actorId": "requester",
      "action": "작업 내용을 작성한다."
    },
    {
      "order": 2,
      "actorId": "requester",
      "action": "검토를 요청한다."
    },
    {
      "order": 3,
      "actorId": "reviewer",
      "action": "승인하거나 보완을 요청한다."
    },
    {
      "order": 4,
      "actorId": "reviewer",
      "action": "처리 결과와 검토 의견을 기록한다."
    }
  ],
  "rules": [
    "검토를 요청한 작업만 검토할 수 있다.",
    "검토 결과에는 처리자와 처리 시각을 포함한다."
  ],
  "assignmentRule": null,
  "missingFields": [
    {
      "fieldPath": "assignmentRule",
      "question": "여러 검토자 중 담당자는 어떤 기준으로 정합니까?"
    }
  ],
  "evidence": [
    {
      "fieldPath": "processSteps[1]",
      "sourceExcerpt": "요청자가 검토를 요청합니다."
    }
  ]
}
この結果を検索やレビューなどの後続処理で使用するには、JSONの文法が正しいだけでは不十分です。原文の担当者や手順を漏らしていないか、Evidenceが実際の原文に存在するか、未確定のポリシーをモデルが勝手に作っていないかを追加で検証する必要があります。
当初は、十分に詳細なPromptとJSON Schemaを提供すれば、安定した結果を得られると予想していました。必須フィールド、データ型、オブジェクト構造をSchemaで制限し、応答はStructured Output機能を使用してJSONで受け取りました。
このアプローチによって、基本的な問題の多くは解決しました。JSONの前後に説明が付く問題、Markdownコードブロックが混在する問題、フィールド名が実行ごとに変わる問題は大幅に減少しました。Schemaの受け渡し、応答のパース、エラー処理の経路も、自動テストで繰り返し検証できました。
しかし、構造が安定すると、むしろより重要な問題がはっきり見え始めました。JSONが有効であることと、業務内容が正確であることは、まったく別の問題でした。
最初の問題:形式が正しくても内容は間違っている可能性がある
評価の過程で頻繁に確認された問題は、担当者、行動、処理結果の混同でした。原文が「レビュアーは依頼を承認するか、補完を依頼します」と説明していても、一部の応答では承認者という新たな参加者を作ったり、「レビュー完了」という原文にない手順を追加したりしていました。
この結果もJSON Schemaを通過できます。participantsとprocessStepsが配列であり、それぞれの値の型も正しいためです。しかし、原文にない担当者や手順が追加されているため、業務内容は変わっています。
もう一つの問題は、参照関係の不整合でした。処理ステップのactorIdがparticipantsに存在しなかったり、同じ参加者が異なるIDで表現されたりすることもありました。それぞれのオブジェクトだけを見れば正しくても、オブジェクト間の関係は壊れています。単に識別子の形式を正規化しても、誤って理解した意味まで正しく変わるわけではありません。
この時点から、検証を2つの層に分けました。
구조 검증
  - JSON 문법
  - 필수 필드
  - 타입
  - enum
  - key 형식

의미 보존 검증
  - 원문 항목 누락 여부
  - 참여자와 처리 단계의 참조 일관성
  - 처리 순서의 중복과 역전 여부
  - 원문 근거 존재 여부
  - 원문에 없는 값의 임의 생성 여부
Schemaは依然として重要ですが、必要条件としてのみ扱いました。その上に、同じ入力には常に同じ判定を下すルールベースのValidatorを追加し、原文と結果の差異を別の評価データとして記録しました。
2つ目の問題:モデルが読んでいない文をどう見つけるか
LLMの応答から一部の結果が欠落したとき、それが本当に原文にない情報なのか、モデルが見落としたのかを区別するのは困難でした。出力結果だけを検査しても、この違いは分かりません。
これを解決するため、入力文書を空でない文単位に分割し、識別子を付与しました。各文は1つ以上の結果フィールドに紐付くか、変換されなかった理由を持つ必要があります。
MAPPED    : 하나 이상의 결과 필드와 연결됨
UNMAPPED  : 현재 출력 구조에 대응하는 필드가 없음
EXCLUDED  : 변환 대상이 아닌 문장으로 명시적으로 제외됨
必須フィールドの充足度は、入力文の状態とは別に管理しました。
PRESENT      : 원문 근거를 가진 값이 존재함
NEEDS_INPUT  : 원문만으로 확정할 수 없어 사용자 확인이 필요함
このように分けた理由は、原文にまったく存在しない情報を、特定の入力文の状態として表現することはできないためです。入力カバレッジは「どの文を処理したか」を追跡し、フィールドの充足度は「必要な値が十分か」を判断します。
評価文書に適用した後は、未処理の文をすぐに見つけ、モデルの欠落と出力構造の限界を区別できるようになりました。すべての内容を無理にフィールドへ入れなくても、文が気付かないうちに消える問題を防げました。
3つ目の問題:根拠に見える文もモデルが作った文である可能性がある
変換結果の信頼性を高めるため、各結果項目に原文の根拠であるEvidenceを付けました。当初は、モデルが返したsourceExcerptをそのまま保存していました。しかし評価してみると、Evidenceの中に原文の文ではなく、モデルが要約または書き換えた文が混在していました。
例えば、原文が次のようなものだと仮定します。
검토자는 요청을 승인하거나 보완을 요청할 수 있습니다.モデルが以下の文をEvidenceとして返すと、意味は似ているように見えます。
검토자는 모든 요청의 최종 처리 결과를 결정합니다.しかし、2つ目の文は原文にはありません。より強い権限を暗示しており、モデルの解釈が入り込んでいます。これを根拠として認めると、モデルが作った主張を再び自分の結果の証拠として使う循環が生じます。
そこで、空白だけを正規化したうえで、sourceExcerptが入力文書に実際に存在する場合にのみ通過するようにしました。これにより、モデルが要約または書き換えた文がEvidenceとして承認されるケースを防止しました。
ただし、Exact Matchは文が原文に存在するという事実だけを保証します。その文が紐付けられたフィールドを実際に裏付けているかどうかは別の問題であるため、Evidenceの検証を次のように分けました。
1단계: 원문성 검증
  sourceExcerpt가 입력 문서에 실제로 존재하는가?

2단계: 연결 검증
  Evidence가 가리키는 fieldPath가 실제 결과 항목과 일치하는가?

3단계: 의미 정합성 검증
  이 문장이 해당 결과를 충분히 뒷받침하는가?
原文性はルールで検査できましたが、意味の整合性には人によるレビューが必要でした。検証機が保証する範囲を、原文に存在するかどうかまでに明確に限定しました。
分からない値は埋めずに質問させる
LLMには空欄を見ると自然に埋めようとする傾向があります。一般的な文章作成では利点ですが、業務文書の構造化では危険です。原文に業務目的や責任範囲がない場合、モデルが業界の一般的な内容を書き加えると、結果は自然でも事実ではない可能性があります。
これを防ぐため、必須値が原文で確認できない場合は、値を生成する代わりに質問を返すよう契約を変更しました。
{
  "missingFields": [
    {
      "fieldPath": "documentPurpose",
      "question": "이 업무가 최종적으로 달성해야 하는 결과는 무엇입니까?"
    }
  ]
}
この設計では、質問は失敗メッセージではありません。変換プロセスにおける正常な結果です。原文情報が不足している状況と、モデルが内容を見落とした状況を区別し、ユーザーが次の段階で補完できるようにします。
実際の評価では、ユーザーへの確認質問が予想以上に多く生成される場合がありました。当初は質問数を減らすべきだと考えていましたが、内容を確認すると、それまでモデルが黙って推論していた不確実性が可視化されたケースが多くありました。質問の数だけを減らすよりも、重複する質問を統合し、実際の意思決定に必要な質問を優先する方が適切でした。
Repair Loopは再試行ではなく、検証結果を利用した修正でした
検証に失敗したとき、同じリクエストをそのまま再送すれば別の結果が得られる可能性はありますが、モデルは何を修正すべきか分かりません。そこで、Repairリクエストは最大1回まで許可し、2回目のリクエストには次の情報を併せて提供しました。
- 최초 사용자 요청
- 최초 모델 응답
- Schema 및 결정적 Validator 오류
- 누락되거나 원문과 일치하지 않은 항목
処理の流れは次のとおりです。
Result first = generate(request);
Validation check = validate(first);
if (check.isValid()) return first;

Result repaired = repair(request, first, check.errors());
return validateOrSendToManualReview(repaired);
無限の再試行は許可しませんでした。繰り返し呼び出すことで偶然通過した結果は、品質上の問題を隠す可能性があるためです。2回目の結果も失敗した場合は自動処理を中止し、元の応答とエラーを記録しました。
ある評価では、入力文の大部分は正しく処理されていましたが、Evidenceの一部が原文をわずかに書き換えていました。結果全体がかなり良好に見えても、システムはこれを承認可能な結果として扱わず、Repair経路へ送りました。この経験から、「大部分が正しい」ことをシステムの成功とみなすかどうかの基準を改めて考えることになりました。
適用後の変化
検証構造を適用した後の変化は、次のように整理できます。
|
適用前 |
適用後 |
|---|---|
|
欠落の有無を原文と手作業で比較しました。 |
未処理の入力文をすぐに特定できるようになりました。 |
|
モデルが返した根拠をそのまま使用しました。 |
原文に存在しないEvidenceを遮断しました。 |
|
文書にない値も自然に補完されました。 |
値を確定せず、確認の質問に切り替えました。 |
|
検証に失敗した場合、同じリクエストを繰り返しました。 |
具体的なエラーを伝え、限定的に修正しました。 |
|
失敗した応答を破棄しました。 |
検証エラーとともに、回帰評価用の資料として保存しました。 |
実行記録と確認済みのデータを分離しました
同じ文書と指示を複数のモデルに適用してみると、すべてJSONは返しましたが、失敗した箇所は異なりました。あるモデルはルールを省略し、別のモデルは原文にない説明を追加し、また別のモデルは参照関係で誤りを示しました。そのため、最終結果だけを保存していては、問題の原因を追跡するのが困難でした。
実行記録には、使用したモデルとPromptのバージョン、入力文書、未加工の応答、解析結果、検証状態、失敗理由を残しました。この記録は確定した業務データではなく、デバッグと回帰評価のための資料です。検証を通過し、人が確認した結果だけを利用可能なデータへと変換しました。
核心内容の要約
-
LLMは確定データを作成する主体ではなく、構造化された候補を作成する役割に限定すべきです。
-
Structured Outputは解析エラーを減らしますが、欠落や誤った解釈まで防ぐことはできません。
-
欠落を見つけるには、結果の件数ではなく、入力文の処理状態を追跡する必要があります。
-
Evidenceが原文に存在するかどうかと、そのフィールドを裏付けているかどうかは、別々に判断する必要があります。
-
失敗した応答と検証エラーを併せて保存しておくことで、Prompt、Schema、Validatorを変更した後の回帰評価が可能になります。
おわりに
この作業を始めたときは、自然言語の文書をJSONに変換する機能だと思っていました。実装を進める中で、実際の問題はJSONの生成ではなく、不確かな解釈をどこまで許容し、何を機械的に検証し、いつ人に再度質問するのかということだと分かりました。
最終的な構成は、JSON Schemaで形式を制限し、入力のカバレッジとEvidenceを検査し、分からない情報は質問として残すという方向でした。生成AIを業務に適用する際に重要なのは、最も自然な答えを得ることよりも、誤った結果が次の段階へ進まないようにすることでした。
この作業を通じて得た結論は、LLMを信頼できるものにするのは、より強力なプロンプトではなく、LLMの出力を疑い、検証するシステムだということです。
Brown