
1. Kirish
Amaldagi xizmatda har daqiqada bitta ma’lumot yaratiladi va ma’lumotlar bazasida saqlanadi. Ma’lumotlar vaqt davomida ketma-ket kelib tushadi, shuning uchun bir soat ichida 60 ta ma’lumot o‘ziga mos vaqt nuqtalarida saqlanadi.
Yangi funksiyani ishlab chiqish jarayonida mavjud ma’lumotlardan boshqacha usulda yaratiladigan, biroq ayni jadvalda saqlanadigan ma’lumotlarni qayta ishlash talabi paydo bo‘ldi.
Yangi qo‘shilgan ma’lumot tashqi xizmat tomonidan oldingi soat ma’lumotlari alohida tahlil qilingandan so‘ng hosil bo‘ladi. Avval har daqiqada bitta ma’lumot kelib tushgan bo‘lsa, yangi funksiya bilan tahlil tugagach, oldingi soatga tegishli taxminan 60 ta ma’lumot bitta API so‘rovida yetkaziladi.
Xizmat ichida boshlangan va qayta ishlash vaqtini boshqarish mumkin bo‘lgan vazifalarni tashqi manbadan kelgan so‘rovlar kabi qayta ishlash to‘g‘rimi?
Ushbu ish aynan shu savoldan boshlandi.
2. Muammoni aniqlash
Dastlab mavjud ma’lumotlarni qayta ishlash usulidan o‘zgarishsiz foydalanishimiz mumkin deb o‘yladim. Biz allaqachon bitta operatsiyada 10 000 dan ortiq yozuv yaratib, ularni Batch Insert uchun 500 tadan iborat paketlarga bo‘lish funksiyasini amalga oshirgan edik.
Biz bir vaqtning o‘zida 10 000 dan ortiq yozuvni qayta ishlayotganimiz sababli, har bir so‘rovda taxminan 60 ta yozuvni saqlashni ham shu yondashuv yordamida yetarlicha bajarish mumkin deb hisobladik. Aslida, 60 ta yozuvning o‘zi muammo emas edi.
Biroq mavjud operatsiyani ushbu funksiya bilan taqqoslash jarayonida muhim farqni aniqladim. Mavjud ommaviy ma’lumotlarni qayta ishlash xizmati ichida boshlanadi. Operatsiya qachon boshlanishi va bir vaqtning o‘zida qancha ma’lumot yaratilishini ma’lum darajada oldindan bilishimiz mumkin, ma’lumotlarni qayta ishlash oqimini ham xizmat ichida boshqarish mumkin.
Yangi funksiyada esa tashqi xizmat tahlilni tugatgach, API chaqiriladi. Xizmatimiz so‘rov qachon kelishini aniqlay olmaydi, shuningdek, bir nechta tahlil vazifasi deyarli bir vaqtda tugasa, bir nechta so‘rov bir vaqtning o‘zida kelib tushishi mumkin. Agar bu avvalgidek sinxron yondashuv yordamida amalga oshirilsa, har bir so‘rov quyidagi jarayondan o‘tadi.
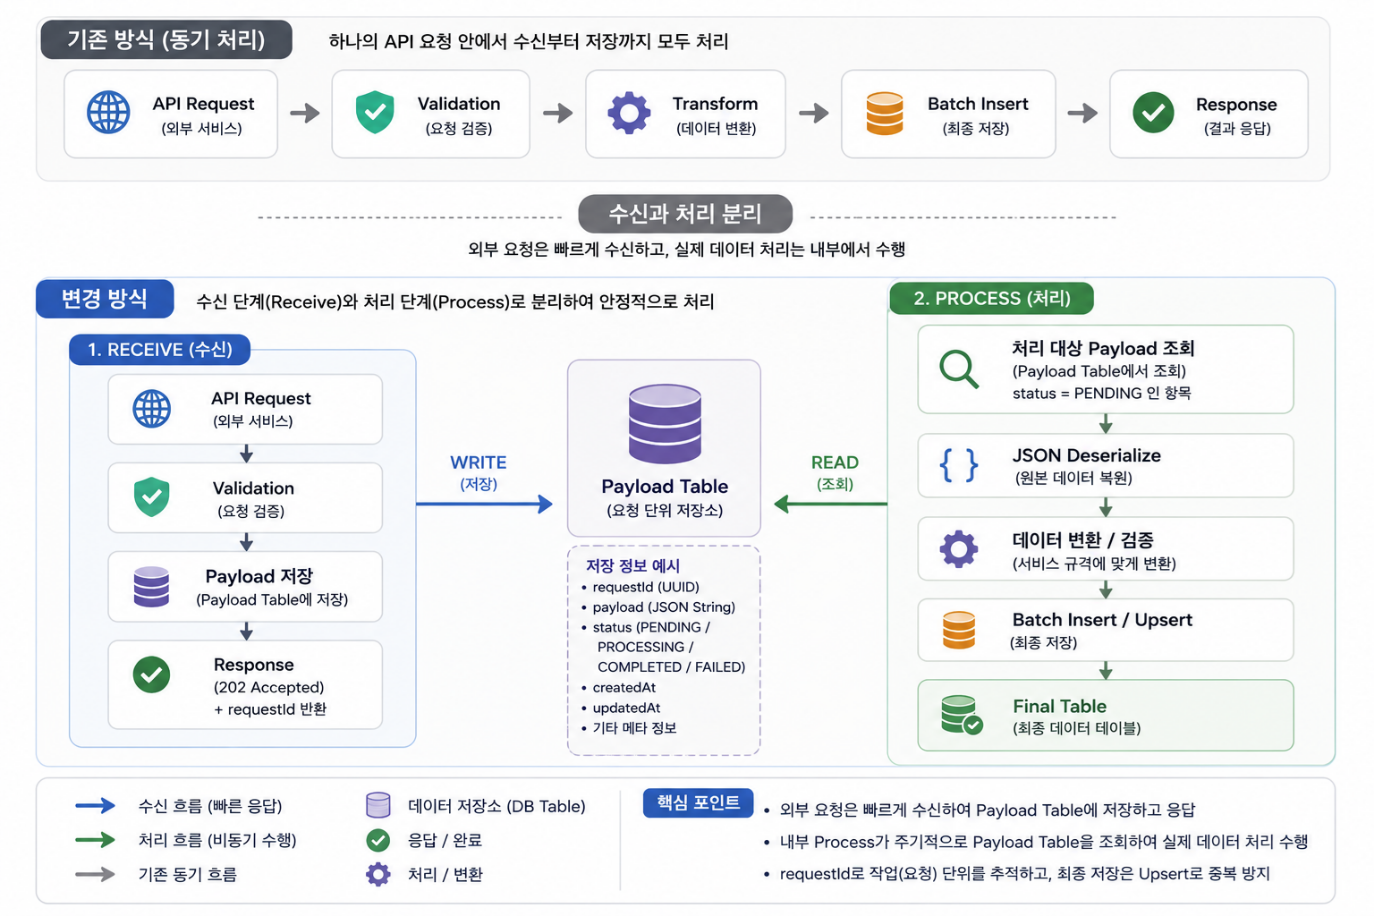
Request → Validation → Transform → Batch Insert → ResponseFaqat bitta so‘rovni ko‘rib chiqishda muammo bo‘lmaydi, biroq so‘rovlar to‘lqin tarzida kelganda, har bir so‘rov uchun ma’lumotlarni o‘zgartirish va ma’lumotlar bazasi operatsiyalari bir vaqtning o‘zida bajariladi. Oxir-oqibat, ikki operatsiya o‘rtasidagi farq bir vaqtning o‘zida qayta ishlanadigan ma’lumot hajmida emas edi. Mavjud operatsiyada xizmatimiz qayta ishlash vaqti hamda oqimini boshqara olardi, yangi funksiya esa tashqi so‘rovlar orqali boshlanadi.
Shu sababli tashqi so‘rov kelgan har safar haqiqiy ma’lumotlarni qayta ishlashgacha bo‘lgan barcha jarayonni bajarish o‘rniga, so‘rovlarni qabul qilish jarayonini haqiqiy ma’lumotlarni qayta ishlash jarayonidan ajratishni ko‘rib chiqdik.
3. Yechim
Oxir-oqibat, tashqi so‘rovlarni qabul qiladigan Receive bosqichini haqiqiy ma’lumotlarni saqlaydigan Process bosqichidan ajratishga qaror qildik. Tashqi so‘rovlar uchun qabul qilingan ma’lumotlar avval Payload ko‘rinishida saqlanadi, haqiqiy ma’lumotlarni qayta ishlash esa alohida Process jarayonida amalga oshiriladi.
Payload yordamida har bir so‘rov bo‘yicha ma’lumotlarni saqlash
Receive va Process bosqichlarini ajratish uchun tashqaridan qabul qilingan ma’lumotlarni haqiqiy qayta ishlash vaqtigacha saqlab turish usuli kerak edi. Bitta API so‘rovida yetkaziladigan taxminan 60 ta ma’lumot oldingi soatning bitta tahlil natijasini anglatadi.
Shu sababli har bir ma’lumotni alohida qayta ishlash obyekti sifatida saqlash o‘rniga, bitta so‘rovni bitta ish birligi sifatida boshqarish maqsadga muvofiq deb topdik. Buning uchun API orqali qabul qilingan barcha ma’lumotlarni JSON String ko‘rinishida serialize qilib, Payload jadvalidagi bitta Row ichida saqlaymiz.
60 ta ma’lumot → JSON Serialize → 1 ta Payload Row
Ushbu bosqichda yakuniy jadvalda 60 ta Row yaratmaymiz. Tashqaridan qabul qilingan so‘rovni faqat bitta Payload sifatida saqlaymiz, haqiqiy ma’lumotlarni qayta ishlash esa keyinroq, Process bosqichida amalga oshiriladi. Bu tashqi so‘rov kelganida faqat nisbatan sodda saqlash operatsiyasini bajarish, ma’lumotlarni o‘zgartirish va yakuniy saqlashni esa alohida qayta ishlash oqimiga ajratish imkonini beradi.
Timer Event orqali ma’lumotlarni qayta ishlash
Payload’da saqlangan ma’lumotlar har daqiqada ishga tushadigan Timer Event orqali qayta ishlanadi. Bu safar yetkazilayotgan ma’lumotlar tashqi xizmatning oldingi soat ma’lumotlarini tahlil qilishi natijasi bo‘lgani sababli, ular so‘rov qabul qilingan zahoti yakuniy jadvalda aks ettirilishi shart bo‘lgan real vaqt ma’lumotlari emas edi.
Shu sababli qayta ishlashni ma’lum darajada kechiktirishimiz mumkin edi. Timer Event ishga tushganda, u Payload jadvalidan qayta ishlanmagan ma’lumotlarni oladi. Keyin JSON String sifatida saqlangan ma’lumotlarni Deserializes qiladi, zarur ma’lumotlarni o‘zgartirishlarni amalga oshiradi va natijani yakuniy jadvalda saqlaydi.
Timer Event → 처리 대상 Payload 조회 → JSON Deserialize → 데이터 변환 → Batch Insert / UpsertYakuniy ma’lumotlarni saqlash usulining o‘zi mavjud Batch Insert yondashuvidan foydalanishda davom etdi. O‘zgargan narsa Batch Insert qachon bajarilishidir. Tashqi API so‘rovi kelishi bilan yakuniy ma’lumotlarni darhol saqlash o‘rniga, avval so‘rovni Payload sifatida qabul qildik, ichki ishga tushiriladigan Timer Event esa haqiqiy ma’lumotlar bazasi operatsiyasini bajardi. Bu tashqi so‘rov kelgan vaqtni haqiqiy ma’lumotlar qayta ishlangan vaqtdan ajratish imkonini berdi.
Request ID va ma’lumotlar yaxlitligi
Receive va Process bosqichlarini ajratgach, so‘rovlarni aniqlash va ularning qayta ishlanish holatini kuzatish usuliga ham ehtiyoj tug‘ildi. Sinxron yondashuvda muvaffaqiyatli API javobi ma’lumotlarni qayta ishlash ham yakunlanganini anglatadi deb hisoblash mumkin. Biroq o‘zgartirilgan tuzilmada muvaffaqiyatli API so‘rovi yakuniy ma’lumotlar saqlangani tugaganini anglatmaydi.
Shu sababli so‘rovni qabul qilganimizda UUID uslubidagi requestId yaratib, uni Payload bilan birga saqlaymiz, API esa 202 Accepted va requestId qiymatlarini qaytaradi. requestId alohida yozuvlarni aniqlash uchun ishlatiladigan qiymat emas; u bitta so‘rov, ya’ni bitta Payload birligi bilan bog‘liq ishni kuzatish uchun ishlatiladi.
Shuningdek, tarmoqdagi muammolar yoki tashqi API’ning boshqa xususiyatlari sababli ayni ma’lumot yana yetkazilishi mumkin bo‘lgan holatlarni ham hisobga olishimiz kerak edi. Ayni so‘rov yana yetkazilgan taqdirda ham yangi requestId yaratilishi mumkin, shuning uchun faqat requestId orqali haqiqiy ma’lumot takrorlangan yoki takrorlanmaganini aniqlab bo‘lmaydi. Shu sababli ishni kuzatuvchi requestId roli bilan haqiqiy ma’lumot takrorlanganini aniqlovchi Unique Key rolini ajratdik.
requestId → 요청 및 작업의 추적
Unique Key → 실제 데이터의 유일성 보장
Yakuniy ma’lumotlarni saqlashda alohida Unique Key asosida Upsert bajaramiz. Shu tariqa ayni ma’lumot yana yetkazilgan taqdirda ham takroriy Row’lar yaratilmaydi. Bu har bir so‘rovni asinxron jarayonga ajratilgan holda kuzatish va ayni paytda yakuniy ma’lumotlar yaxlitligini saqlash imkonini beradi.
4. Xulosa
Yuqoridagi fikrlarga asoslanib, dastlab ko‘rib chiqilgan sinxron qayta ishlash usuli va oxir-oqibat amalga oshirilgan qayta ishlash usulini quyidagicha umumlashtirish mumkin.
Biz allaqachon bitta operatsiyada 10 000 dan ortiq yozuv yaratib, ularni Batch Insert uchun 500 tadan iborat paketlarga bo‘ladigan usuldan foydalanayotgan edik. Shu sababli dastlab har bir so‘rovda taxminan 60 ta yozuvni qayta ishlaydigan ushbu funksiya ham mavjud yondashuvdan o‘zgarishsiz foydalanishi mumkin deb o‘yladik. Aslida, faqat ma’lumot hajmini hisobga olganda, bu yetarlicha maqbul usul edi.
Biroq mavjud operatsiya xizmat ichida boshlanib, uning bajarilish vaqti hamda qayta ishlash oqimini boshqarish imkonini bersa, ushbu funksiya tashqi xizmatdan kelgan so‘rov orqali ishga tushadi.
Shunga ko‘ra, Batch Insert’ning o‘zini o‘zgartirish o‘rniga, tashqi so‘rovlarni qabul qilishni haqiqiy ma’lumotlarni qayta ishlashdan ajratdik. Tashqi so‘rovlar avval Payload sifatida saqlanadi, haqiqiy ma’lumotlarni o‘zgartirish va saqlash esa ichki Process jarayonida amalga oshiriladi.
Ayni ma’lumotlarni saqlashda ham ma’lumotlarning qanday kelishiga, operatsiyaning boshlanish vaqtini boshqarish mumkin yoki mumkin emasligiga va qayta ishlash qaysi vaqtgacha kafolatlanishi kerakligiga qarab, mos qayta ishlash usuli farq qilishi mumkin. Ushbu ish tizimni loyihalashda bunday farqlarni hisobga olish muhimligini yana bir bor tasdiqladi.
yang