
1. Предыстория
Devlime работает в трёх средах — разработке, тестировании и продакшене, — которыми управляют два репозитория GitOps. Независимо от того, какая среда обновляется, до и после развёртывания выполняются одни и те же проверки. В их число входит проверка того, что именно развёртывается в этот раз, наличия изменений в базе данных и соответствия этих изменений рекомендациям, рассинхронизации версий библиотек, на которые ссылаются сервисы, а также наличия незакоммиченных или неотправленных изменений.
После завершения проверок мы систематизируем сведения о развёртывании. Сразу после развёртывания в среду тестирования мы делимся ими внутри команды вместе с пунктами, которые команда должна проверить. После тестирования и внесения исправлений мы развёртываем изменения в продакшен и сообщаем пользователям всю собранную информацию. Развёртывание в продакшен всё ещё находится в переходном состоянии, поэтому есть дополнительный шаг: перенос настроек из среды тестирования с одновременной проверкой их соответствия настройкам продакшена.
Эти проверки и организационные задачи несложны. Однако пунктов много, пропуск одного из них может сразу привести к инциденту, и они повторяются при каждом развёртывании. По мере того как развёртывания стали ежедневными для быстрого реагирования на VoC, это повторение превратилось в ежедневную задачу. Команда уже использует Claude Code и Cowork для разработки, а команда платформы также располагает командным инструментом для работы с агентами под названием Vizend agent hub. Однако этот hub предназначен для сохранения контекста разработки, поэтому для операционных процедур, таких как проверки перед развёртыванием, которые должны выполняться без участия человека, требовалась другая конфигурация. Поскольку сама эта процедура является переходной, мы решили не создавать что-то масштабное и сделать только столько, сколько необходимоВ этой статье рассказывается о первоначальной настройке, о сигнале, показавшем, что её пора улучшить, и о последовавших улучшениях.
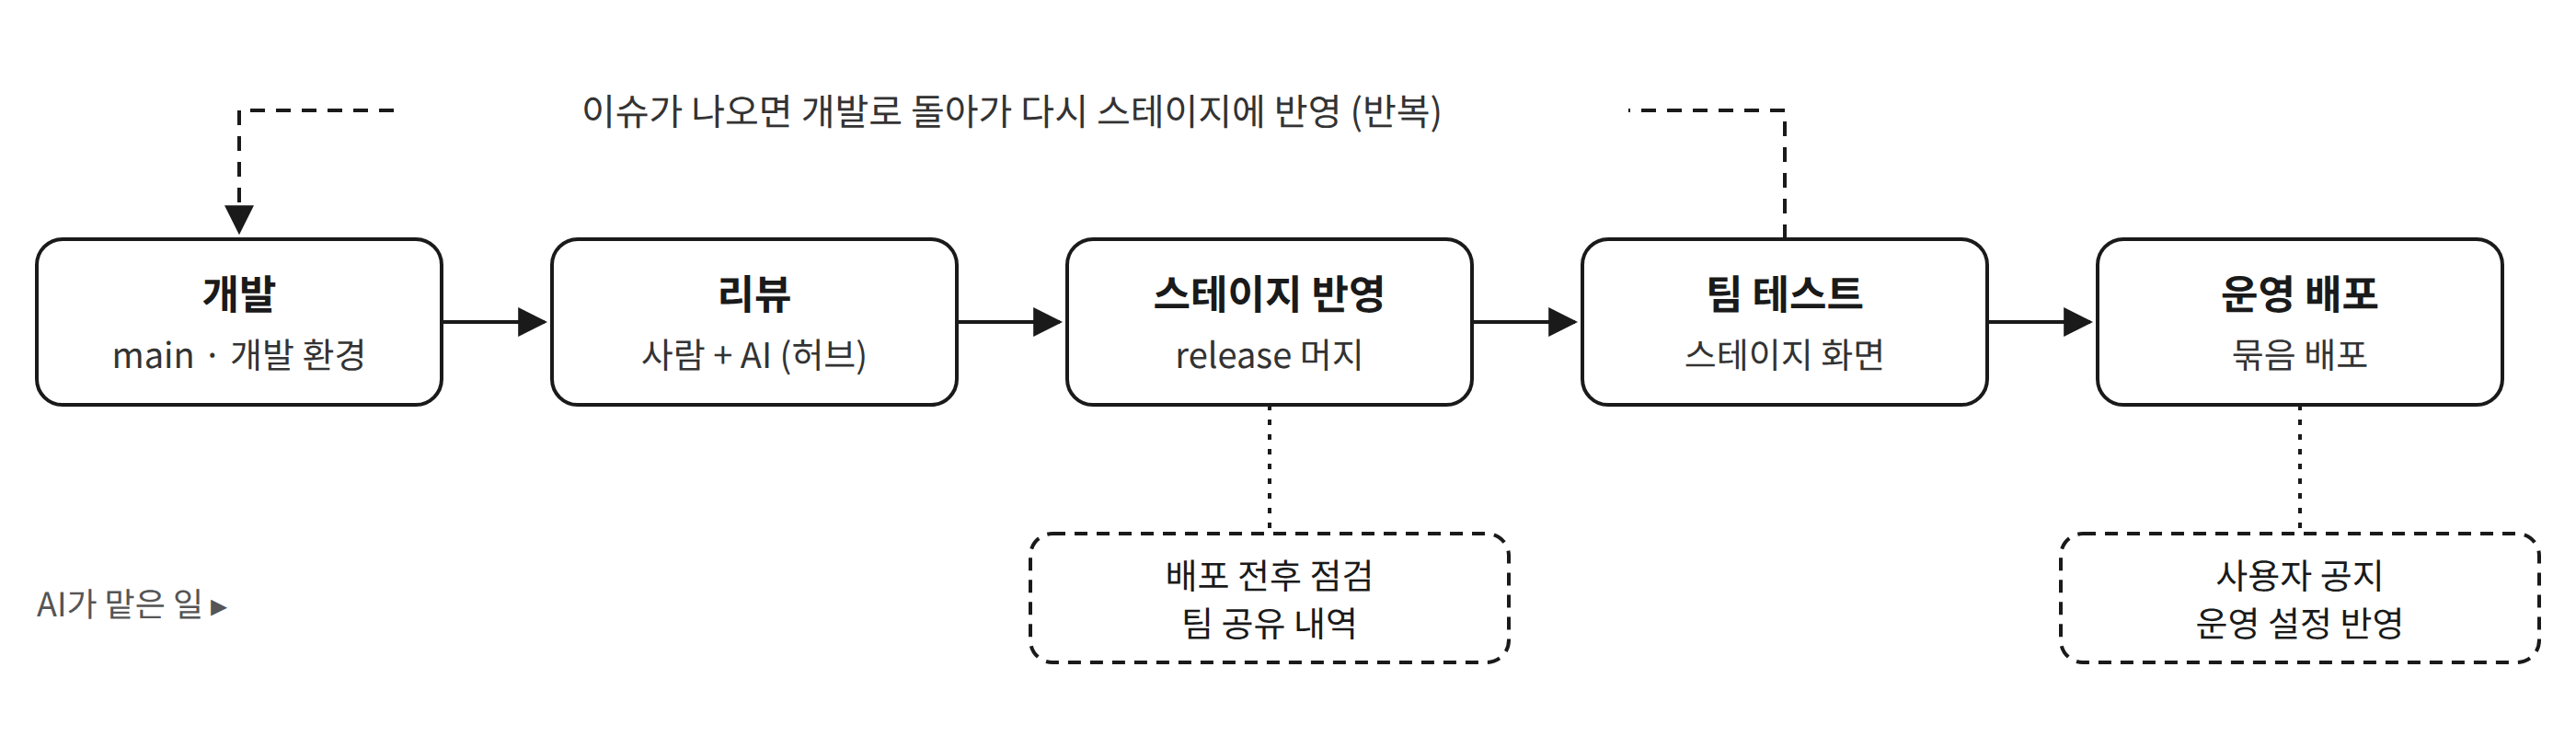
Рисунок 1. Цикл развёртывания Devlime. Пунктирная рамка ниже показывает задачи, назначенные ИИ.
2. Предпосылки выбора технологий
|
Уровень |
Функция |
Что он делает |
Когда официальная документация рекомендует его внедрять |
|---|---|---|---|
|
L1 |
CLAUDE.md · rules · memory |
Правила и контекст, которые автоматически считываются в начале сеанса |
Когда одно и то же правило было нарушено более двух раз |
|
L2 |
Skills · MCP · LSP |
Хранение процедур исправления в файлах и подключение внешних систем в качестве инструментов |
Когда вы в третий раз вводите один и тот же запрос |
|
L3 |
Subagents · workflows |
Перенос вспомогательных задач в отдельные контексты и их параллельное выполнение |
Когда вспомогательные задачи начинают заполнять диалог выводом |
|
L4 |
Hooks |
Принудительное выполнение и проверка действий с помощью команд оболочки до и после вызовов инструментов |
Когда что-то должно происходить каждый раз без дополнительных запросов |
|
L5 |
Schedules (/loop · Desktop tasks · Cloud Routines) |
Выполнение без присутствия человека |
Когда периодические проверки превращаются в запланированные задачи |
|
L6 |
Plugins · marketplaces · managed settings |
Объединение компонентов для развёртывания и управления версиями |
Когда второму репозиторию требуется такая же конфигурация |
|
L7 |
validate · eval |
Измерение того, запускается ли навык и улучшился ли результат |
Перед развёртыванием плагина |
В этой таблице пункты из официальной документации Claude Code — «Extend Claude Code» и «Run prompts on a schedule» — реорганизованы по уровням. Формулировки сроков внедрения соответствуют документации, а номера L1–L7 я добавил для удобства объяснения.
Из семи уровней изначально мы использовали навыки L2 и запланированные задачи L5. Это решение основывалось на трёх критериях.
Во-первых, мы следовали срокам внедрения, указанным в документации.Фактическими триггерами, с которыми мы столкнулись, были «объяснение одной и той же процедуры в третий раз» и «повторение проверок при каждом развёртывании». Триггер для hook — «правило, которое необходимо обеспечивать каждый раз» — удалось выявить только после многократного выполнения процедуры.
Во-вторых, действия, которые нельзя отменить, выполняют люди.Слияния, коммиты, отправка изменений, теги и изменения в среде продакшена выполняются людьми в соответствии с принципами команды, поэтому границы «того, что может выполняться самостоятельно» определились естественным образом. В них входят проверки, документирование и изменения файлов вплоть до шага непосредственно перед коммитом.
В-третьих, мы соотнесли решение с масштабом задачи.В настоящее время эти проверки выполняю только я, а процедура является переходной. Внедрять сначала управление версиями плагинов и оценивание в переходную процедуру, которой пользуется один человек, было бы неправильным порядком действий. Вместо этого мы полностью описали процедуру в файле навыка, чтобы позднее её можно было перенести, и настроили запланированный запрос на вызов этого навыка.
Способ планирования мы выбрали по тем же критериям. В документации Claude Code описаны три метода, и мы выбрали запланированные задачи Desktop (Cowork).
|
Метод |
Место выполнения и условия запуска |
Соответствие проверкам в этой статье |
|---|---|---|
|
Cloud Routines |
Заново клонирует репозиторий в облаке и запускает его. Запуск начинается по cron (не реже чем раз в час), вызову API или событию GitHub. Запрос разрешения не отображается |
Репозиторий находится в нашем внутреннем GitLab, поэтому облачной сессии потребовались бы учетные данные. На этом этапе мы решили этого не делать |
|
Запланированная задача на рабочем столе |
Монтирует папку, подключенную к моему ПК, в новой сессии и запускает задачу. Для каждой задачи задаются разрешения. Можно задать время или поручить запуск человеку |
Выбрано. Репозиторий уже находится на моем ПК, и перед выполнением его обновляет человек |
|
/loop |
Повторяет выполнение в открытой сессии. Зависит от сессии |
Не подходит для проверки, при которой вы «оставляете всё выполняться и занимаетесь чем-то другим» |
Cloud Routines — самый удобный вариант, но наш репозиторий находится во внутреннем GitLab, поэтому нам пришлось бы хранить учетные данные в облачной сессии, а мы решили не настраивать это на данном этапе. Задачи на рабочем столе монтируют папку, подключенную к моему ПК, в новой сессии и запускают её, а обновление репозитория (fetch) перед выполнением выполняю я.
Еще одна причина, по которой мы не стали задавать время выполнения, заключается в том, что развертывания происходят нерегулярно. Сейчас они выполняются примерно ежедневно, а после стабилизации запланированные развертывания будут чередоваться с хотфиксами. В обоих случаях условием запуска является не время, а событие «обновление завершено». Поэтому в обеих задачах поле cron остается пустым, а человек нажимает кнопку запуска.
3. Первоначальная настройка
Первоначальная настройка состоит из двух навыков и двух запланированных задач.
|
Настройка |
Подробности |
|---|---|
|
2 навыка |
Один — для проверки перед развертыванием в staging и подготовки сведений о развертывании, другой — для сравнения и развертывания gitops в staging и production. По одному Markdown-файлу для каждого |
|
2 запланированные задачи |
По одной на каждый навык. Время не задается: человек нажимает кнопку запуска. Задача выполняется с автоматическим подтверждением в новой сессии и по завершении отправляет уведомление |
|
Правила |
«Коммиты, отправка изменений и теги создаются людьми», а также «Если проверить не удалось, сообщи, что проверить не удалось». Эти предложения находятся в навыках и промптах |
|
Память |
Документация проекта. При следующем выполнении читается предыдущий документ с объявлением, ему присваивается номер и повторно используется отображаемый текст |
В файлах навыков я описывал скорее принятие решений, чем процедуру. Порядок проверок везде одинаков, но то, какие значения нельзя изменять, что не следует переводить и где это нужно искать, а также как сообщать о расхождении — это вопросы, относящиеся только к нашей среде. Например, имя каталога в staging gitops также равно prd, поэтому его нужно распознавать как репозиторий, а не как каталог; или названия экранов находятся не в репозитории, а в метках lingo, поэтому их не следует переводить — вместо этого их нужно искать в метках. Если записать эти решения в файлы, новая сессия сможет каждый раз выполнять проверки по одним и тем же критериям.
Операция проста. Обновите репозиторий и нажмите кнопку запуска; новая сессия читает навыки, проверяет область изменений, изменения в БД и согласованность версий, а затем оставляет отчет и черновик объявления. Я читаю отчет и выбираю только пункты, требующие решения. То, что мы не стали с самого начала создавать большую конфигурацию, было намеренным решением. Однако после нескольких запусков стало постепенно проясняться, насколько надежной может быть эта конфигурация и что именно в ней нужно исправить.
4. Признаки того, что пришло время всё исправить
Было пять признаков. Три из них в точности совпадали с точками внедрения, указанными в официальной документации.
Основная часть заполнена фрагментами shell-кода, а не процедурами
Два файла навыков разрослись примерно до 400 строк, половину из которых составляли блоки кода. Структура заставляла AI каждый раз анализировать фрагменты shell-кода в основной части, заново набирать и выполнять их для детерминированных задач: создания снимка репозитория, сравнения тегов образов, проверки имен файлов миграций БД, проверки матрицы версий и извлечения путей к экранам. Результаты немного различались при каждом выполнении, а однажды система даже создала ложное расхождение, прочитав файл, оставшийся после предыдущего выполнения. Если воспользоваться формулировкой из официальной документации, «запустить алгоритм сортировки дешевле, чем сортировать по токенам». Основная часть SKILL.md полностью загружается в контекст при запуске, тогда как скрипты только выполняются и используют токены для своего вывода.
Копии одних и тех же правил находятся в нескольких местах
Правила git существовали в четырех местах: в двух навыках и двух запланированных промптах. Это произошло потому, что полная процедура была продублирована в промптах с формулировкой «Если навык недоступен, выполните приведенную ниже процедуру». Намерение обеспечить избыточность было правильным, но в результате для однократного изменения правила требовалось править четыре места, причем одна копия уже разошлась с остальными.
Среда выполнения привела к инциденту
В среде, где выполнялись запланированные задачи, удаление файлов было заблокировано в подключенных папках. Однако git создает и удаляет файлы блокировки даже для команд, которые выглядят как операции только чтения, поэтому в каждом репозитории оставались пустые файлы блокировки, которые нельзя было удалить. Правило «команды только для чтения безопасны» в этой среде оказалось неверным. Помимо самих файлов блокировки, этот инцидент преподал два урока. Характеристики среды выполнения являются частью дизайна, а правила, сформулированные в виде предложений, — это, как сказано в официальной документации, «запросы, а не гарантии». Правила, которые должны соблюдаться каждый раз, следует обеспечивать с помощью хуков.
Процедура стала устоявшейся
Структура разделов двух навыков стала одинаковой: принципы → цели → снимок и актуальность → область изменений → блокирующие условия → результаты. Это означало, что стало возможно отделить шаги, которые можно реализовать скриптами, от шагов, требующих суждения AI, и пришло время перейти к рекомендуемой структуре (процедура находится в основной части, правила — в справочных файлах, а код — в скриптах). Если бы мы начали с такой структуры, то разделили бы всё неправильно, поскольку не знали бы, что является детерминированным, а что требует суждения.
Она не подготовлена для следующего пользователя
Навыки были синхронизированы с моей учетной записью, известные отклонения и глоссарий отображения были представлены в виде списков прозы, а в основной части находились предложения со встроенными датами. Пока я был единственным пользователем, это не создавало проблем. Но чтобы встроить это в написанный мной отдельно harness или использовать для внедрения AI в команде либо организации, всё нужно организовать как плагин, конфигурацию представить в виде данных, а правила разместить в одном месте. Если оставить всё в форме переходной процедуры, которую впоследствии выбросят, на следующем этапе придется создавать всё заново.
5. Улучшения
Направление улучшений можно сформулировать одним предложением. Скрипты выполняют проверки по заданным правилам, AI принимает решения, следуя навыкам, правила хранятся только в одном месте, а хуки обеспечивают соблюдение правил, которые должны выполняться. Я снова разделил два навыка в соответствии с этим стандартом и объединил их в один плагин.
devlime-release-ops/
├── skills/        release-check · release-notes · prd-gitops-sync
│                  (각 50줄 안팎, 체크리스트 + 판단)
├── references/    repos · git-rules · flyway-check · configmap-compare
│                  notice-style · known-deviations · history · ledger
├── config/        저장소 표 · gitops 대조 규칙 · 기준값 · 버전 상호 참조
│                  알려진 편차 · ledger  (JSON)
├── scripts/       snapshot · freshness · changes · flyway_lint · version_matrix
│                  cm_pair · routes · locate · ledger · notice_lint · image_tags
│                  configmap_diff · plan_validate · plan_apply · plan_verify
├── hooks/         hooks.json + guard.py  (명령 실행 전 규칙 검사)
├── evals/         스킬별 평가 + 트리거 질의
└── tests/         합성 저장소 생성 + 검사
Скрипты выполняют проверки и взаимодействуют с помощью кодов возврата. Проверки по заданным правилам — например, актуальности репозитория, области изменений, формата изменений БД, согласованности версий библиотек и сравнений тегов образов — выполняются скриптами Python. Результаты сохраняются в файлы, а код возврата сообщает «пройдено / заблокировано / требуется проверка / ошибка». Если выполнение заблокировано, навык помещает этот факт в начало отчета и останавливается; элементы, требующие проверки, передаются на рассмотрение. Теперь основная часть навыка содержит только контрольный список, который последовательно вызывает эти скрипты, и объяснения того, как проверять элементы, требующие суждения.
Release check:
- [ ] 1. 스냅샷        snapshot.py
- [ ] 2. 신선도        freshness.py     (낡았으면 멈추고 최신화 명령을 사용자에게)
- [ ] 3. 변경 범위     changes.py
- [ ] 4. DB 반영 사항  flyway_lint.py   (판단이 필요한 항목만 가이드 문서를 읽고 판정)
- [ ] 5. 버전 정합     version_matrix.py
- [ ] 6. 보고서 조립 → 문서 저장
Необратимые изменения разделены на четыре этапа: планирование, проверка, применение и подтверждение. Процесс изменения операционных настроек изменился: вместо немедленного редактирования файлов на основании результатов сравнения AI сначала создает файл плана (какое значение, в каком файле, на что и почему следует изменить), после чего скрипт проверки сопоставляет этот план с правилами и текущими файлами перед применением изменений. Если хотя бы один пункт плана содержит отложенное решение, выполнение не продолжается; если тем временем изменилось значение, одобренное пользователем, процесс останавливается. Это напрямую заимствует из внутреннего блога концепции «ворот решения» и «утверждения на основе снимка». После применения изменений выполняется повторная проверка, подтверждающая, что фактические изменения в точности соответствуют плану.
Правила хранятся в одном месте и обеспечиваются хуками. Правила, разбросанные по четырем местам, теперь используют один справочный файл как единственный источник истины, а навыки и запланированные промпты лишь ссылаются на этот файл. Хуки проверяют те же правила на этапе вызова инструмента и отклоняют команды, которые им не соответствуют, с указанием причины. Правила, записанные в виде предложений, — это то, чему мы ожидаем от AI соблюдения, а хуки делают невозможным их несоблюдение. Запланированные промпты больше не дублируют процедуру; теперь это всего две строки: «запусти навык; если он недоступен, остановись». История с датами была перенесена в отдельный файл, а в основной части остались только правила.
Сравнение до и после
|
Элемент |
Исходная настройка |
Плагин |
|---|---|---|
|
Содержимое навыка |
Около 400 строк × 2, половина из них — блоки кода |
Около 50 строк × 3, содержащих только контрольные списки и решения |
|
Проверки на основе правил |
ИИ заново набирает и выполняет фрагменты оболочки из содержимого |
13 скриптов, коды завершения которых различают успешное выполнение, блокировку и необходимость ручной проверки |
|
Правила |
Копии в четырёх местах, встроенные в текст |
Один справочный файл + хуки |
|
Конфигурация и словари |
Текст в содержимом |
Файл конфигурации (JSON). Скрипты и навык читают один и тот же файл |
|
Изменения операционной конфигурации |
Сравнить и немедленно изменить |
Спланировать → проверить → применить → подтвердить |
|
Основание для утверждения |
Время последнего обновления |
Время последнего обновления + хеш коммита для каждого репозитория |
|
Запрос расписания |
Вызов навыка + полностью продублированная процедура |
Вызов в две строки; остановиться, если навык не установлен |
|
Валидация |
Отсутствует |
Наборы для оценки каждого навыка, тесты синтетических репозиториев |
6. Заключение
Эта настройка состоит из набора навыков, тринадцати скриптов, одного хука и одного плагина, который связывает их воедино. Если рассматривать её через семь уровней функциональности расширений, предоставляемых Claude Code, это всё ещё лишь подмножество, к тому же пользователь всего один. Однако такой охват стал результатом выстраивания порядка, а не недостатка возможностей. Поскольку в официальной документации указано, когда следует внедрять каждую функцию, я могу сказать, каких триггеров уже достиг и каких ещё нет, и заранее знаю, когда возникнет необходимость в следующей функции.
Главным изменением при переходе от исходной настройки к плагину стало расположение элементов проверки. То, что раньше находилось у меня в голове и в истории сообщений, было перемещено в файлы, а половина этих файлов превратилась в правила для чтения людьми, тогда как другая половина стала проверками для выполнения скриптами. В результате мы рассматривали одни и те же пункты в одном и том же порядке, пункты, по которым решение было отложено, каждый раз оставались на том же месте, а процесс останавливался, если за это время утверждённое значение изменялось. Работа с ИИ над проверками развёртывания принесла больше пользы именно благодаря этому, чем за счёт сэкономленного времени.
Следующим шагом станет проверка этой настройки в реальном репозитории. Управление этой настройкой и момент её внедрения в команде будут рассмотрены в следующей статье — «Критерии превращения персональной настройки ИИ в командный ресурс».
Juno