
Введение
Решение использовать ИИ-агента для написания кода в работе не сводилось к установке одного инструмента. Это означало переопределение самого способа нашей работы. Сначала я думал, что будет достаточно хорошо использовать промпты или навыки. Но через несколько месяцев от них почти ничего не осталось. Остались документы с правилами, записи о сбоях и повторяющийся процесс превращения сбоев в правила.
В этой статье я обобщаю структуру и предпосылки текущего agent flow, который я использую, а также то, что работает хорошо, и то, чего пока не хватает. Все даты и числовые показатели взяты из сохранившихся записей.
В чём заключалась проблема?
Речь идёт о внутренней платформе. Она имеет структуру MSA, в которой такие сервисы, как аутентификация, организации, брокер событий и управление знаниями, разделены на backend-, frontend- и GitOps-репозитории. Для агента эта структура сложна потому, что одна функция охватывает три репозитория. Освоив структуру, человек может без особых трудностей применить её в новом проекте, но при смене сессии агенту приходится начинать всё с нуля.
Поначалу мы действовали просто. Я объяснял требования, агент реализовывал их, а я время от времени проверял результат, прежде чем объяснить следующий шаг. Такой подход не мог долго существовать. Узкие места возникали там, где требовалось вмешательство человека. Каждый раз, когда мы добавляли доменную модель в backend микросервиса, приходилось запускать генератор кода, соответствующий структуре платформы, и сообщать агенту о завершении этой операции, прежде чем он мог продолжить. Аналогичные остановки возникали на нескольких этапах как в backend, так и во frontend. Кроме того, вмешательство происходило слишком поздно. Попытка исправить неверное направление уже во время реализации означала потерю всех потраченных к тому моменту токенов и времени.
После этого я сформулировал два принципа: «Принимайте все необходимые решения до начала задачи и не вовлекайте человека в обычный процесс выполнения» и «После завершения задачи получайте отчёт и принимайте следующее решение на его основе». Исключениями были только случаи, когда во время выполнения требовалось новое решение или возникала неустранимая проблема. Большинство навыков, которые я организовал впоследствии, существуют для поддержания этих принципов.
Текущая структура
Три репозитория в одном workspace
У каждого сервиса есть собственный workspace, внутри которого backend-, frontend- и GitOps-репозитории связаны через symlinks. В самих репозиториях нет каталогов, связанных с агентом. Правила, агенты, навыки и рабочие документы, такие как docs и tasks, управляются только в этом workspace.
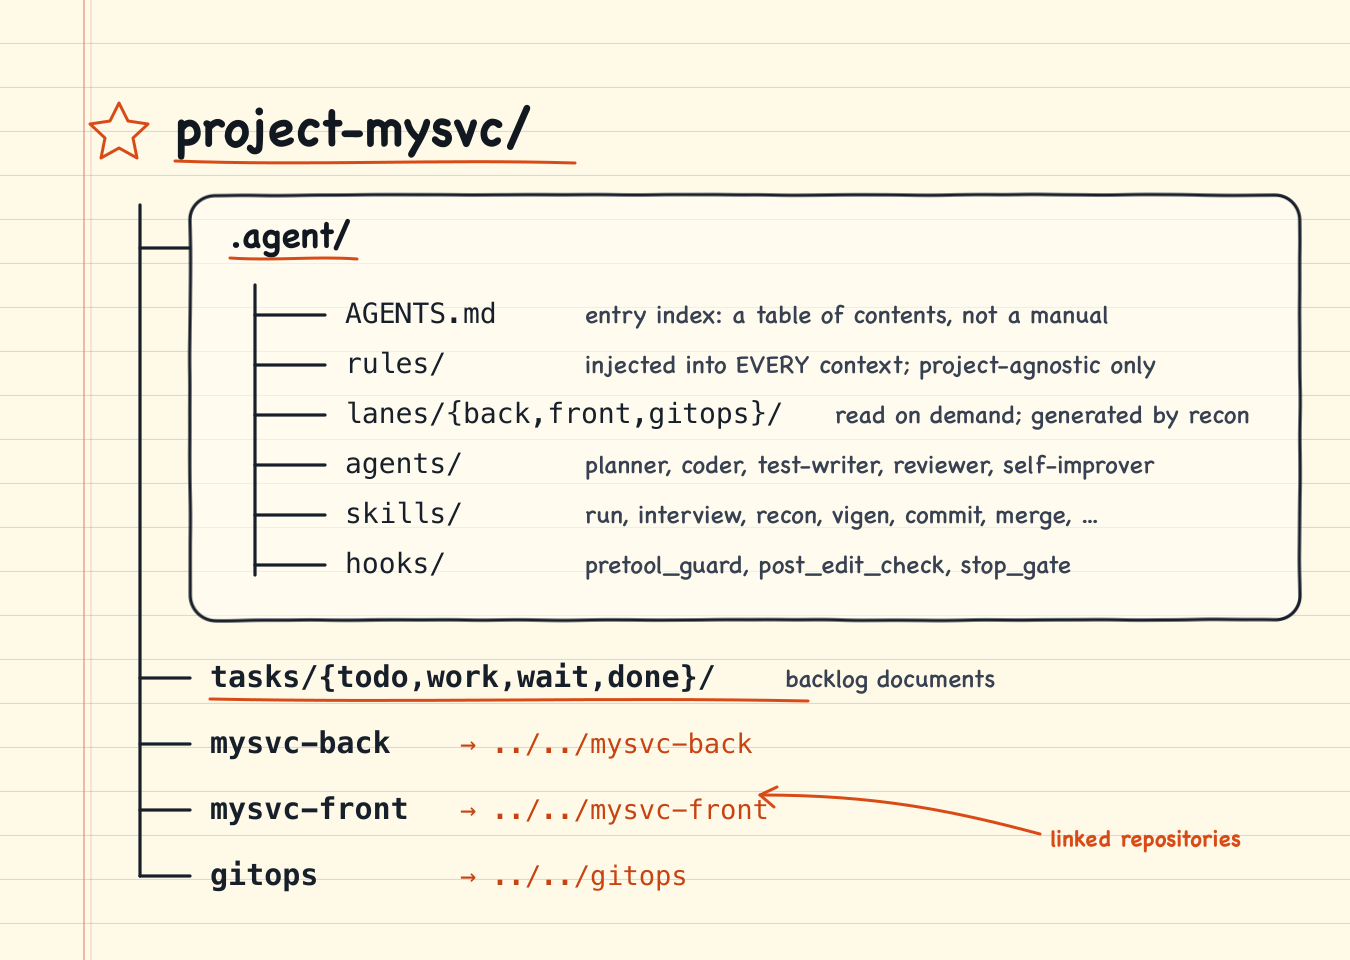
Причина объединения трёх репозиториев в одном workspace — возможность хранить историю работы в одном месте. Разработка функции начинается с контракта backend API, проходит через frontend stub и продолжается манифестами развёртывания. Если работать с репозиториями по отдельности, этот процесс оказывается распределённым между тремя историями коммитов, и человеку приходится помнить, какое изменение во frontend было вызвано каким изменением в backend. Если планировать работу по User Story в одном workspace и выполнять коммит каждого репозитория на каждой волне, коммиты всех трёх репозиториев можно найти вместе в одном документе US.
Разделение rules/ и lanes/ также было важным решением. Поскольку rules/ автоматически включается в каждый контекст, каталог должен оставаться небольшим и не зависеть от конкретного проекта. В lanes/ содержатся специфичные для репозитория стеки, шаблоны, ограничения и моменты, требующие внимания; агент напрямую читает их при необходимости. Когда месяц назад я проводил измерения, в каждый контекст включалось 245 КБ — около 60 000 токенов, — а документы lane находились в rules/. Я обнаружил, что вызовы coder, которым содержимое lanes/ вообще не требовалось, начинались со 175 000 токенов, поэтому в тот же день разделил эти данные.
Пять ролей и общие правила
Существует пять субагентов, каждый со своей ролью. planner делит элемент backlog на Tasks и проводит самооценку, уточняя план, пока его оценка не превысит 95. coder реализует одну Task и не пишет тесты. test-writer пишет тесты, основываясь только на спецификации и контракте интерфейса. reviewer оценивает качество и полноту тестов относительно плана и присваивает одну из оценок: PASS, CONCERNS или FAIL. self-improver анализирует циклы, в которых возникали проблемы, и предлагает улучшения для документов с правилами, но не применяет их до получения одобрения.
Есть причина, по которой test-writer не разрешено видеть код реализации. Изначально у нас был субагент, который сначала писал тесты в стиле TDD. Однако при падении тестов этот агент напрямую изменял код реализации, пока тесты не начинали проходить. Поскольку все тесты проходили, в отчёте не было видно проблем, но на самом деле тесты не проверяли реализацию: реализация подгонялась под тесты. Поэтому мы изменили порядок. Сначала пишется реализация. Затем тесты пишутся без чтения кода реализации. Это правило указано в первой строке промпта test-writer, а Hook также блокирует доступ к файлам реализации.
Правила, общие для всех пяти субагентов, собраны в одном файле: «Не изменяйте файлы за пределами назначенных вам файлов», «Только orchestrator выполняет коммиты», «Сохраните отчёт в файл до написания ответа», «Ограничьте ответ десятью строками или менее» и «Немедленно завершайте работу после выполнения задачи». Последнее правило мы добавили после того, как агент, завершивший работу, пробудился ещё три раза, увеличив расход токенов с 320 000 до 370 000.
Навык run: выполнение одного элемента backlog от начала до конца
orchestrator получает один элемент backlog и действует в следующем порядке.
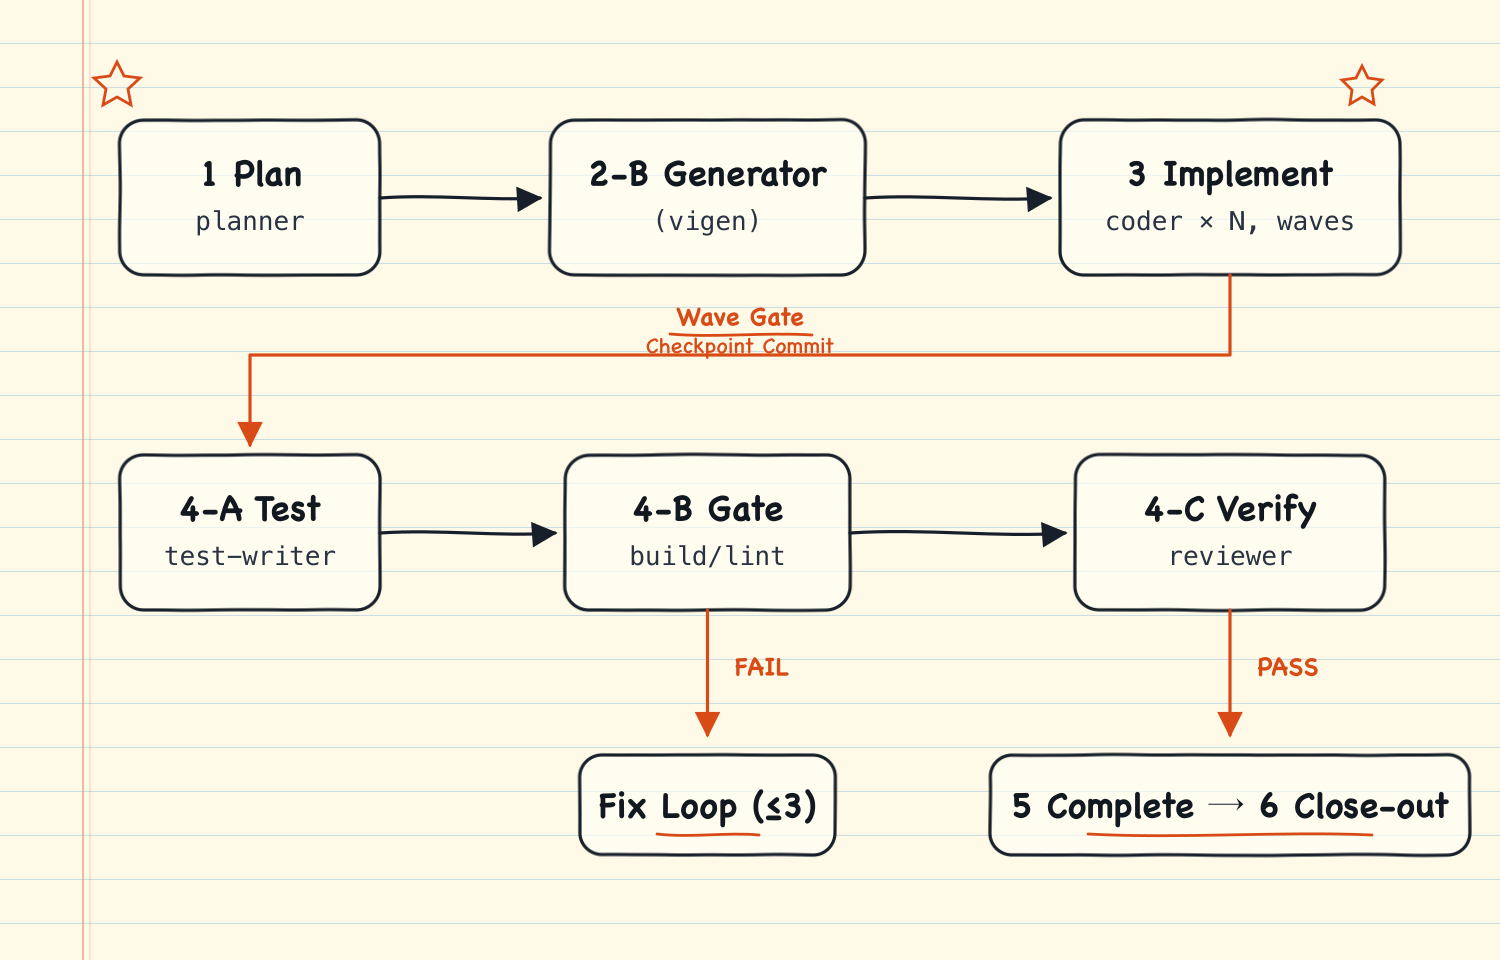
Есть два случая, когда выполнение останавливается на середине. Если необходимо что-то решить, агент задаёт вопрос вместе с рекомендацией. Если проблему нельзя решить ни одним ответом, он откладывает этот элемент backlog и переходит к следующему. Элементы backlog, не имеющие пересечений по изменяемым файлам, обрабатываются параллельно, а в конце каждой волны создаётся checkpoint-коммит. Решения и журналы выполнения сразу записываются в файлы. На основе этих записей в итоговом отчёте строится диаграмма Ганта с указанием времени и расхода токенов. Информация, оставшаяся только в контексте, исчезает при суммаризации.
Навык interview предшествует навыку run. Он выслушивает требования и делит backlog на Tasks, но действительно важная часть происходит ещё до этого. Если требования неясны или допускают две трактовки, сначала запускается ducking. Rubber Duck Debugging — это метод отладки, при котором человек, объясняющий проблему, обнаруживает логические пробелы в ходе объяснения резиновой утке. Затем выполняется обязательный этап подтверждения. Для каждого неоднозначного момента агент предлагает рекомендацию и альтернативы и ничего не записывает, пока не получит ответ. Мы неоднократно убеждались, что заполнение пробелов догадками — самая дорогостоящая ошибка.
Навык vigen: устранение последнего ручного шага
Цель создания навыка vigen заключалась не в экономии токенов. Его цель — устранить работу, которую человеку приходилось выполнять в промежутке между завершением interview и получением отчёта о завершении. Экономия токенов стала результатом этого.
В backend платформы после определения aggregate и entity необходимо структурировать восемь типов файлов, включая Event, Logic, Store и Jpo, в предписанных формах. Слой facade также имеет такой же механический формат для command, fetch и query, а frontend stub создаётся прямым переносом контракта facade. Поскольку форма полностью определяется правилами, принимать решения не требуется. Изначально люди создавали этот код, запуская специализированный генератор в форме плагина, что и вызывало упомянутые ранее остановки.
Первый этап автоматизации мы провели шесть недель назад. Вместо того чтобы поручать человеку запуск специализированного генератора, мы заставили агента прочитать документы с правилами и напрямую записать файлы. Мы проверили сгенерированный результат, сравнив его с эталонным кодом побайтно, и исключили вмешательство человека на этом этапе генерации. Однако после того, как мы поручили агенту работу, определяемую правилами, начали возникать ошибки вроде пропуска маркеров или сопоставлений полей. Иногда во время проверки код приходилось генерировать заново, что приводило к большой потере токенов.
Второй этап автоматизации состоялся четыре недели назад. Мы перенесли правила в четыре скрипта, используя только стандартную библиотеку Python. Теперь entity и facade генерируются за несколько секунд без расхода токенов, по тем же правилам, которые ранее применялись людьми со специализированным генератором. planner исключает код, сгенерированный этими правилами, из области работы coder. С этого момента в обычном процессе между interview и получением отчёта о завершении человек не вмешивается.
Что работает хорошо, а что — нет
Хорошо работает концентрация решений в начале работы. Раньше нам приходилось направлять агента или организовывать следующую задачу на разных этапах выполнения. Теперь мы принимаем необходимые решения до начала работы. Я также доволен тем, что процесс превращения сбоев в правила действительно работает, а размер контекста учитывается как затраты. Результаты проверки подтверждаются через Hooks и ledger, а не на основании самоотчёта агента.
Главный недостаток заключается в том, что сами документы с правилами стали слишком большими. Тело навыка run занимает 33 КБ, а INCIDENTS — 37 КБ. Мы управляем ими по принципу удаления не меньшего объёма, чем добавляем, и с помощью скрипта измерения ёмкости, но их объём продолжает расти. По мере увеличения числа правил растёт и число случаев, когда агенты читают их, но не соблюдают. orchestrator также остаётся единой точкой отказа. Правило записи состояния только в файлы смягчает эту проблему, но не решает её. Строгие правила обременительны и для людей. В недавнем цикле, занявшем 204 минуты, почти половина общего времени ушла на ожидание test-writer, который бездействовал. Эти проблемы необходимо решать посредством непрерывного цикла самоулучшения.
Заключение
Этот процесс также прояснил границы автоматизации. Работа, для которой человеку требовалось три или четыре раза запускать специализированный генератор, сначала была преобразована в правила, а работа, требовавшая от LLM интерпретации этих правил, затем была перенесена в детерминированные скрипты. Проблемы, при которых агенты пересекали границы своих ролей, не оставляются на откуп одним лишь промптам: им препятствуют строгий порядок выполнения и Hooks.
В конечном счёте важным оказалось не количество агентов или навыков, а момент вмешательства человека. Обычное выполнение поручено агентам и скриптам, а разработчики могут сосредоточить своё время на принятии решений до начала работы и оценке результатов.
Оставшиеся задачи — действительно сократить объём документов с правилами, структурно уменьшить число сборок на контрольных точках волн, чтобы сэкономить общее время, и автоматически записывать тенденции между циклами, чтобы использовать их для улучшений.
dnine