
1. Введение
В существующем работающем сервисе каждую минуту генерируется и сохраняется в базе данных один фрагмент данных. Данные поступают последовательно во времени, поэтому в течение часа в соответствующие моменты времени сохраняются 60 фрагментов данных.
При разработке новой функции возникло требование обрабатывать данные, которые хранятся в той же таблице, но генерируются иначе, чем существующие данные.
Новые данные являются результатом отдельного анализа данных за предыдущий час, выполненного внешним сервисом. Ранее один фрагмент данных поступал каждую минуту, тогда как при использовании новой функции после завершения анализа примерно 60 фрагментов данных за предыдущий час передаются в одном API-запросе.
Целесообразно ли обрабатывать задачи, инициированные внутри сервиса и имеющие управляемое время выполнения, так же, как запросы, полученные из внешнего источника?
Эта работа началась с данного вопроса.
2. Формулировка проблемы
Сначала я подумал, что можно без изменений использовать существующий метод обработки данных. У нас уже была реализована функция, которая генерировала более 10 000 записей за одну операцию и разделяла их на пакеты по 500 записей для Batch Insert.
Поскольку мы уже обрабатывали более 10 000 записей за раз, мы решили, что хранение примерно 60 записей в одном запросе можно без проблем реализовать тем же способом. На самом деле сам объём в 60 записей не представлял проблемы.
Однако при сравнении существующей операции с этой функцией я обнаружил важное различие. Существующая пакетная обработка данных инициируется внутри сервиса. Мы можем в определённой степени предвидеть, когда начнётся операция и какой объём данных будет сгенерирован за один раз, а также управлять потоком обработки данных внутри сервиса.
В отличие от этого, при использовании новой функции API вызывается после завершения анализа внешним сервисом. Наш сервис не может определить, когда поступит запрос, а если несколько задач анализа завершатся примерно в одно и то же время, несколько запросов могут поступить одновременно. Если реализовать это с использованием того же синхронного подхода, что и раньше, каждый запрос будет проходить следующий процесс.
Request → Validation → Transform → Batch Insert → ResponseПри рассмотрении только одного запроса проблем нет, но при пакетном поступлении запросов преобразование данных и операции с базой данных выполняются одновременно для каждого запроса. В конечном итоге различие между двумя операциями заключалось не в объёме данных, обрабатываемых за один раз. Существующая операция позволяла нашему сервису управлять временем и потоком обработки, тогда как новая функция инициируется внешними запросами.
Поэтому вместо полного выполнения фактической обработки данных при каждом поступлении внешнего запроса мы решили разделить процесс получения запросов и процесс обработки самих данных.
3. Решение
В конечном итоге мы решили разделить этап Receive, на котором принимаются внешние запросы, и этап Process, на котором сохраняются фактические данные. Для внешних запросов полученные данные сначала сохраняются в виде Payload, а фактическая обработка данных выполняется в отдельном Process.
Сохранение данных для каждого запроса с использованием Payload
Чтобы разделить Receive и Process, нам требовался способ сохранять полученные извне данные до момента их фактической обработки. Примерно 60 фрагментов данных, передаваемых в одном API-запросе, представляют один результат анализа за предыдущий час.
Поэтому вместо сохранения каждого фрагмента данных как отдельной цели обработки мы решили, что будет правильнее управлять одним запросом как одной рабочей единицей. Для этого мы сериализуем все данные, полученные через API, в JSON String и сохраняем их в одной Row таблицы Payload.
60 фрагментов данных → JSON Serialize → 1 Payload Row
На этом этапе мы не создаём 60 Rows в итоговой таблице. Мы лишь сохраняем полученный извне запрос как один Payload, а фактическая обработка данных выполняется позднее, на этапе Process. Это позволяет выполнять при поступлении внешнего запроса только относительно простую операцию сохранения, отделяя преобразование данных и их итоговое сохранение в отдельный поток обработки.
Обработка данных через Timer Event
Данные, сохранённые в Payload, обрабатываются через Timer Event, который запускается каждую минуту. Поскольку передаваемые в этот раз данные являются результатом анализа внешним сервисом данных за предыдущий час, они не были данными реального времени, которые требовалось немедленно отразить в итоговой таблице после получения запроса.
Поэтому мы могли допустить некоторую задержку обработки. При запуске Timer Event он получает необработанные данные из таблицы Payload. Затем он Deserializes данные, сохранённые как JSON String, выполняет необходимые преобразования и сохраняет результат в итоговую таблицу.
Timer Event → 처리 대상 Payload 조회 → JSON Deserialize → 데이터 변환 → Batch Insert / UpsertСам метод сохранения итоговых данных по-прежнему использовал существующий подход Batch Insert. Изменилось лишь время выполнения Batch Insert. Вместо немедленного сохранения итоговых данных при поступлении внешнего API-запроса мы сначала принимали запрос как Payload, а внутренне выполняемый Timer Event обрабатывал фактическую операцию с базой данных. Это позволило разделить момент поступления внешнего запроса и момент фактической обработки данных.
Идентификатор запроса и целостность данных
После разделения Receive и Process нам также потребовался способ идентифицировать запросы и отслеживать их статус обработки. При синхронном подходе успешный ответ API можно считать признаком того, что обработка данных также завершена. Однако в изменённой структуре успешное выполнение API-запроса не означает, что сохранение итоговых данных завершено.
Поэтому при получении запроса мы генерируем requestId в формате UUID и сохраняем его вместе с Payload, а API возвращает 202 Accepted и requestId. requestId не является значением для идентификации отдельных записей; это значение для отслеживания работы, связанной с одним запросом, то есть с одной единицей Payload.
Нам также пришлось учесть случаи, когда одни и те же данные могут быть переданы повторно из-за проблем с сетью или других особенностей внешнего API. Даже если тот же запрос будет передан повторно, может быть сгенерирован новый requestId, поэтому одного requestId недостаточно для определения того, дублируются ли фактические данные. Поэтому мы разделили роль requestId, который отслеживает работу, и роль Unique Key, который определяет, являются ли фактические данные дубликатами.
requestId → 요청 및 작업의 추적
Unique Key → 실제 데이터의 유일성 보장
При сохранении итоговых данных мы выполняем Upsert на основе отдельного Unique Key, чтобы повторные Rows не создавались даже в случае повторной передачи тех же данных. Это позволяет отслеживать каждый запрос, выделенный в асинхронный процесс, сохраняя целостность итоговых данных.
4. Заключение
На основании изложенного выше первоначально рассматривавшийся метод синхронной обработки и реализованный в итоге метод обработки можно обобщить следующим образом.
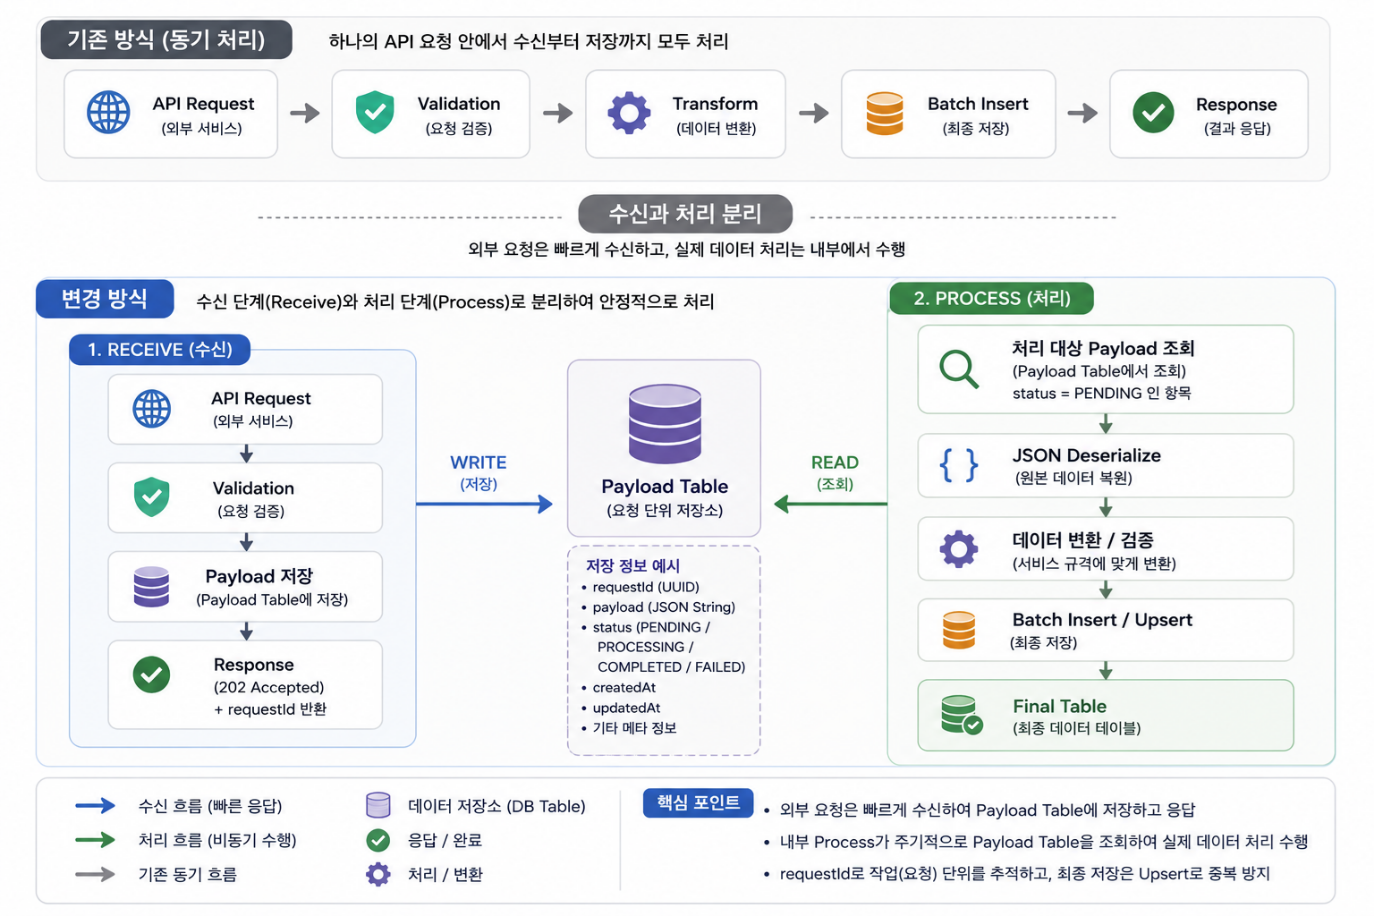
Мы уже использовали метод, который генерировал более 10 000 записей за одну операцию и разделял их на пакеты по 500 записей для Batch Insert. Поэтому сначала мы подумали, что эта функция, обрабатывающая примерно 60 записей в одном запросе, также может использовать существующий подход без изменений. Если учитывать только объём данных, этот метод действительно был вполне жизнеспособным.
Однако существующая операция запускается внутри сервиса, что позволяет нам управлять временем её выполнения и потоком обработки, тогда как эта функция инициируется запросом от внешнего сервиса.
Соответственно, вместо изменения самого Batch Insert мы разделили получение внешних запросов и обработку фактических данных. Внешние запросы сначала сохраняются как Payloads, а фактическое преобразование и сохранение данных выполняются во внутреннем Process.
Даже при сохранении одних и тех же данных подходящий метод обработки может различаться в зависимости от способа поступления данных, возможности управлять временем начала операции и сроков, к которым должна быть гарантирована обработка. Эта работа ещё раз подтвердила важность учёта таких различий при проектировании системы.
yang