
Простой сервера из-за превышения лимита TPS
При настройке конвейера для повторной передачи данных, собранных на борту, в наземное озеро данных мы столкнулись с ситуацией, которая потребовала тестирования пороговых значений. Чтобы повторно передать сообщения, хранящиеся в бортовых подах, в наземное озеро данных, сообщениям пришлось пройти через два ретрансляционных сегмента — EMQX и CCMD, поскольку эти сегменты имели ограничение на количество сообщений, которые они могли обрабатывать в секунду, то есть лимит TPS.
Поскольку на нескольких судах среда связи была нестабильной, данные часто не доходили, поэтому система была спроектирована так, чтобы одним запросом получать из озера данных все неполученные данные посредством пакетной обработки. При нормальном трафике его объём был значительно ниже лимита TPS, но в те короткие моменты, когда запускалась пакетная логика, одновременно поступало в несколько раз больше сообщений. Если бы конвейер, спроектированный с учётом среднего входящего потока, не выдержал эти моменты, серверы ретрансляционных сегментов вышли бы из строя, а сообщения были бы незаметно потеряны без единой ошибки.
В конечном итоге нам нужно было узнать не «Сколько сообщений в секунду может обработать этот конвейер?», а «Когда происходит внезапный всплеск, где система отказывает первой и сколько времени требуется на восстановление?». Обычный нагрузочный тест, поддерживающий постоянную нагрузку в течение длительного времени, не мог ответить на эти вопросы, поэтому мы выбрали Spike Test.
Итак, что такое Spike Test?
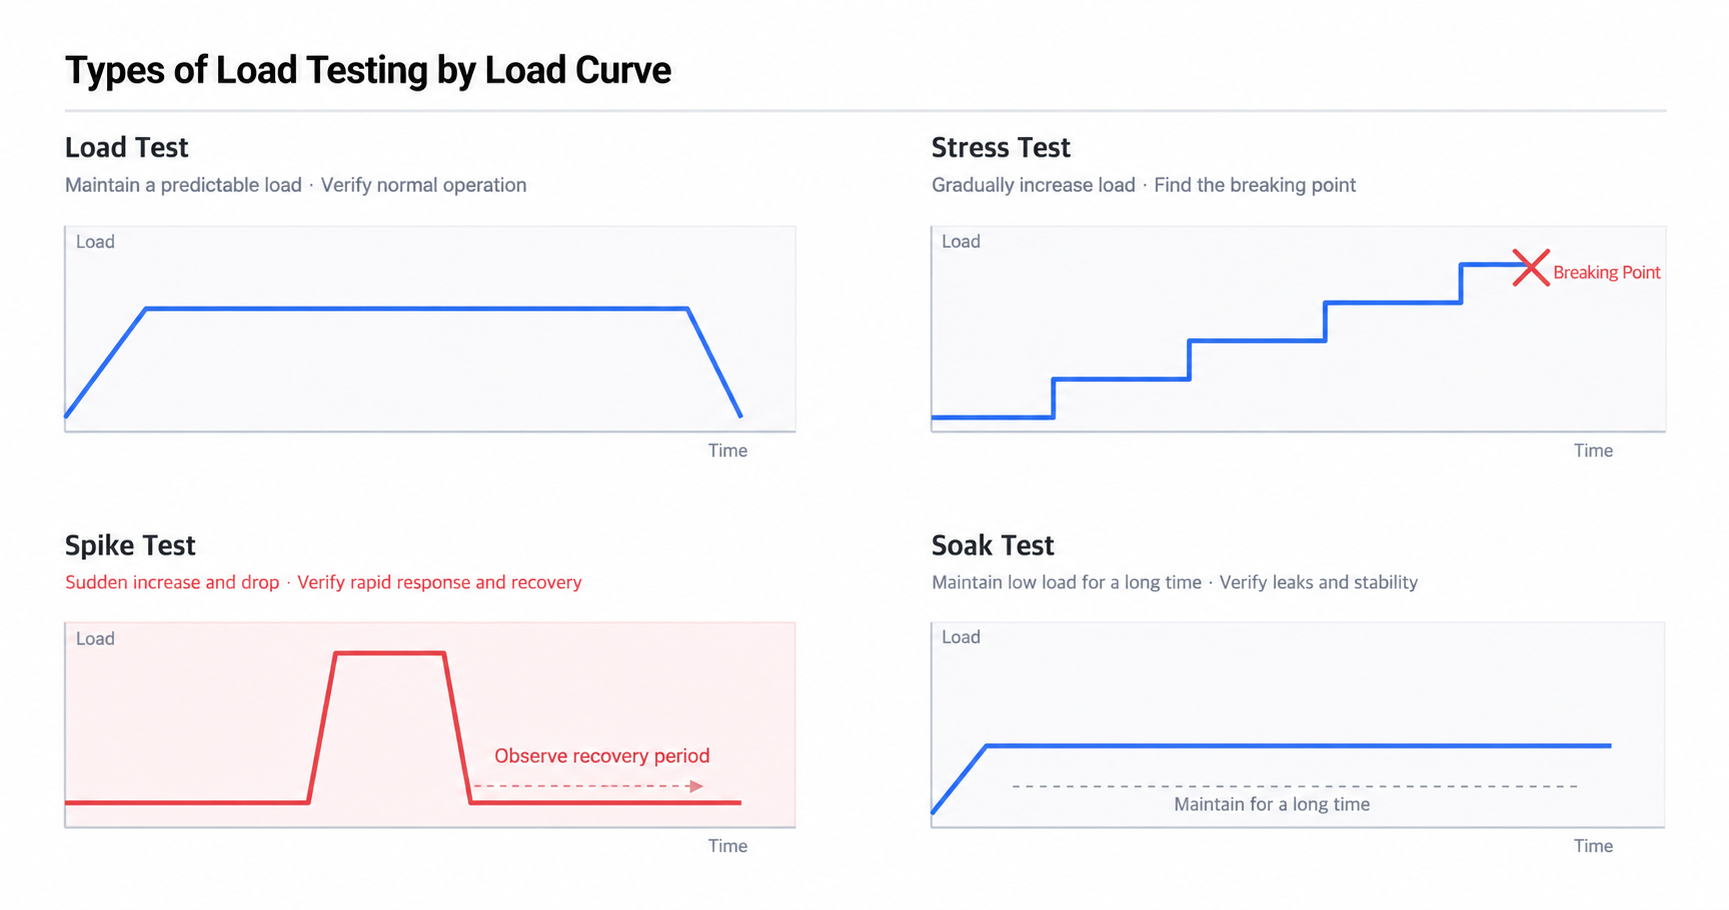
Прежде чем подробно рассматривать дизайн теста, стоит уточнить, чем Spike Test отличается от других видов нагрузочного тестирования. Нагрузочные тесты можно условно разделить на четыре типа в зависимости от формы прикладываемой нагрузки. Load Test поддерживает ожидаемую нормальную нагрузку на постоянном уровне, чтобы проверить корректность обычной обработки. Stress Test постепенно увеличивает нагрузку, чтобы определить порог, при котором система выходит из строя. Soak Test поддерживает низкую нагрузку в течение длительного времени, чтобы выявить проблемы, проявляющиеся только со временем, например утечки памяти или исчерпание ресурсов.
В отличие от них, Spike Test быстро увеличивает нагрузку за короткий период, а затем так же быстро снижает её. Ключевое отличие от других методов заключается в том, что он фокусируется не на самой максимальной пропускной способности, а на реакции системы и её устойчивости к внезапным изменениям. Он позволяет определить, насколько увеличивается очередь при всплеске нагрузки, в какой момент начинают расти частота ошибок и потери данных, а также сколько времени требуется для возврата к исходному состоянию после исчезновения нагрузки.
По определению, трафик повторной передачи имеет форму всплеска. В нормальных условиях он остаётся низким, резко возрастает только при восстановлении соединения, а после отправки всех накопившихся сообщений возвращается к исходному уровню. Если реальный трафик имеет такую форму, тест также должен иметь такую форму, чтобы результаты были значимыми.
Путь повторной передачи и узкое место
Тестируемый путь начинался в бортовых подах и проходил через EMQX и CCMD к наземному озеру данных. Когда бортовые поды публиковали сохранённые сообщения в EMQX, CCMD получал их и передавал в наземный сегмент, где они в конечном итоге загружались в озеро данных. В конвейере, состоящем из нескольких последовательных сегментов, общая пропускная способность определяется не средним значением, а сегментом с наименьшим верхним пределом. В данном пути эту роль выполняли ретрансляционные сегменты, на которые распространялся лимит TPS.
Нам также нужно было заранее задокументировать возможные последствия превышения лимита TPS. Избыточный трафик мог ограничиваться, из-за чего накапливались задержки; сообщения могли продолжать скапливаться в очереди до применения обратного давления; или, в худшем случае, соединения могли разрываться, а сообщения — отбрасываться. Особенно проблемными были случаи, когда сторона публикации отмечала сообщения как успешно отправленные, хотя фактически они так и не достигали озера данных. Поскольку такие потери невозможно обнаружить, анализируя только журналы отправителя, было крайне важно проверить систему, сравнив количество опубликованных сообщений с количеством сообщений, в конечном итоге полученных.
Проектирование теста
Spike Test должен был проверить три вещи. Во-первых, какой сегмент испытывал проблемы и каким образом при превышении лимита TPS. Во-вторых, где находился практический верхний предел, при котором сообщения могли проходить без потерь. В-третьих, сколько времени требовалось для очистки очереди и возврата системы в нормальное состояние после завершения всплеска.
Кривая нагрузки была спроектирована так, чтобы воспроизвести реальный сценарий восстановления соединения. Мы ненадолго поддерживали нормальный базовый уровень, затем за короткий период резко увеличивали нагрузку до значения, в несколько раз превышающего целевой TPS, удерживали её на этом уровне заданное время, а затем быстро возвращали к базовому уровню, чтобы наблюдать процесс восстановления. Если сделать период наращивания нагрузки слишком длинным, нагрузка будет расти постепенно, и тест фактически превратится в Stress Test, поэтому этот период важно намеренно сделать коротким.
Мы отдельно собирали метрики наблюдаемости для каждого сегмента. На стороне публикации мы отслеживали фактический TPS публикации, а также успешные и неуспешные ответы. В ретрансляционных сегментах мы отслеживали количество сообщений inflight и в очереди в EMQX, а также задержку обработки и частоту ошибок в CCMD. На стороне получателя мы проверяли количество сообщений, полученных озером данных. Мы также добавляли в каждое сообщение временную метку времени публикации и порядковый номер, чтобы одновременно рассчитывать сквозную задержку и уровень потерь.
Как выполнить Spike Test
Spike Test можно выполнять с помощью таких инструментов нагрузочного тестирования, как k6, JMeter и Gatling. Однако если цель состоит в проверке лимита TPS, важно выбрать инструмент, который может напрямую управлять количеством запросов в секунду, а не количеством виртуальных пользователей. При генерации нагрузки на основе количества виртуальных пользователей фактическая скорость публикации снижается по мере замедления ответов, не позволяя возникнуть именно тому состоянию перегрузки, которое необходимо проверить.
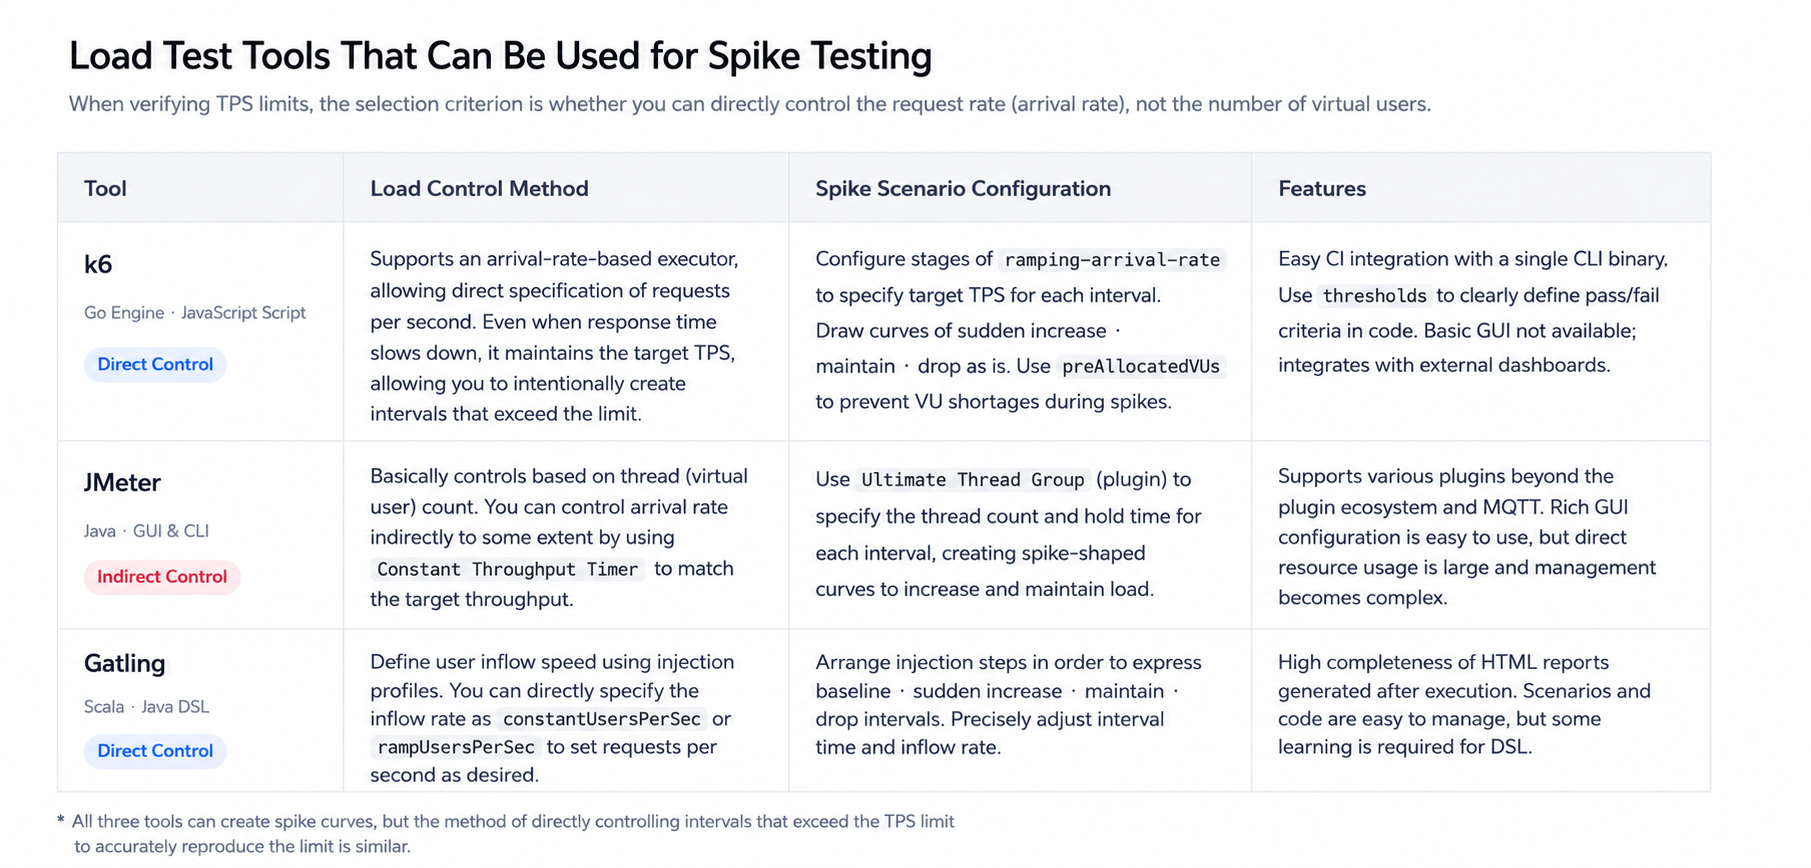
При использовании k6 для этой цели лучше всего подходит исполнитель ramping-arrival-rate. Он позволяет напрямую указывать целевой TPS для каждого сегмента с помощью stages, поэтому вы можете формировать базовый участок и участок всплеска по своему усмотрению. Выделив достаточные значения preAllocatedVUs и maxVUs, можно также предотвратить сглаживание фактического наращивания нагрузки из-за необходимости создавать новых виртуальных пользователей в момент возникновения всплеска. В JMeter кривую того же типа можно создать, объединив Ultimate Thread Group и Constant Throughput Timer.
При выполнении теста убедитесь, что сам генератор нагрузки не становится узким местом. Если генератор нагрузки работает на том же узле, что и целевая система, или имеет недостаточный пул соединений, инструмент тестирования может достичь собственного лимита раньше ретрансляционных сегментов, что приведёт к результатам, отличающимся от реальности. Кроме того, не завершайте тест сразу после окончания всплеска. Поддерживайте базовое состояние ещё несколько минут, чтобы можно было наблюдать процесс восстановления, включая очистку очереди накопившихся сообщений.
Проблемы в логике повторной передачи, выявленные во время Spike Test
Мы выполнили Spike Test по сценарию, основанному на проблеме, при которой после восстановления соединения терялись некоторые сообщения. Мы подтвердили, что начиная с момента превышения лимита TPS некоторые сообщения отмечались на стороне публикации как успешно переданные, но так и не достигали озера данных. Сравнение порядковых номеров показало, что потери были сосредоточены после определённой точки в периоде всплеска.
Чтобы определить, почему сообщения поступали одновременно, а не с такой скоростью, которую могли обработать ретрансляционные сегменты, мы изучили логику повторной передачи и обнаружили, что она немедленно последовательно публиковала все сохранённые сообщения в цикле, без какого-либо управления скоростью. Ещё более проблемным было то, что неудачные сообщения немедленно отправлялись повторно, добавляя трафик повторных попыток в уже перегруженные ретрансляционные сегменты и тем самым усугубляя ситуацию.
В конечном итоге после восстановления связи накопившиеся сообщения поступили со скоростью, в несколько раз превышающей лимит TPS, перегрузив ретрансляционные сегменты. Задержки, вызванные ограничением трафика, в сочетании с немедленными повторными попытками привели к тому, что очередь начала расти как снежный ком, что в итоге вызвало потерю некоторых сообщений.
К счастью, нам удалось обнаружить это с помощью Spike Test. Мы добавили в сегмент повторной передачи ограничение скорости на основе token bucket, чтобы сообщения передавались с равномерной скоростью ниже лимита TPS, и изменили поведение повторных попыток, добавив экспоненциальную задержку при ошибках. Это предотвратило обрушение ретрансляционных сегментов из-за внезапного всплеска трафика. Когда после внесения улучшений мы повторно запустили тот же сценарий, все сообщения были загружены в озеро данных без потерь, а время, необходимое для очистки очереди после всплеска, укладывалось в предсказуемый диапазон.
Заключение
Spike Test — это инструмент, позволяющий проверить не «Насколько быстра эта система?», а «Как она выдерживает неожиданные всплески и насколько быстро возвращается в нормальное состояние?». Системы, спроектированные только с учётом среднего трафика, обычно работают без проблем в нормальных условиях, поэтому уязвимости, проявляющиеся при внезапных всплесках, редко становятся видимыми до тех пор, пока не вызовут инцидент в рабочей среде.
Если система содержит логику, которая по своей природе генерирует всплески, например повторную передачу или повторные попытки, и перед ней находится сегмент с ограничением TPS, Spike Test стоит выполнить хотя бы один раз после завершения функциональной проверки.
jungboke