
글에 나오는 코드와 이름은 이해를 돕기 위해 실제 코드를 단순화하고 바꾼 예시입니다.
들어가며
담당하던 프로젝트에 AI 챗봇 기능을 붙이는 작업을 맡았습니다. 사용자가 질문을 입력하면 AI가 답변을 만들고 그 결과를 챗봇처럼 화면에 보여줘야 했습니다. 서버는 AI 처리가 끝났을 때 결과를 한 번 내려주는 구조였습니다.
백엔드에는 이미 Flux<ServerSentEvent<...>>를 반환하는 엔드포인트가 준비되어 있었습니다. SSE라는 걸 이때 처음 접했고 코드도 처음 봤으니, 이게 뭔지부터 알아본 다음 프론트엔드를 붙였습니다. 그런데 막상 테스트해보니 완료 메시지가 오지 않았습니다.
원인은 생각보다 금방 찾았습니다. 저는 프론트엔드를 맡아 화면과 SSE 연결을 먼저 붙여두었고 백엔드 담당자와 함께 증상을 보면서 범위를 좁혀갔습니다. 서버 쪽 수정은 백엔드 담당자가 했고 저는 무엇이 왜 바뀌었는지 설명을 들으며 정리했습니다. 이 글은 그 과정에서 SSE가 실제로 어떻게 동작하는지, 그리고 눈에 보이는 증상에서 출발해 원인을 어떻게 좁혀나갔는지를 프론트엔드 입장에서 정리한 것입니다.
1. SSE란?
SSE는 서버가 연결 하나를 계속 열어둔 채 데이터가 생길 때마다 클라이언트로 흘려보내는 방식입니다. 브라우저에는 이걸 받는 EventSource라는 API가 내장되어 있습니다.
일반적인 요청과 응답은 이렇게 끝납니다.
클라이언트: GET /api/data
서버: [응답 완성] → 200 OK + 본문 전체 → 연결 종료
SSE는 응답을 끝내지 않습니다.
클라이언트: GET /api/tasks/{taskId}/stream
서버: 200 OK, Content-Type: text/event-stream
서버: data: {"status":"GENERATING"}\n\n
서버: data: {"status":"GENERATING"}\n\n
서버: data: {"status":"SUCCESS"}\n\n
서버: (연결 종료)
data: 뒤에 개행이 두 번 오면 거기까지가 메시지 하나라고 규격에 정의되어 있습니다. 브라우저는 이 형식을 파싱해 청크가 도착할 때마다 message 이벤트를 발생시킵니다.
그래서 프론트엔드는 리스너를 한 번만 등록해두면 됩니다.
eventSource.addEventListener("message", handleEventMessage);이렇게 등록해두면 서버가 청크를 100개 보낼 때 handleEventMessage도 100번 호출됩니다.
백엔드의 Flux와도 그대로 대응됩니다. Flux는 여러 개의 값을 시간차를 두고 순차적으로 흘려보내는 타입이고 Spring WebFlux는 Flux에서 값이 나올 때마다 그걸 data: {...} 형식으로 인코딩해 응답 스트림에 씁니다. Flux가 값을 내보내는 횟수가 곧 message 이벤트 리스너가 호출되는 횟수입니다.
2. 다른 방식이었다면 어땠을까
사실 선택지는 하나였습니다. 백엔드에 이미 SSE 엔드포인트가 있었고 저는 거기에 연결만 하면 됐습니다. 다만 붙이면서 굳이 SSE여야 했을까, 다른 방식이었다면 어땠을까 하는 의문이 들어 다른 방식들과 비교해봤습니다.
폴링은 짧은 주기로 조회 API를 반복 호출합니다. 구현이 제일 쉽고 어떤 서버 환경에서도 동작하지만 불필요한 요청이 많고 실시간성이 폴링 주기에 묶입니다.
롱 폴링은 요청을 보내고 서버가 상태를 바꿀 때까지 응답을 미룹니다. 폴링보다 실시간성은 좋으나 서버가 커넥션을 오래 붙잡아야 하고 SSE 대비 이점이 뚜렷하지 않으면서 구현만 번거로워집니다.
웹소켓은 양방향 상시 연결입니다. 채팅이나 실시간 협업처럼 클라이언트도 계속 데이터를 보내야 하는 상황에 적합합니다.
|
폴링 |
롱 폴링 |
SSE |
웹소켓 |
|
|---|---|---|---|---|
|
방향 |
단방향 |
단방향 |
단방향 |
양방향 |
|
구현 난이도 |
매우 쉬움 |
중간 |
쉬움 |
상대적으로 복잡 |
|
실시간성 |
낮음 |
중간 |
높음 |
매우 높음 |
|
자동 재연결 |
해당 없음 |
직접 구현 |
브라우저가 기본 지원 |
직접 구현 |
우리 상황은 서버가 만든 결과를 클라이언트로 내려주기만 하면 되는 단방향이었습니다. 사용자가 질문을 보낸 뒤로는 클라이언트가 서버에 추가로 보낼 게 없었고 서버도 처리가 끝났을 때 결과를 한 번 보내면 됐습니다.
이 조건만 보면 폴링으로도 충분히 구현할 수 있었습니다. 다만 폴링은 결과가 언제 나올지 모르는 채로 주기마다 요청을 보내야 하고 결과를 받는 시점도 그 주기에 묶입니다. SSE는 연결 하나로 기다리다가 결과가 나오는 즉시 받을 수 있어, 대기 상태를 보여주다가 바로 결과로 바꿔야 하는 챗봇 화면과 잘 맞았습니다. 결과적으로 이미 준비되어 있던 SSE를 그대로 쓴 것도 괜찮은 판단이었다고 생각합니다.
3. JWT 인증 문제와 라이브러리 선택
우리 챗봇은 질문을 등록하는 API를 먼저 호출해 작업 아이디를 받은 뒤, 그 아이디로 SSE 연결을 여는 구조였습니다.
프론트엔드 구현은 어렵지 않아 보였습니다. EventSource 인스턴스를 만들고 리스너를 붙이면 끝입니다.
const eventSource = new EventSource(url);

eventSource.onmessage = (event) => {
  const data = JSON.parse(event.data);
  console.log(data);
};
그런데 붙여보니 바로 인증 에러가 났습니다.
브라우저 내장 EventSource는 커스텀 헤더를 지원하지 않습니다. 생성자에 넘길 수 있는 건 URL과 withCredentials 둘뿐입니다. 우리 프로젝트는 요청마다 헤더에 JWT 토큰을 실어 인증하는 구조였는데, 그 헤더를 붙일 방법 자체가 없었습니다.
찾아보니 이 문제를 우회하는 라이브러리가 두 가지 있었습니다.
event-source-polyfill은 내부적으로 XHR을 써서 EventSource API를 흉내 내면서 커스텀 헤더를 지원합니다. API 형태가 브라우저 내장 EventSource와 거의 같아 addEventListener나 close() 같은 기존 코드 구조를 그대로 쓸 수 있습니다.
@microsoft/fetch-event-source는 폴리필이 아니라 fetch() 위에서 SSE를 다시 구현한 라이브러리입니다. fetch가 제공하는 걸 모두 쓸 수 있어 POST 요청도 가능하고 응답 객체에 직접 접근해 검증할 수도 있으며 재시도 전략을 처음부터 끝까지 직접 제어합니다. 탭이 백그라운드로 가면 연결을 닫았다가 다시 보이면 재연결하는 기능도 있습니다.
기능만 보면 후자가 유연합니다. 다만 우리 백엔드는 GET 방식이었고 프로젝트 다른 화면에서 이미 event-source-polyfill을 쓰고 있었습니다. 같은 목적으로 라이브러리를 두 개 들일 이유가 없었고 기존 코드 구조를 거의 바꾸지 않아도 된다는 점이 컸습니다. 그래서 전자를 골랐습니다.
import { EventSourcePolyfill } from "event-source-polyfill";

const eventSource = new EventSourcePolyfill(url, {
  headers: {
    Authorization: `Bearer ${token}`,
  },
  heartbeatTimeout: 5 * 60 * 1000,
});

eventSource.addEventListener("message", handleEventMessage);
eventSource.addEventListener("error", handleEventError);
4. 첫 메시지 이후 응답이 오지 않는 증상
테스트해보니 첫 메시지는 잘 들어왔습니다.
eventMessage { status: "GENERATING", message: "Generating response...", ... }그런데 그게 끝이었습니다. AI가 답변을 다 만들었을 시간이 한참 지나도 완료 메시지는 오지 않았고 그렇게 5분을 기다린 끝에 돌아온 건 이런 에러였습니다.
EventSource failed.
Error: No activity within 300000 milliseconds. 277 chars received. Reconnecting.
heartbeatTimeout으로 설정해둔 5분 동안 아무 데이터도 오지 않아 라이브러리가 연결을 끊고 재연결을 시도한 것이었습니다. 277 chars, 첫 메시지 하나가 들어온 게 전부였다는 뜻입니다.
5. 원인 분석
5-1. 프론트엔드 배제와 반복되던 메시지
먼저 프론트엔드가 개입할 여지를 없애야 했습니다. 브라우저에서 챗봇을 한 번 실행시킨 뒤 개발자 도구에서 작업 아이디와 토큰을 그대로 복사해 API 테스트 도구로 같은 엔드포인트에 직접 요청을 보냈습니다.
결과는 같았습니다. 첫 메시지 하나만 오고 그대로 멈췄습니다. React도 라이브러리도 리스너 등록도 개입하지 않은 요청에서 똑같은 증상이 나왔으니, 프론트엔드는 용의선상에서 빠졌습니다. 응답 헤더의 Content-Type도 text/event-stream으로 정상이어서 형식 문제도 아니었습니다.
같은 요청을 여러 번 보내 보니 보낼 때마다 GENERATING 메시지가 바로 들어왔고 내용도 전부 같았습니다. 백엔드 코드를 보니 이유가 있었습니다.
public Flux<ServerSentEvent<TaskMessage>> subscribe(AiTask task) {
    String taskId = task.getId();

    Sinks.Many<TaskMessage> channel = this.channelMap.computeIfAbsent(taskId,
            id -> Sinks.many().replay().all());

    channel.tryEmitNext(TaskMessage.of(task, GENERATING));

    return channel.asFlux().map(m -> ServerSentEvent.builder(m).build());
}
tryEmitNext가 Flux를 반환하기도 전에 메서드 본문에서 무조건 실행됩니다. 이 메시지는 서버가 진행 상황을 감지해 보내준 게 아니라, 요청이 들어왔다는 이유만으로 그 자리에서 만들어진 것이었습니다. 제가 보낸 요청이 이벤트를 받은 게 아니라 이벤트를 만들고 있었던 셈입니다. 상태값도 GENERATING으로 고정되어 있었으니 몇 번을 호출해도 같은 내용이 나올 수밖에 없었습니다.
5-2. 완료 메시지가 버려진 이유
남은 건 완료 메시지가 왜 안 오는가였습니다. 완료 처리 코드는 이렇게 생겼습니다.
private void completeTask(TaskMessage message) {
    String taskId = message.getTaskId();

    Sinks.Many<TaskMessage> channel = this.channelMap.remove(taskId);

    if (channel != null) {
        channel.tryEmitNext(message);
        channel.tryEmitComplete();
    }
}
channelMap에 채널이 등록되는 시점은 앞에서 본 computeIfAbsent 하나뿐이었습니다. 그런데 그건 프론트엔드가 SSE 연결을 시도해야 비로소 실행되는 코드입니다.
문제가 재현된 건 AI 호출이 오류로 바로 실패하면서 평소보다 훨씬 빨리 끝난 경우였습니다. 완료 처리가 프론트엔드의 SSE 연결보다 먼저 실행된 것입니다. 전체 흐름을 그려보면 이렇습니다.
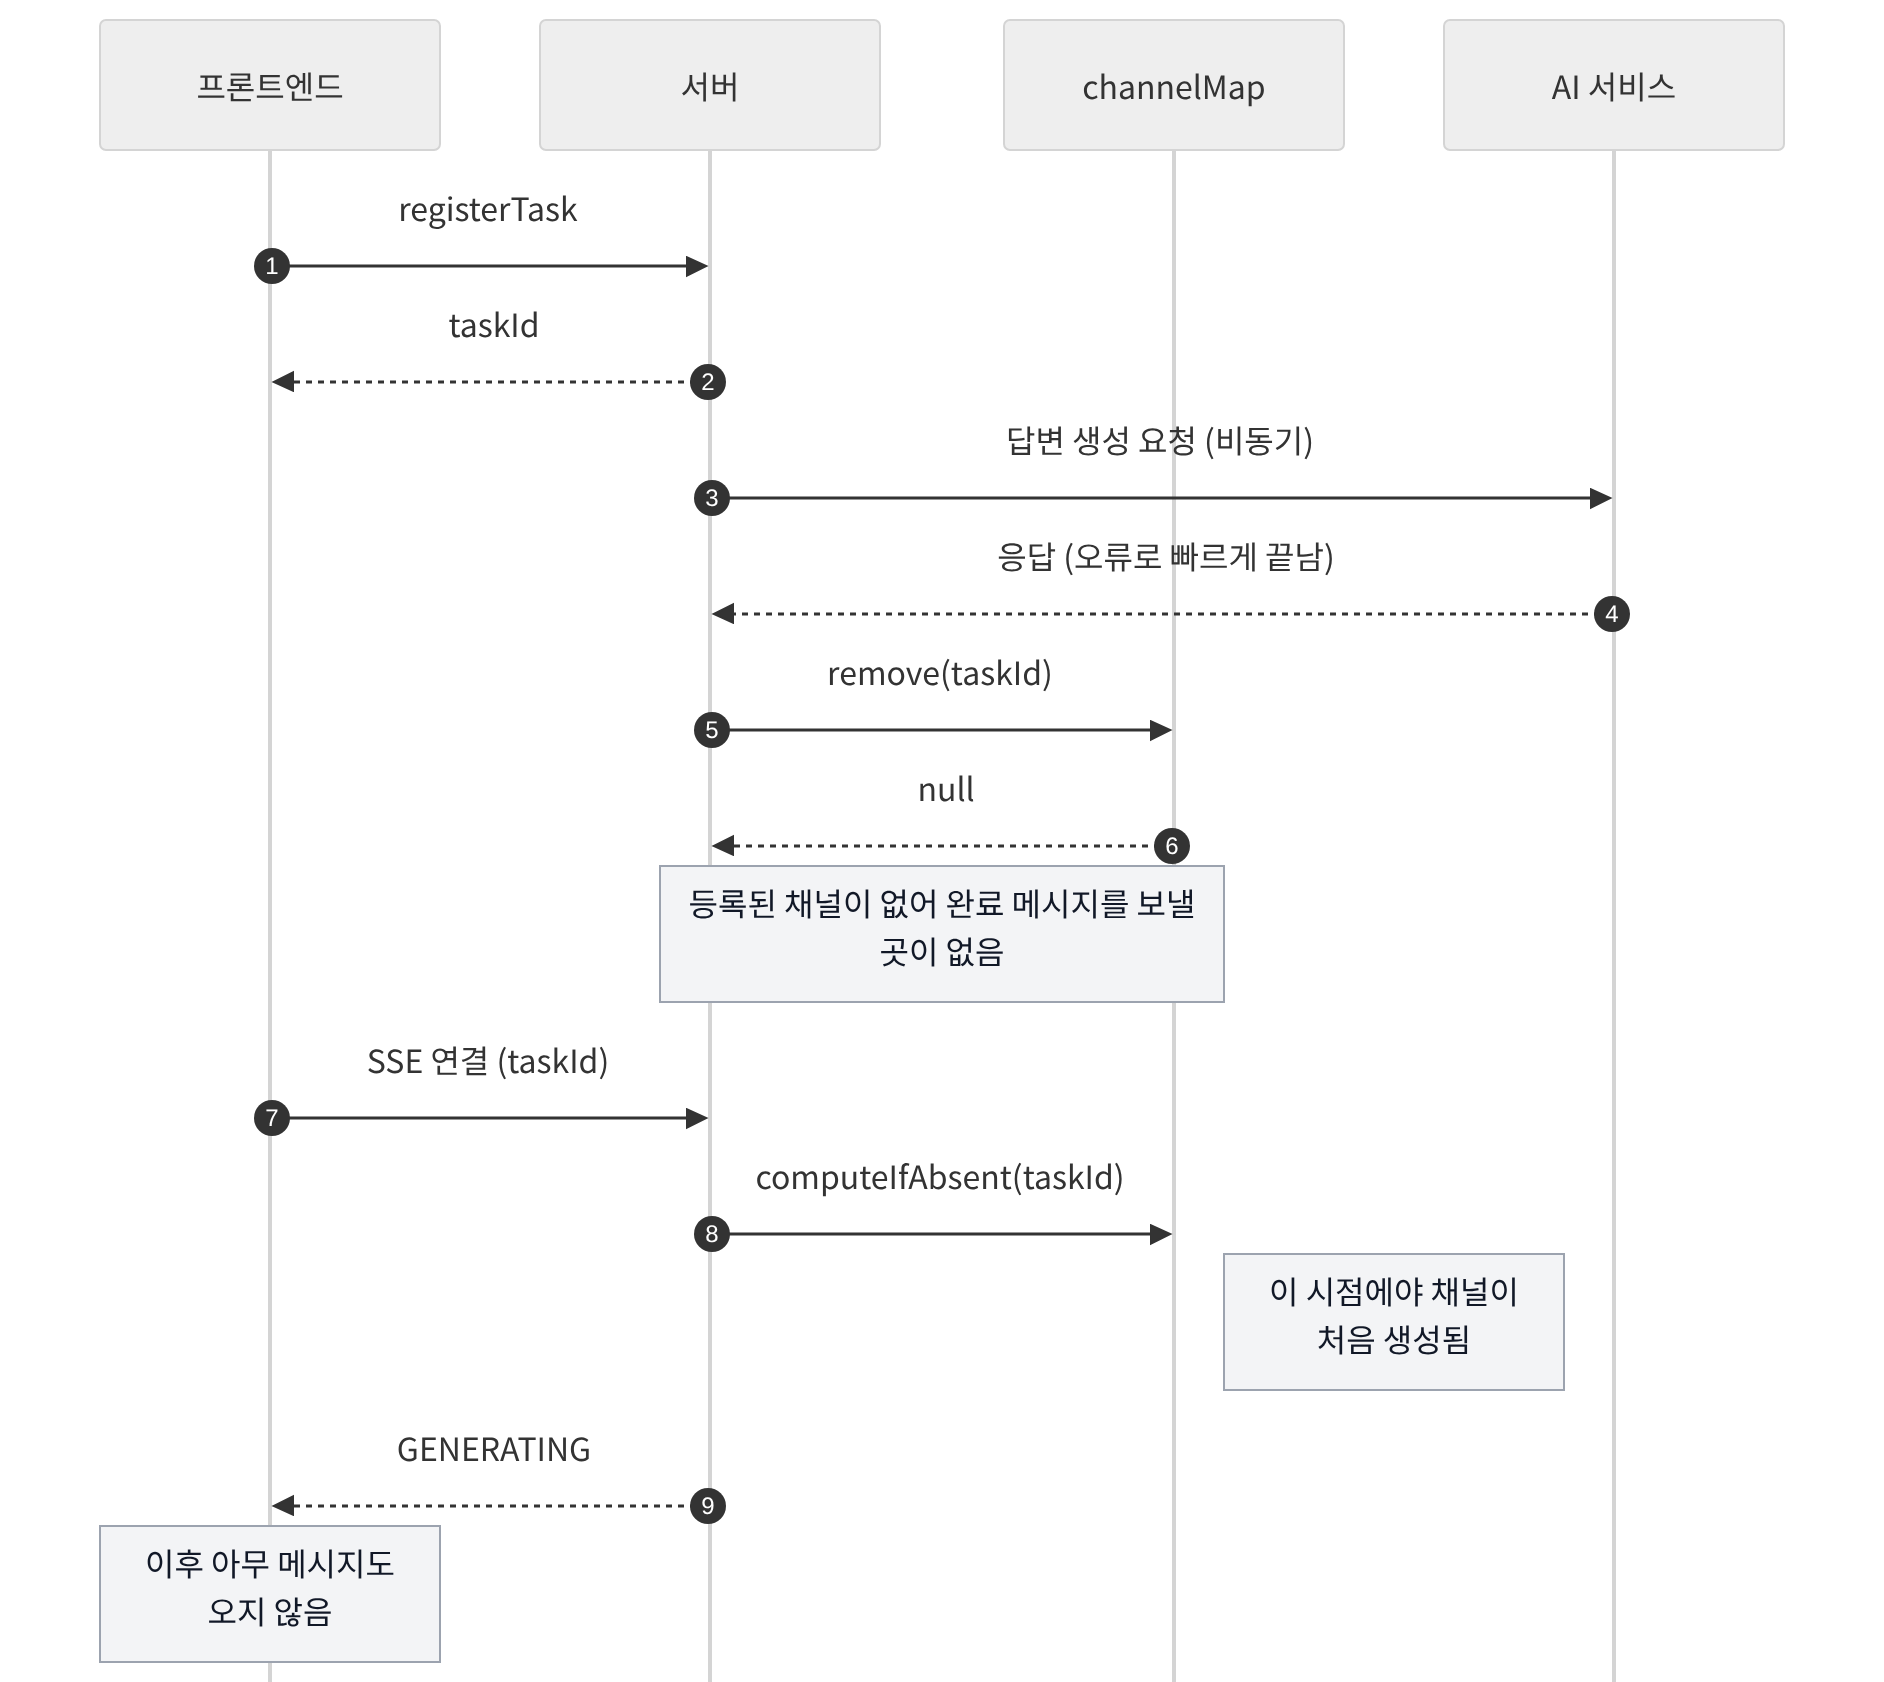
등록한 적 없는 채널을 꺼내려 했으니 remove는 null을 돌려줬습니다. 조건문 안으로 들어가지 못하니 완료 메시지는 보낼 대상이 없었고 로그 한 줄 남기지 않은 채 버려졌습니다. 게다가 완료 처리는 채널을 꺼내자마자 맵에서 지우는 구조라, 채널이 있었더라도 늦게 연결한 쪽은 그 채널을 찾을 수 없었습니다.
6. 해결 — 채널 등록 추가와 꺼내는 방식 변경
원인은 두 가지였습니다. 작업을 등록할 때 그 작업의 채널도 맵에 넣어야 했는데 이 등록이 빠져 있었고, 완료 처리에서는 채널을 꺼내자마자 맵에서 지우고 있었습니다. 수정은 백엔드 담당자가 맡았고 세 군데를 고쳤습니다.
먼저 작업을 등록하는 단계에서 채널을 맵에 넣도록 했습니다. AI 호출 이벤트는 이 메서드가 끝난 뒤 따로, 비동기로 발행됩니다.
public String registerTask(String prompt) {
    AiTask task = taskRepository.save(AiTask.create(prompt));

    this.channelMap.put(task.getId(), Sinks.many().replay().all());

    return task.getId();
}
다음으로 완료 처리에서 채널을 remove 대신 get으로 꺼내도록 바꿨습니다.
private void completeTask(TaskMessage message) {
    Sinks.Many<TaskMessage> channel = this.channelMap.get(message.getTaskId());

    if (channel != null) {
        channel.tryEmitNext(message);
        channel.tryEmitComplete();
    }
}
마지막으로 채널을 지우는 일은 SSE 연결 쪽으로 옮겼습니다. 구독자가 완료 신호까지 받으면 그때 맵에서 지웁니다. 이미 연결된 구독자가 있을 때는 대기 메시지를 다시 보내지 않도록 조건도 추가했습니다.
public Flux<ServerSentEvent<TaskMessage>> subscribe(AiTask task) {
    String taskId = task.getId();

    Sinks.Many<TaskMessage> channel = this.channelMap.computeIfAbsent(taskId,
            id -> Sinks.many().replay().all());

    if (channel.currentSubscriberCount() == 0) {
        channel.tryEmitNext(TaskMessage.of(task, GENERATING));
    }

    return channel.asFlux()
            .doOnComplete(() -> this.channelMap.remove(taskId))
            .map(m -> ServerSentEvent.builder(m).build());
}
이제 AI가 SSE 연결보다 먼저 끝나도 완료 메시지는 맵에 남아 있는 채널에 담깁니다. 프론트엔드가 늦게 연결하면 같은 채널을 구독하게 되고 replay().all()이 그동안 쌓인 메시지를 처음부터 다시 보내주기 때문에 완료 메시지까지 받을 수 있습니다. 이때 채널은 이미 닫혀 있으므로 연결 시점에 보내려던 대기 메시지는 전달되지 않고 무시됩니다. 결과를 받은 뒤에는 채널도 맵에서 지워집니다.
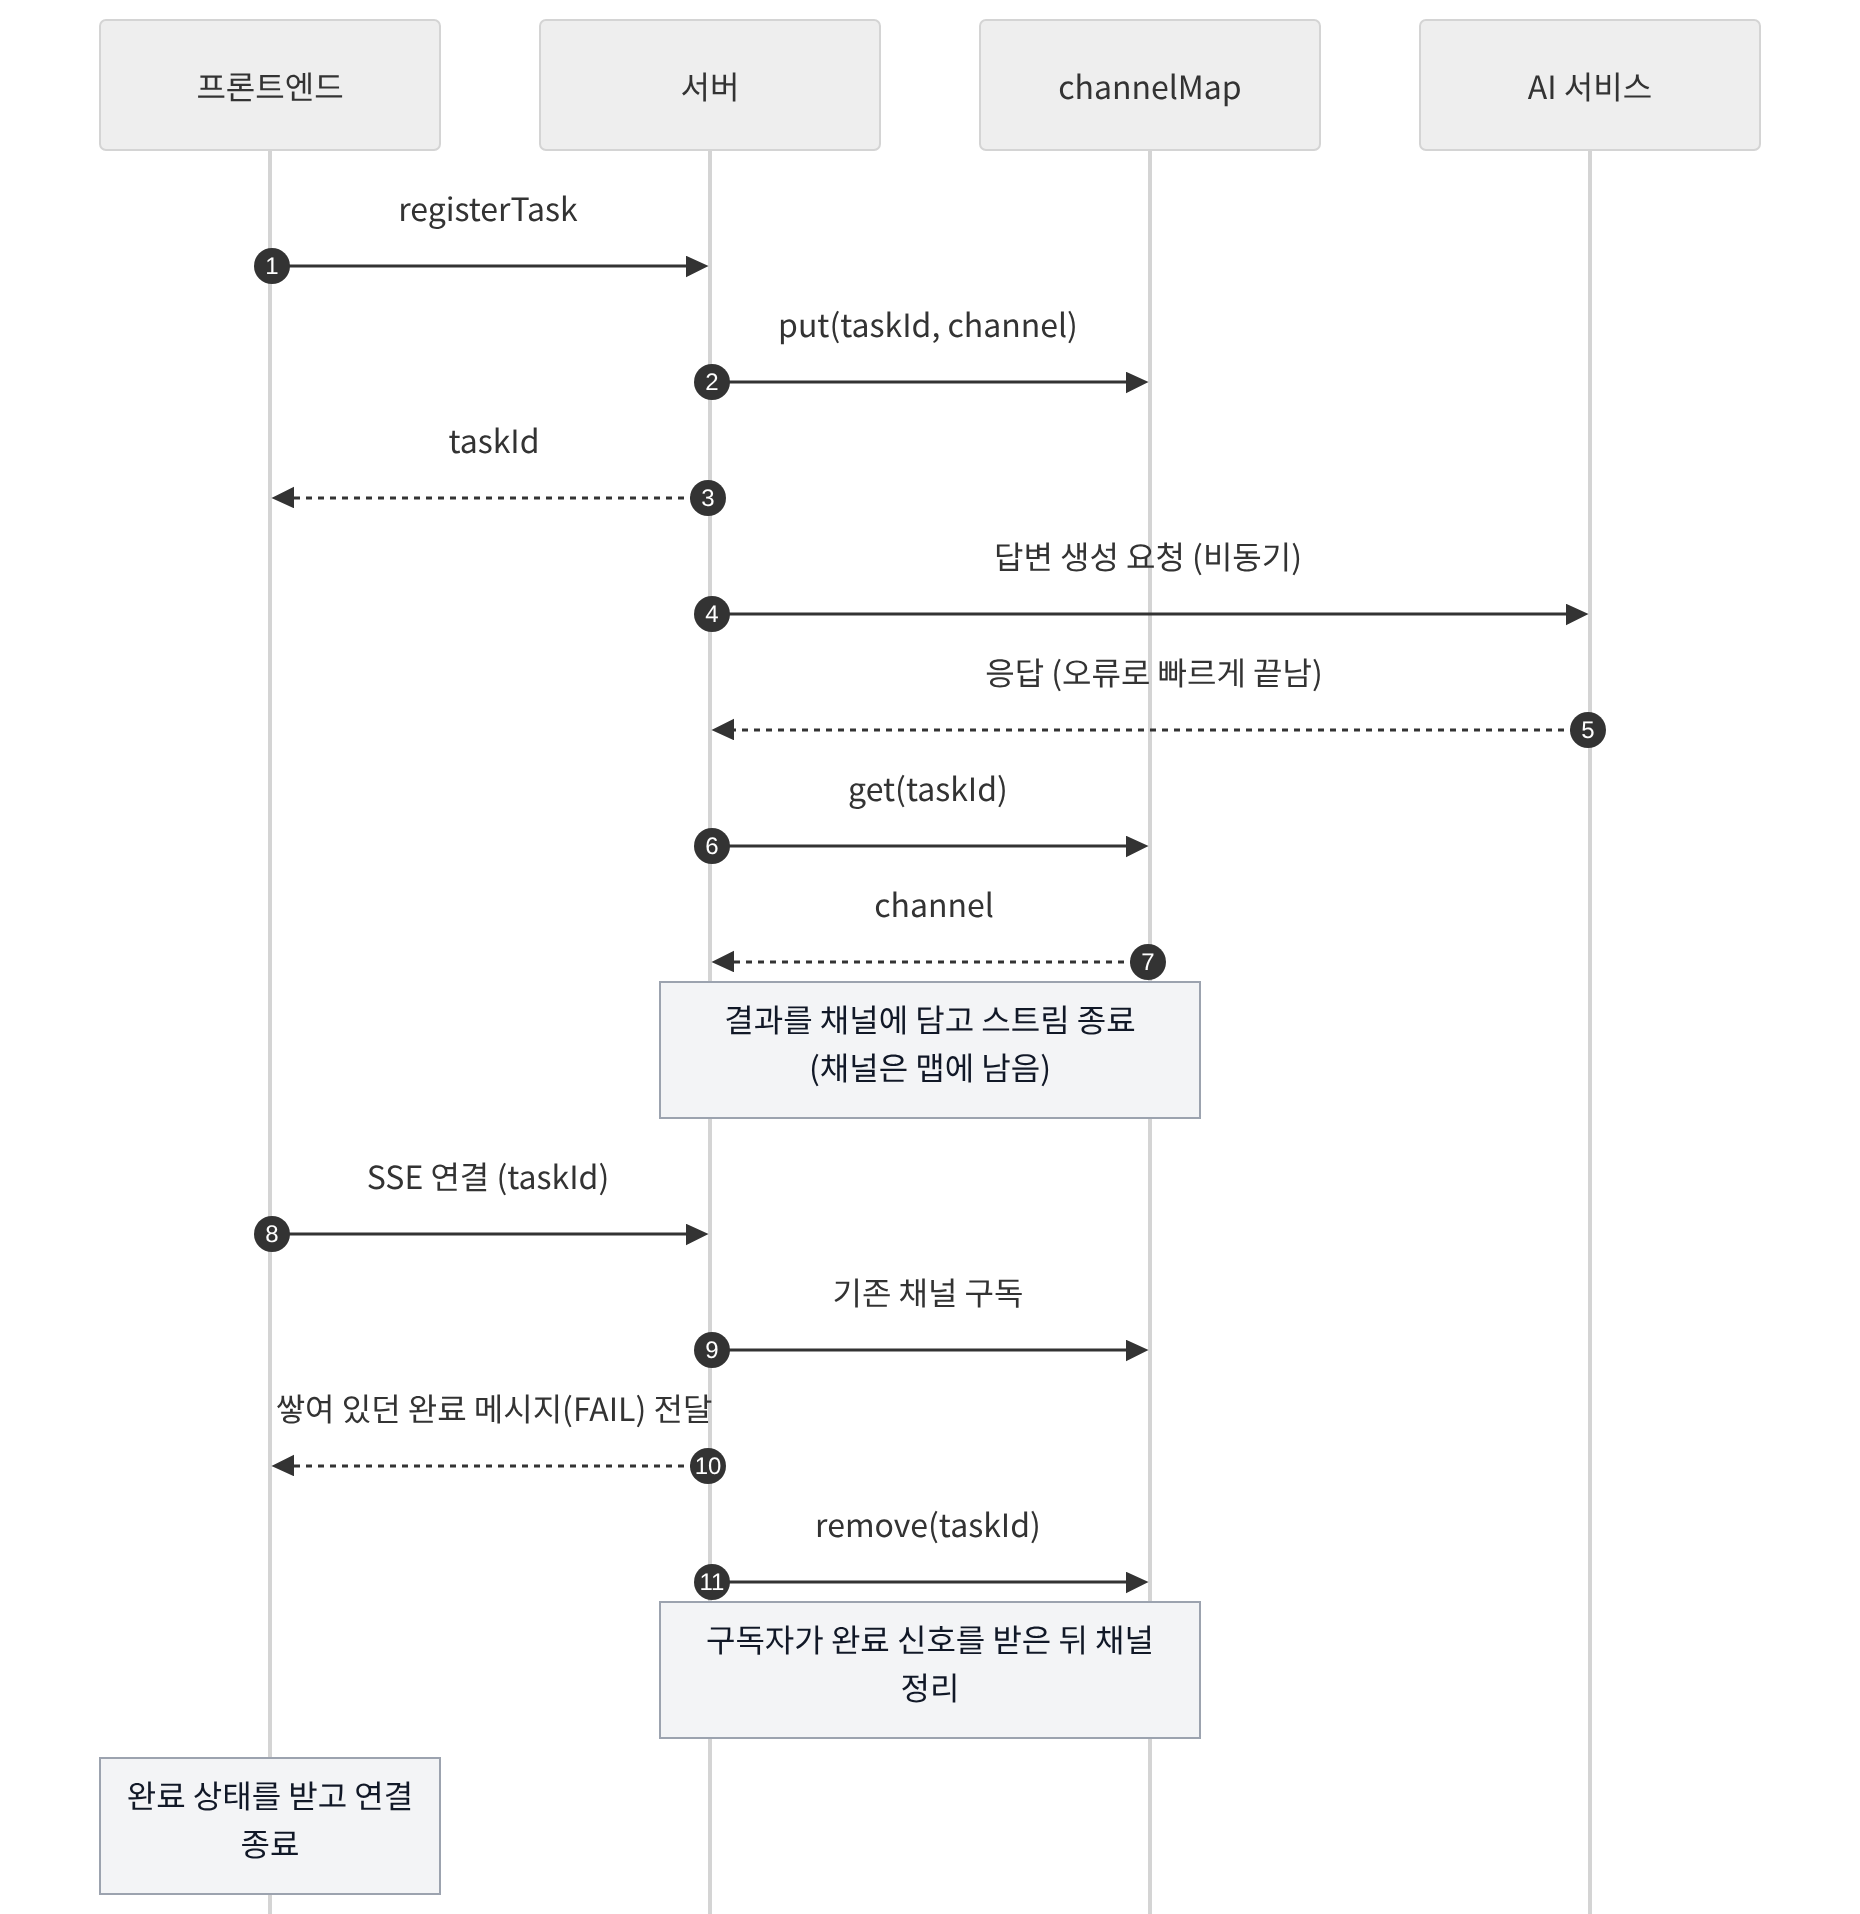
연결이 먼저 되든 AI가 먼저 끝나든, 프론트엔드가 받는 결과는 같아졌습니다.
마치며
SSE 자체보다 크게 남은 건 문제의 범위를 좁혀나가는 방법이었습니다. 처음에는 헤더나 라이브러리 설정처럼 제 쪽 코드부터 의심했지만 API 테스트 도구로 같은 요청을 보내 보니 프론트엔드 문제가 아니라는 게 바로 드러났습니다. 그걸 먼저 확인해두니 백엔드 담당자와 이야기할 때도 어디를 봐야 할지가 분명했습니다.
서버 코드를 함께 따라가면서는 비동기 구조에서 순서가 얼마나 중요한지 알게 됐습니다. 보내는 쪽과 받는 쪽 코드는 각각 문제가 없어 보였지만 받을 채널이 언제 만들어지고 언제 지워지는지가 순서에 따라 달라졌습니다. 프론트엔드에서 연결만 맡더라도 서버가 메시지를 언제, 어디에 담아 보내는지까지 알고 있어야 이런 문제를 빨리 짚을 수 있다는 걸 배웠습니다.
Pong