
1. 들어가며
현재 운영 중인 기존 서비스에서는 데이터가 1분에 한 건씩 생성되어 DB에 저장되고 있습니다. 시간의 흐름에 따라 데이터가 순차적으로 들어오는 구조로, 한 시간을 기준으로 보면 60개의 데이터가 각각의 시점에 맞춰 저장됩니다.
새로운 기능을 개발하면서 같은 테이블에 저장되지만, 기존과는 다른 방식으로 생성되는 데이터를 처리해야 하는 요구사항이 생겼습니다.
새롭게 추가되는 데이터는 외부 서비스에서 지난 1시간의 데이터를 별도로 분석한 결과입니다. 기존에는 1분마다 하나씩 데이터가 들어왔다면, 새로운 기능에서는 분석이 완료된 후 지난 1시간에 해당하는 약 60개의 데이터를 한 번의 API 요청으로 전달받습니다.
서비스 내부에서 시작되어 처리 시점을 통제할 수 있는 작업과 외부에서 들어오는 요청을 동일한 방식으로 처리하는 것이 적절한가?
이번 작업은 이 질문에서 시작했습니다.
2. 문제 정의
처음에는 기존의 데이터 처리 방식을 그대로 활용할 수 있을 것으로 생각했습니다. 기존에도 한 번의 작업에서 1만 건 이상의 데이터를 생성하고, 이를 500건 단위로 나누어 Batch Insert하는 기능을 구현한 경험이 있었기 때문입니다.
한 번에 1만 건 이상의 데이터도 처리하고 있으므로, 요청 한 번에 약 60건의 데이터를 저장하는 것은 같은 방식으로 충분히 처리할 수 있을 것으로 판단했습니다. 실제로 60건이라는 데이터의 양 자체는 문제가 되지 않았습니다.
하지만 기존 작업과 이번 기능을 비교하면서 중요한 차이가 있다는 것을 알게 되었습니다. 기존의 대량 데이터 처리는 서비스 내부에서 시작되는 작업입니다. 작업의 시작 시점과 한 번에 생성되는 데이터의 양을 어느 정도 예상할 수 있으며, 데이터 처리 흐름 역시 서비스 내부에서 통제할 수 있습니다.
반면 새로운 기능에서는 외부 서비스의 분석이 완료된 이후 API를 호출합니다. 요청이 발생하는 시점을 우리 서비스에서 결정할 수 없으며, 여러 분석 작업이 비슷한 시점에 완료된다면 여러 요청이 한꺼번에 들어올 수도 있습니다. 기존과 동일한 동기 방식으로 구현한다면 각각의 요청은 다음 과정을 수행하게 됩니다.
Request → Validation → Transform → Batch Insert → Response하나의 요청만 놓고 보면 문제가 없지만, 요청이 몰리면 각각의 요청에서 데이터 변환과 DB 작업이 동시에 수행됩니다. 결국 두 작업의 차이는 한 번에 처리하는 데이터의 양이 아니었습니다. 기존 작업은 처리 시점과 흐름을 우리 서비스에서 통제할 수 있었지만, 새로운 기능은 외부 요청에 의해 작업이 시작된다는 차이가 있었습니다.
따라서 외부 요청이 들어올 때마다 실제 데이터 처리까지 모두 수행하기보다, 요청을 수신하는 과정과 실제 데이터를 처리하는 과정을 분리하는 방향을 검토했습니다.
3. 해결
최종적으로 외부 요청을 수신하는 Receive 단계와 실제 데이터를 저장하는 Process 단계를 분리하기로 했습니다. 외부 요청에서는 전달받은 데이터를 우선 Payload 형태로 저장하고, 실제 데이터 처리는 별도의 Process에서 수행하도록 구성했습니다.
Payload를 이용한 요청 단위 저장
Receive와 Process를 분리하기 위해서는 외부에서 전달받은 데이터를 실제 처리 시점까지 보관할 방법이 필요했습니다. 한 번의 API 요청으로 전달되는 약 60건의 데이터는 지난 1시간에 대한 하나의 분석 결과입니다.
따라서 각각의 데이터를 별도의 처리 대상으로 저장하기보다는, 하나의 요청을 하나의 작업 단위로 관리하는 것이 적절하다고 판단했습니다. 이를 위해 API를 통해 전달받은 데이터 전체를 JSON String으로 직렬화하여 Payload 테이블의 한 Row에 저장하도록 구성했습니다.
60건의 데이터 → JSON Serialize → Payload 1 Row
이 단계에서는 최종 테이블에 60개의 Row를 생성하지 않습니다. 외부에서 전달받은 요청을 하나의 Payload로 저장하는 것까지만 수행하고, 실제 데이터 처리는 이후 Process 단계에서 수행합니다. 이를 통해 외부 요청이 들어오는 시점에는 비교적 단순한 저장 작업만 수행하고, 데이터 변환과 최종 저장은 별도의 처리 흐름으로 분리할 수 있었습니다.
Timer Event를 통한 데이터 처리
Payload에 저장된 데이터는 1분마다 실행되는 Timer Event를 통해 처리하도록 구성했습니다. 이번에 전달받는 데이터는 외부 서비스에서 지난 1시간의 데이터를 분석한 결과이기 때문에 요청을 받은 즉시 최종 테이블에 반영해야 하는 실시간 데이터는 아니었습니다.
따라서 일정 수준의 처리 지연을 허용할 수 있었습니다. Timer Event가 실행되면 Payload 테이블에서 아직 처리되지 않은 데이터를 조회합니다. 이후 JSON String으로 저장된 데이터를 Deserialize하고, 필요한 데이터 변환 과정을 거쳐 최종 테이블에 저장합니다.
Timer Event → 처리 대상 Payload 조회 → JSON Deserialize → 데이터 변환 → Batch Insert / Upsert최종 데이터를 저장하는 방식 자체는 기존에 사용하던 Batch Insert 방식을 활용했습니다. 달라진 것은 Batch Insert가 실행되는 시점입니다. 외부 API 요청이 들어올 때 바로 최종 데이터를 저장하는 대신, 요청을 Payload로 먼저 받아두고 실제 DB 작업은 내부에서 실행되는 Timer Event가 담당하도록 했습니다. 이를 통해 외부 요청이 들어오는 시점과 실제 데이터를 처리하는 시점을 분리할 수 있었습니다.
Request ID와 데이터 정합성
Receive와 Process를 분리하면서 요청을 식별하고 처리 상태를 추적할 방법도 필요했습니다. 동기 방식에서는 API가 정상적으로 응답하면 데이터 처리까지 완료되었다고 볼 수 있습니다. 하지만 변경된 구조에서는 API 요청이 성공했다는 것이 최종 데이터의 저장까지 완료되었다는 의미는 아닙니다.
따라서 요청을 수신할 때 UUID 형태의 requestId를 생성하여 Payload와 함께 저장하고, API에서는 202 Accepted와 requestId를 반환하도록 구성했습니다. requestId는 개별 데이터를 식별하기 위한 값이 아니라 하나의 요청, 즉 Payload 단위의 작업을 추적하기 위한 값입니다.
또한 외부 API의 특성상 네트워크 문제 등으로 동일한 데이터가 다시 전달되는 경우도 고려해야 했습니다. 동일한 요청이 다시 전달되더라도 새로운 requestId가 생성될 수 있기 때문에 requestId만으로 실제 데이터의 중복 여부를 판단할 수는 없습니다. 따라서 작업을 추적하기 위한 requestId와 실제 데이터의 중복을 판단하기 위한 Unique Key의 역할을 분리했습니다.
requestId → 요청 및 작업의 추적
Unique Key → 실제 데이터의 유일성 보장
최종 데이터를 저장할 때는 별도의 Unique Key를 기준으로 Upsert하여 동일한 데이터가 다시 전달되더라도 중복 Row가 생성되지 않도록 구성했습니다. 이를 통해 비동기로 분리된 각각의 요청을 추적하면서도 최종 데이터의 정합성을 유지할 수 있도록 했습니다.
4. 결론
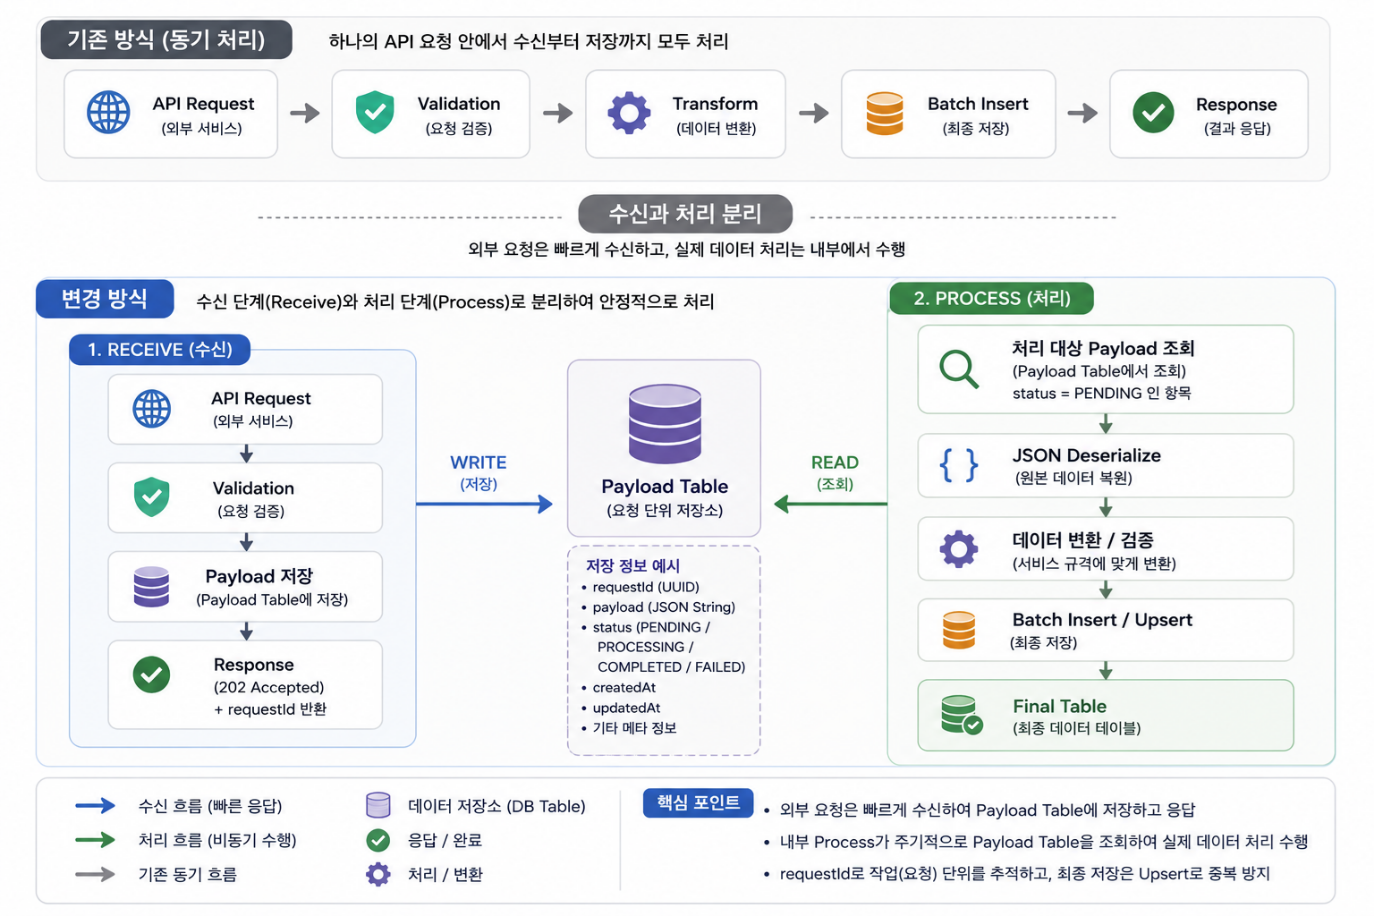
위 내용을 바탕으로 기존에 고려했던 동기 처리 방식과 최종적으로 구성한 처리 방식을 정리하면 다음과 같습니다.
기존에도 한 번의 작업에서 1만 건 이상의 데이터를 생성하고, 이를 500건 단위로 나누어 Batch Insert하는 방식을 사용하고 있었습니다. 따라서 처음에는 요청 한 번에 약 60건의 데이터를 처리하는 이번 기능 역시 기존 방식을 그대로 적용할 수 있을 것으로 생각했습니다. 실제로 데이터의 양만 본다면 충분히 가능한 방법이었습니다.
하지만 기존 작업은 서비스 내부에서 시작되어 실행 시점과 처리 흐름을 통제할 수 있는 반면, 이번 기능은 외부 서비스의 요청에 의해 시작된다는 차이가 있었습니다.
이에 따라 Batch Insert 자체를 변경하기보다 외부 요청의 수신과 실제 데이터 처리를 분리했습니다. 외부 요청은 Payload 형태로 먼저 저장하고, 실제 데이터 변환과 저장은 내부 Process에서 수행하도록 구성했습니다.
같은 데이터를 저장하더라도 데이터가 어떤 방식으로 들어오는지, 작업의 시작 시점을 통제할 수 있는지, 어느 시점까지 처리를 보장해야 하는지에 따라 적절한 처리 방식은 달라질 수 있습니다. 이번 작업을 통해 이러한 차이를 고려한 설계가 중요하다는 점을 다시 확인할 수 있었습니다.
yang