
1. はじめに
現在運用中の既存サービスでは、データが1分に1件ずつ生成され、DBに保存されています。時間の経過に伴ってデータが順番に入ってくる構造で、1時間を基準にすると、60件のデータがそれぞれの時点に合わせて保存されます。
新しい機能を開発するにあたり、同じテーブルに保存されるものの、既存とは異なる方法で生成されるデータを処理する必要が生じました。
新たに追加されるデータは、外部サービスで過去1時間分のデータを別途分析した結果です。従来は1分ごとに1件ずつデータが入ってきていましたが、新機能では分析完了後、過去1時間分に該当する約60件のデータを1回のAPIリクエストで受け取ります。
サービス内部で開始され、処理のタイミングを制御できる処理と、外部から送られてくるリクエストを同じ方法で処理するのが適切なのか。
今回の作業は、この問いから始まりました。
2. 問題の定義
当初は、既存のデータ処理方式をそのまま活用できると考えていました。既存システムでも、1回の処理で1万件を超えるデータを生成し、それを500件単位に分割してBatch Insertする機能を実装した経験があったためです。
1回で1万件を超えるデータも処理しているため、1回のリクエストで約60件のデータを保存することは、同じ方法で十分処理できると判断しました。実際、60件というデータ量自体は問題になりませんでした。
しかし、既存の処理と今回の機能を比較する中で、重要な違いがあることに気付きました。既存の大量データ処理は、サービス内部で開始される処理です。処理の開始時点や一度に生成されるデータ量をある程度予測でき、データ処理の流れもサービス内部で制御できます。
一方、新機能では外部サービスの分析が完了した後にAPIを呼び出します。リクエストが発生するタイミングを自分たちのサービスで決定することはできず、複数の分析処理が近いタイミングで完了すると、複数のリクエストが一度に届く可能性もあります。従来と同じ同期方式で実装すると、それぞれのリクエストで次の処理を実行することになります。
Request → Validation → Transform → Batch Insert → Response1件のリクエストだけを見れば問題ありませんが、リクエストが集中すると、それぞれのリクエストでデータ変換とDB処理が同時に実行されます。結局、2つの処理の違いは一度に処理するデータ量ではありませんでした。既存の処理は、処理のタイミングと流れを自分たちのサービスで制御できましたが、新機能では外部リクエストによって処理が開始されるという違いがありました。
そこで、外部リクエストが届くたびに実際のデータ処理まで全て実行するのではなく、リクエストを受信する処理と実際にデータを処理する処理を分離する方向で検討しました。
3. 解決策
最終的に、外部リクエストを受信するReceive段階と、実際にデータを保存するProcess段階を分離することにしました。外部リクエストでは、受け取ったデータをまずPayload形式で保存し、実際のデータ処理は別のProcessで行う構成にしました。
Payloadを利用したリクエスト単位の保存
ReceiveとProcessを分離するには、外部から受け取ったデータを実際の処理時点まで保持する方法が必要でした。1回のAPIリクエストで送られてくる約60件のデータは、過去1時間分に対する1つの分析結果です。
そのため、個々のデータを別々の処理対象として保存するよりも、1つのリクエストを1つの処理単位として管理するのが適切だと判断しました。そのため、APIで受け取ったデータ全体をJSON Stringにシリアライズし、Payloadテーブルの1つのRowに保存する構成にしました。
60件のデータ → JSON Serialize → Payload 1 Row
この段階では、最終テーブルに60個のRowを生成しません。外部から受け取ったリクエストを1つのPayloadとして保存するところまでを行い、実際のデータ処理はその後のProcess段階で実行します。これにより、外部リクエストを受け取るタイミングでは比較的単純な保存処理だけを行い、データ変換と最終保存を別の処理フローに分離できました。
Timer Eventによるデータ処理
Payloadに保存されたデータは、1分ごとに実行されるTimer Eventを通じて処理する構成にしました。今回送られてくるデータは、外部サービスが過去1時間分のデータを分析した結果であるため、リクエストを受け取った直後に最終テーブルへ反映しなければならないリアルタイムデータではありませんでした。
そのため、一定レベルの処理遅延を許容できました。Timer Eventが実行されると、Payloadテーブルからまだ処理されていないデータを取得します。その後、JSON Stringとして保存されたデータをDeserializeし、必要なデータ変換処理を経て最終テーブルに保存します。
Timer Event → 처리 대상 Payload 조회 → JSON Deserialize → 데이터 변환 → Batch Insert / Upsert最終データの保存方法自体は、従来使用していたBatch Insert方式を活用しました。変わったのは、Batch Insertを実行するタイミングです。外部APIリクエストが届いた時点ですぐに最終データを保存するのではなく、リクエストをまずPayloadとして受け取り、実際のDB処理は内部で実行されるTimer Eventが担当するようにしました。これにより、外部リクエストが届くタイミングと、実際にデータを処理するタイミングを分離できました。
Request IDとデータ整合性
ReceiveとProcessを分離するにあたり、リクエストを識別し、処理状態を追跡する方法も必要でした。同期方式では、APIが正常に応答すれば、データ処理まで完了したと見なすことができます。しかし、変更後の構成では、APIリクエストが成功したことが最終データの保存まで完了したことを意味するわけではありません。
そのため、リクエストを受信した際にUUID形式のrequestIdを生成してPayloadとともに保存し、APIでは202 AcceptedとrequestIdを返す構成にしました。requestIdは個々のデータを識別するための値ではなく、1つのリクエスト、つまりPayload単位の処理を追跡するための値です。
また、外部APIの特性上、ネットワーク障害などによって同じデータが再度送信される場合も考慮する必要がありました。同じリクエストが再送されても新しいrequestIdが生成される可能性があるため、requestIdだけで実際のデータの重複有無を判断することはできません。そこで、処理を追跡するためのrequestIdと、実際のデータの重複を判定するためのUnique Keyの役割を分離しました。
requestId → 요청 및 작업의 추적
Unique Key → 실제 데이터의 유일성 보장
最終データを保存する際は、別途設定したUnique Keyを基準にUpsertし、同じデータが再度送信されても重複したRowが生成されないようにしました。これにより、非同期に分離された各リクエストを追跡しながら、最終データの整合性も維持できるようにしました。
4. 結論
以上の内容を踏まえ、当初検討していた同期処理方式と、最終的に構成した処理方式を整理すると、次のようになります。
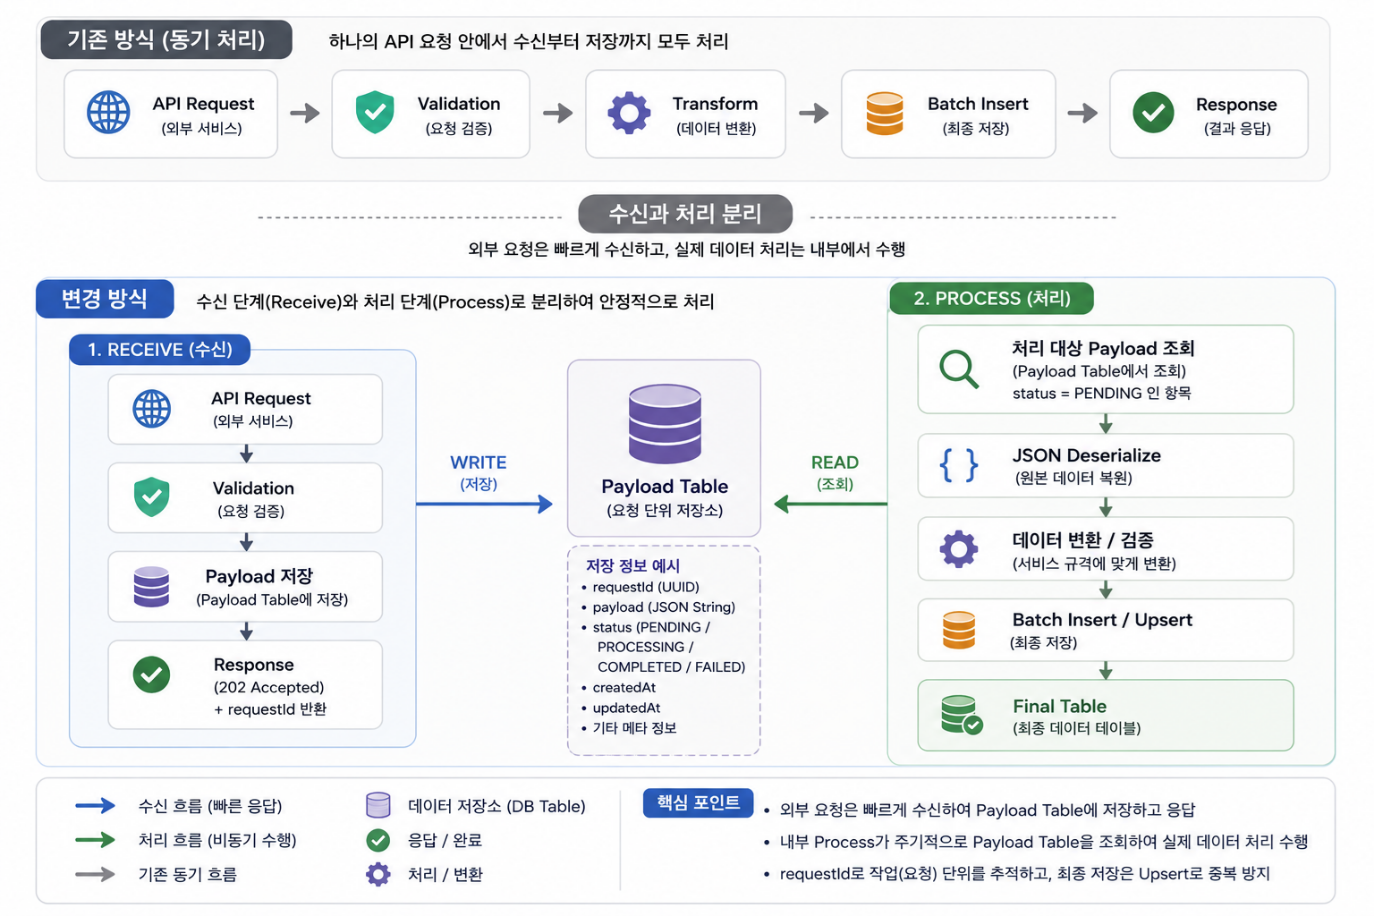
従来も、1回の処理で1万件を超えるデータを生成し、それを500件単位に分割してBatch Insertする方式を使用していました。そのため当初は、1回のリクエストで約60件のデータを処理する今回の機能にも、既存方式をそのまま適用できると考えていました。実際、データ量だけを見れば十分に可能な方法でした。
しかし、既存の処理はサービス内部で開始されるため、実行タイミングや処理の流れを制御できる一方、今回の機能は外部サービスからのリクエストによって開始されるという違いがありました。
そこで、Batch Insert自体を変更するのではなく、外部リクエストの受信と実際のデータ処理を分離しました。外部リクエストはまずPayload形式で保存し、実際のデータ変換と保存は内部のProcessで行う構成にしました。
同じデータを保存する場合でも、データがどのような方法で届くのか、処理の開始時点を制御できるのか、どの時点まで処理を保証する必要があるのかによって、適切な処理方式は異なる可能性があります。今回の作業を通じて、このような違いを考慮した設計が重要であることを改めて確認できました。
yang