
TPS超過によるサーバーダウン
船上で収集したデータを陸上のデータレイクへ再送するパイプラインを構築している途中で、限界テストを実施する必要が生じました。船上のPodが保持していたメッセージを陸上のデータレイクへ再送するには、EMQXとCCMDという2つの中継区間を必ず通過する必要がありました。これらの区間には、1秒あたりに処理できるメッセージ数、つまりTPSの制限が設定されていたためです。
複数の船上では通信環境が不安定で、データが届かないことが頻繁にあり、データレイク側ではバッチによって受信できなかったデータをまとめて再要求するように設計されていました。通常時のトラフィックだけを見ると制限TPSを大きく下回っていますが、バッチ処理が動く短い瞬間には、その数倍に達するメッセージが同時に押し寄せます。平均流入量を基準に設計されたパイプラインがこの瞬間に耐えられなければ、中継区間のサーバーはダウンし、メッセージはエラーひとつ表示されないまま静かに失われます。
結局、この状況で必要だったのは「このパイプラインは1秒あたり何件まで処理できるのか」ではなく、「瞬間的に集中したとき、どこから先に崩れ、どれくらいで回復するのか」という答えでした。一定の負荷を長時間維持する一般的な負荷テストではこの問いに答えられなかったため、選択したのがスパイクテスト(Spike Test)でした。
そこで、スパイクテストとは何か
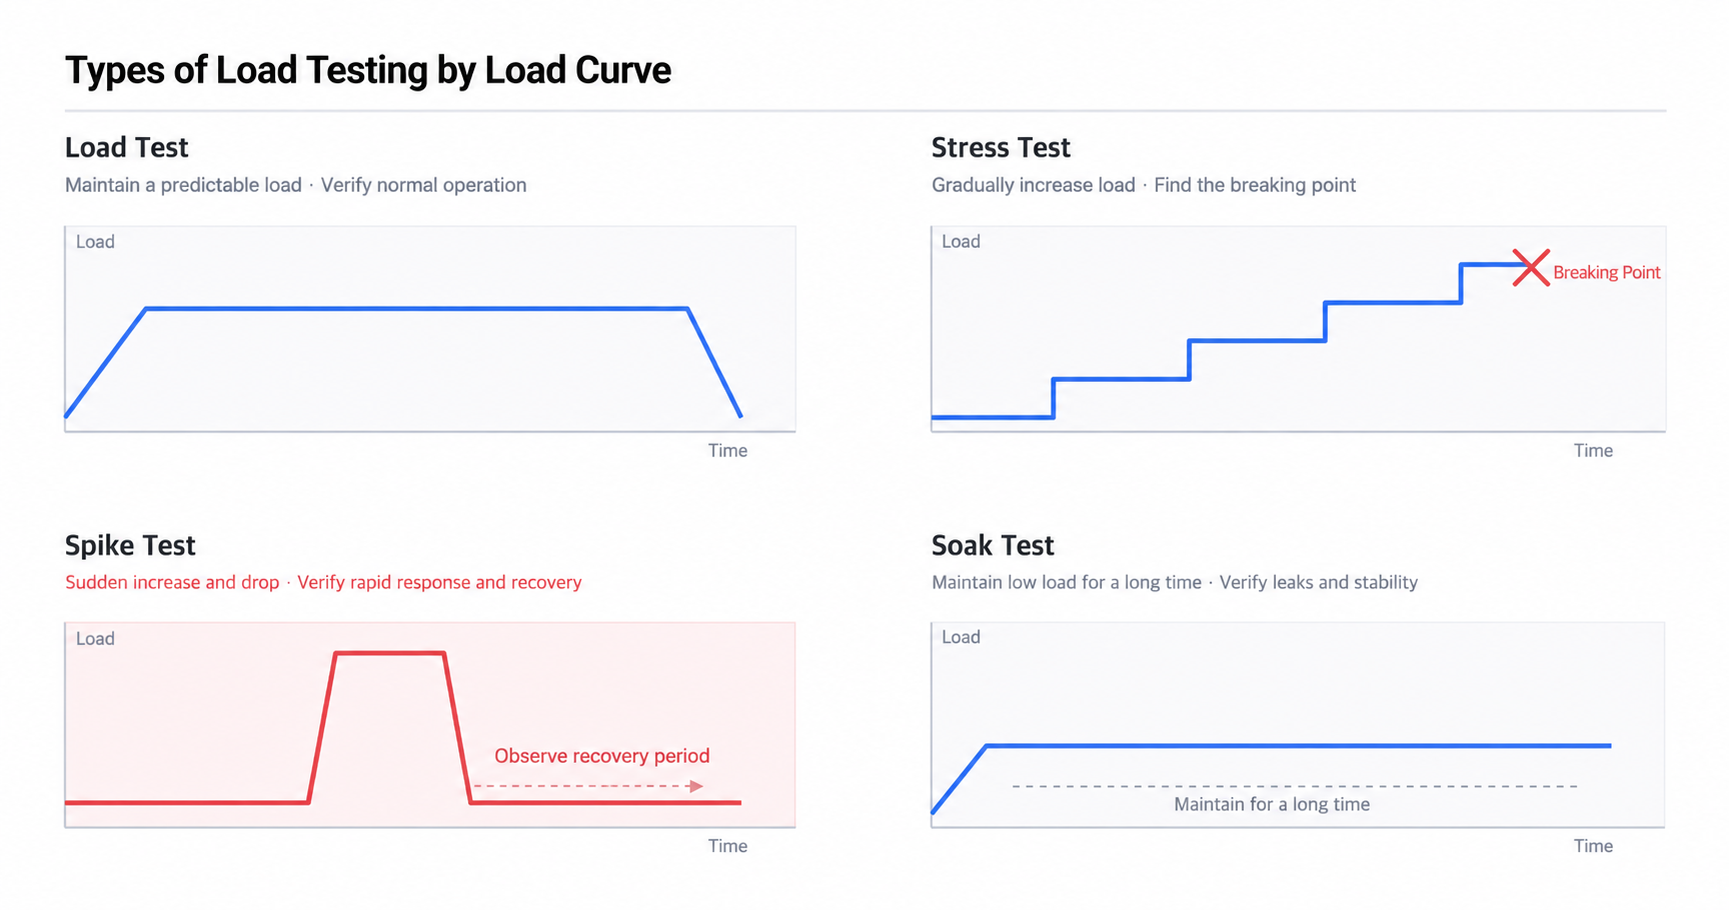
本格的なテスト設計を見る前に、スパイクテストが他の負荷テストと何が異なるのかを確認しておく必要があります。負荷テストは、負荷をどのような形で与えるかによって大きく4種類に分けられます。Load Testは想定される通常時の負荷を一定に維持し、正常に処理できるかを確認します。Stress Testは負荷を徐々に引き上げ、システムが崩れる限界点を探します。Soak Testは低い負荷を長時間維持し、メモリリークやリソース枯渇のように時間の経過によって初めて明らかになる問題を確認します。
これに対してSpike Testは、短時間で負荷を急激に引き上げた後、再び急激に低下させる形式のテストです。最大処理量そのものではなく、急激な変化に対する反応と回復力に関心がある点が、他の手法との決定的な違いです。負荷が急上昇した瞬間にキューがどの程度滞留するのか、エラー率やデータ欠損がどの時点から発生するのか、そして負荷がなくなった後に元の状態へ戻るまでどれくらいかかるのかを確認します。
再発行トラフィックは、定義上スパイクの形状をしています。通常は低い水準で推移し、再接続の時点だけ垂直に急上昇し、滞留していたメッセージをすべて流し終えると再び元の水準まで低下します。実際のトラフィックがこのような形状であるなら、テストも同じ形状にしてこそ意味のある結果を得られます。
再発行経路とボトルネック箇所
テスト対象となった経路は、船上のPodから始まり、EMQXとCCMDを経由して陸上のデータレイクへ続く区間です。船上のPodが保持していたメッセージをEMQXへ発行すると、CCMDがそれを受け取って陸上区間へ中継し、最終的にデータレイクへ格納される構造です。複数の区間が直列に接続されたパイプラインでは、全体の処理量を決めるのは平均値ではなく、最も低い上限を持つ区間です。この経路では、TPS制限が設定された中継区間がその役割を担います。
制限TPSを超えたときに現れるパターンも、あらかじめ整理しておく必要がありました。超過分がスロットリングされて遅延が蓄積する場合、queueに継続的に滞留してバックプレッシャーが発生する場合、そして最悪の場合には接続が切断されたり、メッセージがドロップされたりする場合まで考えられます。特に厄介なのは、発行側では正常に送信したと記録される一方で、実際にはデータレイクまで到達しないケースです。このような欠損は発行側のログだけでは決して明らかにならないため、発行件数と最終受信件数を照合する検証を必ず併せて行う必要がありました。
テスト設計
スパイクテストで確認したかったことは3つありました。1つ目は、制限TPSを超えた瞬間に、どの区間でどのような形で問題が現れるのか。2つ目は、データ欠損なしに通過できる実質的な上限がどこなのか。3つ目は、スパイクが過ぎた後、滞留が解消されて正常な状態に戻るまでにかかる回復時間がどれくらいなのか、ということです。
負荷曲線は、実際の再接続状況をそのまま模して構成しました。通常時の水準であるbaselineをしばらく維持した後、短時間で目標TPSの数倍まで垂直に引き上げ、その状態を一定時間維持してから、再びbaselineへ急激に低下させ、回復過程を観察する形式です。このとき上昇区間を長く設定すると、負荷が緩やかに増加して実質的にStress Testになってしまうため、上昇区間は意図的に短く保つことが重要です。
観測指標は区間ごとに分けて収集しました。発行側では実際の発行TPSと成功・失敗応答を、中継区間ではEMQXのinflightおよびqueuedメッセージ数と、CCMDの処理遅延およびエラー率を、受信側ではデータレイクの受信件数を確認しました。さらに、発行時点のタイムスタンプとシーケンス番号をメッセージに併せて付与し、エンドツーエンドの遅延率と欠損率を同時に算出できるようにしました。
スパイクテストの実施方法
スパイクテストは、k6、JMeter、Gatlingなどの負荷テストツールで実施できます。ただし、TPS制限の検証が目的であれば、仮想ユーザー数ではなく、1秒あたりのリクエスト数を直接制御できるツールを選ぶことが重要です。仮想ユーザー数を基準に負荷をかけると、応答が遅くなるほど実際の発行量も同時に減少し、本来確認したい超過区間を作れなくなるためです。
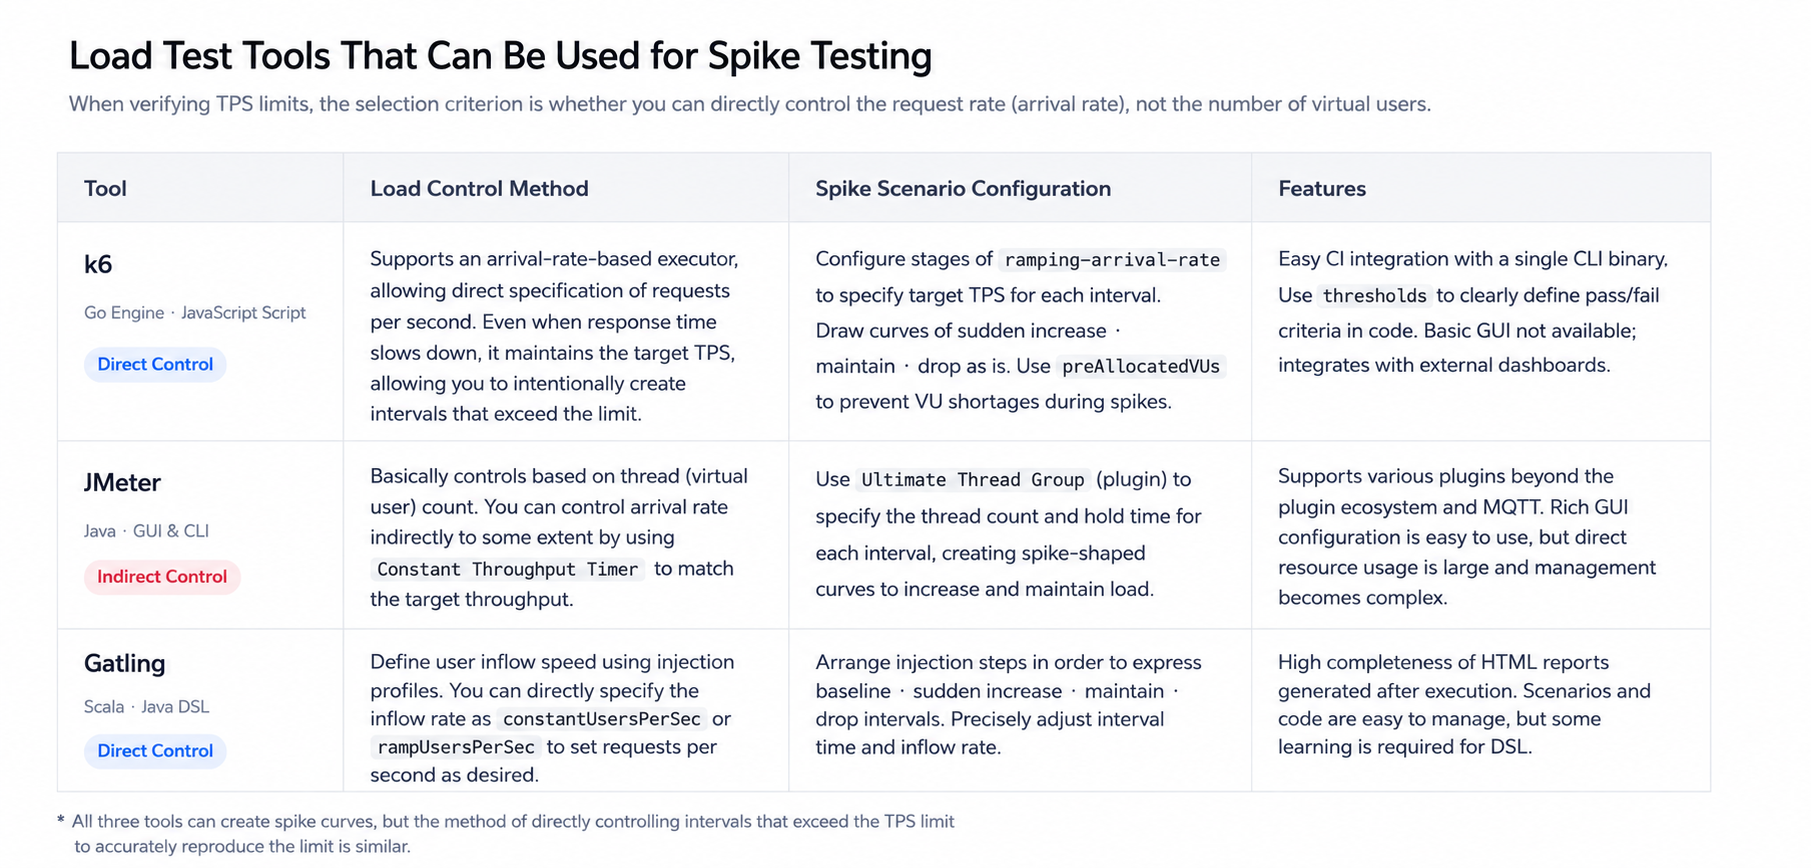
k6を使用する場合は、ramping-arrival-rate executorがこの目的に最も適しています。stagesで区間ごとの目標TPSを直接指定できるため、baselineとスパイク区間を意図した形で描くことができます。また、preAllocatedVUsとmaxVUsを十分に確保しておけば、負荷が急上昇した瞬間に仮想ユーザーの新規作成に時間がかかり、実際の上昇が鈍る現象を防げます。JMeterを使用する場合は、Ultimate Thread GroupとConstant Throughput Timerを組み合わせることで、同じ形の曲線を作成できます。
テストを実施する際に注意すべき点は、負荷生成器自体がボトルネックにならないようにすることです。負荷生成器を対象システムと同じノードで実行したり、コネクションプールが不足した状態にしたりすると、中継区間ではなくテストツールが先に限界へ達し、実際とは異なる結果を確認することになります。また、スパイクが終了した直後にテストを終了せず、baseline状態を数分間維持する必要があります。そうすることで、滞留したメッセージが解消される回復過程まで観測できます。
スパイク区間で明らかになった再発行ロジックの問題
再接続後に一部のメッセージが失われていた問題状況を想定して設計したシナリオでスパイクテストを実施したところ、制限TPSを超えた区間から、発行側には正常な送信として記録される一方で、データレイクには最後まで到達しないメッセージが発生することを確認しました。シーケンス番号を照合した結果、欠損はスパイク区間の中でも特定の時点以降に集中して発生していました。
本来であれば中継区間が処理できる速度に合わせて流れるはずのメッセージが、なぜ一度に集中するのかを確認するために再発行ロジックを調査したところ、保持していたメッセージを速度制御なしの逐次ループで直ちに全件発行していることが分かりました。さらに問題だったのは、失敗したメッセージを直ちに再試行するようになっていたことです。そのため、すでに飽和状態にある中継区間へ再試行トラフィックまで加わり、状況を自ら悪化させていました。
結局、通信が復旧した瞬間に滞留していたメッセージが制限TPSの数倍に達する速度で一気に流れ込み、中継区間が飽和しました。スロットリングによる遅延と即時再試行が重なって滞留が雪だるま式に膨らみ、一部のメッセージが失われる状況につながっていたのです。
幸い、この事実をスパイクテストの過程で発見できました。再発行区間にトークンバケット方式のレート制限を設け、制限TPSを下回る速度でメッセージが均一に流れるよう改善しました。また、失敗時には指数バックオフで再試行するよう変更し、瞬間的なフラッシュが中継区間を崩壊させる状況を防げるようにしました。改善後、同じシナリオで再度テストしたところ、欠損なく全件がデータレイクに格納され、スパイク通過後に滞留が解消されるまでの時間も予測可能な範囲に収まりました。
おわりに
スパイクテストは、「このシステムはどれほど速いのか」ではなく、「予期せぬ瞬間にどのように耐え、どれほど速く元の状態へ戻れるのか」を確認するためのツールです。平均トラフィックだけを見て設計されたシステムは、通常時には問題なく動作することが多いため、瞬間的なフラッシュによって現れる脆弱性は、運用中の障害として直面するまでなかなか明らかになりません。
再発行や再試行のように、本質的にバーストを生み出すロジックを持ち、その前段にTPS制限のある区間が置かれているシステムであれば、機能検証を終えた時点で、必ず一度は実施すべきテストとして考えるとよいでしょう。
jungboke