
1. はじめに
運用中のPostgreSQLデータベースでCPU使用率が100%の状態が続く事態が発生し、原因を掘り下げてみると、その中心にはautovacuumがありました。普段はほとんど気にすることのないバックグラウンドプロセスだと思っていましたが、この問題をきっかけに、autovacuumがどのような仕組みで動作し、なぜlock競合まで引き起こす可能性があるのかをある程度理解できました。ここでは、実際に経験した問題をまず整理し、その分析と解決の過程で分かったautovacuumとlockについてまとめます。
2. 何が起きたのか
トラフィックが集中する時間帯にバックグラウンドのクリーンアップ処理が遅延し、特定のテーブルのxid年齢が徐々に蓄積していました。最終的にある時点でしきい値を超えたため、PostgreSQLは自動的にautovacuumを1つ強制実行しました。そして、折悪しくその時点でデータの一部に問題があったテーブルをこのプロセスが処理することになり、なかなか終了せず、長時間CPUを占有する状況につながりました。
最初は単純なトラフィックの急増や非効率なクエリが原因だと思っていましたが、確認してみると、原因ははるかに根本的なところにありました。実行中のクエリを調べたところ、CPUを占有していたのは一般的なアプリケーションのクエリではなく、「autovacuum: VACUUM ... (to prevent wraparound)」という形式のautovacuumでした。調べてみると、これはトランザクションIDのwraparoundを防ぐためにPostgreSQLが強制実行したものであり、一般的な方法(プロセスの終了、autovacuumの無効化)では停止できないプロセスでした。
この過程で状態がどのように変化したのかを簡単にまとめると、次のとおりです。
|
区間 |
状態 |
|---|---|
|
平常時 |
正常運用、xid_ageは正常範囲 |
|
問題の蓄積区間 |
バックグラウンドのクリーンアップ処理が遅延 → xid_ageがしきい値に接近 |
|
障害発生時点 |
wraparound防止autovacuumを強制実行、問題のあるテーブルを処理中に停滞 → CPU使用率100%が継続 |
|
対応完了後 |
しきい値を元に戻し、CPU使用率とサービスが正常化 |
対応は大きく3段階で進めました。まず、CPUを占有しているプロセスがwraparound防止autovacuumであることを確認しました。前述のとおり、このモードは一般的な方法では停止できないため、プロセスを直接終了する代わりに、しきい値の設定を一時的に引き上げ、該当テーブルが強制実行の対象から除外されるようにしました。その後、CPU使用率が正常な水準まで低下したことを確認してから、問題のあったテーブルをバックアップおよび初期化し、根本的な破損を整理しました。最後に、一時的に引き上げていた設定値を元に戻し、CPUとサービスの状態を再確認して対応を完了しました。
-- 1) 원인 진단: CPU를 점유 중인 프로세스 확인
SELECT pid, query FROM pg_stat_activity WHERE state = 'active';

-- 2) 긴급 조치: wraparound 방지 대상에서 제외되도록 임계값 임시 상향
ALTER SYSTEM SET autovacuum_freeze_max_age = 500000000;

-- 3) 문제 테이블 정리 후 임시 설정 원복
TRUNCATE TABLE target_table;
ALTER SYSTEM SET autovacuum_freeze_max_age = 200000000;
1番の検索結果のquery値に「autovacuum: VACUUM ... (to prevent wraparound)」という文言が付いているかどうかが、重要な判断基準です。この文言があれば、一般的なautovacuumではなく、強制実行されたwraparound防止モードを意味します。前述のとおり、プロセスを直接終了しても効果はありません。反対に、この文言がなく「autovacuum: VACUUM ...」だけが表示されている場合は、通常のクリーンアップ処理なので、過度に心配する必要はありません。
3. Autovacuumとは
3.1 Autovacuumとは何をするプロセスなのか
PostgreSQLはUPDATEやDELETEが発生しても、既存の行をすぐには削除せず、dead tupleという形で残す仕組みを使用します(MVCC)。Autovacuumは、このように蓄積したdead tupleを整理し、トランザクションIDを再利用できるようにfreeze処理を行うバックグラウンドプロセスです。一見するとDBAの領域のように感じられますが、実際にはアプリケーションが生成するクエリパターンやトランザクションの利用方法が、autovacuumの負荷やlock競合に直接影響します。そのため、開発者の立場でも最低限の動作原理を知っておくと役立ちます。
|
用語 |
説明 |
|---|---|
|
dead tuple |
UPDATE/DELETEによって、もはや有効ではないものの、まだ物理的には削除されずに残っている行です。 |
|
MVCC |
複数のトランザクションが異なる時点のデータを同時に参照できるようにする、PostgreSQLの同時実行制御方式です。 |
|
autovacuum |
dead tupleを整理し、トランザクションIDをfreeze処理するPostgreSQLのバックグラウンド自動クリーンアッププロセスです。 |
|
xid / wraparound |
PostgreSQLは32ビットのトランザクションID(xid)を使用しており、古いxidを整理しないとIDが循環(wraparound)し、データの整合性が損なわれる可能性があります。 |
|
lock |
複数のセッションが同じ対象に同時にアクセスする際、整合性を保つために取得するロックです。要求の種類に応じて異なるレベルのlockが使用されます。 |
3.2 xid_ageはなぜ、どのように蓄積するのか — Wraparound防止Autovacuum
xid_ageはトランザクションが発生するたびに増加し続けます。これを低下させる唯一の方法は、autovacuumが対象テーブルに対するfreeze処理を最後まで完了することだけです。しかし、書き込みトラフィックが多く、xid_ageが蓄積する速度は速い一方で、I/O競合や処理遅延によってautovacuumが適切なタイミングで完了できない状況が重なると、蓄積する速度と解消する速度の差が広がり続けます。この差が縮まらず、トランザクションID(xid)の年齢が最終的にしきい値を超えると、PostgreSQLはwraparoundを防ぐために対象テーブルに対するautovacuumを強制実行します。このモードはデータの整合性を守るための最後の防衛線であるため、一般的な方法(プロセスの終了、autovacuumの無効化)では停止できません。今回の問題でも、問題のあったテーブルと重なったことで、長時間リソースを占有し、サービスに影響を及ぼす状況へと発展しました。
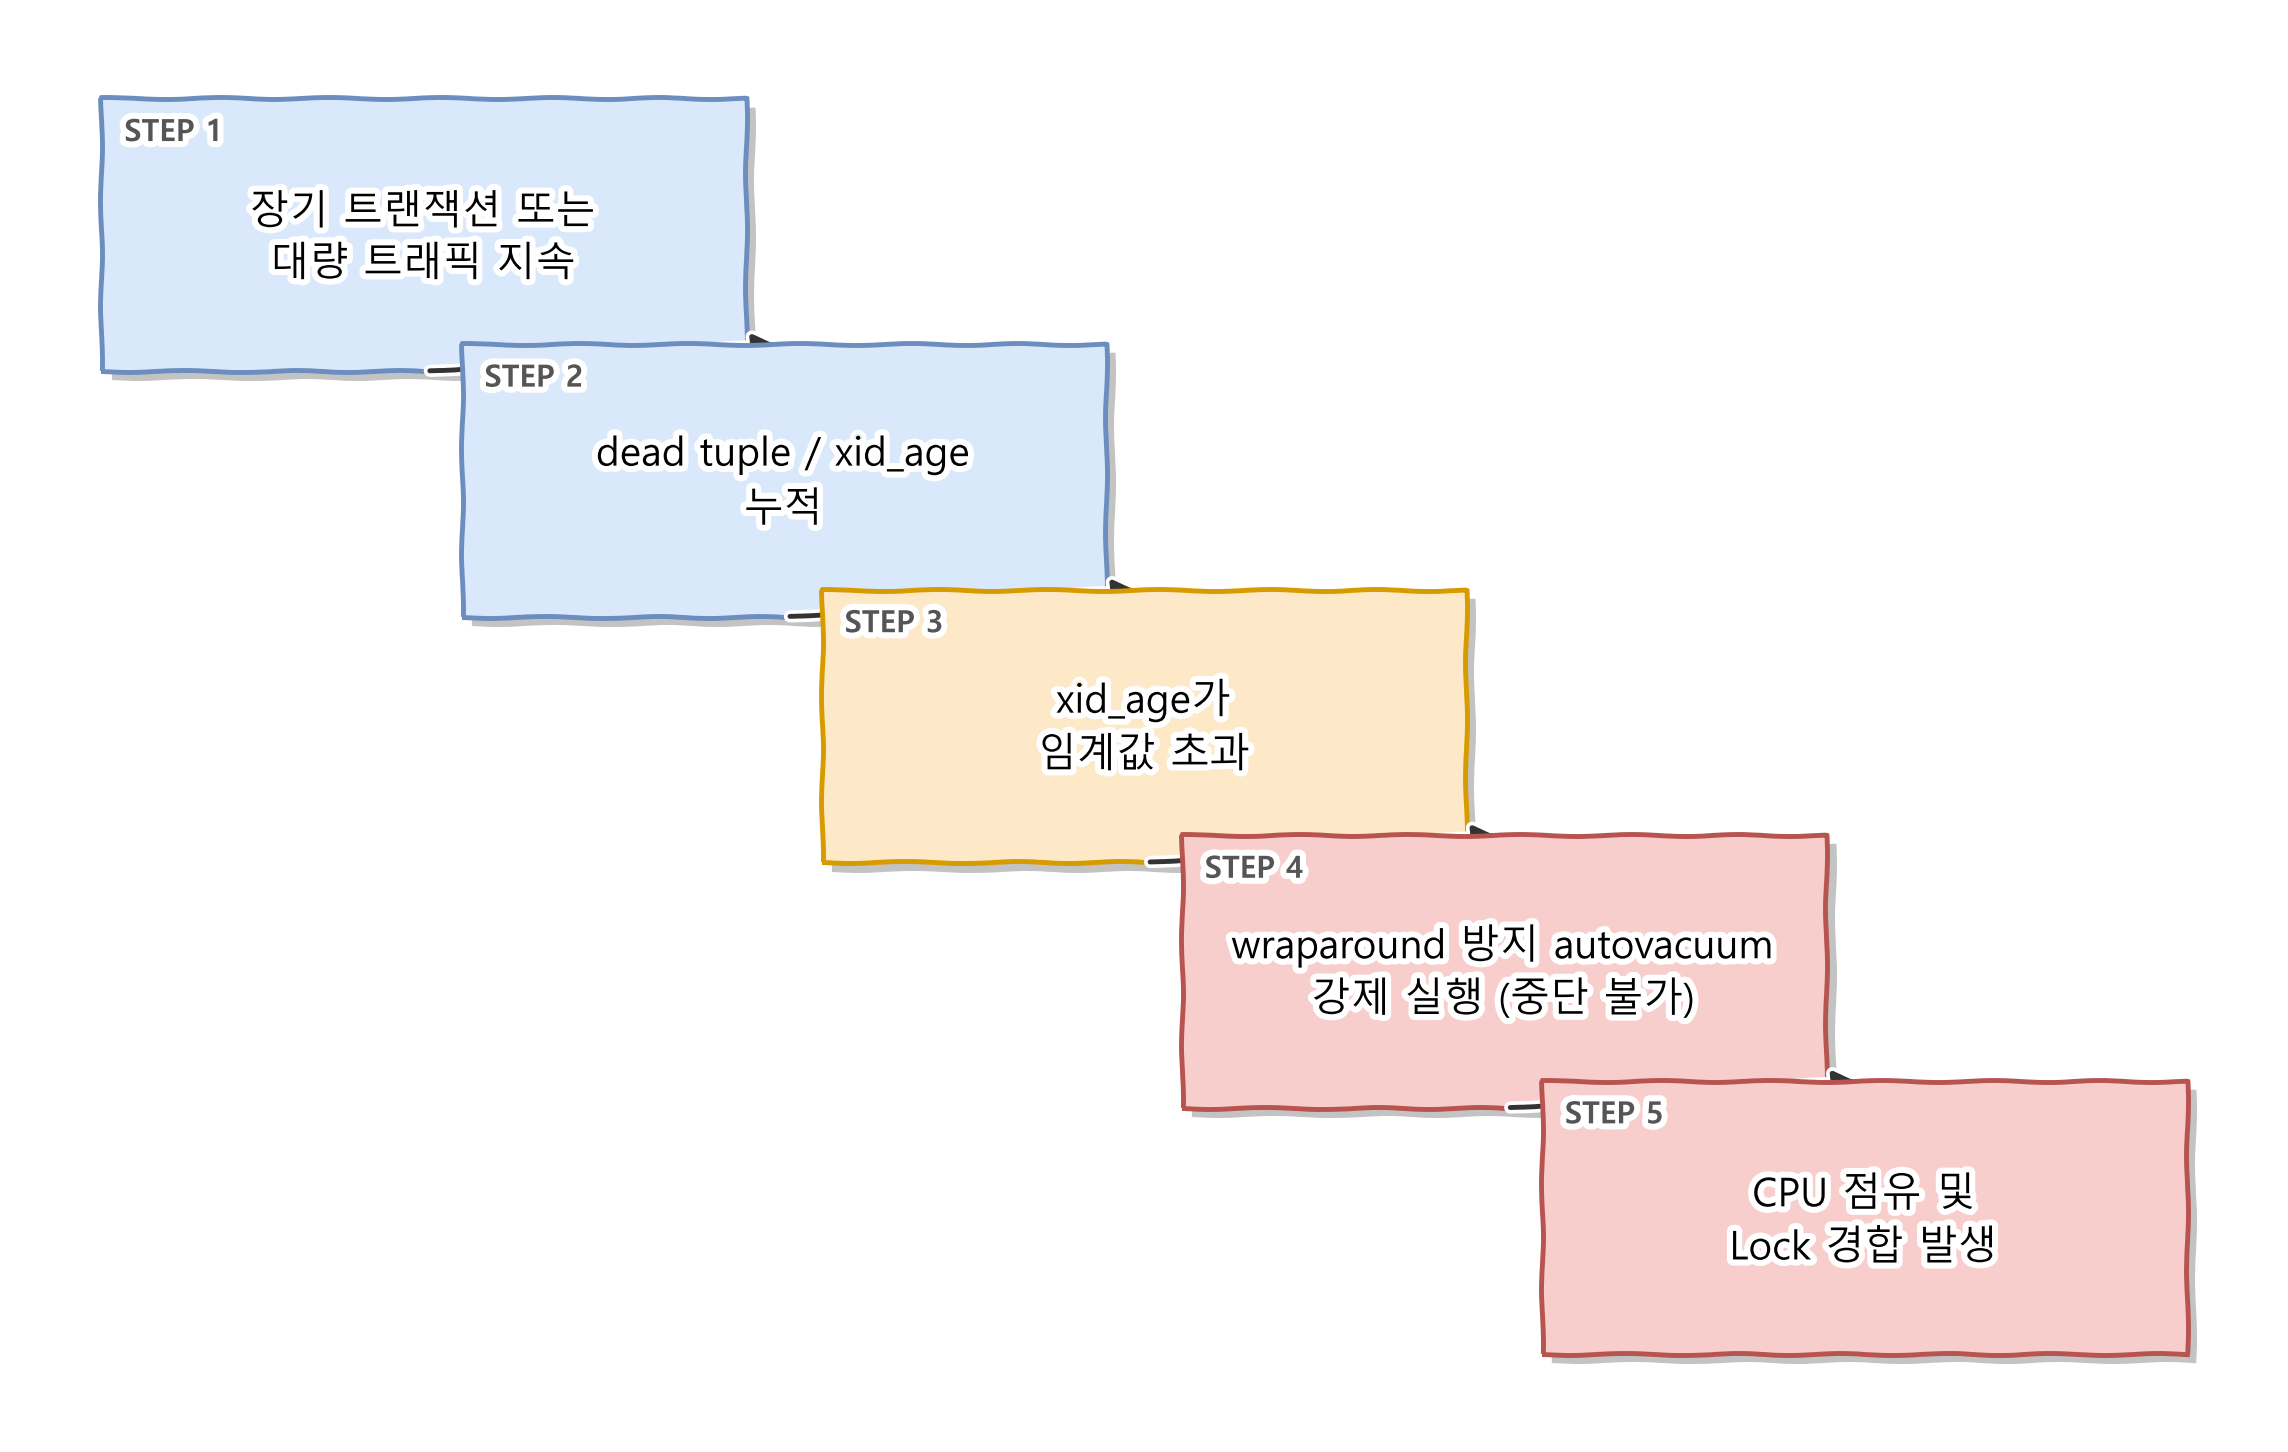
図 1. Wraparound防止Autovacuumまでの段階
4. Autovacuumが引き起こす可能性のある別のLock競合の状況
今回の問題の直接的な原因ではありませんでしたが、この出来事をきっかけに、autovacuumがlock競合を引き起こす可能性のある別の状況についても整理してみました。
4.1 一般的なautovacuumとDDLの衝突
一般的なautovacuumはSHARE UPDATE EXCLUSIVEという比較的軽いlockだけを使用するため、通常のSELECT / INSERT / UPDATEなどのクエリとは、ほとんどの場合問題なく共存できます。問題は、デプロイ中のALTER TABLEのようにACCESS EXCLUSIVE lockを要求するDDLを実行する際に発生します。autovacuumがすでに対象テーブルを処理している場合、DDLはautovacuumが終了するまで待機することになります。さらに、その後に入ってくる通常のクエリまで次々と待機状態に陥ります。「デプロイ中に突然サービスが停止した」という現象のよくある原因の1つが、まさにこれです。
|
Lockモード |
代表的な使用例 |
autovacuumとの関係 |
|---|---|---|
|
ACCESS SHARE |
SELECT |
競合なし |
|
ROW EXCLUSIVE |
INSERT / UPDATE / DELETE |
競合なし |
|
SHARE UPDATE EXCLUSIVE |
autovacuum, CREATE INDEX CONCURRENTLY |
同一モード同士の競合(同時実行不可) |
|
ACCESS EXCLUSIVE |
ALTER TABLE, DROP TABLE, TRUNCATE |
競合(autovacuumの終了まで待機) |
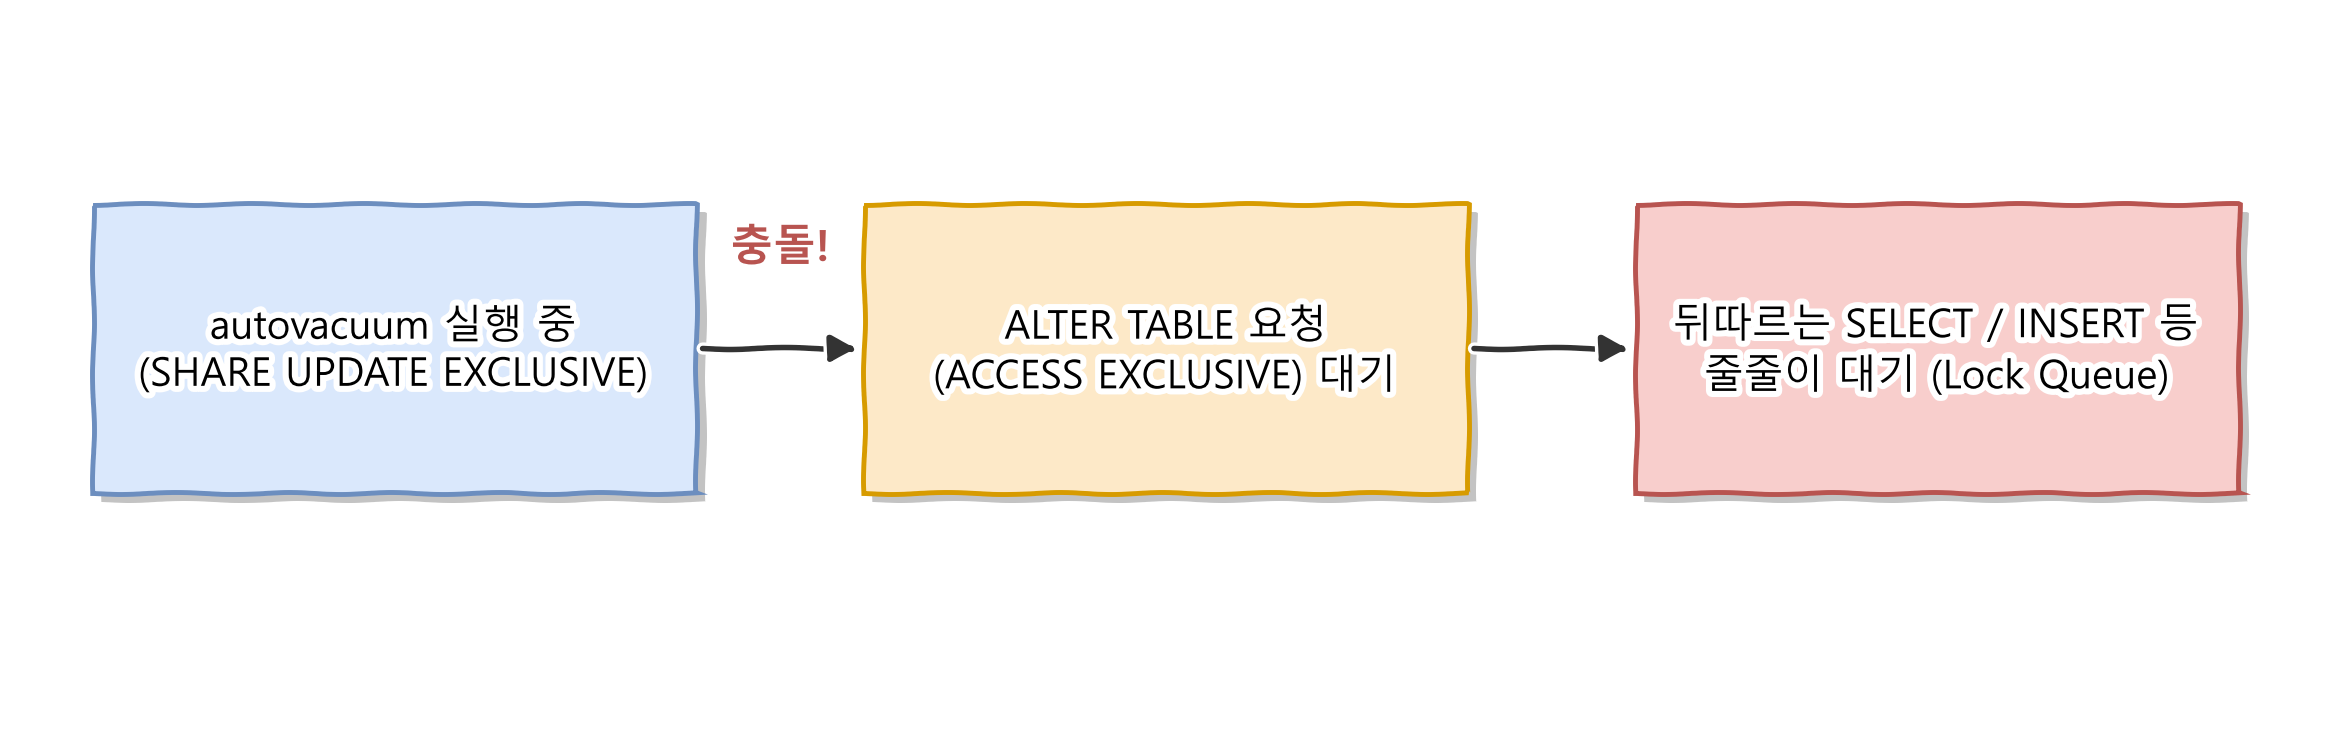
図 2. AutovacuumとDDLのLock競合
4.2 長時間開いたトランザクションが引き起こす問題
アプリケーションのコネクションリークや、デバッグ中に開いたままのトランザクションを長時間放置すると、そのトランザクションが開始された時点より前のdead tupleをautovacuumがクリーンアップできなくなります。その結果、テーブルとインデックスのサイズが必要以上に膨れ上がるbloat現象が発生し、クエリ性能の低下につながる可能性があります。
5. おわりに
「autovacuumは自動的にうまく動作するバックグラウンドプロセス」と放置していると、普段は何の問題もなくても、トラフィックの増加、長時間開いたトランザクション、設定不足といった条件が一度に重なった瞬間、サービス全体に影響を及ぼす可能性があります。xid_ageやdead tupleの割合といった指標を普段から監視していないため、問題がしきい値に達した後になって初めて気づくこともあります。こうした指標についても監視を行えば、強制実行の条件に達する前に、より余裕を持って対応できるでしょう。
Sean