
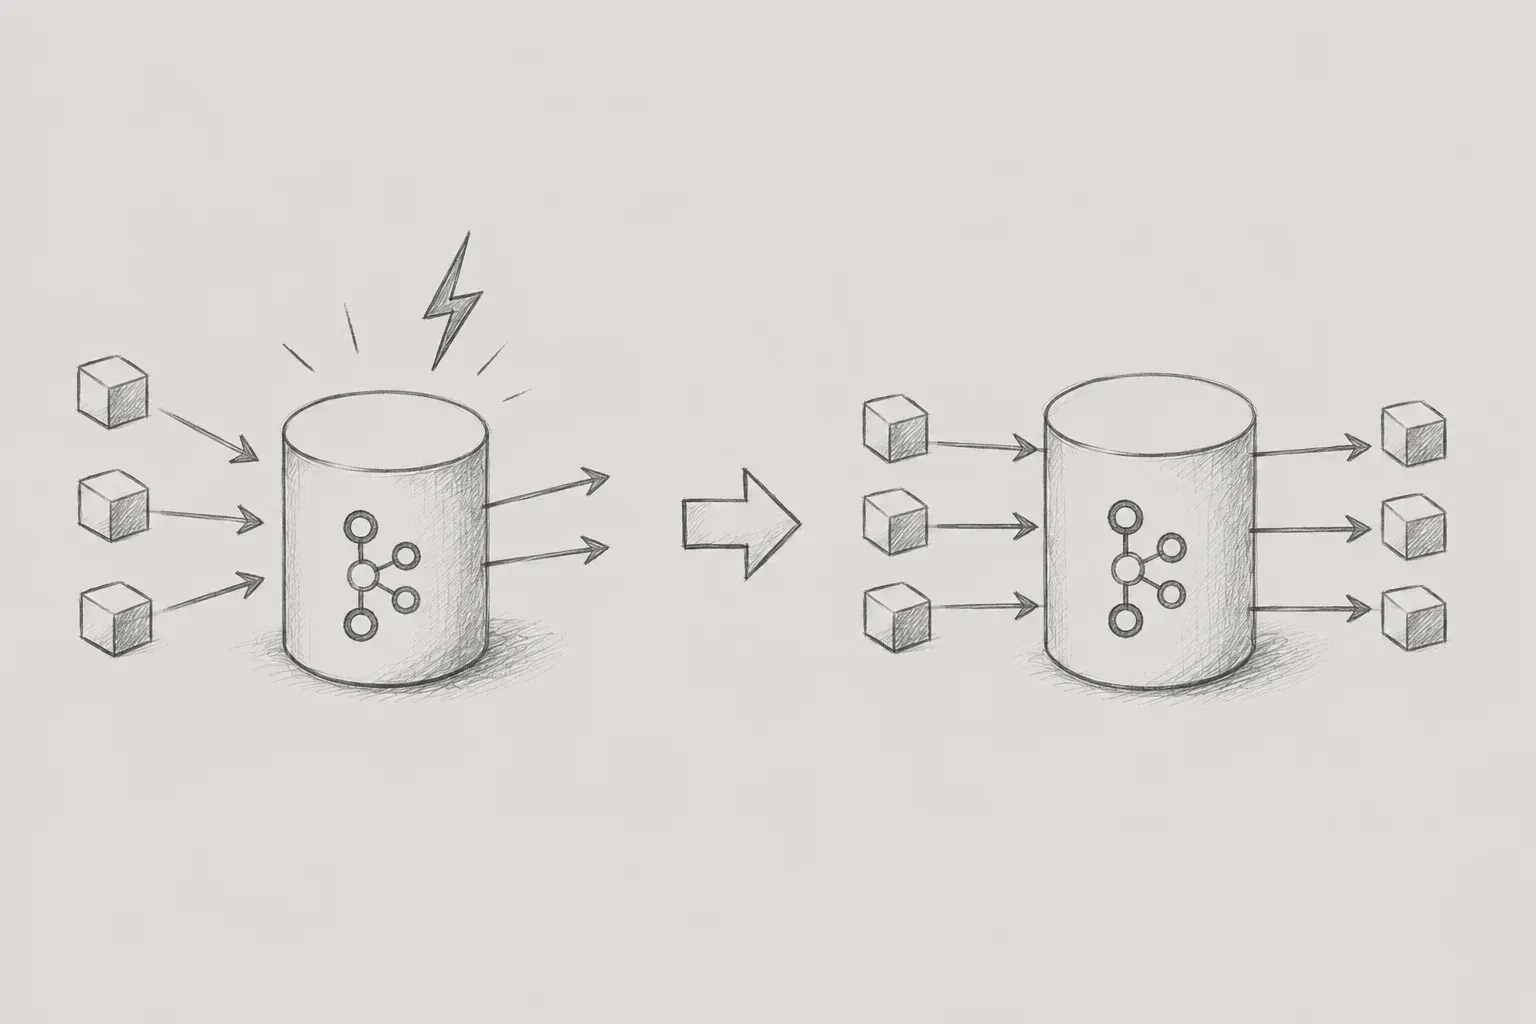
1. 問題発生
運用中のKafkaメッセージが正常にConsumeされていないという問い合わせを受けました。
該当サーバーのログを確認した結果、Consumer GroupのRebalancingが約10分間隔で繰り返し発生していました。
Rebalancingが発生する原因を確認するため、Consumer設定と実際のメッセージ処理時間を併せて確認しました。
当時、max.poll.interval.msは10分に設定されており、1つのKafkaメッセージを処理するのに10分以上かかっていました。
max.poll.interval.msは、Consumerがpoll()を呼び出してから次のpoll()を呼び出すまでに許容される最大間隔です。そのため、メッセージ処理時間がこの設定値を超えたことで、Consumerが正常な処理間隔を維持できず、Rebalancingが発生したと判断しました。
問題を確認した当時の設定は以下のとおりでした。
max.poll.interval.ms=600000ログと設定を併せて確認することで、今回の問題はKafka自体のメッセージ受信問題というよりも、メッセージ処理時間が長くなり、Consumerの処理間隔制限を超過したことによる問題であると確認できました。
2. 優先的な運用対応
原因を確認した後、まず運用中のConsumerでRebalancingが繰り返される状況を緩和する必要がありました。
そこで、max.poll.interval.msを従来の10分から30分に変更しました。
max.poll.interval.ms=1800000設定変更により、現在のメッセージ処理に10分以上かかる場合でも、Consumerが処理を完了できる時間を確保しました。
ただし、この対応を根本的な解決方法とは考えていませんでした。
現在の処理時間が10分であるため、30分に変更することで当面の問題は緩和できますが、今後データ量の増加やDB処理時間の増加によって処理時間が30分を超えた場合、同じ問題が再び発生する可能性があるためです。
そのため、運用環境ではまずConsumerが正常にメッセージを処理できるように設定を変更したうえで、実際のメッセージ処理に時間がかかる原因を追加で確認しました。
3. メッセージ処理遅延の原因分析
メッセージ処理ロジックを確認した結果、1つのKafkaメッセージを処理する過程で約46,000件のデータをMSSQLに保存していました。
ここでの問題は、46,000件というデータ件数そのものよりも、1つのメッセージを処理するために複数回のDB保存処理が実行され、全体の処理時間が10分以上に増加していたことでした。
Kafka Consumerの観点では1つのメッセージを処理する作業ですが、アプリケーション内部では、そのメッセージを処理するために複数回のDB保存処理を実行していました。
そのため、Consumer設定をさらに調整するよりも、メッセージ処理時間そのものを短縮する必要があると判断しました。
メッセージ処理ロジックを追いながら各処理区間を確認し、DB保存部分が全体の処理時間に大きな割合を占めていることを確認しました。
そこで、Consumerの処理時間を短縮するため、該当するDB保存区間を改善する方針で作業を進めました。
今回の問題の原因と解決方針をまとめると、以下のとおりです。
-
1つのKafkaメッセージの処理に10分以上かかる
-
max.poll.interval.msが10分に設定されている
-
メッセージ処理中にRebalancingが繰り返し発生する
-
メッセージ処理の過程でDB保存区間に相当な時間がかかる
-
DB保存方式を改善し、メッセージ全体の処理時間を短縮する方針を決定
4. DB保存方式の変更
メッセージ処理ロジックを確認した結果、約46,000件のデータをMSSQLに保存する過程に多くの時間がかかっていました。
従来のアプリケーションはJPAを使用していました。今回の改善では、特定のメッセージ処理におけるDB保存区間のみをBatch方式に変更する必要がありました。
JPAのBatch設定は、その設定を使用するHibernate処理全般に影響を及ぼす可能性があるため、既存のJPA設定は維持しながら、該当する保存ロジックにのみJdbcTemplate.batchUpdate()を適用しました。
jdbcTemplate.batchUpdate(
   sql,
   data,
   batchSize,
   (PreparedStatement ps, T obj) -> {
      // 데이터 바인딩
   }
 );
従来は複数件のデータを保存する過程でDB保存処理が繰り返されていましたが、変更後はデータをBatch単位にまとめてInsertするように処理しました。
これにより、既存のJPAを使用する他の保存ロジックには影響を与えず、問題が発生していたDB保存区間の処理時間を短縮する方向で改善しました。
5. 既存のID生成方式の維持
DB保存方式を変更するにあたり、既存のID生成方式も併せて確認しました。
該当するEntityはHibernateのguid戦略を使用しており、既存環境ではMSSQLのNEWID()を利用してIDが生成されていました。
JdbcTemplateを使用して直接Insertする場合、JPA/Hibernateが実行していたID生成処理を自ら実装する必要があるため、従来と同じ方式でIDが生成されるように構成する必要がありました。
JavaでUUIDを生成して渡す方法も可能でしたが、今回の作業では既存システムのID生成方式を変更しないことを優先しました。
そのため、Batch InsertでもMSSQLのNEWID()を使用するように構成しました。
INSERT INTO TABLE_NAME ( ID, COLUMN_A, COLUMN_B)
VALUES (NEWID() , ?, ?)
これにより、既存システムで使用していたID生成方式を維持しながら、DB保存方式のみをBatch Insertに変更できました。
今回の作業では、処理性能を改善すると同時に、既存のデータ生成方式に不要な変更が生じないようにすることも重要な基準としました。
6. 改善結果
Batch Insertを適用した後、約46,000件を保存するDB処理区間の所要時間が短縮され、それに伴ってKafkaメッセージ全体の処理時間も改善されました。
問題発生時には、メッセージ処理時間がmax.poll.interval.msを超過したことで、Rebalancingが繰り返し発生していました。
その後、まずmax.poll.interval.msを30分に変更して運用環境の状況を緩和し、実際の処理時間が増加する原因となっていたDB保存区間をBatch Insert方式に改善しました。
その結果、DB保存にかかる時間が短縮され、メッセージ全体の処理時間も併せて短くなり、従来から繰り返し発生していたRebalancing現象も緩和されました。
今回の改善で重要だった点は、単にmax.poll.interval.msを30分に延長して問題を回避したのではなく、設定変更による運用上の問題の緩和と、実際の処理時間を短縮するためのコード改善を分けてアプローチしたことです。
設定変更は、運用中のConsumerがメッセージを処理できる時間を確保するための対応であり、Batch Insertの適用は、実際のメッセージ処理時間を短縮するための改善でした。
これにより、運用障害を優先的に緩和しながら、実際の処理遅延の原因も併せて改善できました。
7. 今回の問題を通じて確認したこと
今回の問題を確認する中で、Kafka Consumerで発生するRebalancingを、単なるKafka設定の問題として捉えてはいけないことを確認しました。
当初は「KafkaメッセージがConsumeされない」という現象として伝えられましたが、ログからRebalancingが繰り返し発生していることを確認し、Consumer設定と実際のメッセージ処理時間を比較することで、原因を絞り込むことができました。
特に、max.poll.interval.msと実際のメッセージ処理時間が近い水準にあり、メッセージ処理中のDB保存にかなりの時間がかかっていることを確認したことで、Consumerの問題に見えていた現象が、実際にはメッセージ処理ロジックの処理時間と関連していることを確認できました。
また、max.poll.interval.msを増加させるだけでは問題を解決できないことも確認しました。
設定値を増加させれば、Consumerがメッセージを処理できる時間をより長く確保できますが、実際の処理時間が増加し続ける場合、最終的には同じ問題が再び発生する可能性があります。
したがって、運用中に同様の問題が発生した場合は、特定の設定値だけを確認するのではなく、Rebalancingが発生した時点と実際のメッセージ処理の流れを併せて確認し、どの区間で時間が増加しているのかを見つけることが重要だと判断しました。
今回の事例ではDB保存の区間が主なボトルネックとして確認されましたが、同じ現象が発生したとしても、実際の原因がDBであるとは限りません。
重要なのは、特定の技術や設定をあらかじめ原因と判断するのではなく、ログと設定、実際の処理の流れを併せて確認しながら、原因を段階的に絞り込んでいくことだと考えています。
8. まとめ
今回の問題は、当初はKafkaメッセージが正常にConsumeされない現象として始まりましたが、ログとConsumer設定、実際の処理時間を併せて確認することで、Rebalancingが発生する原因を絞り込むことができました。
max.poll.interval.msを調整するだけで問題を終わらせるのではなく、実際のメッセージ処理の中で時間がかかっていたDB保存の区間まで確認し、処理方法を改善しました。
特に、運用障害が発生した際には、現在の症状を迅速に緩和することと、実際の処理の流れを分析して根本的な原因を改善することを区別して対応する必要があるという点を確認できました。
今後も同様の問題が発生した場合は、単にエラーが発生した箇所や設定値だけを確認するのではなく、ログと実際の処理の流れを併せて確認しながら原因を段階的に絞り込み、特定されたボトルネックを改善する形で対応したいと考えています。
参考
-
https://kafka.apache.org/0101/generated/consumer_config.html
-
https://docs.spring.io/spring-framework/reference/data-access/jdbc/advanced.html
-
https://docs.hibernate.org/orm/7.3/introduction/html_single/
-
https://learn.microsoft.com/en-us/sql/t-sql/functions/newid-transact-sql?view=sql-server-ver17