
1. Edge Computingとは?
Edge Computingは、データが生成される場所の近くでデータを処理する分散コンピューティングパラダイムです。中央のデータセンターにデータを送信してから処理する方式とは異なり、ネットワークのエッジ(Edge)にコンピューティングリソースを配置し、データの収集、処理、分析などの作業を行います。
データが生成される場所の近くで必要な処理を行うことで、データ転送量と処理遅延を削減できます。また、中央システムとのネットワーク接続が不安定な環境でも、一部の機能を独立して実行できます。
Edge Computingは中央システムを置き換えるための構成ではなく、互いに役割を分担する構成です。データの収集や即時処理が必要な作業はEdgeで行い、大規模なデータ保存や複数の現場のデータを統合して処理する作業は中央システムで行うことができます。
2. IoT環境でEdge Computingが必要な理由
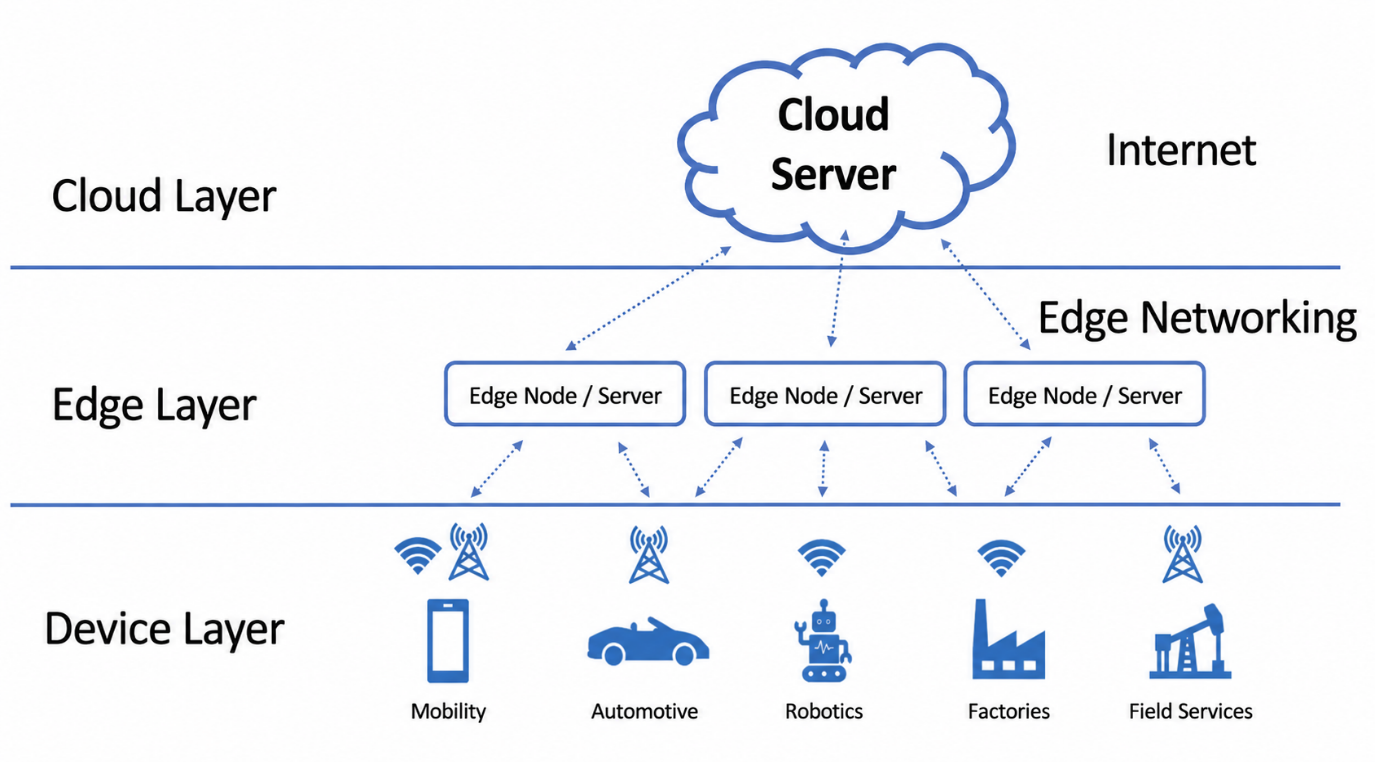
IoT環境では、センサーや機器などさまざまなDeviceから継続的にデータが生成されます。これらのデータをすべて中央システムに送信して処理する構成では、データ量やネットワーク環境に応じてさまざまな制約が生じる可能性があります。Edge Computingは、データの発生地点に近い場所でデータを処理することで、こうした制約を軽減できます。
2.1 データ処理のリアルタイム性
IoT環境では、データを迅速に処理する必要がある場合があります。機器の状態を検知して即座に制御したり、異常状況に対応したりする場合、データを遠隔地の中央システムに送信し、結果を再び受信する過程で発生する遅延が問題になる可能性があります。
Edgeでデータを直接処理すれば、ネットワークを介した往復処理を削減できるため、迅速な応答が必要な機能を現場で実行できます。
2.2 ネットワーク接続への依存性
IoT Deviceが設置される環境では、中央システムとのネットワーク接続が常に安定して維持されるとは限りません。中央システムですべての処理を担う場合、ネットワーク接続に問題が発生すると、Deviceのデータ処理にも影響が及ぶ可能性があります。
Edgeで必要な機能を実行するように構成すれば、中央システムとの接続が一時的に不可能になっても、現場で必要なデータの収集や処理を継続できます。
2.3 データ転送量
IoT環境では多くのDeviceが継続的にデータを生成し、短い間隔でデータを生成するDeviceでは相当量のデータが発生する可能性があります。すべての原データを中央システムに送信すると、ネットワーク使用量だけでなく、中央システムの処理負荷も増加します。
Edgeでデータのフィルタリング、集計、または前処理を行えば、中央システムには必要なデータだけを送信できるため、ネットワーク転送量と中央システムの処理負担を削減できます。
3. 顧客企業のIoTプラットフォームにおけるEdge Computingの適用
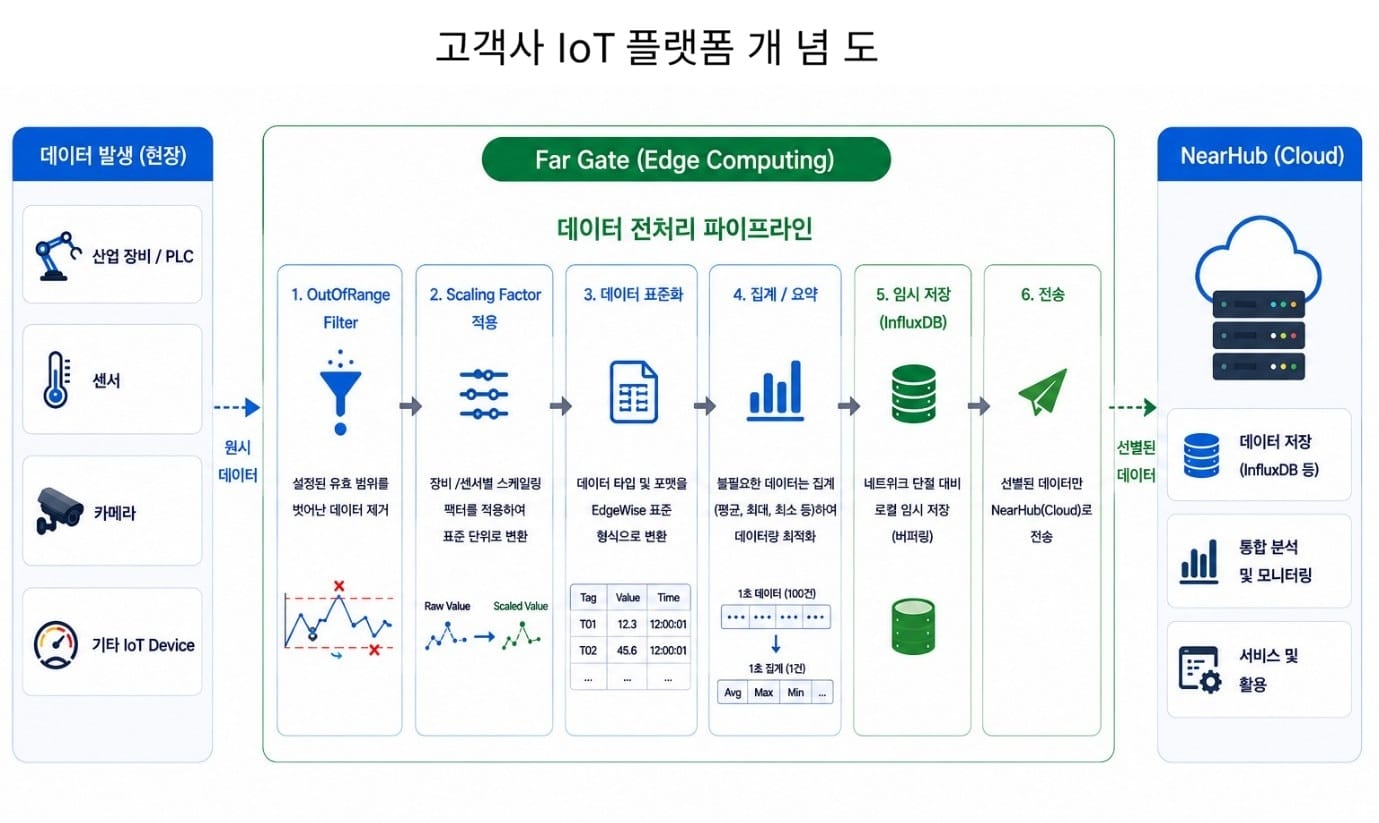
顧客企業のIoTプラットフォームでは、産業現場で発生するデータを収集し、中央システムに送信するためにEdge Computing構成を適用しています。現場にEdge Gatewayを配置し、機器からのデータ収集と一部の処理をEdgeで行った後、必要なデータを中央システムに送信します。
3.1 不要なデータの早期除去
顧客企業のIoTプラットフォームでは、機器からデータを収集する時点でデータの有効性を確認するために、OutOfRange Filterを適用できます。各データ項目に正常に収集できる値の範囲を設定し、その範囲を外れるデータが収集された場合は、以降の処理へ渡さずにEdgeで除去します。
無効なデータを中央システムまで送信した後に判定する方式では、データの送信、受信、およびその後の処理まで不必要に行うことになります。顧客企業のIoTプラットフォームでは、データが最初に収集されるEdgeで有効性を判定し、不適切なデータをできるだけ早く除去するように構成しています。
これにより、不要なデータがその後のデータ処理に及ぼす影響を抑え、中央システムに送信されるデータも有効なデータを中心とした構成にできます。
3.2 ネットワーク切断への対応
Edgeと中央システムの間のネットワークが常に安定して維持されるとは限りません。ネットワークが一時的に切断されても、Edge Gatewayと現場の機器の間でデータを収集する処理は独立して実行できます。
顧客企業のIoTプラットフォームでは、中央システムにデータを送信できない場合でも、機器から収集されるデータが失われないように、Edgeに配置されたInfluxDBにデータを一時保存します。その後、ネットワーク接続が復旧すると、一時保存したデータを中央システムに再送信するように構成しています。
InfluxDBは、時間の経過に伴って継続的に発生するデータを保存する時系列データベースであり、Edgeで収集されるIoTデータを一時的に保管する目的で活用しています。これにより、中央システムとの一時的なネットワーク障害が、現場でのデータ収集の停止やデータの損失に直接つながることを防止できます。
3.3 データ変換と標準化
顧客企業のIoTプラットフォームでは、機器から収集したデータを中央システムに送信する前に、必要な前処理をEdgeで行います。収集した生データにScaling Factorを適用して実際に使用する値へ変換したり、機器ごとのデータ項目名を顧客企業のIoTプラットフォームで使用する標準項目名に変換したりする作業などがこれに該当します。
このように、データが発生する現場で必要な処理を行い、中央システムには一定の形式に加工したデータを送信するように構成しています。
この変換を中央システムで行う場合、中央システムが機器ごとの原データの表現方式まで把握していなければなりません。Edgeで機器データに必要な変換を行ってから送信することで、中央システムが機器ごとの詳細なデータ表現方式に依存する度合いを軽減できます。
4. Edgeと中央システムの役割分担
Edge Computingを適用したからといって、すべての機能をEdgeで実行するわけではありません。顧客企業のIoTプラットフォームでは、現場で処理することが効率的な機能と、複数の現場のデータを統合して処理する必要がある機能を基準に、Edgeと中央システムの役割を区分しています。
機器と直接通信したり、データが収集された直後に実行したりする必要がある処理はEdgeが担当します。また、中央システムとのネットワーク接続状態に関係なく継続する必要がある機能も、Edgeで実行するように構成しています。
一方、複数の現場で収集されたデータを統合して保存したり、モニタリングしたりする機能は中央システムで実行します。個々の現場ではなくシステム全体のデータを基準に処理する必要がある機能を中央に配置し、複数のEdgeを統合して管理できるようにしています。
Edgeで実行される機能の設定と管理も、中央システムを通じて行います。中央でデータ収集および処理に必要な設定を管理してEdgeに送信し、Edgeでは受信した設定に基づいて、現場で実際のデータ収集と処理を行います。
結果として、顧客企業のIoTプラットフォームでは、現場や機器に近い必要がある機能はEdgeに、複数の現場を統合して管理し、データを活用する必要がある機能は中央システムに配置することを基本的な役割分担の基準として適用しています。
genie