
はじめに
AIコーディングエージェントを業務で使うと決めたことは、ツールを一つインストールすることではありませんでした。仕事の進め方そのものを見直すことでした。最初は、プロンプトやスキルをうまく使えばよいと思っていました。しかし数か月が経ってみると、実際に残ったのはプロンプトではありませんでした。ルール文書と失敗の記録、そして失敗をルールに変える反復的な手順でした。
この記事では、私が現在使っているエージェントフローの構成とその背景、満足している点、そして依然として不足している点を整理します。日付と数値はすべて残っている記録から引用しています。
どのような問題だったのか
背景にあるのは社内プラットフォームです。認証、組織、イベントブローカー、ナレッジ管理などのサービスが、それぞれバックエンド、フロントエンド、GitOpsリポジトリに分かれたMSA構成になっています。エージェントがこの構造を扱いにくい理由は、一つの機能が三つのリポジトリにまたがるためです。人間は構造を一度覚えれば新しいプロジェクトにも難なく適用できますが、エージェントはセッションが変わるたびに最初からやり直さなければなりません。
初期は単純に進めていました。要件を説明するとエージェントが作業し、途中で私が確認してから再び説明するというやり方です。この方法は長続きしませんでした。人間が介入する箇所がボトルネックだったからです。マイクロサービスのバックエンドにドメインモデルを一つ追加するたびに、プラットフォームの構造に合わせたコードジェネレーターを実行し、完了したことを伝えなければ次の段階に進めませんでした。バックエンドとフロントエンドの複数の段階で、このような停滞が発生しました。介入するタイミングも遅すぎました。実装途中で誤った方向を修正しようとすると、それまでに使ったトークンと時間をそのまま捨てることになったのです。
その後、原則を定めました。「決めるべきことは作業開始前にすべて決め、正常な実行フローには人間が介入しない」「作業が終わったら報告を受け、その報告に基づいて次の判断を下す」。実行中に新たな意思決定が必要になった場合や、復旧できない問題が発生した場合だけを例外としました。その後に整理したスキルのほとんどは、この原則を守るためのものです。
現在の構成
一つのワークスペースに三つのリポジトリ
サービスごとにワークスペースを一つ用意し、その中でバックエンド、フロントエンド、GitOpsリポジトリをシンボリックリンクで接続します。リポジトリ自体にはエージェント関連のディレクトリを置きません。ルール(rule)、エージェント(sub-agent)、スキル(skill)、作業文書(docs、tasks)はすべてこのワークスペースだけで管理します。
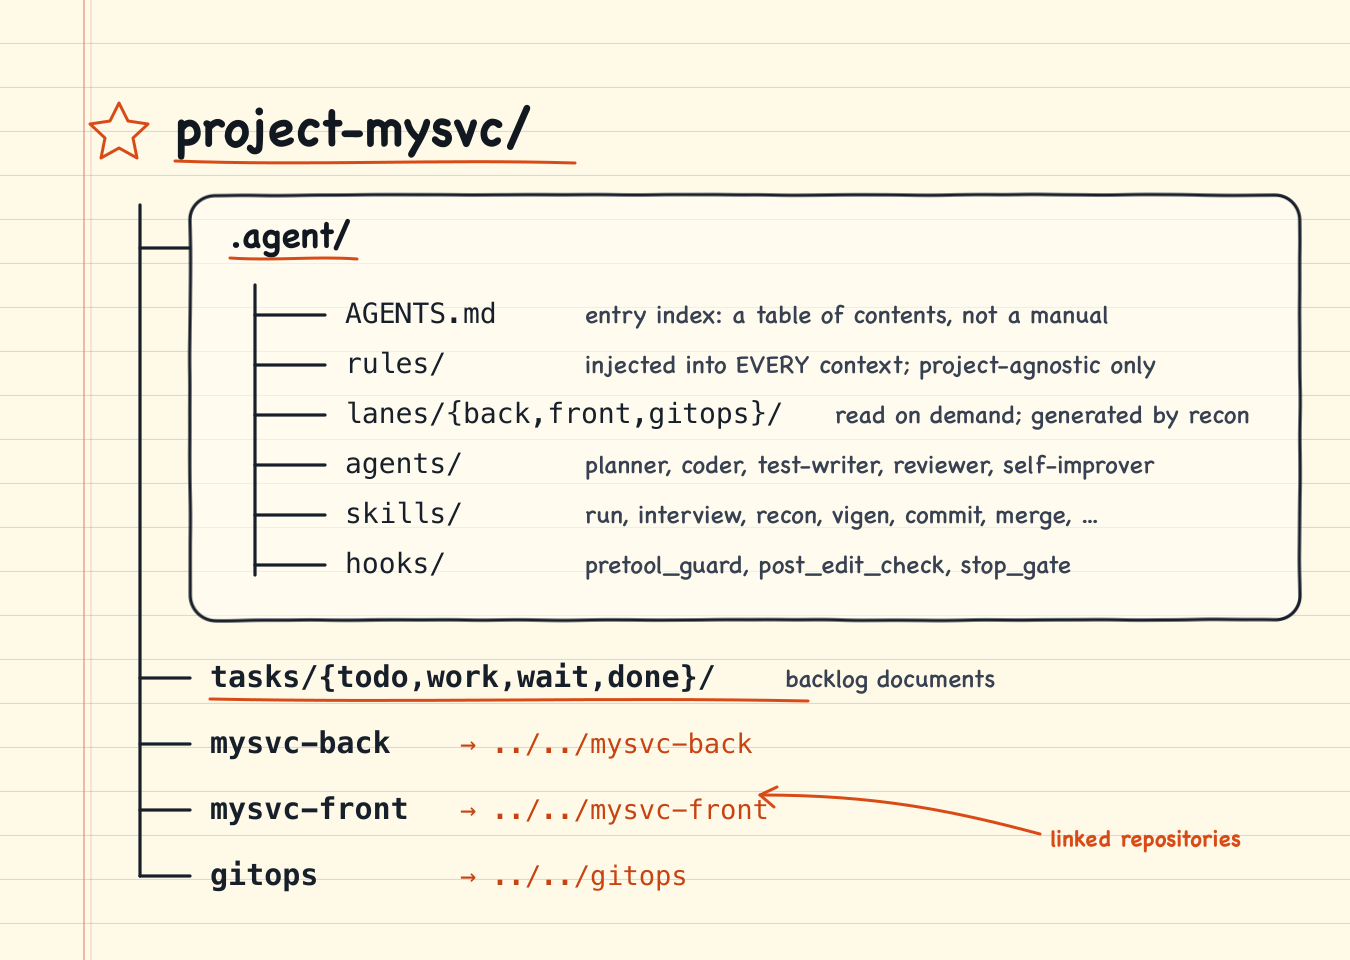
三つのリポジトリを一つのワークスペースにまとめた理由は、作業履歴を一か所で追跡するためです。一つの機能を作ると、バックエンドAPI契約から始まり、フロントのstubを経て、デプロイマニフェストまでつながります。リポジトリごとに別々に作業すると、この流れが三つのコミット履歴に分散し、どのフロントエンドの変更がどのバックエンドの変更によって生じたのかを人間が覚えておかなければなりません。一つのワークスペースでUser Story単位に計画を立て、ウェーブごとにリポジトリ別にコミットすれば、US文書一枚から三つのリポジトリのコミットをまとめて見つけられます。
rules/とlanes/を分けたことも重要な決定でした。rules/はすべてのコンテキストに自動的に含まれるため、分量を小さくし、特定のプロジェクトに依存しないようにする必要があります。lanes/にはリポジトリごとのスタック、パターン、制約、注意点を記載し、エージェントが必要なときに自分で読み取るようにします。1か月前に測定したところ、レーン文書がrules/の下にあった間は245KB、約6万トークンがすべてのコンテキストに含まれていました。lanes/の内容がまったく必要ないcoder呼び出しが17万5千トークンから始まっていることを確認し、その日に分離しました。
五つの役割と共通ルール
サブエージェントは役割ごとに五つあります。plannerは一つのバックログをTaskに分割し、自分で評価しながら95点を超えるまで計画を改善します。coderは一つのTaskを実装しますが、テストは作成しません。test-writerは仕様とインターフェース契約だけを見てテストを作成します。reviewerはテストの品質と計画に対する完成度を確認し、PASS、CONCERNS、FAILのいずれかで判定します。self-improverは問題のあったサイクルを分析し、ルール文書の改善案を提案しますが、承認されるまでは適用しません。
test-writerに実装コードを見せないようにしたのには理由があります。初期には、TDD方式で先にテストを作成するサブエージェントを置いていました。しかし、このエージェントはテストが失敗すると実装コードを直接修正して通過させていました。テストはすべて通過したため、レポートには問題がありませんでしたが、実際にはテストが実装を検証していたのではなく、実装がテストに合わせられていたのです。そこで順序を変えました。まず実装し、その後、実装コードを読んでいない状態でテストを作成します。このルールはtest-writerプロンプトの最初の行にあり、Hookでも実装ファイルの読み取りを禁止しています。
五つのサブエージェントが共通して従うルールは、一つのファイルにまとめました。「自分が担当するファイル以外は変更しない」「コミットはオーケストレーターだけが行う」「レポートは回答を書く前に、まずファイルとして保存する」「回答は10行を超えない」「作業が終わったらすぐに終了する」。最後のルールは、作業を終えたエージェントが三回再び起動し、トークンが32万から37万に増えた後に追加しました。
runスキル、バックログ一つを最後まで処理する
オーケストレーターは一つのバックログを受け取り、次の順序で進めます。
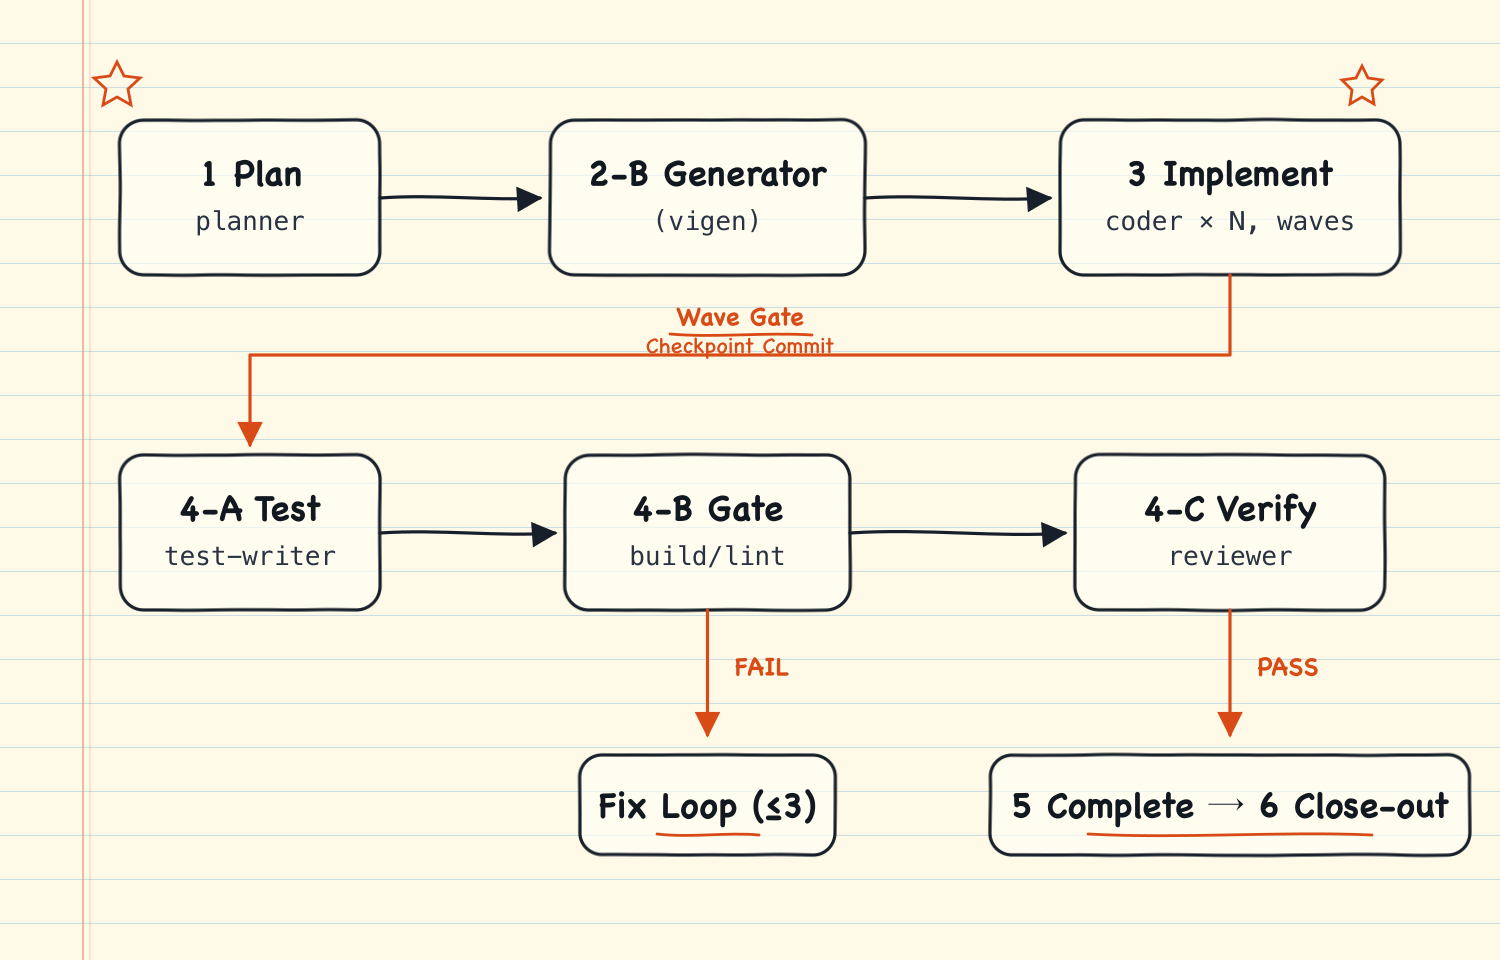
途中で停止するのは二つの場合です。決めるべき事項が生じたら、推奨案とともに質問します。どのような回答を受けても解決できない問題であれば、そのバックログを保留し、次のバックログに進みます。変更ファイルが重ならないバックログは同時に進め、ウェーブが終わるたびにチェックポイントコミットを残します。決定事項と実行ログはすぐにファイルへ記録します。終了報告では、この記録を基に時間とトークン使用量を示すガントチャートを作成します。コンテキストにだけ残った情報は、要約の過程で失われるからです。
runスキルの前にはinterviewスキルがあります。要件を聞いてバックログをTaskに分割するスキルですが、実際に重要なのはその前の段階です。要件が不明確だったり、二通りに解釈できたりする場合は、まずduckingを実行します。Rubber Duck Debuggingとは、問題をアヒルのおもちゃに説明する過程で、説明している人自身が論理的な抜けを見つけるデバッグ手法です。その後、必ず確認を行います。曖昧な点ごとに推奨案と代替案を提示し、回答を受けるまでは何も作成しません。空白を推測で埋めることが、最もコストの高いミスだと何度も経験したからです。
vigenスキル、最後の手作業をなくす
vigenスキルを作った目的は、トークンを節約することではありませんでした。interviewが終わって完了報告を受けるまでの間に、人間が行う作業をなくすことが目的であり、トークンの削減はその結果として得られたものです。
プラットフォームのバックエンドでは、アグリゲートとエンティティを一つ定義すると、Event、Logic、Store、Jpoなど八種類のファイルが決められた形式で構成されなければなりません。facade層にはcommand、fetch、queryごとに同じ機械的な形式があり、フロントエンドのstubもfacade契約をそのまま移して作成します。形式がルールによって完全に定められているため、判断することはありません。もともとこのコードは、人間がプラグイン形式の専用ジェネレーターを実行して作成しており、前述した複数の停滞箇所の原因になっていました。
1次自動化は6週間前に行いました。人間が専用ジェネレーターを実行する代わりに、エージェントがルール文書を読み、自分でファイルを作成するようにしました。エージェントの生成結果が参照コードと同じかどうかをバイト単位で比較して検証し、これにより該当する生成段階では人間が介入しなくなりました。しかし、ルールで決められた作業をエージェントに任せると、マーカーやフィールドマッピングを漏らすミスが発生しました。レビュー段階で再度生成することもあり、トークンを大きく浪費しました。
2次自動化は4週間前に進めました。ルールを、Python標準ライブラリだけを使う四つのスクリプトに移しました。これにより、エンティティとfacadeを人間が専用ジェネレーターで作成していたルールどおりに、トークンを消費せず数秒で生成できるようになりました。plannerは、ルールに従って生成されるコードをcoderの作業範囲から除外します。この時点から、正常なフローではinterviewの後、完了報告を受けるまで人間が介入しなくなりました。
満足している点と不足している点
満足している点は、決定事項が作業の前半に集約されることです。以前は作業の途中で何度もエージェントの方向性を調整したり、次の作業を整理したりする必要がありました。今は必要な決定を開始前に済ませておきます。失敗をルールに変換する手順が実際に機能し、コンテキストの大きさをコストとして管理できるようになった点も満足しています。検証結果もエージェントの自己申告ではなく、Hookと台帳で確認します。
不足している点は、ルール文書自体が大きくなりすぎたことです。runスキル本文は33KB、INCIDENTSは37KBあります。ルールを追加した分だけ削除するという原則と、容量を測定するスクリプトで管理していますが、分量は増え続けています。ルールが増えるほど、読んでも守らないケースも増えます。オーケストレーターが単一障害点になるという問題も残っています。状態をファイルに書き出すルールはこの問題を緩和するだけで、解決はしません。厳格なルールは人間にとっても負担になります。少し前に204分かかったサイクルでは、全体時間の半分近くを、停止していたtest-writerを待つことに費やしました。このような問題は、継続的な自己改善ループで補っていく必要があります。
おわりに
この過程で、自動化の境界も明確になりました。人間が何度も専用ジェネレーターを実行していた作業は、まずルールに変えました。そして、LLMがそのルールを解釈して処理していた作業は、再び決定論的なスクリプトへ移しました。エージェントが役割の境界を越える問題は、プロンプトだけに任せず、厳格な実行順序とHookで防ぎました。
結局、重要なのはエージェントやスキルの数よりも、人間がどの時点で介入するかでした。正常な実行はエージェントとスクリプトに任せ、開発者の時間は作業前に決定を下し、結果を評価することに集中できるようになりました。
残っている作業は、ルール文書の分量を実際に減らすこと、ウェーブゲートでビルドする回数を構造的に減らして全体の時間を節約すること、サイクル間の推移を自動的に記録して改善の資料として活用することです。
dnine