
스마트쉽 솔루션(이하 SS) 데이터 정합성 관리 – 누락 감지부터 복구, 검증, 이상 데이터 탐지까지
선박에서는 IAS, VDR, ACONIS를 비롯한 다양한 장비에서 항해·기관·설비 데이터가 지속적으로 생성됩니다. SS는 이러한 데이터를 선상에서 수집하고 표준화·가공한 뒤 기계류 관리, 항해 관리, 선박 관리 등의 서비스에서 활용하고, 필요한 데이터를 육상으로 전달하는 선상–육상 통합 데이터 플랫폼입니다.
그러나 선박 환경에서 데이터 신뢰성을 확보하는 문제는 단순히 데이터를 육상으로 “보냈는가”만으로 해결되지 않습니다. 선박과 육상 사이에는 네트워크 단절이나 지연이 발생할 수 있고, 선상 내부의 수집·처리 Pipeline에서도 데이터가 누락될 수 있기 때문입니다.
결국 확인해야 하는 것은 세 가지입니다.
데이터가 필요한 시점에 정상적으로 생성되었는가, 그 데이터가 선상에서 육상까지 빠짐없이 전달되었는가, 그리고 육상에 도착한 값 자체가 실제 활용 가능한 정상 데이터인가입니다.
SS에서는 이 문제를 크게 데이터 누락·복구 관리와 데이터 이상 탐지 관리라는 두 기능으로 나누어 관리합니다. 데이터 누락·복구 관리는 데이터의 수집·전송·복구 정합성을 담당하고, 데이터 이상 탐지 관리는 수집된 센서 값의 이상 여부를 확인합니다.
즉, 단순한 데이터 전송 기능이 아니라 누락 탐지 → 원인 추적 → 복구 → 복구 검증 → 데이터 품질 확인까지 이어지는 데이터 신뢰성 관리 체계를 구성하고 있습니다.
1. 선박 데이터는 왜 ‘전송 성공’만으로 충분하지 않은가
SS의 데이터 흐름은 선박 장비에서 시작합니다. IAS, VDR, ACONIS 등에서 발생한 데이터는 선상 센서 데이터 수집 모듈을 거쳐 선상 데이터 가공 모듈로 전달되고, 원천 시계열 데이터와 주기 집계 데이터 형태로 가공됩니다. 이후 기계류 관리나 항해 관리 등의 도메인 서비스에서 활용되거나 선육 간 통신을 통해 육상으로 전달됩니다.
특히 운영 관점에서 중요한 대상은 1분 단위 주기 집계 데이터입니다.
데이터 누락·복구 관리는 선박별로 각 일자의 1분 데이터가 정상적으로 육상까지 수집되는지 확인하고, 데이터가 유실된 경우 유실 지점을 확인하고 재전송을 수행하기 위한 기능으로 정의되어 있습니다.
하루를 분 단위로 환산하면 다음과 같습니다.
24시간 × 60분 = 1,440건
따라서 과거 하루의 데이터가 정상적으로 모두 수집되었다면 1,440개의 Timestamp가 존재해야 합니다.
하지만 실제 정합성 판단은 단순히 Count = 1440인지 확인하는 것보다 세밀합니다.
선상에서 생성된 시간/구간 집계 데이터가 육상에 도착하면 수신 Timestamp를 기록하고, 중복 Timestamp를 제외한 실제 수신 시점을 기준으로 유실 여부를 판단하며 단일 지표 하나로 유실을 확정하기보다는 데이터 수신 상태, Backfill 이벤트, 복구 이력, Pipeline 상태를 함께 확인하고 있습니다.
그래서 SS 데이터 정합성 관리의 출발점은 다음 질문입니다.
하루 1,440개의 데이터 중 단 한 개가 빠졌다면, 시스템은 그것을 어떻게 발견하고 어디에서 유실되었는지 찾아 다시 확보할 것인가?
2. 1단계 — 정합성 관리의 출발점은 ‘누락을 보이게 하는 것’
데이터 정합성을 관리하려면 가장 먼저 데이터 누락이 보여야 합니다.
데이터 누락·복구 관리는 이를 위해 세 가지 관점을 제공합니다.
Overview에서는 현재 시점을 기준으로 선박별 상태를 확인하고, Daily에서는 선택한 날짜의 분 데이터 수집 현황을 확인하며, Recovery Status (On-Board)에서는 선상 자체 복구 상태를 확인합니다.
운영자는 이를 통해 단순히 “데이터 수집에 문제가 있습니다”는 사실뿐 아니라,
어느 선박에서 → 어느 날짜에 → 몇 건의 데이터가 누락되었는가까지 단계적으로 확인할 수 있습니다.
여기서 중요한 것은 장애의 존재 자체보다 장애의 범위를 구체화하는 것입니다. 수백 척의 선박 데이터를 관리하는 환경에서 단순한 Error 메시지만으로는 실제 대응이 어렵습니다.
반면 선박과 날짜, Timestamp 단위로 누락 범위를 좁힐 수 있다면 이후의 원인 분석과 복구 절차도 훨씬 명확해집니다. 따라서 SS에서 데이터 정합성 관리의 첫 번째 원칙은 다음과 같이 정리할 수 있습니다.
“데이터가 빠졌다는 사실을 아는 것에서 끝나지 않고, 어느 선박의 어느 시간대 데이터가 빠졌는지까지 식별합니다.”
3. 2단계 — 1440 → 1439에서 끝내지 않고 유실 구간을 추적합니다
1,440건이어야 할 데이터가 1,439건이라면 한 건이 누락된 것은 알 수 있습니다.
하지만 이것만으로는 장애를 복구하기 어렵습니다.
복구를 위해서는 어느 Timestamp가 빠졌고, 그 데이터가 Pipeline의 어느 단계까지 정상적으로 전달되었는가를 확인해야 합니다.
SS는 선상과 육상에 걸쳐 여러 처리 구간을 가집니다.
운영 관점에서는 이를 개념적으로 다음과 같이 볼 수 있습니다.
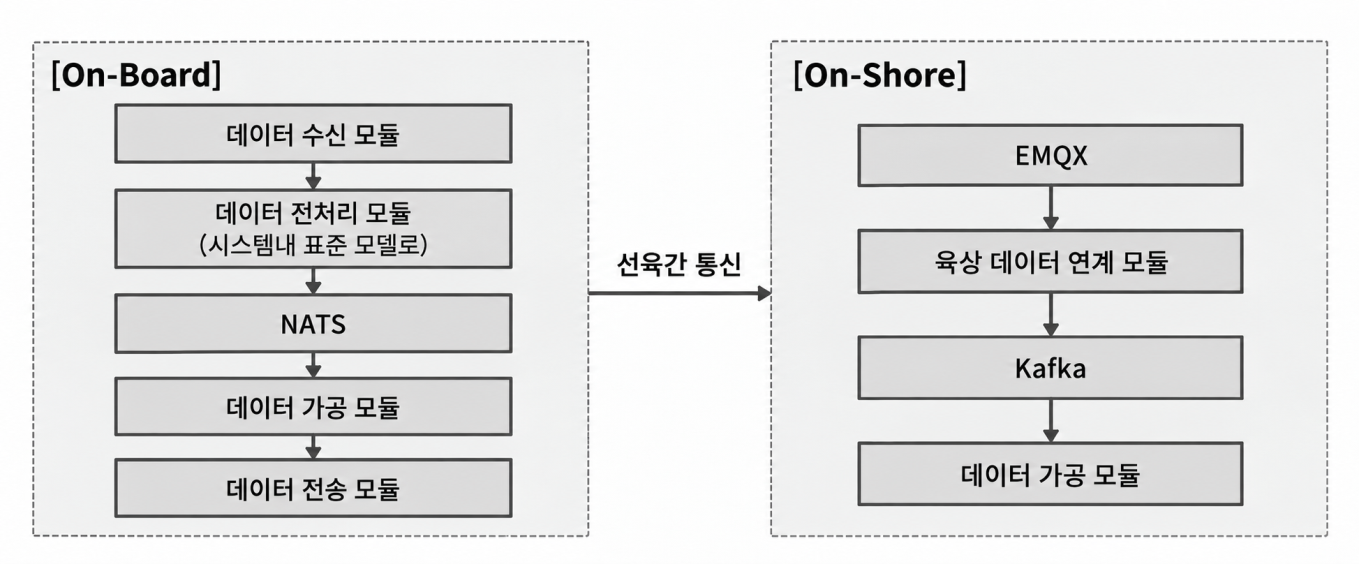
따라서 동일한 1건의 누락이라도 원인은 서로 다를 수 있습니다.
선상에서 생성되는 데이터 자체가 부족하다면 데이터 수신 모듈, 데이터 전처리 모듈, 데이터 가공 모듈 등 선상 생성·가공 구간을 우선 확인해야 합니다.
반대로 선상 데이터는 정상적으로 생성되었지만 육상의 수신 건수가 부족합니다면 데이터 전송 모듈 이후의 선육간 네트워크나 EMQX, 육상 데이터 연계 모듈, Kafka 및 육상 데이터 가공 모듈 구간을 점검할 수 있습니다.
이 구조의 의미는 분명합니다.
“데이터가 없다”는 현상에서 한 단계 더 나아가 “데이터가 어디까지 왔고 어디에서 사라졌는가”를 찾아야 실제 복구가 가능합니다.
4. 3단계 — 가능한 복구는 먼저 선상에서 수행합니다
SS 의 특징 중 하나는 데이터 유실을 발견했다고 해서 무조건 육상 운영자가 선박에 직접 재전송을 요청하는 구조가 아니라는 점입니다.
선상에서는 데이터 생성과 가공 Pipeline을 기준으로 누락 여부를 확인하고, 필요한 경우 자체적으로 복구 가능한 데이터를 다시 처리합니다.
전체 흐름을 단순화하면 다음과 같습니다.
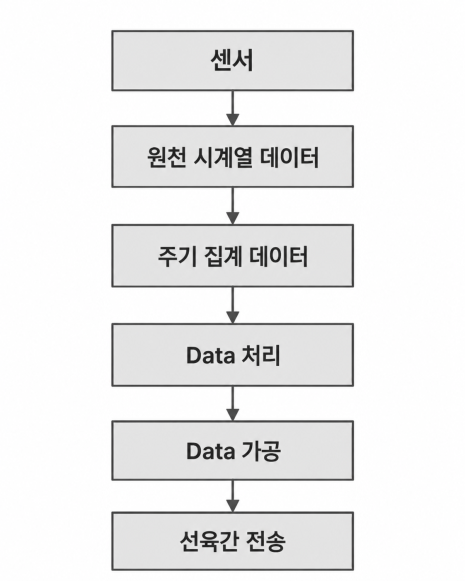
주기 집계 1분 데이터는 이후 육상에서 데이터 누락·복구 관리의 정합성 판단 기준이 되기 때문에, 선상에서 정상적으로 생성되고 유지되는 것이 중요합니다.
데이터 누락·복구 관리의 적용 범위는 선상과 육상의 데이터 가공, 데이터 모니터링, 선상 센서 데이터 수집/데이터 전처리/육상 데이터 연계/Kafka 연계 구간까지 포함하고 있으며, 주요 행위 역시 유실 후보 확인과 재처리 및 최종 복구 확인을 대상으로 합니다.
즉 데이터 정합성을 중앙 시스템 하나의 책임으로 보지 않고, 데이터가 생성되는 선박 자체에서도 복구할 수 있도록 역할을 분담한 구조입니다.
이를 한 문장으로 표현하면 다음과 같습니다.
“네트워크가 정상화되기만 기다리는 것이 아니라, 데이터가 존재하는 위치에서 먼저 복구할 수 있도록 합니다.”
5. 4단계 — 육상에서는 육상 데이터 연계 모듈 확인과 재전송을 하나의 상태 프로세스로 관리합니다
선상 자체 복구 이후에도 육상에서 데이터가 확인되지 않습니다면 육상 중심의 복구 절차가 이어집니다.
여기서 중요한 점은 누락이 발견됐다고 즉시 선박에 동일 데이터를 다시 보내라고 요청하는 것이 아니라는 것입니다. 육상에서 먼저 육상 데이터 연계 모듈 측에 데이터 존재 여부와 재전송 가능 여부를 확인하고, 그래도 데이터가 복구되지 않은 경우 선상 재전송 단계로 넘어가는 구조를 사용합니다.
육상 재전송 요청 → 선상 복구 대상 감지 → 데이터 가공 모듈 복구 처리 → BackfillResponse 수신 및 결과 반영 → 응답 지연·실패 재시도
사용자에게는 이러한 복구 과정을 상태 형태로 단순화해 보여줍니다.
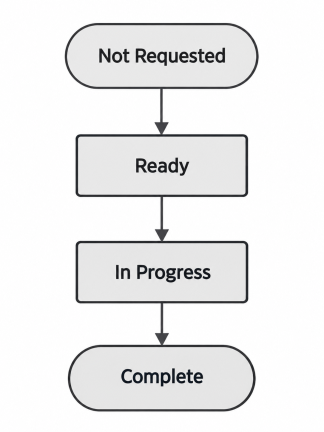
또한 데이터 누락·복구 관리는 Daily 재전송 관련 기능을 제공합니다.
이 구조에서 재전송은 단순한 버튼이나 API 한 번의 호출이 아니라
누락 발견 → 재전송 가능 여부 판단 → 요청 → 처리 중 → 실제 복구 확인이라는 상태를 가진 Recovery Workflow입니다.
6. 5단계 — ‘요청 성공’과 ‘복구 완료’를 구분합니다
데이터 복구 시스템에서 자주 발생하는 오류는 재전송 API 호출이 성공한 것을 데이터 복구 성공으로 간주하는 것입니다.
하지만 실제로 필요한 것은 요청에 대한 200 OK가 아닙니다.
재전송한 데이터가 다시 Pipeline을 통과하여 육상 데이터 가공 모듈까지 도착하고, 실제 누락 Timestamp가 수신 이력에 반영되어야 합니다.
따라서 SS 의 복구 완료 조건은 다음과 같이 이해하는 것이 적절합니다.
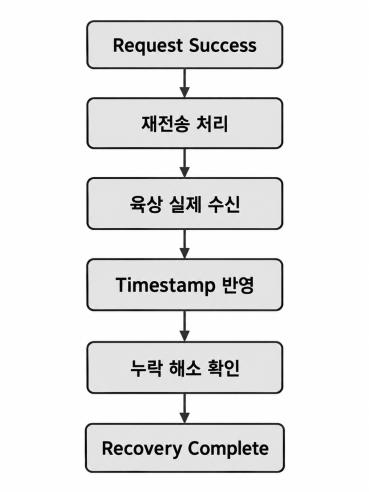
즉, Request Success ≠ Recovery Complete입니다.
데이터 누락·복구 관리의 목적 역시 유실 구간 탐지와 재처리 요청뿐 아니라 최종 복구 결과를 확인하는 절차까지 포함하며, 운영자는 데이터 수신 상태와 Backfill 이벤트, 복구 이력, Pipeline 상태를 함께 확인할 수 있습니다.
이 부분이 SS 데이터 정합성 관리에서 중요한 지점입니다.
재전송 기능을 만드는 것이 아니라, 재전송의 결과가 실제 시스템 상태에 반영되었는지를 다시 측정하는 것입니다.
7. 6단계 — 1,440건을 모두 받았다고 데이터가 정상인 것은 아니다
여기까지 해결하면 데이터의 Completeness, 즉 필요한 데이터가 존재하는지는 확인할 수 있습니다.
하지만 또 하나의 문제가 남습니다.
1,440건의 데이터가 모두 들어왔더라도 1,440건이 모두 같은 값을 가리키거나 비정상적인 범위를 지속적으로 나타내고 있다면 해당 데이터는 분석이나 운항 지원에 그대로 사용할 수 없습니다.
이 지점에서 데이터 이상 탐지 관리가 데이터 누락·복구 관리를 보완합니다.
데이터 이상 탐지 관리는 육상에서 선박별 센서 데이터의 이상 징후를 일 단위로 점검하고, 알람의 발생·유지·해제 이력을 관리한 뒤 담당자에게 전달하는 기능입니다.
내부 구성에는 선박 마스터, 알람 조건, 선박별 알람 상태, 상세 이력, 일별 집계, 메일 수신 그룹 등이 포함됩니다.
사용자는 Tag별 Alarm Condition과 적용 선박, Recipient Group을 설정할 수 있으며, 선박별 Alarm 현황을 조회하고 CSV로도 내보낼 수 있습니다.
대표적으로 Stuck Alarm과 Custom Alarm을 통해 장시간 동일 값이 유지되거나 사전에 정의한 조건에 해당하는 센서 데이터를 탐지합니다.
따라서 SS의 데이터 신뢰성 관점을 다음 네 단계로 나눌 수 있습니다.
|
관점 |
확인해야 하는 질문 |
주요 기능 |
|---|---|---|
|
Completeness |
필요한 데이터가 빠짐없이 존재하는가? |
데이터 누락·복구 관리 |
|
Continuity |
선상에서 육상까지 어느 구간에서 끊겼는가? |
Pipeline 상태 확인 |
|
Recovery |
누락 데이터를 다시 확보했는가? |
Backfill / Resend |
|
Validity |
확보한 데이터 값 자체가 정상적인가? |
데이터 이상 탐지 관리 |
즉, 데이터 누락·복구 관리가 “데이터가 존재하는가”를 확인한다면, 데이터 이상 탐지 관리는 그다음 단계인 “그 데이터가 사용할 수 있는 상태인가”를 확인합니다.
8. 운영 관점 — 자동화와 운영자 개입의 경계를 나눈다
정합성 관리 기능이 많아질수록 또 다른 문제가 발생합니다.
모든 상황을 운영자가 직접 확인한다면 선박 수와 데이터량이 증가할수록 운영 부담 역시 급격히 커지게 됩니다.
반대로 모든 장애를 시스템이 자동으로 판단하고 조치하도록 만들면 잘못된 판단이나 반복 재전송을 통제하기 어렵습니다.
SS는 이 두 극단 사이에서 자동 처리와 운영자 개입 영역을 분리합니다.
시스템은 지속적으로 데이터 수신 상태를 확인하고 유실 후보를 계산하며, Backfill과 복구 상태를 관리합니다. 데이터 이상 탐지 관리 역시 일 배치를 통해 선박 센서 데이터를 확인하고 알람 발생·유지·해제 이력을 처리합니다.
운영자는 그 결과를 바탕으로 특정 선박과 일자를 선택하고, 재전송 가능 대상을 선택하거나, Tag 상태·Remark·Hazard 조건 및 대상 선박 등을 관리합니다.
즉, 운영 철학은 다음과 같이 정리할 수 있습니다.
“반복적으로 판단 가능한 정상 복구 과정은 시스템이 자동화하고, 추가 판단이 필요한 상황을 운영자에게 명확한 상태로 제공합니다.”
자동화의 목적은 운영자를 제거하는 것이 아니라, 운영자가 정말 판단해야 할 문제에 집중하게 만드는 것입니다.
9. 결론 — 선육간 데이터 정합성은 하나의 기능이 아니라 Closed Loop다
SS의 데이터 정합성 관리를 데이터 누락·복구 관리나 데이터 이상 탐지 관리라는 개별 기능으로만 보면 여러 기능이 병렬적으로 존재하는 것처럼 보일 수 있지만 하나의 연결된 흐름을 갖습니다.
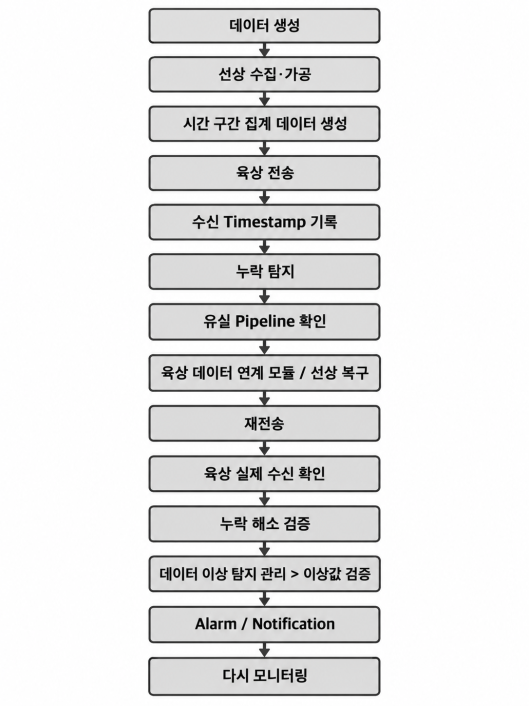
이것은 단순한 “재전송 기능”이라기보다 하나의 Closed Loop 데이터 신뢰성 관리 구조에 가깝습니다.
데이터 누락·복구 관리는 선상에서 생성된 1분 데이터가 육상까지 정상적으로 전달됐는지를 확인하고, 누락된 경우 원인을 추적해 복구한 후 실제 복구 결과까지 확인합니다.
데이터 이상 탐지 관리는 그렇게 확보된 데이터의 값 자체가 정상적인지를 다시 확인하고, 이상이 발견되면 알람과 이력을 통해 운영자에게 전달합니다.
결국 선육간 데이터 신뢰성을 확보하는 핵심은 데이터를 한 번 잘 보내는 것이 아닙니다.
누락을 스스로 발견하고, 어디에서 문제가 발생했는지를 찾아 복구하고, 복구된 데이터가 실제 육상에 반영되었는지 다시 검증하며, 마지막으로 데이터 값의 품질까지 확인하는 폐쇄형 관리 체계를 만드는 것입니다.
이 관점에서 보면 SS 의 데이터 누락·복구 관리와 데이터 이상 탐지 관리는 서로 독립된 두 기능이 아니라,
“데이터 존재 여부 → 전달 정합성 → 복구 가능성 → 복구 검증 → 데이터 유효성”으로 이어지는 End-to-End 데이터 신뢰성 체계의 앞단과 뒷단을 담당한다고 볼 수 있습니다.
sypark2