
들어가며
AI 코딩 에이전트를 업무에 사용하기로 한 일은 도구 하나를 설치하는 일이 아니었습니다. 업무 방식 자체를 다시 정해야 하는 일이었습니다. 처음에는 프롬프트나 스킬만 잘 쓰면 될 거라고 생각했습니다. 하지만 몇 달이 지나고 보니 실제로 남은 것은 프롬프트가 아니었습니다. 규칙 문서와 실패 기록, 실패를 규칙으로 바꾸는 반복적인 절차였습니다.
이 글에서는 제가 지금 사용하는 에이전트 플로우의 구성과 그 배경, 만족스러운 점과 여전히 부족한 점을 정리합니다. 날짜와 수치는 모두 남아 있는 기록에서 가져왔습니다.
어떤 문제였는가
배경은 사내 플랫폼입니다. 인증, 조직, 이벤트 브로커, 지식 관리 같은 서비스가 각각 백엔드, 프론트엔드, GitOps 저장소로 나뉜 MSA 구조입니다. 에이전트가 이 구조를 다루기 어려운 이유는 기능 하나가 세 저장소에 걸쳐 있기 때문입니다. 사람은 구조를 한 번 익히면 새 프로젝트에도 어렵지 않게 적용하지만, 에이전트는 세션이 바뀔 때마다 처음부터 다시 시작해야 합니다.
초기에는 단순하게 진행했습니다. 요건을 설명하면 에이전트가 만들고, 중간중간 제가 확인한 뒤 다시 설명하는 식이었습니다. 이 방식은 오래갈 수 없었습니다. 사람이 개입하는 지점이 병목이었기 때문입니다. 마이크로서비스 백엔드에 도메인 모델 하나를 추가할 때마다 플랫폼 구조에 맞는 코드 생성기를 실행하고, 완료 사실을 알려 줘야 다음 단계로 넘어갈 수 있었습니다. 백엔드와 프론트엔드의 여러 단계에서 이런 정체가 발생했습니다. 개입 시점도 늦었습니다. 구현 도중 잘못된 방향을 바로잡으려 하면 그때까지 쓴 토큰과 시간을 그대로 버리는 셈이었습니다.
이후 원칙을 정했습니다. "결정할 것은 작업 시작 전에 모두 결정하고, 정상적인 실행 흐름에는 사람이 개입하지 않는다", "작업이 끝나면 보고를 받고, 그 보고를 바탕으로 다음 결정을 내린다". 실행 중 새로운 의사결정이 필요하거나 복구할 수 없는 문제가 생기는 경우만 예외로 두었습니다. 이후 정리한 스킬 대부분은 이 원칙을 지키기 위한 것입니다.
지금의 구성
워크스페이스 하나에 저장소 셋
서비스마다 워크스페이스를 하나씩 두고, 그 안에 백엔드, 프론트엔드, GitOps 저장소를 심링크로 연결합니다. 저장소 자체에는 에이전트 관련 디렉터리를 두지 않습니다. 규칙(rule), 에이전트(sub-agent), 스킬(skill), 작업 문서(docs, tasks)는 모두 이 워크스페이스에서만 관리합니다.
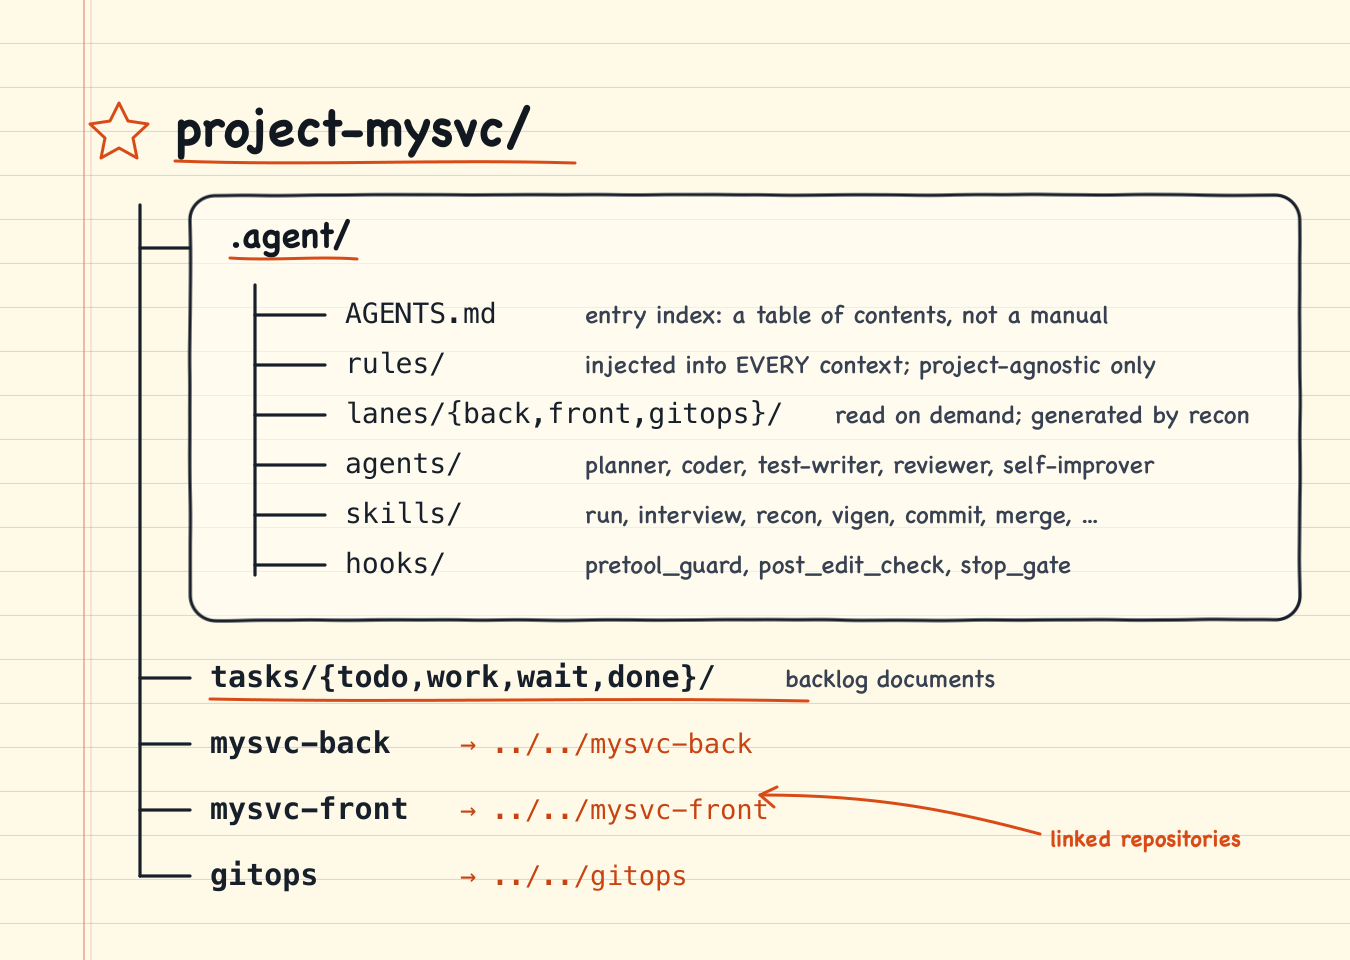
세 저장소를 한 워크스페이스로 묶은 이유는 작업 이력을 한곳에서 추적하기 위해서입니다. 기능 하나를 만들면 백엔드 API 계약에서 시작해 프론트 stub을 거쳐 배포 매니페스트까지 이어집니다. 저장소별로 따로 작업하면 이 흐름이 세 개의 커밋 이력으로 흩어지고, 어떤 프론트 변경이 어떤 백엔드 변경 때문에 생겼는지 사람이 기억해야 합니다. 워크스페이스 하나에서 User Story 단위로 계획을 세우고 웨이브마다 저장소별로 커밋하면, US 문서 한 장에서 세 저장소의 커밋을 함께 찾을 수 있습니다.
rules/와 lanes/를 나눈 것도 중요한 결정이었습니다. rules/는 모든 컨텍스트에 자동으로 포함되므로 분량이 작아야 하고 특정 프로젝트에 종속되면 안 됩니다. lanes/에는 저장소별 스택, 패턴, 제약, 주의할 점을 담고, 에이전트가 필요할 때 직접 읽게 합니다. 한 달 전에 측정해 보니 레인 문서가 rules/ 아래에 있던 동안에는 245KB, 약 6만 토큰이 모든 컨텍스트에 실리고 있었습니다. lanes/ 내용이 전혀 필요 없는 coder 호출이 17만 5천 토큰에서 시작하는 것을 확인하고 그날 바로 분리했습니다.
다섯 가지 역할과 공통 규칙
서브에이전트는 역할별로 다섯 개입니다. planner는 백로그 하나를 Task로 나누고, 스스로 평가하여 95점을 넘길 때까지 계획을 보완합니다. coder는 Task 하나를 구현하고 테스트는 작성하지 않습니다. test-writer는 스펙과 인터페이스 계약만 보고 테스트를 작성합니다. reviewer는 테스트 품질과 계획 대비 완성도를 보고 PASS, CONCERNS, FAIL 중 하나로 판정합니다. self-improver는 문제가 있었던 사이클을 분석해 규칙 문서 개선안을 제안하는데, 승인하기 전에는 적용하지 않습니다.
test-writer가 구현 코드를 보지 않게 한 데는 이유가 있습니다. 초기에는 TDD 방식으로 테스트를 먼저 작성하는 서브에이전트를 두었습니다. 그런데 이 에이전트는 테스트가 실패하면 구현 코드를 직접 수정해서 통과시켰습니다. 테스트는 모두 통과했으니 보고서에는 문제가 없었지만, 실제로는 테스트가 구현을 검증하는 것이 아니라 구현이 테스트에 맞춰지고 있었습니다. 그래서 순서를 바꿨습니다. 먼저 구현하고, 그다음 구현 코드를 읽지 않은 상태에서 테스트를 작성합니다. 이 규칙은 test-writer 프롬프트의 첫 줄에 있고, Hook에서도 구현 파일 읽기를 막습니다.
다섯 개의 서브에이전트가 공통으로 따르는 규칙은 파일 하나에 모아 두었습니다. "자기가 맡은 파일 외에는 수정하지 않는다", "커밋은 오케스트레이터만 한다", "보고서는 답변을 작성하기 전에 파일로 먼저 저장한다", "답변은 열 줄을 넘기지 않는다", "작업이 끝나면 바로 종료한다". 마지막 규칙은 작업을 마친 에이전트가 세 번 다시 깨어나면서 토큰이 32만에서 37만으로 늘어난 뒤 추가했습니다.
run 스킬, 백로그 하나를 끝까지 처리하기
오케스트레이터는 백로그 하나를 받아 다음 순서로 진행합니다.
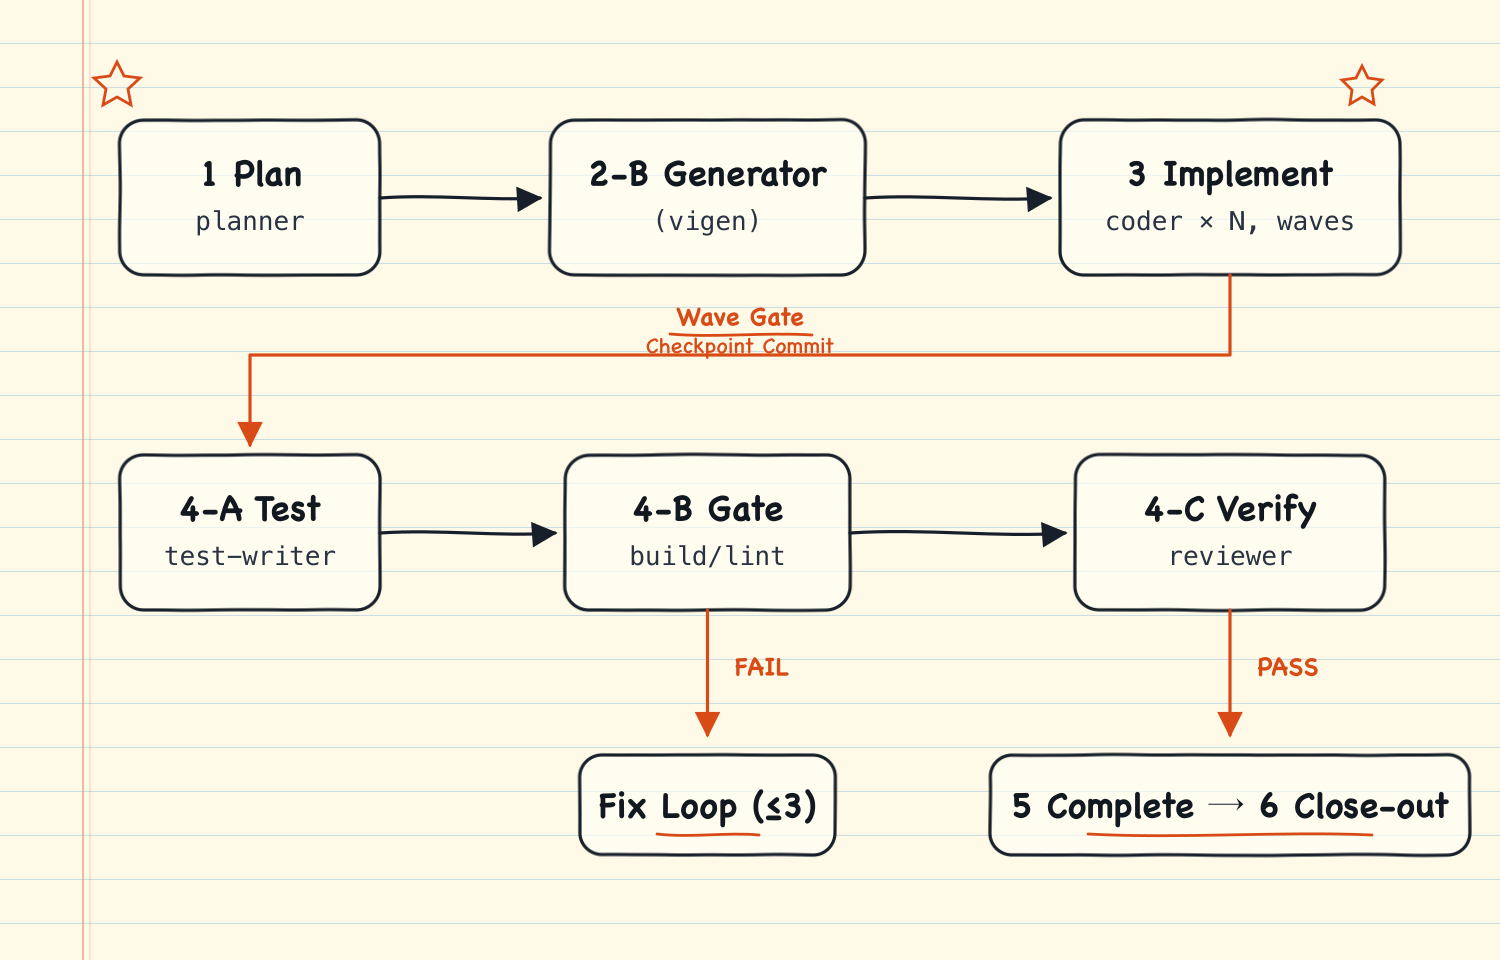
도중에 멈추는 건 두 가지 경우입니다. 결정해야 할 사항이 생기면 권고안과 함께 질문합니다. 어떤 답을 받아도 해결되지 않는 문제라면 해당 백로그를 보류하고 다음 백로그로 넘어갑니다. 수정 파일이 겹치지 않는 백로그는 동시에 진행하고, 웨이브가 끝날 때마다 체크포인트 커밋을 남깁니다. 결정 사항과 수행 로그는 즉시 파일에 기록합니다. 종료 보고서는 이 기록을 바탕으로 시간과 토큰 사용량을 보여 주는 Gantt 차트를 만듭니다. 컨텍스트에만 남은 정보는 요약 과정에서 사라지기 때문입니다.
run 스킬 앞에는 interview 스킬이 있습니다. 요건을 듣고 백로그를 Task로 나누는 스킬이지만, 실제로 중요한 부분은 그 전 단계입니다. 요건이 불명확하거나 두 가지로 해석될 수 있으면 먼저 ducking을 실행합니다. Rubber Duck Debugging은 문제를 고무 오리에게 설명하는 과정에서 설명하는 사람이 스스로 논리적 빈틈을 찾는 디버깅 기법입니다. 그다음 반드시 확인을 거칩니다. 애매한 지점마다 추천안과 대안을 제시하고, 답을 받기 전에는 아무것도 작성하지 않습니다. 빈 곳을 추측으로 채우는 일이 비용이 가장 큰 실수라는 것을 여러 번 겪었기 때문입니다.
vigen 스킬, 마지막 수작업 단계 없애기
vigen 스킬을 만든 목적은 토큰을 아끼는 것이 아니었습니다. interview가 끝난 뒤 완료 보고를 받을 때까지 사람이 중간에 할 일을 없애는 것이 목적이었고, 토큰 절감은 그 결과로 따라왔습니다.
플랫폼 백엔드에서는 애그리거트 및 엔티티 하나를 정의하면 Event, Logic, Store, Jpo 등 여덟 종류의 파일이 정해진 형태로 구성되어야 합니다. facade 계층에는 command, fetch, query별로 동일한 기계적 형식이 있고, 프론트엔드 stub도 facade 계약을 그대로 옮겨 만듭니다. 형태가 규칙으로 완전히 정해져 있어 판단할 것이 없습니다. 원래 이 코드는 사람이 플러그인 형태의 전용 생성기를 실행해 만들었고, 앞에서 언급한 여러 정체 구간의 원인이었습니다.
1차 자동화는 6주 전에 했습니다. 사람이 전용 생성기를 실행하는 대신 에이전트가 규칙 문서를 읽고 직접 파일을 작성하게 했습니다. 에이전트의 생성 결과가 참조 코드와 같은지 바이트 단위로 비교해 검증했고, 이로써 해당 생성 단계에서는 사람이 개입하지 않게 되었습니다. 그러나 규칙으로 정해진 일을 에이전트에게 맡기자 마커나 필드 매핑을 누락하는 실수가 생겼습니다. 리뷰 단계에서 다시 생성하는 일도 있어 토큰이 많이 낭비되었습니다.
2차 자동화는 4주 전에 진행했습니다. 규칙을 Python 표준 라이브러리만 사용하는 스크립트 네 개로 옮겼습니다. 이제 엔티티와 facade를 사람이 전용 생성기로 만들던 규칙 그대로, 토큰 소모 없이 몇 초 만에 생성합니다. planner는 규칙에 따라 생성되는 코드를 coder의 작업 범위에서 제외합니다. 이 시점부터 정상 흐름에서는 interview 이후 완료 보고를 받을 때까지 사람이 개입하지 않게 되었습니다.
만족스러운 것과 부족한 것
만족스러운 점은 결정이 작업 앞부분에 모인다는 것입니다. 예전에는 작업 중간중간 에이전트의 방향을 잡거나 다음 작업을 정리해야 했습니다. 지금은 필요한 결정을 시작 전에 내려 둡니다. 실패를 규칙으로 전환하는 절차가 실제로 작동하고, 컨텍스트 크기를 비용으로 관리하게 된 점도 만족스럽습니다. 검증 결과도 에이전트의 자기 보고가 아니라 Hook과 원장으로 확인합니다.
부족한 점은 규칙 문서 자체가 너무 커졌다는 것입니다. run 스킬 본문이 33KB, INCIDENTS가 37KB입니다. 규칙을 추가한 만큼 삭제한다는 원칙과 용량 측정 스크립트로 관리하지만, 분량은 계속 늘어나는 추세입니다. 규칙이 많아질수록 읽고도 지키지 않는 경우도 늘어납니다. 오케스트레이터가 단일 장애 지점이라는 문제도 남아 있습니다. 상태를 파일로 내려 두는 규칙은 이 문제를 완화할 뿐 해결하지는 못합니다. 엄격한 규칙은 사람에게도 부담이 됩니다. 얼마 전 204분이 걸린 사이클에서는 전체 시간의 절반 가까이를 멈춰 있던 test-writer를 기다리는 데 썼습니다. 이런 문제는 지속적인 자기 개선 루프로 보완해야 합니다.
마치며
이 과정에서 자동화의 경계도 분명해졌습니다. 사람이 서너 번씩 전용 생성기를 실행하던 일은 먼저 규칙으로 바꿨고, LLM이 그 규칙을 해석해 처리하던 일은 다시 결정론적 스크립트로 옮겼습니다. 에이전트가 역할의 경계를 넘는 문제는 프롬프트에만 맡기지 않고 엄격한 실행 순서와 Hook으로 막았습니다.
결국 중요한 것은 에이전트나 스킬의 개수보다 사람이 어느 시점에 개입하느냐였습니다. 정상적인 실행은 에이전트와 스크립트에 맡기고, 개발자의 시간은 작업 전에 결정을 내리고 결과를 평가하는 데 집중하게 되었습니다.
남은 일은 규칙 문서의 분량을 실제로 줄이는 것, 웨이브 게이트에서 빌드하는 횟수를 구조적으로 줄여 전체 시간을 절약하는 것, 사이클 사이의 추이를 자동으로 기록해 개선 자료로 활용하는 것입니다.
dnine